Un pipeline de revue de documents tient ses promesses ou ne les tient pas, et l’écart entre les deux n’a généralement rien à voir avec le choix du modèle. Tout se joue dans les décisions d’architecture prises dès la première semaine, les patterns de prompts choisis selon le cas d’usage et une stratégie de routage par confiance qui survit au contact des documents réels.
Cet article passe en revue ces trois volets. Vous y trouverez l’architecture de référence, trois patterns de prompts qui fonctionnent en production, les modes de défaillance qui détruisent discrètement les pipelines dès la troisième semaine, ainsi qu’un plan de mise en œuvre en quatre semaines. Claude sert d’exemple concret, car son comportement en contexte long, la fiabilité de ses sorties structurées et son ancrage des citations conviennent mieux au travail de revue que tout autre modèle de pointe. Les patterns eux-mêmes se transposent à d’autres LLM moyennant des ajustements mineurs.
Redwerk construit des systèmes à forte composante documentaire depuis 2005, dont Linktiger, un vérificateur de liens cassés qui parcourt plus de 3 millions de liens et est utilisé par Microsoft, Hosting.com et le département des Transports des États-Unis. Les conseils ci-dessous sur le traitement de documents avec Claude reflètent la façon dont nous aborderions un nouveau projet aujourd’hui, après avoir vu des équipes engloutir des trimestres entiers dans des pipelines qui n’ont jamais atteint la production.
Quand la revue de documents mérite d’être automatisée
Tous les workflows ne méritent pas d’être automatisés. Passer six semaines à construire un pipeline LLM pour un processus exécuté deux fois par trimestre gaspille du capital, et le calcul ne survivra pas à votre prochaine revue budgétaire.
Trois signaux indiquent qu’un workflow mérite l’investissement. Un volume supérieur à 500 documents par mois constitue le seuil à partir duquel les économies de main-d’œuvre dépassent les coûts d’évaluation et de prompt engineering en l’espace d’un trimestre. Une entrée semi-structurée signifie que les mêmes champs apparaissent d’un document à l’autre même quand la mise en page change, comme pour les factures, les déclarations de sinistre ou les documents de transporteurs. L’extractibilité des règles signifie qu’un relecteur humain peut tenir la logique de décision sur une seule page.
Les contre-signaux comptent tout autant : une revue ponctuelle sans volume récurrent, un jugement qui dépend d’un contexte extérieur au document, ou des lots si petits que l’instrumentation coûte plus cher que la main-d’œuvre. Le rapport State of AI in the Enterprise 2026 de Deloitte montre que deux tiers des organisations citent la productivité comme principal bénéfice de l’IA, mais seulement lorsque le cas d’usage est étroitement délimité. Un processus de revue documentaire par IA propre vaut mieux qu’un processus astucieux qui ne dépasse jamais le stade du pilote.
Traitez le workflow d’automatisation de la revue de documents comme un produit : un seul type de document, un jeu d’évaluation d’abord, puis gagnez le droit de passer à l’échelle. C’est la discipline que notre pratique d’agence d’automatisation IA applique à chaque pipeline documentaire que nous livrons, et c’est ce qui sépare un système opérationnel d’un pilote qui ne sort jamais du stade de la démo.
Les capacités de Claude en traitement de documents qui comptent pour la revue
Les listes de fonctionnalités des éditeurs cachent généralement l’essentiel. Quatre capacités de Claude changent réellement la façon d’architecturer un pipeline de revue, et en ignorer une seule ajoute des semaines d’ingénierie dont vous n’avez pas besoin. Les capacités ci-dessous supposent que vous travaillez avec Claude Sonnet 4.6 ou Claude Opus 4.7, les modèles actuellement en production pour les charges documentaires.
La première est la fenêtre de contexte longue. Claude Sonnet traite la plupart des contrats et documents de politique interne en une seule passe, ce qui fait du découpage un mécanisme de repli pour les documents de plus de 200 pages plutôt qu’un comportement par défaut.
La deuxième est l’entrée PDF native : Claude lit à la fois le texte et la mise en page visuelle (tableaux, signatures, tampons) sans couche d’analyse séparée pour les PDF numériques natifs.
La troisième est l’application de sorties structurées : les schémas JSON contraignent les réponses avec une fiabilité suffisante pour éviter l’essentiel de la logique de post-traitement.
La quatrième est l’ancrage des citations : Claude renvoie les numéros de page et les extraits sources à côté des valeurs extraites, ce qui vous donne un contrôle déterministe contre les contenus hallucinés.
Ensemble, ces quatre capacités expliquent pourquoi l’extraction de documents par LLM est passée de la démo de recherche à la maturité de production en dix-huit mois. Pour les équipes sans ingénierie LLM senior en interne, c’est là que le développement de grands modèles de langage relève davantage de l’intégration disciplinée que de la recherche. Maîtrisez ces quatre capacités et le reste du pipeline redevient de l’ingénierie ordinaire.
L’architecture de référence des pipelines de traitement de documents avec Claude
Cinq couches portent chaque pipeline de production. Sautez-en une et vous la reconstruirez dans les trois mois, généralement sous la pression des délais.
- Couche d’ingestion. Les PDF, DOCX, scans et pièces jointes d’e-mails entrent via une file d’attente. Chaque scan subit une pré-OCR avant que Claude n’y touche, car demander à un modèle de raisonnement d’effectuer l’OCR de scans de mauvaise qualité gaspille des tokens et de la précision.
- Prétraitement. La classification des documents (contrat vs facture vs sinistre) oriente chaque fichier vers le bon prompt. La stratégie de découpage et l’enrichissement des métadonnées se font ici, en amont de l’inférence.
- Couche API Claude. Le routage des prompts par type de document, la sélection du modèle (Sonnet pour le volume, Opus pour les enjeux élevés) et l’application des sorties structurées vivent ici. La mise en cache des prompts réduit les coûts à l’échelle.
- Scoring de confiance et routage. Les scores de confiance par champ alimentent un routeur à trois voies. La logique de nouvelle tentative intercepte les échecs transitoires avant qu’ils n’atteignent une file humaine.
- Formateur de sortie. JSON validé contre le schéma, journal d’audit écrit, transmission en aval vers votre CLM, votre plateforme de gestion de sinistres ou votre ERP.
La plupart des équipes sous-estiment la quantité d’ingénierie qui vit en dehors du prompt. Les meilleurs frameworks LLM gèrent les nouvelles tentatives, la validation de schéma et l’observabilité qui engloutiraient autrement un ou deux sprints de code sur mesure. Un workflow de traitement documentaire par IA propre, voilà comment automatiser le traitement de documents avec l’IA sans reconstruire le pipeline chaque trimestre. Quand vous avez besoin de ce type de système construit de bout en bout, nos services d’automatisation Claude couvrent toute la pile, de l’ingestion à l’intégration en aval.
Trois patterns de prompts qui fonctionnent en production
La plupart des pipelines calent au niveau du prompt, bien avant que le modèle lui-même ne devienne le problème. Nous utilisons trois patterns dans chaque système de revue documentaire que nous touchons, et chacun résout un problème de production différent. Ils se combinent dans un même pipeline.
Pattern 1 : extraction structurée avec confiance au niveau du champ
Ce pattern convient aux lignes de facture, aux métadonnées de sinistres, aux documents de transporteurs et à la plupart des flux entrants semi-structurés. Le prompt demande à Claude de renvoyer un JSON conforme à un schéma fixe, avec un score de confiance par champ compris entre 0 et 1.
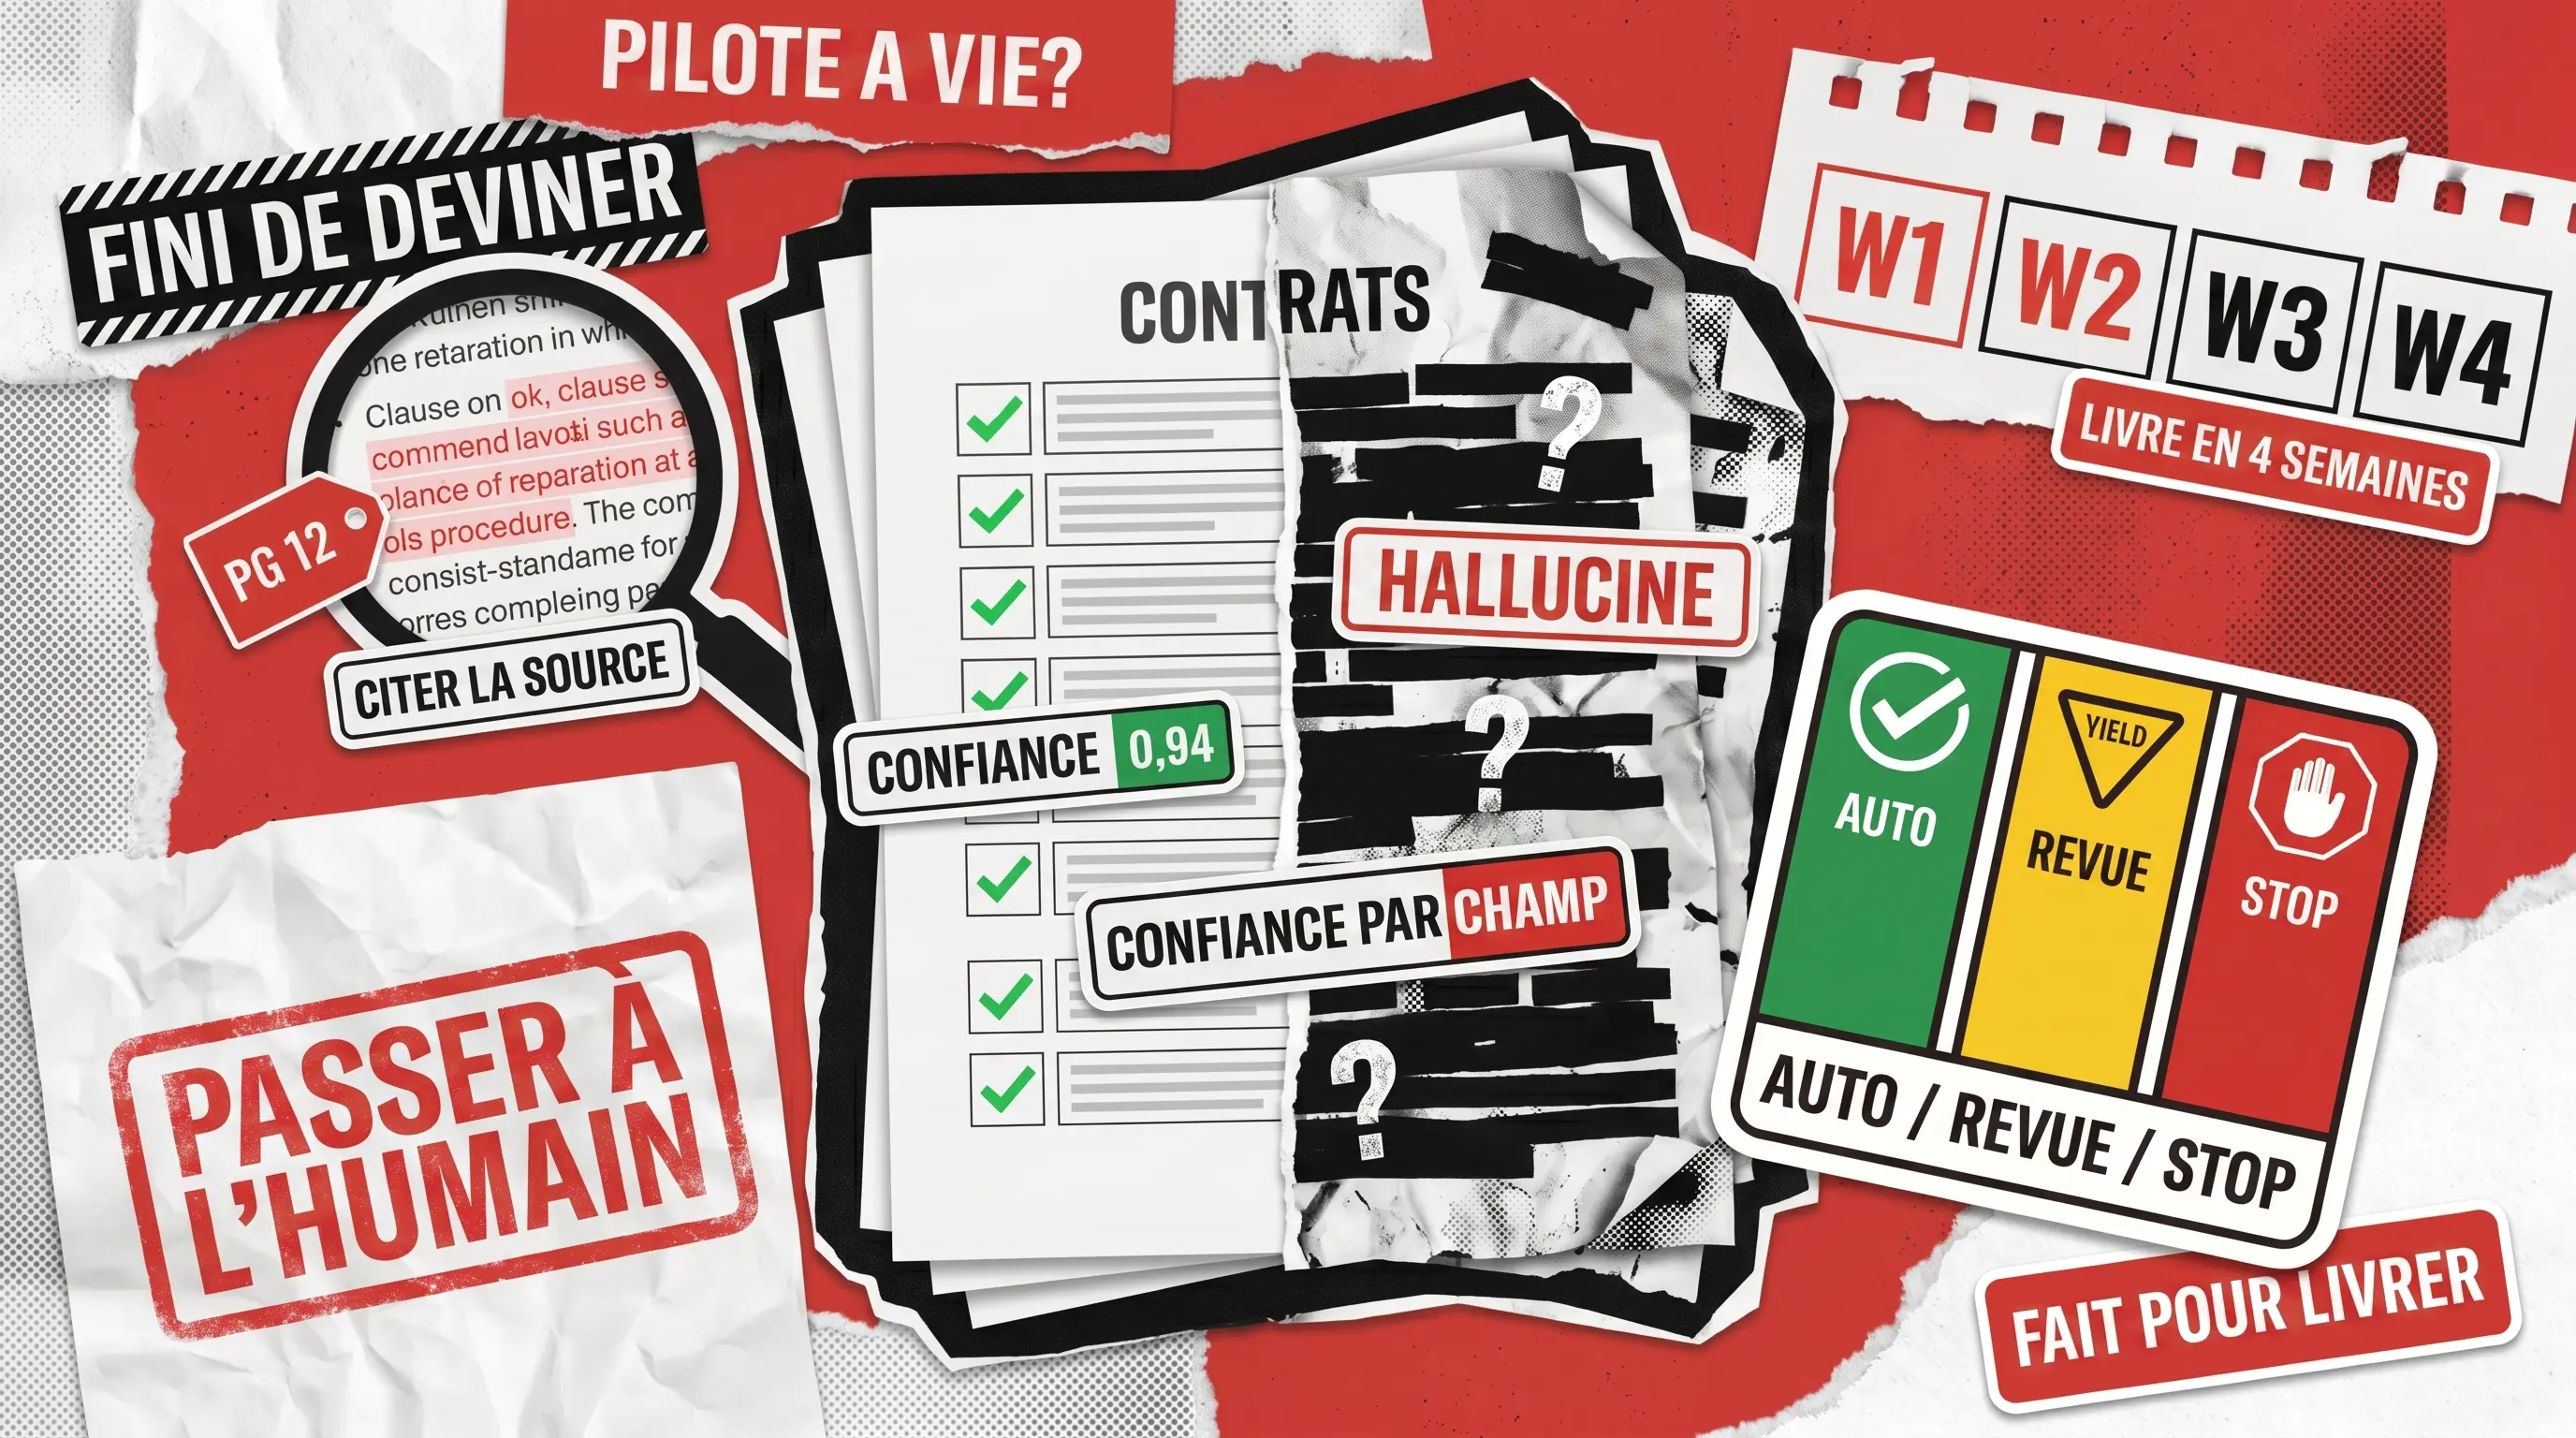
Le routeur en aval reçoit quelque chose d’exploitable. Chaque champ au-dessus de 0,9 est approuvé automatiquement, tout ce qui est en dessous de 0,7 est routé vers un humain, et la bande intermédiaire déclenche une nouvelle tentative sur le modèle le plus puissant. La confiance au niveau du champ bat la confiance au niveau du document, car les erreurs se concentrent dans des champs spécifiques au lieu de se répartir uniformément dans le document. Régler les seuils champ par champ vous donne de la précision là où elle compte, sans ralentir le débit sur le reste.
Pattern 2 : extraction de citations ancrées à la source pour la revue de contrats
Voici comment extraire des données de contrats avec l’IA quand les enjeux vous interdisent de faire confiance à une seule passe d’extraction. Le prompt demande à Claude de renvoyer, à côté de chaque valeur extraite, le numéro de page et l’extrait source exact où la valeur apparaît. L’extraction automatisée de clauses, la détection d’écarts par rapport à un playbook et le suivi des obligations reposent tous sur ce pattern.
Les hallucinations sont détectées instantanément : soit la citation correspond mot pour mot à la source, soit elle ne correspond pas. Les propres recommandations d’Anthropic sur la synthèse juridique préconisent des sorties balisées en XML pour la même raison, le post-traitement devenant déterministe. Pour l’analyse de contrats par LLM à tout volume significatif, c’est le seul pattern qui passe à l’échelle sans régressions de précision hebdomadaires. C’est aussi ainsi que les équipes automatisent la revue de contrats avec l’IA tout en préservant la confiance des juristes dans les résultats.
Pattern 3 : boucle de vérification en deux passes pour les revues à enjeux élevés
Les contrats-cadres de services, les sinistres d’assurance importants et les dépôts réglementaires méritent plus qu’une seule passe d’extraction. Le premier appel extrait, le second vérifie indépendamment l’extraction par rapport au document source. Les désaccords sont escaladés vers un relecteur humain.
Le coût double environ en tokens, et le taux d’erreur baisse sensiblement sur les documents où les erreurs coûtent cher. Au-delà d’un certain seuil de complexité, le vérificateur bascule dans une véritable orchestration multi-agents, où extracteur et vérificateur fonctionnent comme des agents séparés avec leur propre contexte et leurs propres outils. Sautez ce pattern sur les travaux à fort volume et à faibles enjeux, où le compromis de coût ne justifie pas le gain.
Comment fournir de longs documents à Claude sans perdre le contexte
La fenêtre de contexte de Sonnet traite désormais la plupart des contrats en une seule passe, et cela change la discussion sur le découpage. La question de savoir s’il faut découper vient d’abord, bien avant celle de savoir comment découper. La question par défaut a changé, et se tromper ajoute du coût sans ajouter de précision.
Quand vous découpez, découpez sémantiquement plutôt qu’au nombre de tokens. Segmentez par titre, section ou limite de clause, gardez les tableaux et les blocs de code intacts, et faites chevaucher les morceaux de 100 tokens pour capter les références entre pages. Valeurs par défaut pratiques : 600 à 800 tokens par morceau, avec pour chacun des métadonnées incluant le type de document, le titre de section, la plage de pages et l’URI source.
La mise en cache des prompts a sa place dans tout workflow de documents longs. Tout ce qui ne change pas d’un document à l’autre (prompt système, schéma, exemples few-shot) est mis en cache, ce qui réduit sensiblement la latence et le coût à volume élevé. Cela vaut pour les traitements par lots comme pour la revue interactive, et c’est l’un des gains les plus nets pour automatiser le traitement de documents à l’échelle.
Quand faire confiance à Claude et quand router vers un humain
Les portes binaires approuver-ou-rejeter sont l’endroit où les projets d’automatisation documentaire vont échouer. Elles produisent une fausse confiance côté approbation automatique, submergent les relecteurs côté rejet, et apprennent à l’équipe à se méfier du système. Construisez plutôt un routeur à trois voies.
La première voie approuve automatiquement quand chaque champ dépasse le seuil de confiance, typiquement 0,9. La deuxième recommande une revue humaine quand un champ tombe dans la bande intermédiaire (0,7 à 0,9), avec le raisonnement de Claude visible pour le relecteur. La troisième bloque net quand un champ revient sous 0,7 ou quand la classification du document elle-même est incertaine. Réglez les seuils sur un jeu d’évaluation étiqueté plutôt que sur une valeur par défaut marketing.
Deux métriques comptent pour tout processus de revue de contrats par IA. Le taux de fausses approbations mesure la fréquence à laquelle vous approuvez automatiquement quelque chose qu’un humain aurait intercepté : c’est votre plafond de précision. Le taux de revue humaine mesure le travail qui reste à l’équipe : c’est votre ROI. Les travaux de recherche de Thomson Reuters sur la précision de l’IA relèvent que la moitié des praticiens citent la précision démontrable comme principal frein à l’investissement dans l’IA, et les jeux d’évaluation étiquetés sont le seul moyen crédible de la démontrer.

Cinq façons dont l’automatisation documentaire casse en production
Les pipelines échouent de manière prévisible, et chaque équipe apprend les mêmes leçons. Voici cinq modes de défaillance que nous rencontrons souvent, avec les correctifs qui fonctionnent. Traitez cette liste comme une check-list de pré-vol avant la mise en production.
1
Champs hallucinés quand la source ne contient pas la donnée
Exigez null accompagné d’une raison quand un champ est absent. Pénalisez dans le prompt l’extraction confiante de données manquantes.
2
Dérive de la sortie JSON d’une exécution à l’autre
Utilisez le mode de sortie structurée de Claude, validez contre le schéma, réessayez une fois en cas d’échec de parsing, routez vers un humain au second échec.
3
Références entre pages manquées dans les documents longs
Chevauchement des morceaux plus un index de métadonnées. Définir une fois et référencer ailleurs est le pattern par défaut dans les contrats.
4
PDF scannés avec une OCR de mauvaise qualité
Prétraitez avec une couche OCR dédiée (Textract, Azure Document Intelligence ou Tesseract). Ne demandez jamais à Claude de faire l’OCR et de raisonner en une seule passe.
5
Régressions de prompt sur les cas limites
Constituez un jeu de référence de 30 à 50 documents étiquetés dès le premier jour. Rejouez-le avant chaque modification de prompt.
Le cinquième mode compte le plus. La plupart des équipes déploient une modification de prompt et remarquent la régression trois semaines plus tard, en production, quand un client se plaint. La même discipline d’évaluation s’applique côté développement, où les bons plugins Claude Code aident à détecter les problèmes avant le merge. La fiabilité de l’automatisation de la revue de contrats dépend de cette discipline autant que de la conception des prompts.
Du playbook au pipeline
La différence entre les équipes qui livrent et celles qui pilotent éternellement tient en trois points : un jeu d’évaluation étiqueté dès le premier jour, un routage par confiance plutôt que des portes binaires, et des patterns de prompts choisis selon le cas d’usage plutôt que copiés sur Reddit. Réussissez ces trois points et le reste n’est que de l’ingénierie.
Quatre semaines suffisent pour aboutir à un pipeline opérationnel. La première semaine délimite les types de documents, construit le jeu d’évaluation et conçoit le schéma avec le responsable du système en aval. La deuxième met en place l’ingestion, le repli OCR, la classification et le découpage. La troisième câble le routage par confiance, l’interface de revue humaine et l’intégration en aval. La quatrième rejoue le jeu d’évaluation complet, règle les seuils, passe en shadow mode, puis bascule en production une fois que l’équipe humaine a validé les résultats.
L’approche interne fonctionne quand vous disposez d’un ingénieur senior expérimenté en LLM et d’un product owner capable de trancher les questions de schéma dans la journée. Quand l’un des deux manque, un partenaire ayant un historique de systèmes documentaires comblera l’écart plus vite. Si vous préparez ce chantier pour votre équipe, contactez-nous et nous vous aiderons à cadrer le premier type de document.
Découvrez comment nous avons réduit de 40 % les tâches administratives manuelles pour une plateforme de réservation à laquelle font confiance plus de 100 institutions gouvernementales australiennes.