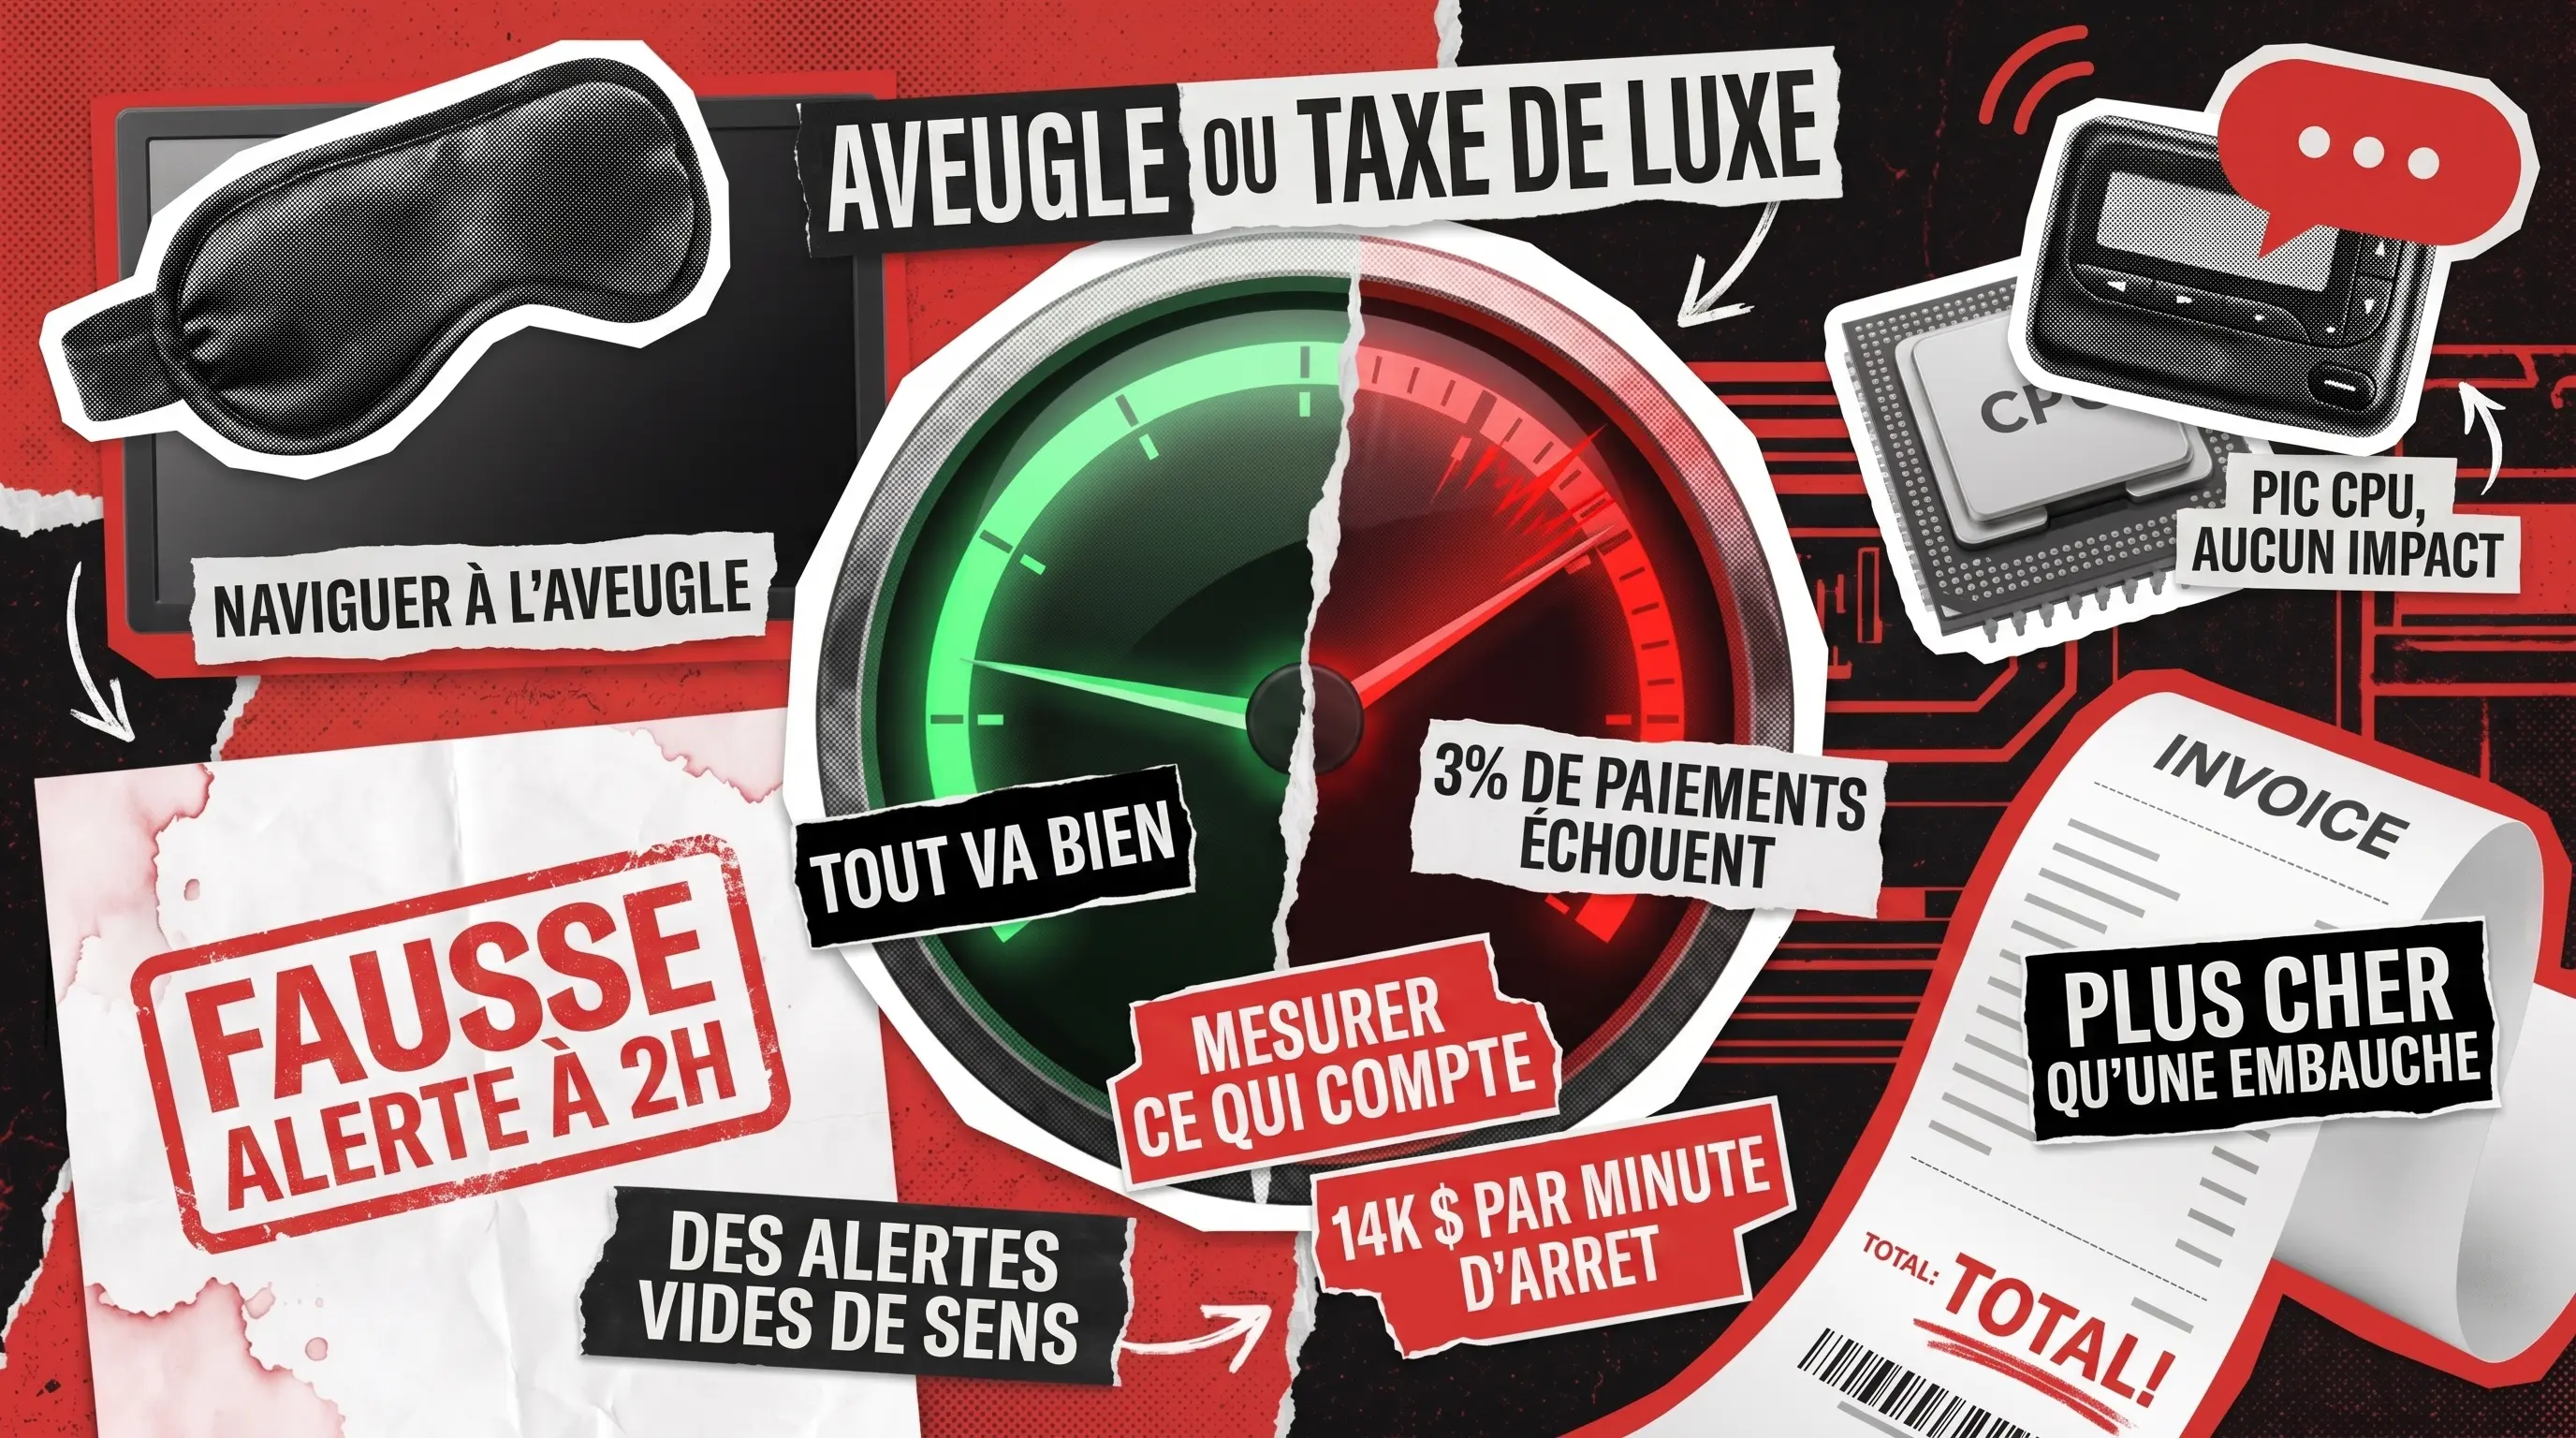
Le parcours vers une observabilité SaaS optimale commence généralement par l’un de ces deux pièges extrêmes et accidentels. Au départ, la plupart des fondateurs optent pour la solution de facilité. Ils ne suivent absolument rien, déploient des fonctionnalités à une vitesse fulgurante et supposent naïvement que tout va bien jusqu’à ce qu’un utilisateur exaspéré dénonce un bug critique sur les réseaux sociaux. Paniqués, ils basculent brutalement dans l’autre extrême : l’achat d’une plateforme de supervision massive et professionnelle avant même d’atteindre 500 utilisateurs actifs. Trois mois plus tard, la facture s’élève à un montant supérieur au coût de leur premier recrutement d’ingénieur.
Les deux voies sont incroyablement douloureuses, vous laissant soit complètement dans l’ignorance, soit complètement ruiné.
Cependant, développer votre startup ne devrait pas donner l’impression de choisir entre un bandeau sur les yeux et une taxe de luxe.
Il existe une solution de compromis raisonnable, et tout est une question de timing. Forts de notre expérience dans la conception et la maintenance de logiciels pour plus de 250 clients, nous, chez Redwerk, avons constaté une tendance constante : le problème n’est pas que les équipes suivent trop ou pas assez d’informations, mais qu’elles suivent les mauvaises informations au mauvais moment.
Vous n’avez pas à laisser vos outils avaler vos marges. Pour vous aider à trouver ce point d’équilibre parfait, nous avons élaboré un guide étape par étape basé sur notre expérience en développement de produits SaaS. Que vous soyez une équipe dynamique cherchant encore l’adéquation produit-marché ou une plateforme en plein essor dépassant 100 000 utilisateurs actifs mensuels, ce guide vous montrera exactement ce qu’il faut suivre aujourd’hui, ce que vous pouvez ignorer sans risque jusqu’à demain, et le piège de sur-monitoring le plus important à éviter. Mettons de l’ordre dans votre système.#x2019;ve laid out a stage-by-stage playbook based on our experience in développement de produits SaaS. Whether you’re a scrappy team still looking for product-market fit or a booming platform scaling past 100,000 monthly active users, this guide will show you exactly what to track today, what you can safely ignore until tomorrow, and the single biggest over-monitoring trap to steer clear of. Let’s get your system sorted.
Qu’est-ce que l’observabilité pour les applications SaaS, et en quoi diffère-t-elle de la surveillance ?
L’observabilité est votre capacité à comprendre ce qui se passe à l’intérieur de votre application SaaS à partir des signaux qu’elle produit : erreurs, temps de réponse, journaux et traces. Elle vous permet de répondre à la question « pourquoi est-ce cassé ? » et pas seulement « est-ce cassé ? », ce qui est la différence entre un tableau de bord avec un voyant d’avertissement et un tableau qui vous indique quel cylindre est défaillant.
Le monitoring est la discipline plus étroite qui en découle. Vous définissez une limite, et le système vous alerte lorsqu’une métrique la franchit. L’observabilité va plus loin, en vous fournissant les données brutes pour investiguer des pannes que vous n’aviez pas anticipées. Les deux comptent, mais les startups paient souvent pour des outils d’observabilité lourds alors qu’un monitoring solide est tout ce dont elles ont besoin, et c’est là que les coûts explosent. Ce que vous surveillez et ce que vous dépensez doit correspondre à votre étape de croissance, ce que le reste de ce guide détaille.
Que faut-il surveiller dans une application SaaS ? 4 signaux à instrumenter dès le premier jour
Ces quatre signaux appartiennent à tout produit SaaS dès le premier jour, que vous ayez dix utilisateurs ou dix mille.
- Taux d’erreur sur vos flux utilisateurs principaux
Choisissez les trois ou quatre flux de travail que votre produit est destiné à soutenir, comme l’inscription, la connexion et la réalisation d’un achat. Ensuite, instrumentez chacun pour voir s’il réussit ou échoue. Suivi de manière cohérente, ce seul signal surpasse cent tableaux de bord d’infrastructure, car vous n’avez pas besoin de savoir pourquoi quelque chose a échoué tant que vous ne savez pas que ça échoue. - Temps de réponse API sur vos chemins critiques
Suivez la latence du 95e percentile (p95) sur vos points de terminaison les plus utilisés, pas la moyenne, car une moyenne cache silencieusement vos pires cas. Une réponse typique de 200 ms semble correcte jusqu’à ce que vous découvriez que 5 % des utilisateurs attendent quatre secondes, et ces réponses lentes touchent souvent vos clients à plus haute valeur. - Monitoring de disponibilité via un ping externe
Celui-ci est simple à configurer et est bien trop souvent omis. Un outil gratuit qui vérifie si votre application est accessible depuis le monde extérieur ne coûte rien et a économisé des millions à des entreprises. Selon l’analyse 2024 d’EMA Research, les temps d’arrêt non planifiés coûtent désormais aux organisations une moyenne de 14 056 € par minute. Une vérification externe est l’assurance la moins chère contre le fait d’entendre parler d’une panne par un client en premier. - Journaux d’erreurs visibles par l’utilisateur avec suffisamment de contexte pour reproduire la panne
Les journaux qui disent « erreur 500 » sans détails sur l’utilisateur, la requête ou l’état du système sont presque inutiles. Dès le premier jour, vos journaux doivent fournir suffisamment de contexte pour diagnostiquer une panne sans avoir à reconstruire le parcours de l’utilisateur de mémoire. Cela demande de la discipline dans la façon dont vous écrivez les instructions de journal, pas des outils coûteux.
The maintenance logicielle Redwerk aide les équipes SaaS à établir ces bases tôt, avant que le coût de correction des lacunes ne s’accumule.
Étape 1 : Observabilité SaaS pré-PMF (moins de 10 000 utilisateurs actifs mensuels) avec un budget mensuel de 0 à 50 $
À cette étape, vous n’optimisez pas un système fini mais exécutez plutôt une expérience. L’objectif avant l’adéquation produit-marché n’est pas une couverture exhaustive. Vous devriez plutôt viser à détecter les échecs qui vous coûtent la confiance des utilisateurs ou vous empêchent d’apprendre comment les gens utilisent le produit.
Les quatre signaux toujours actifs qui couvrent la plupart de ce dont vous avez besoin consistent à ajouter des journaux d’erreurs structurés avec le contexte utilisateur et de session, puis à placer le taux d’erreur, la latence et la disponibilité sur un seul tableau de bord afin de pouvoir répondre à une question en moins de deux minutes : « Quelque chose est-il cassé pour un utilisateur en ce moment ? »
Rien de tout cela ne doit coûter de l’argent pour l’instant. Le niveau gratuit de Sentry gère le suivi des erreurs et le contexte de session, UptimeRobot couvre la disponibilité externe, et AWS CloudWatch (le service de monitoring d’Amazon Web Services) et Grafana Cloud offrent tous deux des niveaux gratuits pour les métriques de base et l’agrégation de journaux à faible trafic.
À ignorer :
- Le traçage distribué complet, qui est puissant mais coûteux à exécuter et inutile jusqu’à ce que vous ayez la complexité de service pour le justifier.
- Le profilage par requête, qui affine un produit avant que vous ayez confirmé que quelqu’un le veut.
- La rétention à long terme des journaux est inutile, car 14 jours suffisent pour diagnostiquer presque tout problème à ce stade.
Étape 2 : Observabilité des SaaS en phase de croissance initiale (10 000 à 100 000 utilisateurs actifs mensuels) avec un budget mensuel de 200 à 500 $
Vous avez trouvé quelque chose que les utilisateurs veulent. Le trafic monte, votre équipe s’agrandit probablement, et les échecs ont désormais un vrai coût métier. C’est là que l’observabilité passe de « agréable à avoir » à ce qui vous permet d’avancer vite sans perdre la confiance.
Commencez à suivre les métriques au niveau de l’application comme l’adoption des fonctionnalités et les taux d’activation, afin que si l’activation chute de 15 % le lendemain d’un déploiement, vous le détectiez avant que les e-mails de plainte n’arrivent. Ajoutez le traçage distribué à vos deux ou trois flux les plus critiques pour l’activité, comme le paiement, l’intégration et la fonctionnalité principale sur laquelle vos meilleurs clients comptent quotidiennement. Définissez des objectifs de niveau de service (SLO), qui sont des cibles de performance mesurables comme « 99,5 % des requêtes de connexion réussissent en moins de 800 ms », et construisez des alertes dessus qui correspondent à des résultats visibles pour le client plutôt qu’à des métriques d’infrastructure brutes.
Ajoutez également l’agrégation de journaux avec recherche, car à 10 000 MAU, vous ne pouvez plus lire les journaux dans une console ou vous appuyer sur l’accès SSH (écran sécurisé) à vos serveurs. Le niveau payant de Grafana Cloud, Better Uptime, Sentry Team et un backend compatible OpenTelemetry comme Axiom ou Highlight.io couvrent tout cela pour bien moins de 500 € par mois.
Ce qu’il faut éviter :
- Traçer chaque service de bout en bout, ce qui est encore plus que nécessaire à ce niveau de trafic.
- L’enregistrement de session au niveau de l’infrastructure, car des outils d’analyse produit comme PostHog le font moins cher et mieux.
- Les agents APM (Application Performance Monitoring) coûteux sur chaque conteneur, qui gonflent votre facture pour un gain marginal.
C’est également l’étape où les bonnes décisions d’architecture DevOps, prises tôt, rapportent plusieurs fois leur investissement. L’équipe de conseil DevOps de Redwerk aide les équipes SaaS à concevoir une instrumentation et des pipelines qui évoluent sans forcer une reconstruction à l’étape de croissance suivante.
Étape 3 : Observabilité SaaS à grande échelle (plus de 100 000 utilisateurs actifs mensuels) avec un budget mensuel de 2 000 à 5 000 $
Au-delà de 100 000 MAU, vous exploitez un produit mature sous forte charge, et les enjeux d’un incident de production sont bien plus élevés. La question n’est plus de savoir si investir, mais comment investir dans les bons signaux tout en évitant la prolifiration d’outils qui fait exploser les coûts à 2 ou 3 fois le budget prévu.
Le traçage distribué complet sur tous les services est maintenant justifié par votre complexité, votre trafic et votre cas métier. Ajoutez le monitoring des utilisateurs réels (RUM) pour les performances frontend, car le comportement de votre application dans un vrai navigateur diffère souvent de vos tests synthétiques, et à cette échelle, cet écart se manifeste dans la conversion et la rétention.
Introduisez le monitoring des performances des requêtes de base de données, car les requêtes lentes sont une cause principale de pics de latence et de pannes en cascade, mais restent invisibles sans lui. Suivez les budgets d’erreur par rapport à vos SLO, où le budget correspond au temps d’arrêt que votre cible autorise (99,9 % de disponibilité vous laisse 8,7 heures par an), ce qui transforme la fiabilité en une décision métier concrète. Ajoutez l’attribution des coûts afin de savoir quelles fonctionnalités ou segments consomment le plus d’infrastructure lors de vos décisions de tarification et de feuille de route.
Ce qu’il faut encore éviter :
- Le profilage par requête en production, sauf si vous cherchez un problème spécifique confirmé ; échantillonnez 1 % des requêtes à la place.
- La rétention indéfinie des journaux ; gardez les journaux consultables pendant 30 jours et archivez-les à moindre coût au-delà.
Pour les outils, Datadog, Honeycomb, Grafana Enterprise ou une pile OpenTelemetry auto-hébergée avec ClickHouse fonctionnent tous bien, bien que les coûts varient considérablement. Datadog en particulier mérite une gestion budgétaire attentive. Son monitoring d’infrastructure commence à 15 € par hôte par mois, et les modules comme l’APM et la gestion des journaux sont tarifés séparément, de sorte que les factures arrivent souvent 2 à 3 fois supérieures à l’estimation initiale. Allez-y les yeux ouverts.
L’erreur #1 d’observabilité SaaS : sur-alerter sur des indicateurs d’infrastructure qui ne prédisent pas la douleur client
Nous avons vu ce schéma dans des dizaines d’équipes SaaS. Elles branchent un tableau de bord et configurent des alertes sur l’utilisation du CPU (unité centrale de traitement), la mémoire, les E/S disque et le débit réseau, et se sentent couvertes. Puis elles sont réveillées à 2 h du matin parce que le CPU a picé à 80 % lors d’une tâche batch planifiée, investiguent pendant 45 minutes, ne trouvent rien d’anormal pour les utilisateurs, et retournent se coucher frustrées. Entre-temps, un bogue du déploiement précédent fait silencieusement échouer 3 % des flux de paiement sans aucune alerte parce que personne n’a instrumenté ce flux.
Les métriques d’infrastructure ne sont pas inutiles, mais elles sont un moyen, pas une fin. Un serveur à 90 % d’utilisation mémoire ne vaut pas, en soi, la peine d’être réveillé. Le même serveur qui pousse la latence p95 sur votre point de terminaison de paiement au-delà de deux secondes, si. La différence est de savoir si vous avez connecté le signal à un résultat visible pour le client.
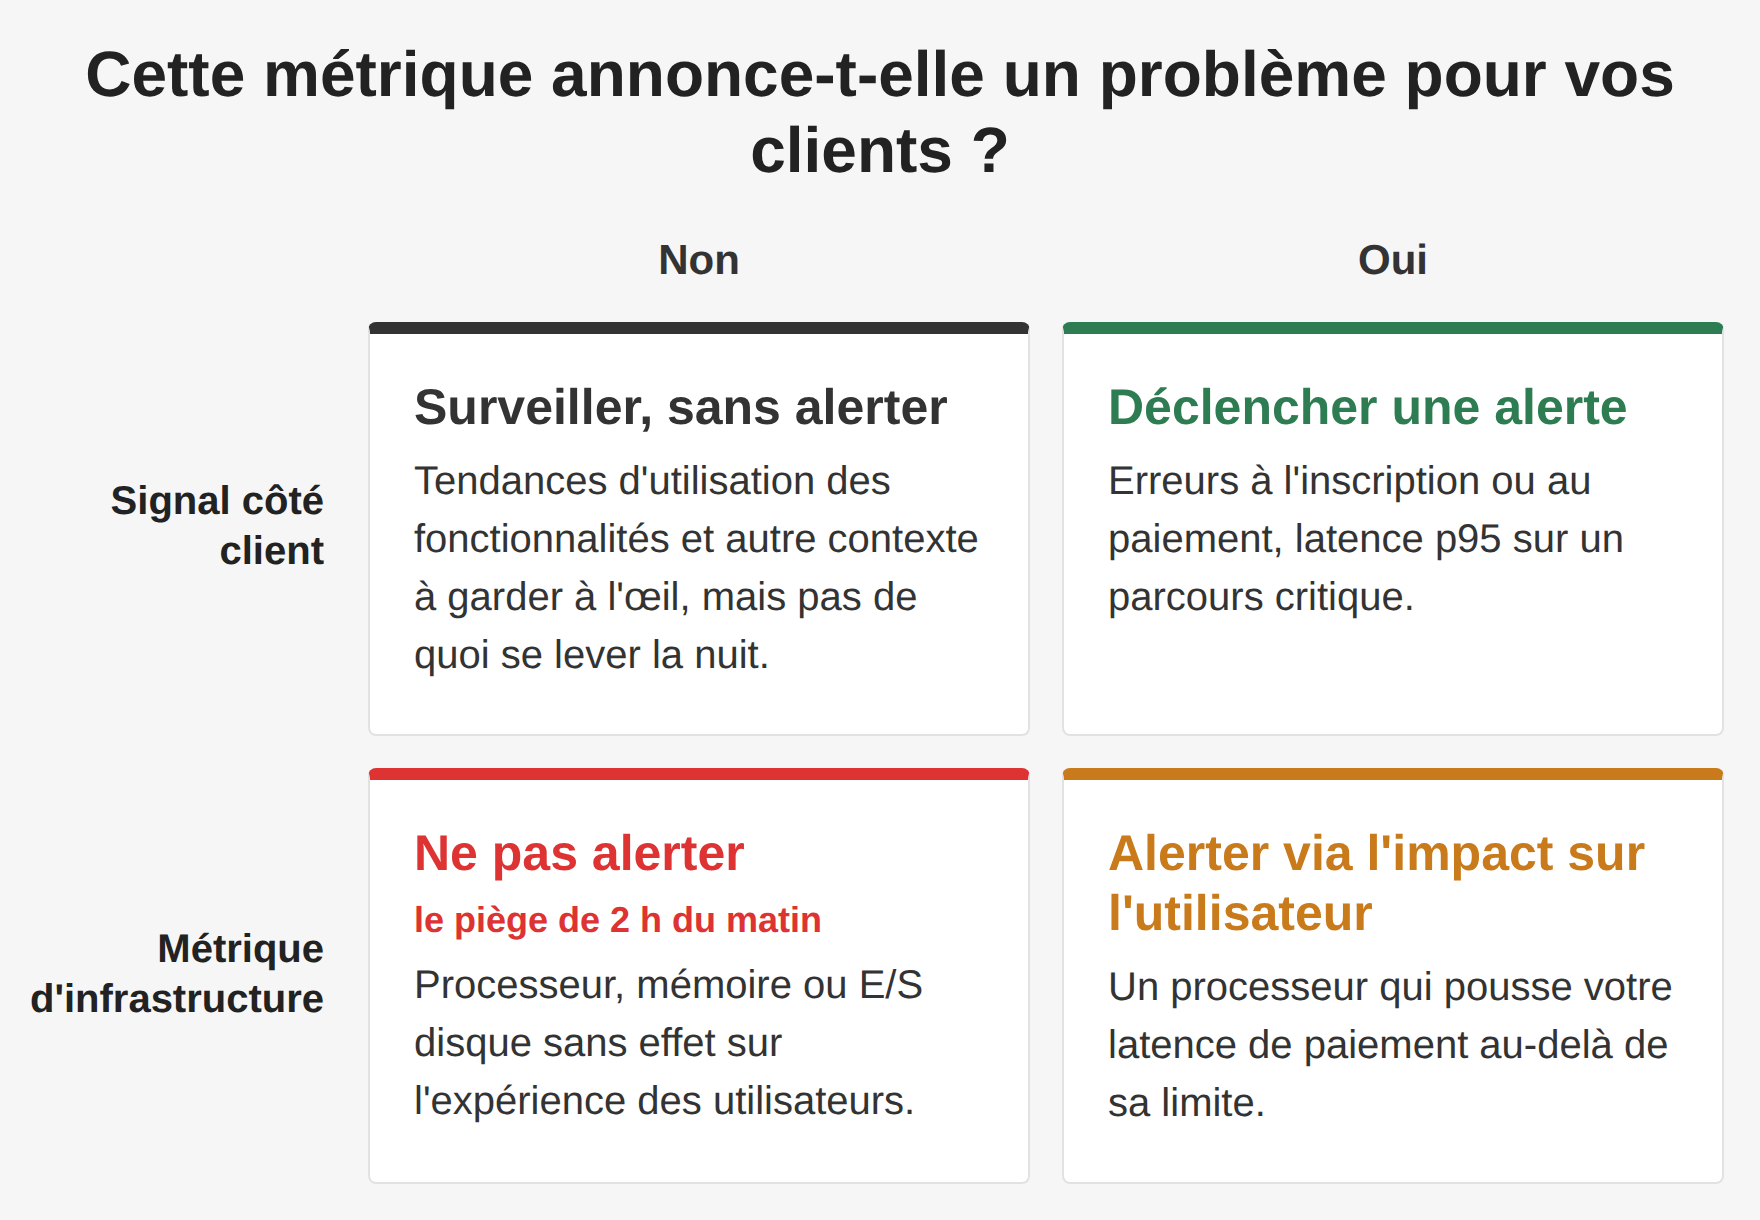
Voici donc la règle que nous suggérons d’appliquer avant de configurer toute alerte : elle doit se rattacher à quelque chose qu’un client vivrait. Si vous ne pouvez pas compléter la phrase « si cela se déclenche et que nous l’ignorons, le client vivra ____ », ça ne devrait alerter personne.
Construisez les alertes de haut en bas plutôt : définissez à quoi ressemble une expérience dégradée pour chaque flux critique en termes mesurables, puis instrumentez les signaux qui la prédisent. La plupart des équipes travaillent dans le sens inverse, gaspillant du temps d’ingénierie à chasser le bruit plutôt qu’à prévenir les problèmes.
Comment choisir les outils d'observabilité SaaS : un cadre de décision simple
Le bon ordre pour choisir les outils d’observabilité est simple, mais la plupart des équipes le sautent :
- Premièrement, cartographiez vos trois flux utilisateurs les plus critiques, ceux qui feraient qu’un client annule ou appelle le support en cas de panne.
- Deuxièmement, définissez ce que « cassé » signifie pour chacun en termes mesurables : un délai d’expiration de plus de trois secondes, un code d’erreur, ou une défaillance silencieuse où la réponse indique 200 mais rien ne s’est passé en aval.
- Troisièmement, demandez-vous quel signal révélerait cette défaillance avant la première plainte, et instrumentez cela en premier.
- Quatrièmement, ouvrez la page de tarification de l’outil, car l’outil doit correspondre aux signaux dont vous avez besoin, pas l’inverse.
Bien configurer l’observabilité dès le départ détermine la rapidité avec laquelle vous diagnostiquez les problèmes, le temps que vous perdez à cause de fausses alarmes et la confiance avec laquelle vous livrez. Que vous construisiez un produit SaaS ou que vous le fassiez évoluer au-delà du point où votre configuration actuelle vous freine. L’équipe Redwerk fait cela depuis plus de 20 ans. Nous construisons des produits SaaS avec une observabilité prête pour la production incluse, pas ajoutée après coup, afin que vous partiez avec les signaux qui comptent et un chemin clair pour évoluer au fur et à mesure de votre croissance. Si vous êtes prêt, contactez-nous et établissons le bon cadre d’observabilité pour vous.
FAQ
Qu’est-ce que l’observabilité SaaS ?
L’observabilité SaaS est la pratique de collecte et d’analyse des signaux d’une application SaaS, notamment les erreurs, les temps de réponse, les journaux et les traces de requêtes, pour comprendre le comportement du système et pourquoi les problèmes surviennent. Un système bien observé permet à votre équipe de diagnostiquer rapidement les pannes inattendues, plutôt que de seulement détecter qu’une panne existe.
Quelle est la différence entre le monitoring et l’observabilité ?
Le monitoring vérifie si des conditions prédéfinies sont remplies, par exemple si la disponibilité reste au-dessus de 99,9 % ou si les taux d’erreur restent en dessous d’un seuil. L’observabilité fournit des données brutes pour investiguer des conditions que vous n’aviez pas anticipées. Le monitoring vous dit que quelque chose ne va pas. L’observabilité vous dit pourquoi. La plupart des équipes SaaS en phase initiale ont bien plus urgement besoin d’un bon monitoring que d’outils d’observabilité complets.
Que devriez-vous surveiller dans une application SaaS ?
Au minimum, surveillez si vos flux utilisateurs principaux réussissent ou échouent, la rapidité de réponse de vos points de terminaison les plus utilisés, si l’application est accessible depuis le monde extérieur et si vos journaux d’erreurs contiennent suffisamment de contexte pour diagnostiquer les pannes. Ce que vous ajoutez au-delà doit être déterminé par votre stade de croissance, la complexité architecturale et votre budget.
Quelle est la façon la moins chère de surveiller une application SaaS ?
La configuration la plus légère et efficace pour un produit pré-PMF combine le niveau gratuit de Sentry pour le suivi des erreurs, UptimeRobot pour la disponibilité externe et le niveau gratuit d’AWS CloudWatch ou de Grafana Cloud pour les métriques. Ensemble, ils couvrent les quatre signaux toujours actifs dont chaque produit a besoin, et vous pouvez avoir toute la pile opérationnelle en une seule journée de travail.
Quand une startup devrait-elle commencer à investir dans des outils d’observabilité payants ?
Le déclencheur n’est pas un nombre d’utilisateurs ni un chiffre de revenus. C’est le moment où votre configuration de niveau gratuit commence à jouer contre vous : les alertes génèrent plus de bruit que de signal, les incidents mettent plus de 30 minutes à être diagnostiqués, ou vos fenêtres de rétention sont trop courtes pour investiguer les problèmes qui comptent. Dès que l’un de ces points devient routinier, les outils payants rentabilisent leur coût en temps d’ingénierie récupéré.
Découvrez comment nous avons construit un SaaS de recrutement acquis par une société cotée au Nasdaq avec une capitalisation boursière de plus de 250 millions