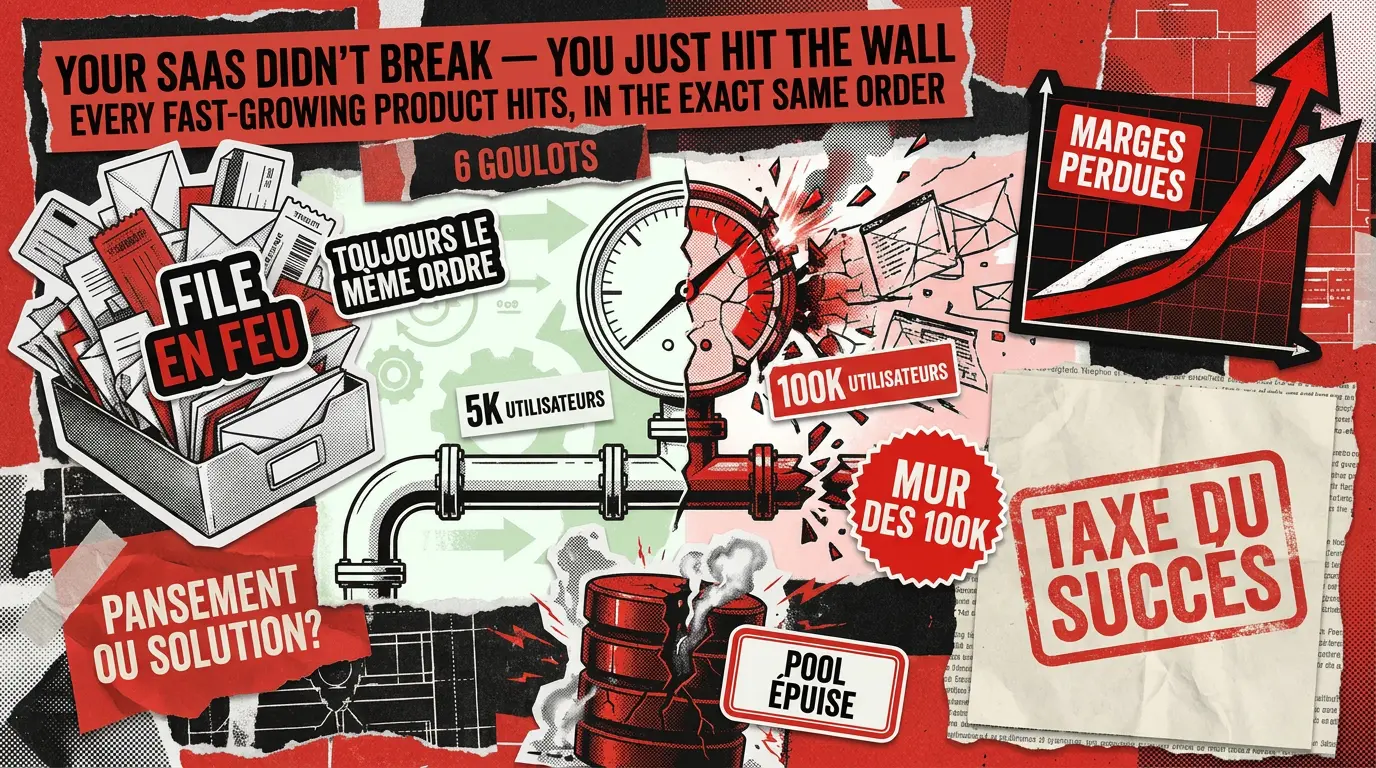
Personne ne vous prévient du moment exact où le succès de votre SaaS commence à ressembler à une punition, car le besoin de mise à l’échelle vous prend souvent de court. Cela arrive généralement du jour au lendemain : le produit qui fonctionnait parfaitement à 5 000 utilisateurs commence à vaciller à 30 000, et à 80 000, il est officiellement sous perfusion. Soudain, votre boîte de support est en feu, vos ingénieurs ont abandonné votre feuille de route pour devenir des pompiers à temps plein, et votre facture d’infrastructure augmente bien plus vite que votre compte bancaire.
Si cela vous semble douloureusement familier, respirez profondément. Vous n’avez pas construit un mauvais produit, et votre équipe n’a pas oublié comment coder. Vous payez simplement la « taxe du succès ».
La vérité réconfortante est que rien de ce chaos n’est aléatoire. Après deux décennies de construction et de mise à l’échelle de projets de développement SaaS de développement SaaS, nous avons remarqué un schéma définitif : les goulots d’étranglement aiment les horaires. Ils arrivent dans une séquence très prévisible, déclenchée par des jalons de comptage d’utilisateurs très spécifiques.
Si votre équipe sait exactement ce qui arrive, vous pouvez réparer la plomberie avant que vos clients ne remarquent la moindre fuite. C’est l’ingrédient secret qui sépare les géants SaaS qui grandissent sans effort de ceux qui se noient dans la dette technique et le churn.
Chez Redwerk, nous avons réalisé plus de 250 projets logiciels. Autrement dit, nous avons suffisamment d’expérience de ce scénario catastrophe pour savoir précisément quand le problème va surgir.
Considérez cet article comme votre guide ultime de survie. Nous y décortiquons les six principaux points de blocage prévisibles, les étapes précises auxquelles ils surviennent, les signes avant-coureurs à surveiller et, surtout, la différence entre une solution de fortune et une solution durable. Entrons dans le vif du sujet.
Mise à l’échelle d’un SaaS : référence rapide pour le diagnostic des goulots d’étranglement
Le tableau ci-dessous résume les six goulots d’étranglement couverts dans cet article. Utilisez-le comme fiche de référence lorsque vous essayez de faire correspondre ce que vous voyez en production à sa cause probable.
Épuisement du pool de connexions à la base de données
~20 K
Délais d’expiration aléatoires sur des actions qui étaient rapides hier
Connexions actives vs. maximum du pool ; temps d’attente des requêtes ; erreurs « trop de connexions »
Augmenter la taille du pool, ajouter des répliques en lecture
Regroupeur de connexions (PgBouncer) ; séparer les chemins lecture/écriture
Saturation de la file de tâches en arrière-plan
~40 K
E-mails arrivant avec 20 minutes de retard ; exports bloqués
Tendance de profondeur de file ; âge de la tâche au traitement ; temps d’attente vs. temps d’exécution du worker
Ajouter plus de workers
Files de priorité ; limiter le débit d’ingéstion
Chaos d’invalidation du cache
~60 K
Données obsolètes après enregistrement ; tableaux de bord incohérents
Taux de frappe du cache ; audit TTL ; vérification des collisions de clés inter-locataires
Réduire les TTL globalement
Invalidation basée sur les balises ou événementielle par locataire
Dégradation par voisin bruyant
~80 K
Certains grands comptes ralentissent de manière imprévisible
Temps de requête par locataire ; utilisation des ressources partagées par ID locataire
Limiter manuellement le locataire le plus bruyant
Partitionnement des ressources par niveau de locataire ; pools de calcul dédiés
Inversion du coût par utilisateur
~100 K
Rien de visible encore, mais les marges se compriment
Tendance du coût par utilisateur actif ; ratio de ressources oisives ; dépenses vs. revenus par cohorte
Instances réservées, calcul spot, dimensionnement approprié
Attribution des coûts par locataire ; marquage des charges de travail lourdes
Effondrement de la mise à l’échelle organisationnelle et des processus
~150 K
Les fonctionnalités ralentissent ; les incidents prennent plus de temps à résoudre
Tendances MTTD/MTTR ; fréquence de déploiement ; ratio ingénierie réactive vs. proactive
Plus de réunions de processus et de coordination
Frontières de propriété alignées sur les services ; runbooks ; investissement en observabilité
Ce que signifie concrètement « développer une entreprise SaaS » à chaque étape
La plupart des équipes abordent une conversation sur la mise à l’échelle en pensant aux performances : aller plus vite, traiter plus de requêtes. Ce cadrage n’est pas faux, mais il est incomplet. La mise à l’échelle signifie réellement identifier ce qui va casser ensuite et y remédier avant que les utilisateurs ne s’en aperçoivent.
Chaque étape de croissance introduit une contrainte dominante. L’instinct de jeter des ressources de calcul sur un problème ou de réécrire toute l’architecture à la fois tend à être coûteux précisément parce qu’il néglige ce point. La bonne démarche est presque toujours plus ciblée : trouvez la contrainte spécifique à votre étape actuelle, corrigez-la correctement et instrumentez pour la suivante.
Les six sections ci-dessous parcourent chaque contrainte dans l’ordre où elle arrive typiquement.
1. Pourquoi les services SaaS ralentissent-ils à partir de 20 000 utilisateurs ? : Épuisement du pool de connexions à la base de données
Des actions rapides depuis des mois commencent à expirer de manière intermittente. Les échecs tendent à se concentrer pendant les heures de bureau, quand l’utilisation concurrente est la plus élevée, puis disparaissent le soir. Les utilisateurs ouvrent des tickets, votre équipe vérifie la base de données et la trouve bien en deçà de sa capacité. Que se passe-t-il donc ?
Pourquoi cela se produit lors de la mise à l’échelle d’un SaaS
Votre application maintient un pool de connexions de base de données ouvertes que les requêtes peuvent emprunter et restituer. Avec peu d’utilisateurs, ce pool est suffisamment grand par rapport à la demande concurrente. Lorsque votre nombre d’utilisateurs actifs mensuels (MAU) monte vers 20 000, le nombre de requêtes simultanées dépasse finalement le pool. Les nouvelles requêtes se mettent en file d’attente en attendant qu’une connexion se libère. Si l’attente dépasse le délai d’expiration, l’utilisateur voit une erreur. Pendant ce temps, la base de données elle-même semble bien fonctionner car le goulot se trouve dans la couche de gestion des connexions, pas dans le moteur de base de données.
Ce scénario est plus courant que la plupart des équipes ne l’attendent. Comme l’a découvert une équipe d’ingénierie après avoir profilé son propre système, l’épuisement du pool de connexions peut provoquer des pics de latence P99 même quand la base de données elle-même est à 47 % d’utilisation. Ce qui ressemble à un problème de capacité de base de données est en réalité une congestion dans la file d’attente de connexions.
3 signes à rechercher dans votre système
- Nombre de connexions actives vs. maximum de pool configuré (êtes-vous régulièrement au plafond ?)
- Temps d’attente des requêtes dans la vue d’activité des processus de votre base de données (pg_stat_activity dans PostgreSQL, ou l’équivalent dans votre moteur)
- Journaux d’erreurs pour « trop de connexions », « pool épuisé » ou messages similaires, croisés avec les horodatages des plaintes des utilisateurs
Soulagement rapide vs. solution durable
Le correctif temporaire consiste à augmenter la taille de votre pool et à ajouter des répliques en lecture pour gagner du temps. La correction architecturale consiste à introduire un regroupeur de connexions dédié, tel que PgBouncer en mode transaction, qui multiplexe de nombreuses connexions applicatives en beaucoup moins de connexions à la base de données. En parallèle, découpler votre chemin de lecture (requêtes tableau de bord, reporting) de votre chemin d’écriture afin qu’ils ne se disputent pas le même pool.
2. Un problème courant de mise à l'échelle des SaaS à 40 000 utilisateurs : saturation de la file d'attente des tâches en arrière-plan
Les confirmations d’e-mail qui devraient arriver en secondes prennent maintenant 20 minutes. Les exports de fichiers qui étaient prêts instantanément affichent un spinner pendant longtemps, puis échouent silencieusement. Les webhooks vers les systèmes de vos clients cessent de se livrer. Aucun de ces échecs n’apparaît comme des erreurs sur votre tableau de bord principal, ce qui rend ce goulot particulièrement insidieux.
Pourquoi cela se produit-il lors de la mise à l’échelle d’une application SaaS ?
Au fur et à mesure que votre nombre d’utilisateurs augmente, le volume de travail que votre système de tâches en arrière-plan doit traiter augmente avec lui, souvent plus vite que le nombre d’utilisateurs lui-même car de nombreuses actions utilisateur déclenchent plusieurs tâches en arrière-plan. Finalement, la file s’accumule plus vite que vos workers ne peuvent la vider. Les nouvelles tâches attendent derrière un backlog. Les tâches sensibles au temps comme les e-mails font la queue derrière de lourds exports par lots. Les workers semblent occupés, mais la plupart de leur temps réel est passé à attendre, pas à s’exécuter.
C’est particulièrement dangereux car les échecs sont silencieux. Les clients entreprise le remarquent avant vous, car leurs intégrations webhook commencent à manquer des événements. Au moment où les tickets de support arrivent, la confiance a déjà été érodée.
3 signes à surveiller dans votre système
- Tendance de profondeur de file sur les 24 dernières heures (augmente-t-elle au cours de la journée au lieu de rester stable ?)
- Âge de la tâche au moment du traitement (les tâches attendent-elles 15 minutes avant de démarrer ?)
- Ratio CPU vs. temps réel des workers (des workers qui passent la plupart de leur temps à attendre plutôt qu’à s’exécuter signalent un goulot de débit, pas de capacité)
Soulagement rapide ou solution durable
Le correctif rapide consiste à ajouter plus de workers. Cela aide temporairement mais crée souvent un nouveau problème : les tâches par lots lourdes entrent en compétition avec les tâches sensibles au temps destinées aux utilisateurs, et la file se remplit à nouveau en quelques semaines. La correction architecturale est la mise en place de files prioritaires, avec des files dédiées séparées pour les tâches orientées utilisateurs (émails, notifications in-app, livraison de webhooks) et le travail interne par lots (exports, agrégation analytique, indexation de recherche). Associez cela à une limitation du débit côté ingéstion afin qu’un pic soudain de nouveaux événements ne puisse pas enterrer votre file prioritaire.
3. Données obsolètes et tableaux de bord dysfonctionnels : problèmes d’invalidation du cache chez 60 000 utilisateurs
Un utilisateur enregistre une modification, et la page affiche toujours les anciennes données. Deux personnes sur le même compte voient des chiffres différents dans le même tableau de bord. Un enregistrement supprimé continue de réapparaître, et votre équipe de support commence à les enregistrer comme des bogues. Quand votre équipe d’ingénierie enquique, les données sous-jacentes dans la base de données sont correctes ; le cache sert simplement une version obsolète.
Pourquoi cela se produit-il lors de la mise à l’échelle d’une application SaaS ?
La mise en cache est l’un des outils les plus efficaces pour réduire la charge de la base de données lors de la mise à l’échelle d’un produit SaaS. Cependant, l’invalidation du cache—décider quand une valeur mise en cache n’est plus valide et doit être remplacée—est véritablement l’un des problèmes les plus difficiles des systèmes distribués. À 60 000 MAU, les modes d’échec qui étaient gérables à plus petite échelle deviennent visibles. Dans les environnements multi-locataires, un problème courant est les collisions de clés de cache : les données de deux locataires sont indexées de manière chevauchante, de sorte que l’écriture d’un locataire sert accidentellement des données obsolètes à un autre. Un autre problème est la sur-dépendance à l’expiration TTL, ce qui signifie que les données obsolètes persistent aussi longtemps que le TTL, même si l’enregistrement sous-jacent change quelques secondes après l’écriture du cache.
3 signes à surveiller dans votre système
- Taux de frappe du cache ventilé par point de terminaison (une chute soudaine du taux de frappe précède souvent des plaintes visibles sur les données obsolètes)
- Audit de la distribution TTL sur vos objets en cache (les objets à fort trafic utilisent-ils des TTL plus longs que la tolérance de vos utilisateurs aux données obsolètes ?)
- Vérification des collisions de clés de cache inter-locataires dans votre environnement multi-locataire (vos clés sont-elles suffisamment limitées au locataire et à la version de la ressource ?)
Soulagement rapide ou solution durable
La première chose à faire est de réduire les TTL sur l’ensemble. Cela réduit la fenêtre pour les données obsolètes mais augmente considérablement la charge de la base de données, ce qui déclenche souvent d’autres problèmes. La solution au niveau architectural est de passer à une invalidation basée sur les balises ou événementielle, où une écriture sur une ressource invalide explicitement toutes les vues en cache de cette ressource, indexées par ID de locataire et version de la ressource. En parallèle, passer à la mise en cache en écriture directe sur vos chemins de lecture les plus sollicités, afin que le cache et la base de données soient mis à jour ensemble à chaque écriture. Pour plus de conseils sur la structuration de l’isolation des locataires dans votre couche de cache, consultez notre guide sur les meilleures pratiques d’architecture SaaS multi-locataire.
4. Dégradation due aux voisins bruyants : un défi de mise à l’échelle SaaS multi-locataires à 80 000 utilisateurs
Vos plus grands comptes, les plus précieux, commencent à se plaindre de ralentissements. Le moment est incohérent et ne se corrèle avec rien d’évident de leur côté. Ce qui ressemble à leur problème est en réalité causé par un autre compte consommant l’infrastructure partagée en même temps.
Pourquoi cela se produit-il lors de la mise à l’échelle d’une application SaaS ?
Dans une architecture multi-locataire, plusieurs clients partagent la même base de données, les mêmes serveurs d’application et l’infrastructure de cache. Un seul grand locataire dont l’utilisation est légitimement lourde—en exécutant un export complexe, en traitant une importation en masse ou en lançant des requêtes analytiques—peut consommer une part disproportionnée des ressources partagées. Les autres locataires sur cette même infrastructure voient leurs performances se dégrader. C’est le problème du voisin bruyant, et il devient typiquement visible autour de 80 000 MAU, car c’est généralement quand la distribution des tailles de locataires devient suffisamment large pour que les locataires les plus lourds entrent vraiment en compétition avec tous les autres.
3 signes à surveiller dans votre système
- Percentiles de temps de requête par locataire (vos périodes P95 les plus lentes se corrèlent-elles avec un ou deux ID de locataires spécifiques consommant plus de ressources que les autres ?)
- Utilisation des ressources partagées ventilée par ID de locataire (IOPS de stockage, nombre de connexions, CPU)
- Nombre de connexions par locataire pendant les fenêtres de plainte
Soulagement rapide ou solution durable
Le correctif temporaire consiste à limiter manuellement le débit du locataire le plus bruyant lorsqu’une plainte arrive. C’est réactif, cela nuit à votre relation avec ce locataire et ne prévient pas la répétition du même scénario la semaine suivante avec un locataire différent. La solution architecturale est le partitionnement des ressources basé sur le niveau de locataire : les comptes à forte utilisation obtiennent des pools de calcul dédiés ou des schémas de base de données avec leurs propres allocations de ressources, tandis que les petits comptes partagent un pool commun dimensionné de manière appropriée pour leurs modèles d’utilisation agrégés. Cela ouvre également un chemin naturel vers une tarification échelionnée, où les clients entreprise paient pour une infrastructure dédiée.
5. Quand la mise à l'échelle d'une entreprise SaaS devient coûteuse : Inversion du coût par utilisateur à 100 000 utilisateurs
Celui-ci est invisible pour vos clients, ce qui contribue à le rendre dangereux.
Ce que votre équipe remarque
La facture d’infrastructure a triplé au cours des six derniers mois. Votre nombre d’utilisateurs a augmenté d’environ 50 % dans la même période. Les calculs qui semblaient convaincants dans votre modèle d’économie unitaire ne fonctionnent plus. Selon le rapport 2025 de Flexera sur l’état du cloud, 84 % des organisations identifient la gestion des dépenses cloud comme leur principal défi, les budgets cloud dépassant déjà les prévisions de 17 % en moyenne. Les produits SaaS frappent ce mur de manière aiguë autour de 100 000 MAU, car c’est là que les inefficacités architecturales tolérables à plus petite échelle commencent à se compoundre en une véritable érosion des marges.
Les revenus SaaS augmentent par siège ou par plan. Les coûts d’infrastructure augmentent par interaction : chaque appel API (interface de programmation applicative), chaque requête de base de données, chaque gigaoctet stocké ou transféré. Quand ces courbes cessent d’être proportionnelles, vous avez une inversion du coût par utilisateur, et si vous ne corrigez pas l’architecture sous-jacente, l’inversion s’aggrave à mesure que vous grandissez.
3 signes à surveiller dans votre système
- Tendance du coût par utilisateur actif sur les 90 derniers jours (pas la dépense totale, mais la dépense divisée par MAU, suivie semaine après semaine)
- Ratio de ressources oisives (quel pourcentage de votre calcul provisionné est oisif pendant les heures creuses ?)
- Dépenses de calcul vs. revenus ventilés par cohorte de clients (certains niveaux de plan ou ensembles de fonctionnalités sont-ils véritablement non rentables aux coûts d’infrastructure actuels ?)
Soulagement rapide ou solution durable
Vous pouvez essayer le dimensionnement correct des instances, passer au calcul spot pour les charges de travail non critiques et acheter de la capacité réservée. Ces mesures valent la peine et doivent être mises en œuvre, mais ce sont des optimisations, pas de l’architecture. Corriger le problème au niveau architectural nécessite une attribution des coûts par locataire, afin de savoir exactement ce que chaque client coûte réellement à servir, et le marquage des fonctionnalités pour les charges de travail lourdes afin que les fonctionnalités intensives en ressources ne soient actives que pour les niveaux dont la tarification soutient le coût. De plus, un examen de vos politiques de rétention des données et de stockage des journaux révèle presque toujours un gaspillage significatif à ce stade : des données pour lesquelles vous payez le stockage et que personne ne consulte.
6. Le défi caché de la mise à l'échelle SaaS à 150 000 utilisateurs : effondrement de l'organisation et des processus
Les sorties de fonctionnalités ralentissent notablement. Quand quelque chose se casse, la résolution prend plus de temps qu’avant. L’intégration des clients, qui prenait une semaine, en prend maintenant trois. Votre NPS (net promoter score) commence à dériver vers le bas même si le produit lui-même ne s’est pas détérioré.
Ce que votre équipe remarque
Un déploiement en production nécessite maintenant de coordonner quatre personnes ou plus. Personne n’a une image claire de la façon dont tous les services interagissent. Quand un incident se produit, la moitié du temps est passée à déterminer à quelle équipe il appartient. Les tickets de support référencent des comportements que l’ingénierie ne peut pas reproduire dans un environnement de staging. Le ratio du travail réactif (corriger ce qui est déjà cassé) au travail proactif (construire ce qui n’a pas encore cassé) s’est silencieusement inversé.
Pourquoi cela se produit-il lors de la mise à l’échelle d’une application SaaS ?
C’est le goulot d’étranglement que la plupart des articles sur la mise à l’échelle d’un SaaS évitent, parce qu’il semble organisationnel plutôt que technique. Mais il est tout aussi prévisible et tout aussi dommageable que les cinq précédents. Autour de 150 000 MAU, le nombre de personnes dans votre équipe et le nombre de services dont elles sont responsables ont grandi au point où la coordination informelle ne fonctionne plus. La charge cognitive de maintien d’un contexte partagé devient trop élevée, ce qui ralentit les décisions. Un audit de développement logiciel à ce stade révèle souvent que les symptômes techniques—échecs de déploiement, bogues non reproductibles et lacunes de monitoring—sont en aval de problèmes structurels dans la manière dont la propriété et l’observabilité sont organisées.
3 signes à surveiller dans votre système
- Tendances du temps moyen de détection (MTTD) et du temps moyen de résolution (MTTR) pour les incidents sur les six derniers mois (les deux devraient diminuer à mesure que le produit mûrit ; s’ils augmentent, c’est un signal structurel)
- Fréquence de déploiement par équipe ou service (les déploiements deviennent-ils moins fréquents et plus cérémoniels ?)
- Ratio du travail d’ingénierie réactif au proactif sur le dernier trimestre (si l’équipe passe plus de 40 % de son temps en travail réactif, l’organisation a un problème structurel, pas seulement un problème de backlog)
Soulagement rapide ou solution durable
Le correctif temporaire consiste à ajouter plus de processus : plus de réunions, plus d’étapes d’approbation, plus d’exigences de documentation. Cela ressemble à des solutions car elles réduisent temporairement le chaos, mais elles ralentissent aussi tout le reste. La correction propre au niveau architectural aligne explicitement les frontières de propriété avec les services, de sorte que chaque composant du système a une équipe nommée responsable. Cela implique des rotations d’astreinte avec des runbooks écrits, pas seulement des connaissances informelles. Cela implique d’investir dans une plateforme d’observabilité afin que quand quelque chose casse, l’équipe puisse voir ce qui s’est passé et pourquoi, plutôt que de devoir le reproduire par tâtonnement.
Comment savoir à quel défi de mise à l'échelle SaaS vous êtes confronté actuellement ?
La séquence ci-dessus n’est pas rigoureuse à la journée près, mais elle est fiable dans son ordre. Donc, si votre produit est autour de 20 000 à 40 000 MAU et que vous voyez des délais d’expiration intermittents, commencez par la section 1. Si vous êtes autour de 60 000 à 80 000 MAU et que votre file de support se remplit de plaintes « les données semblaient incorrectes », commencez par la section 3. Si vous avez dépassé 100 000 MAU et que votre économie unitaire s’est silencieusement affaiblie, l’inversion du coût par utilisateur en section 5 est la cause la plus probable.
La discipline clé consiste à effectuer les vérifications des trois signes pour la section correspondant à votre étape actuelle avant de supposer que vous connaissez la réponse. Les symptômes à chaque étape peuvent sembler décevamment similaires de l’extérieur, et les corrections sont suffisamment différentes pour que les confondre soit coûteux. Une architecture logicielle bien conçue et évolutive est celle dans laquelle l’instrumentation pour le prochain goulot est déjà en place avant que le goulot ne survienne.
Quand faire appel à une aide extérieure pour relever les défis liés à la mise à l'échelle de votre produit SaaS
Le moment où la plupart des équipes cherchent une aide extérieure est généralement un goulot trop tard. Il existe trois signaux fiables indiquant que l’autodiagnostic n’est plus la bonne approche.
- Premièrement, votre monitoring ne couvre pas les signaux qui comptent pour votre étape actuelle. Vous ne pouvez pas corriger ce que vous ne pouvez pas mesurer, et si les trois signes ci-dessus ne renvoient aucune donnée, la lacune d’observabilité est la première chose à traiter.
- Deuxièmement, votre équipe combat répétitivement des incendies dans le même domaine. Si la même catégorie d’incident s’est produite trois fois ou plus au cours du dernier trimestre, un correctif temporaire a été appliqué à chaque fois plutôt que la correction architecturale.
- Troisièmement, les décisions architecturales prises il y a 12 à 18 mois sont maintenant la contrainte. La plupart des produits SaaS sont conçus pour le nombre d’utilisateurs qu’ils ont aujourd’hui, pas pour celui qu’ils attendent dans 18 mois. Quand la croissance s’accélère, l’écart entre l’architecture actuelle et l’architecture requise peut être trop grand pour qu’une équipe le comble tout en maintenant le produit.
Si l’une de ces situations décrit votre cas, il est temps d’avoir une conversation structurée sur ce qui doit changer et dans quel ordre, alors contactez-nous.
FAQ
Comment mettre à l’échelle une application SaaS ?
La mise à l’échelle d’une application SaaS est moins une question de « la rendre plus rapide » et plus une question d’identifier quelle contrainte spécifique devient le goulot d’étranglement à votre nombre d’utilisateurs actuel, de la corriger correctement et d’instrumenter pour la suivante. Chaque étape est listée dans l’article ci-dessus, et elle a un ensemble distinct de symptômes, une méthode de confirmation et une correction architecturale qui diffère du correctif temporaire. Les équipes qui grandissent proprement sont celles qui traitent chaque goulot à sa racine architecturale, pas seulement son symptôme de surface.
Quels sont les problèmes courants de mise à l’échelle SaaS ?
Les problèmes de mise à l’échelle SaaS les plus courants, approximativement dans l’ordre où ils apparaissent à mesure que le nombre d’utilisateurs augmente, sont :
- Épuisement des connexions à la base de données (l’application manque de connexions disponibles sous charge concurrente)
- Saturation de la file de tâches en arrière-plan (les tâches asynchrones comme les e-mails et les webhooks s’accumulent plus vite que les workers ne peuvent les traiter)
- Échecs d’invalidation du cache (des données obsolètes sont servies aux utilisateurs après les mises à jour)
- Dégradation par voisin bruyant (l’utilisation d’un grand locataire dégrade les performances des autres locataires sur l’infrastructure partagée)
- Inversion du coût par utilisateur (les coûts d’infrastructure augmentent plus vite que les revenus à mesure que l’utilisation augmente)
- Échec des processus organisationnels (la charge de coordination ralentit l’ingénierie à mesure que la complexité de l’équipe et du système augmente)
Pourquoi mon SaaS ralentit-il à mesure que les utilisateurs augmentent ?
Les applications SaaS ralentissent à mesure que les utilisateurs augmentent car l’architecture qui fonctionne bien avec peu d’utilisateurs a des limites de capacité spécifiques qui deviennent contraignantes à mesure que la concurrence augmente. La cause initiale la plus courante est l’épuisement du pool de connexions à la base de données : l’application ne peut pas ouvrir de nouvelles connexions assez rapidement pour servir tous les utilisateurs concurrents, donc les requêtes se mettent en file d’attente et expirent. À mesure que le nombre d’utilisateurs augmente, les files de tâches en arrière-plan se remplissent, les couches de cache servent des données obsolètes et l’infrastructure partagée commence à montrer des conflits entre locataires. Chacun de ces échecs a un point déclencheur prévisible, ce qui signifie qu’ils sont diagnosticables et évitables si la bonne instrumentation est en place avant que le nombre d’utilisateurs n’atteigne le seuil.
Découvrez comment nous avons aidé Recruit Media à construire un SaaS de recrutement acquis par une société cotée au Nasdaq avec une capitalisation boursière de plus de 250 millions