Vous avez lu les présentations stratégiques. McKinsey, Accenture, BCG. Le conseil d’administration a approuvé « faire quelque chose avec l’IA ». Et maintenant, vous êtes face à un organigramme de douze fonctions, essayant de déterminer laquelle deviendra la preuve tangible qui justifiera le budget des douze prochains mois.
Le problème avec la plupart des conseils en la matière est qu’ils opèrent à une altitude trop élevée. Les cadres vous disent « d’identifier les cas d’utilisation à fort impact ». Les audits de préparation vous disent de corriger votre gouvernance de données. Ni l’un ni l’autre ne vous dit, un lundi matin, s’il faut d’abord placer des agents au support de niveau 1 ou aux comptes fournisseurs.
Ceci est une liste de contrôle opérationnelle pour la transformation de l’IA. Évaluez chaque fonction selon cinq questions, totalisez le résultat, et vous obtiendrez une réponse défendable pour votre prochaine réunion de direction. La seconde moitié de l’article transforme ces scores en un plan de séquencement sur 12 mois.
Pourquoi l'évaluation par fonction bat les audits de préparation à l'échelle de l'organisation
La plupart des conseils publiés choisissent la mauvaise unité d’analyse. L’aperçu de McKinsey a révélé que si 88 % des entreprises utilisent l’IA dans au moins une fonction, moins de 25 % ont mis à l’échelle l’IA agentique en production. Le goulot d’étranglement est rarement la stratégie. C’est que personne n’a décidé quelle fonction serait livrée en premier.
Ce que la priorisation au niveau du processus manque. Une fonction possède cinq ou six flux de travail qui réussissent ou échouent ensemble. Évaluer un seul flux de travail isolément, comme la « correspondance des factures » au sein des comptes fournisseurs, vous donne le feu vert pour construire quelque chose que le reste de la fonction des comptes fournisseurs ne peut pas absorber. L’agent est livré, l’équipe autour de lui reste inchangée, et le flux de travail redevient manuel au bout d’un trimestre.
Ce que les audits de préparation à l’échelle de l’organisation manquent. Les audits vous disent que votre gouvernance de données a besoin d’un travail, que votre vivier de talents est mince et que votre capacité de gestion du changement est faible. Tout cela est vrai. Rien de tout cela ne dit au directeur des opérations quelle ligne budgétaire défendre le trimestre prochain. Un audit produit un rapport. Un tableau de bord de fonction produit une décision.
Pourquoi la fonction est la bonne unité pour la feuille de route d’un directeur technique. Les fonctions ont des propriétaires, des budgets, des effectifs et des résultats mesurables. Elles correspondent parfaitement à un compte de résultat. Lorsque Salesforce a réduit ses effectifs de support client d’environ 4 000 personnes en 2025, elle l’a fait par fonction. Workday livre maintenant des agents nommés Agent de paie et Agent de mobilité des talents pour la même raison. L’unité de remplacement est la fonction, donc l’unité d’évaluation devrait correspondre.

L'évaluation de la préparation des fonctions en 5 questions
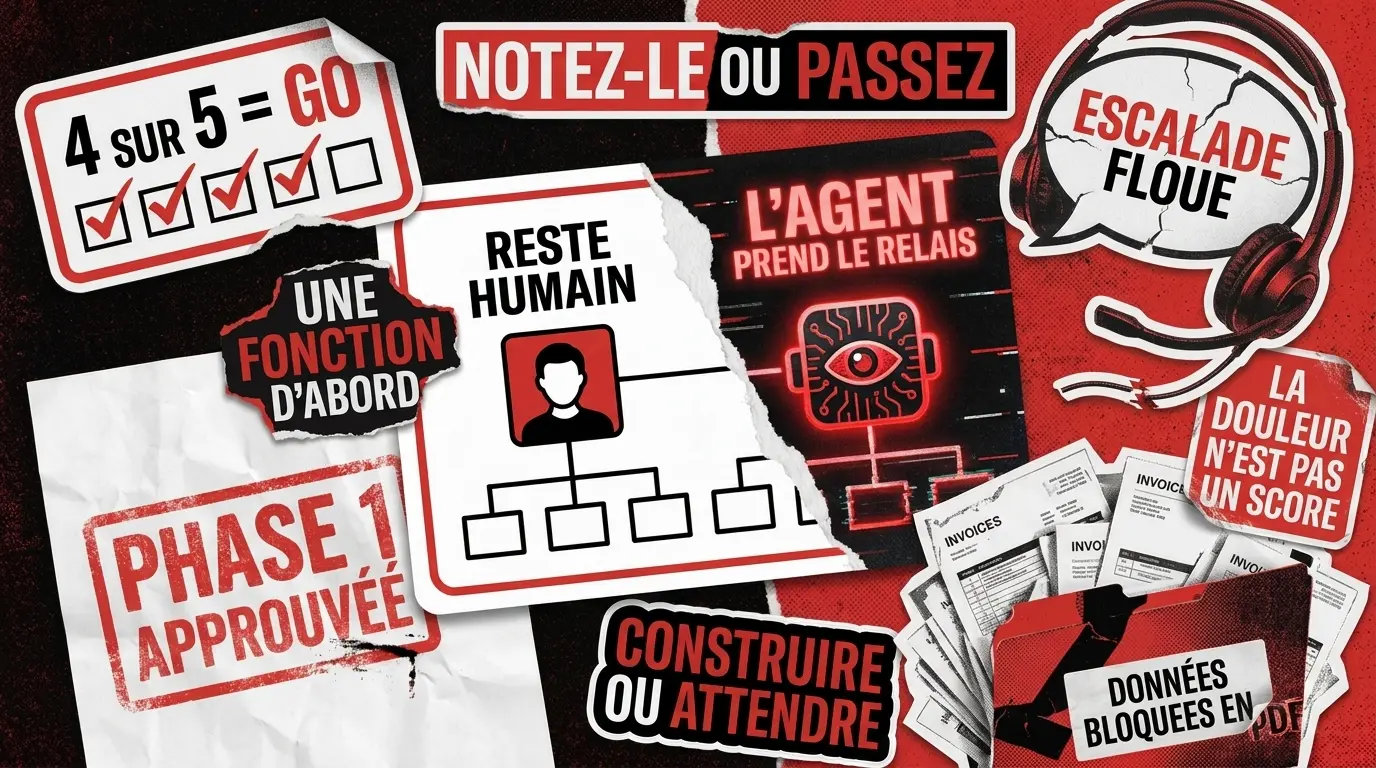
Choisissez une fonction candidate. Notez-la oui ou non sur les cinq questions ci-dessous. Un point par oui. La grille de notation à la fin convertit le total en décision de construction.
Ces cinq critères sont délibérément stricts. En mai 2026, Gartner a averti que 40 % des entreprises déclasseront ou désaffecteront des agents IA autonomes d’ici 2027 en raison de lacunes de gouvernance découvertes uniquement après des incidents de production. Des critères stricts dès le départ évitent les retouches qui tuent les budgets de la Phase 1.
Le résultat est-il vérifiable ?
Un humain ou un système peut-il confirmer si le résultat de l’agent était correct, quelques minutes après que le travail a été effectué ?
Si la boucle de vérification s’exécute trimestriellement, lors d’une revue QA, ou « quand quelque chose casse », la fonction échoue à cette question. Un résultat vérifiable est la différence entre attraper une erreur d’agent au point d’action et la découvrir trois mois plus tard dans une plainte client.
Les données sont-elles accessibles ?
Les entrées dont l’agent a besoin doivent résider dans des systèmes dotés d’API et de schémas raisonnablement propres. Si la réponse dont l’agent a besoin est dispersée sur cinq onglets, trois canaux Slack et la tête d’un analyste, la réponse est non. L’exportation vers un tableau de bord ne compte pas. L’agent a besoin de la source, pas du rapport.
C’est aussi là que la plupart des entreprises du marché intermédiaire se heurtent à un mur. Les modèles pratiques d’API Claude pour l’automatisation des entreprises montrent que la construction elle-même est rarement la partie difficile. La partie difficile est de relier les données afin que l’agent ait quelque chose sur quoi agir.
Les décisions sont-elles basées sur des règles ?
Les appels quotidiens dans cette fonction doivent pouvoir être exprimés comme une politique, jamais comme un jugement. Remboursement de moins de 50 $ sans approbation est basé sur des règles. Les décisions de promotion sont basées sur le jugement. La qualification de prospects par firmographie est basée sur des règles. La qualification de prospects par « intuition de l’ajustement » est basée sur le jugement.
Les fonctions pleines d’appels de jugement peuvent toujours bénéficier de l’assistance de l’IA. Elles ne sont pas encore candidates au remplacement par un agent.
Le volume est-il suffisant pour justifier un développement ?
Un seuil approximatif : 500 instances ou plus par mois, ou un volume collectif suffisant à travers des fonctions similaires pour qu’une plateforme d’agents partagée soit rentabilisée en douze mois. En dessous de cela, la surcharge d’ingénierie, de gouvernance et de surveillance l’emporte sur les économies.
C’est la question que les dirigeants sautent le plus souvent. Douloureux ne signifie pas volumineux. La fonction qui frustre le PDG chaque vendredi peut traiter trente cas par mois, auquel cas il n’y a pas d’étude de cas pour le remplacement.
Le chemin d'escalade est-il clair ?
Lorsque l’agent n’est pas sûr, qui reprend le travail et à quelle vitesse ? Si la réponse est « nous allons y réfléchir plus tard », la réponse est non.
Les agents de production ont besoin d’un propriétaire humain nommé, d’un seuil de confiance défini et d’un engagement de niveau de service pour les transferts. Sans ces trois éléments, l’agent dégrade silencieusement la fonction qu’il était censé améliorer. C’est le facteur de préparation qui devient le fondement de toute stratégie de transformation sérieuse de l’IA, car tous les autres gains en dépendent.
Comment noter : 5/5, 3–4/5, Moins de 3
Totalisez le score de la fonction. Le résultat vous dit quoi faire ensuite.
5 / 5
Construire maintenant
Candidat à la Phase 1, accéléré
3 ou 4 / 5
Construire avec des réserves
Candidat à la Phase 2, documenter la lacune
0–2 / 5
Pas encore
Réexaminer dans 6 à 12 mois
Notez chaque fonction candidate de votre organisation. La liste que vous obtenez devient l’entrée de la Partie 2.
Séquençage de vos fonctions notées sur 12 mois
Une liste notée n’est pas encore un plan. Le plan vient du séquençage. Considérez cela comme la couche opérationnelle de votre stratégie plus large de transformation de l’IA, l’endroit où la stratégie se transforme en un diagramme de Gantt.
La structure ci-dessous présente trois phases de feuille de route de transformation de l’IA, chacune liée aux scores de la Partie 1. L’objectif n’est jamais de tout livrer en douze mois. L’objectif est de livrer une chose en trois, puis de construire sur cette base.
Phase 1 (0–3 mois) : Une fonction livrée en production
Choisissez une fonction 5/5 et résistez à la tentation de surcharger. Une seule fonction livrée en production, avec un véritable canal d’escalade et une amélioration mesurable des coûts ou du temps de cycle, devient la preuve interne qui finance la Phase 2. Trois pilotes à moitié terminés deviennent l’étude de cas expliquant pourquoi le conseil devrait suspendre le programme.
Les entreprises qui réussissent la Phase 1 partagent deux habitudes. Elles publient une métrique de référence avant la mise en ligne de l’agent, et elles maintiennent un escalade humaine généreuse dans les soixante premiers jours, puis la resserrent.
Phase 2 (3–9 mois) : Mise à l'échelle et construction de la plateforme partagée
Avec une fonction en production, deux choses deviennent possibles. Les fonctions restantes notées 5/5 sont livrées plus rapidement car la plateforme existe. Et les fonctions notées 3-4/5 où le problème est résoluble, généralement l’accessibilité des données, deviennent viables.
C’est la phase où une transformation de la main-d’œuvre par l’IA agentique structurée s’élargit vers l’agenda plus large de la transformation numérique : identité, observabilité, sécurité et modèle opérationnel autour des équipes humaines-agents.
La Phase 2 est également celle où la réutilisation commence à porter ses fruits. Le deuxième agent devrait coûter considérablement moins cher à construire que le premier. Si ce n’est pas le cas, la plateforme n’existe que sur une diapositive.
Phase 3 (9–12 mois) : Réévaluation des fonctions différées
Reprenez la liste 0-2/5 d’il y a douze mois et réévaluez-la. La plupart des fonctions auront évolué. La raison a peu à voir avec les fonctions elles-mêmes. Les Phases 1 et 2 ont nettoyé les données, construit l’infrastructure d’escalade et établi la gouvernance comme effets secondaires.
Une fonction qui a obtenu 1/5 en janvier obtient souvent 4/5 en décembre sans que personne ne travaille directement sur cette fonction. La réévaluation à une fréquence fixe évite que la liste différée ne devienne un cimetière.
Ce qu'il ne faut pas choisir pour la Phase 1
Trois schémas à éviter :
- La fonction dont le PDG se plaint le plus. La douleur est un sentiment, jamais un score.
- La fonction que le vendeur le plus bruyant a présentée la semaine dernière. Les démonstrations s’exécutent sur des données de staging.
- La fonction ayant le plus de poids politique. Le poids politique transforme la Phase 1 en une campagne au lieu d’une construction.
Choisissez le score le plus élevé. Si deux fonctions sont à égalité, choisissez celle qui a le volume mensuel le plus élevé. Les mathématiques gagnent.
Erreurs courantes de notation qui brûlent le budget de la Phase 1
Les erreurs les plus coûteuses proviennent d’une notation généreuse. Quatre points à signaler :
Qualifier les résultats de vérifiables lorsque l’examen QA est trimestriel. Considérer les données comme accessibles parce qu’elles apparaissent dans un rapport BI. Traiter les connaissances informelles comme une règle parce qu’une personne a écrit un document Notion que personne ne lit. Sauter la question du volume parce que la fonction « semble » importante.
Une discipline utile est de faire noter la même fonction indépendamment par un deuxième examinateur. Lorsque les deux scores diffèrent de plus d’un point, la fonction nécessite une découverte plus approfondie avant d’entrer dans la Phase 1. Le même principe qui rend les développements IA personnalisés efficaces pour les entreprises du marché intermédiaire s’applique ici : la rigueur initiale permet d’économiser du travail plus tard.
Du score à l'étude de cas
Une fonction 5/5 avec plus de 500 instances mensuelles est déjà une proposition prête pour le conseil. Le score vous donne la fonction, la phase, la métrique de succès et le propriétaire d’escalade nommé. Trois des quatre questions les plus difficiles de toute conversation budgétaire sur l’IA agentique sont répondues avant même d’entrer dans la pièce.
Exécutez les cinq questions à travers votre organisation en un après-midi. Notez cinq fonctions lors de votre prochaine réunion de direction et vous repartirez avec un candidat pour la Phase 1 qui résistera à l’examen. Si trois fonctions ou plus dépassent le seuil de 4/5, le score constitue l’étude de cas. Contactez-nous si vous êtes prêt à le mettre au travail.
FAQ
Comment savoir quelles fonctions d'équipe automatiser avec l'IA ?
Notez chaque fonction selon cinq questions : le résultat est-il vérifiable, les données sont-elles accessibles, les décisions sont-elles basées sur des règles, le volume est-il suffisant pour justifier un développement, et le chemin d’escalade est-il clair. Un score de 5/5 signifie que la fonction est prête pour le remplacement par un agent dès maintenant. Un score de 3 ou 4 signifie construire avec des réserves. Moins de 3, réexaminer dans six à douze mois.
Quelle est la différence entre une stratégie de transformation de l'IA et une liste de contrôle ?
Une stratégie définit la direction et les résultats sur un horizon de plusieurs années. Une liste de contrôle est l’instrument opérationnel qui décide de ce qui sera livré le trimestre prochain. La stratégie répond au « pourquoi ». La liste de contrôle répond « lequel », et « quand ».
Quelle fonction devrions-nous remplacer en premier ?
La fonction avec le score de préparation le plus élevé, puis le volume mensuel le plus élevé comme critère de départage. Remplacer d’abord la fonction la mieux notée permet de construire la plateforme et la preuve interne qui finance tout le reste.
Découvrez comment nous avons aidé BengalFox à automatiser les routines d'entreposage et à réduire le traitement des commandes de 15 à 3 secondes