L’utilisation de l’IA se répand comme une traînée de poudre, ce qui signifie qu’il ne suffit plus de proposer quelques fonctionnalités intégrées d’IA/ML via vos produits ; le moment est venu de passer à l’échelle de l’IA. Cependant, cela s’accompagne d’une série de défis, notamment une baisse de la qualité des performances, des perturbations commerciales, des coûts excessifs, des échecs de déploiement de systèmes et des pertes de réputation irréparables.
Avec 71 % des organisations utilisant déjà l’IA générative dans leur travail, nous devons admettre que vous en avez besoin pour rester compétitif. L’astuce consiste à utiliser les modèles d’IA efficacement pour en tirer le maximum de bénéfices. Cela implique de mettre à l’échelle et d’intégrer vos fonctionnalités personnalisées d’IA/ML dans un système cohérent qui optimise à mesure qu’il consomme davantage de données commerciales.
Nous avons plus de 20 ans d’expérience dans le domaine du développement d’intelligence artificielle. Aujourd’hui, nous mettons cette expertise à profit pour expliquer exactement ce que signifie la mise à l’échelle de l’IA et pourquoi elle n’équivaut pas nécessairement à rendre votre système plus grand. Nous listerons également des conseils pratiques pour aider à maintenir la qualité globale des résultats des modèles d’IA pendant le processus et fournirons des exemples concrets de la manière dont certaines grandes entreprises y sont parvenues et pourquoi.
Mise à l'échelle des modèles d'IA : quelle direction vous convient le mieux ?
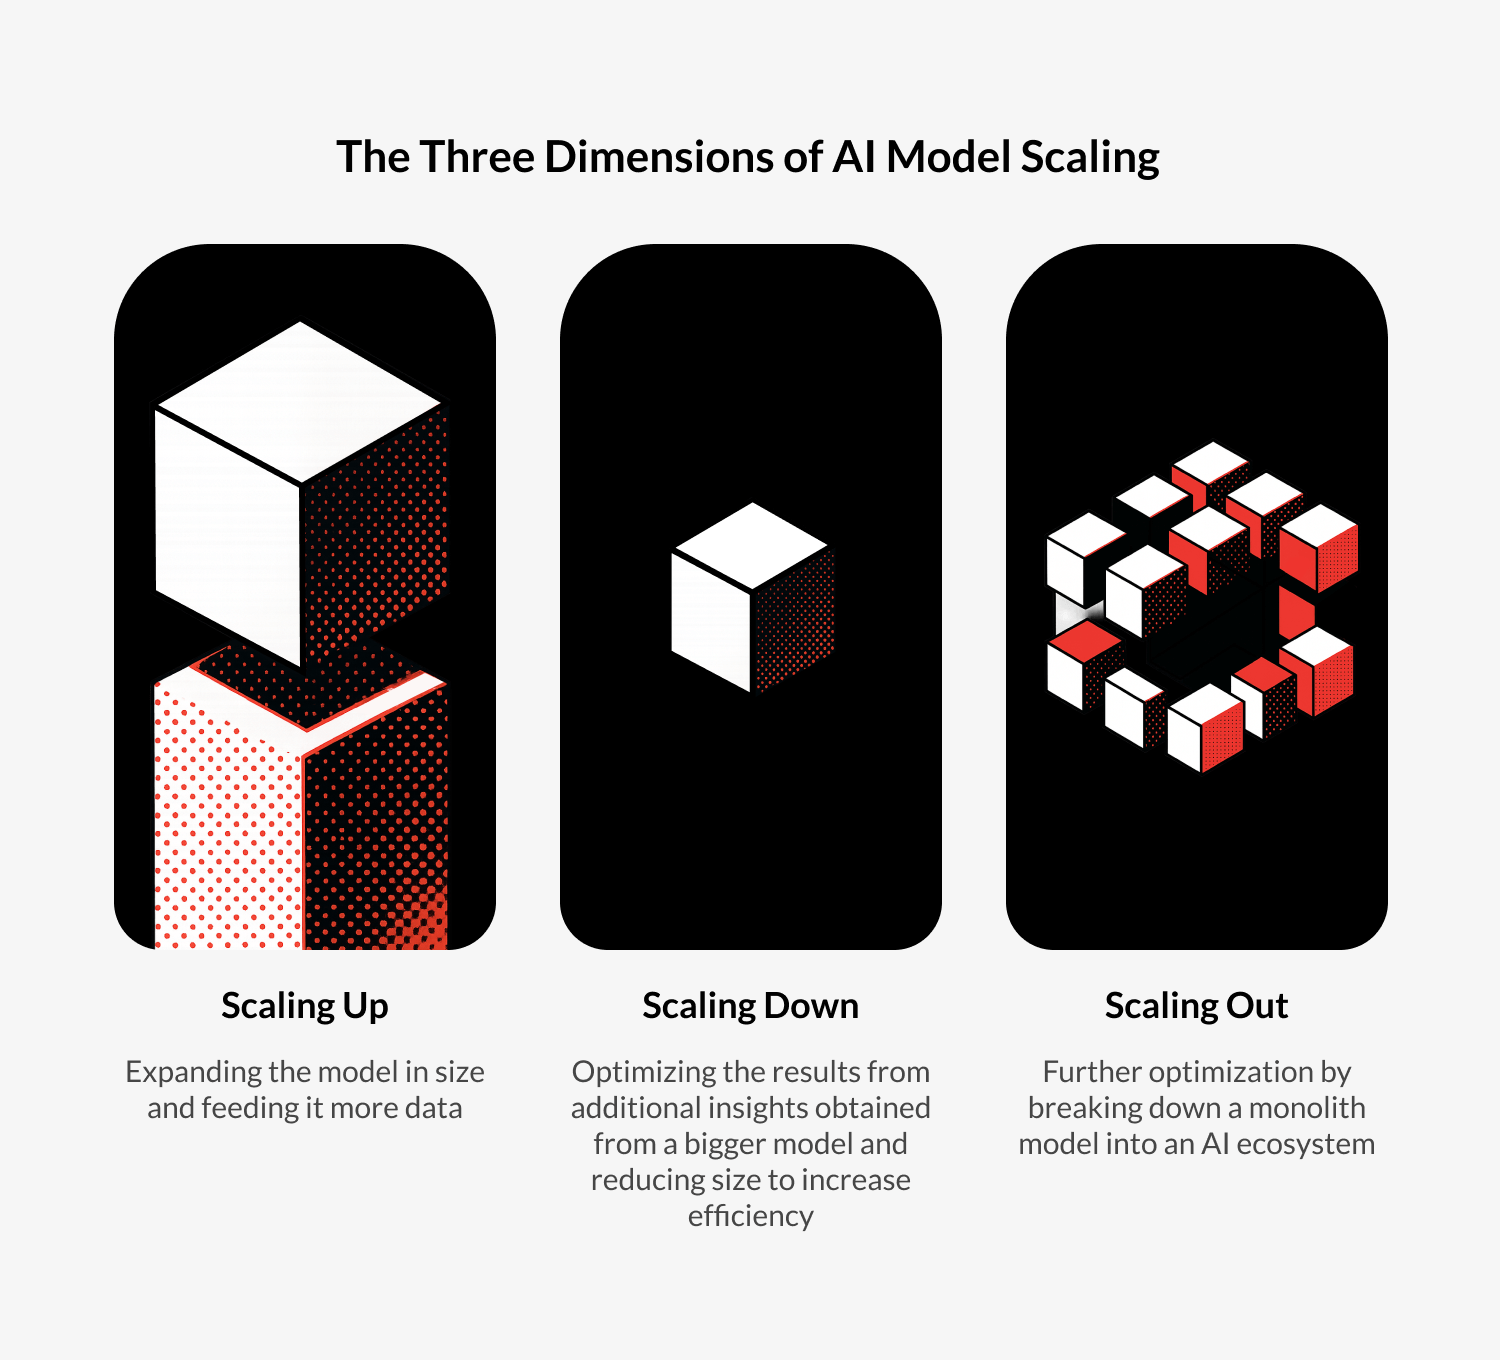
Lorsque l’on discute de la mise à l’échelle des modèles d’IA, on fait généralement référence à l’« agrandissement » (scaling up). Cependant, à mesure que les modèles d’IA deviennent plus complexes et que leurs applications se répandent, la signification de la mise à l’échelle change. Aujourd’hui, vous devez comprendre que « plus grand » n’est pas nécessairement « mieux » en ce qui concerne la qualité des modèles d’IA. Par conséquent, la première chose à décider est le type de mise à l’échelle qui profitera le plus à vos applications de modèles d’IA.
AgrandissementComme son nom l’indique, l’agrandissement des modèles d’IA implique d’étendre leurs capacités en augmentant le nombre de paramètres, en entraînant sur des ensembles de données plus importants et en utilisant des ressources informatiques supplémentaires. En termes simples, vous rendez le modèle plus grand et repoussez ses limites pour améliorer la qualité et la précision des résultats.
Le revers de l’agrandissement est son coût. Ce processus nécessitera un investissement énorme en données, en infrastructure et en ressources informatiques. Il augmente également l’impact environnemental du déploiement et de l’utilisation des modèles d’IA. De plus, la saturation inévitable des données peut entraîner une détérioration des résultats au fil du temps.
RéductionÉtonnamment, la réduction est l’étape qui suit naturellement l’agrandissement. La collecte de données issues de la surveillance de la dérive des modèles d’IA et des performances générales vous fournit des informations qui permettent une réduction efficace. C’est un processus d’optimisation qui crée des modèles d’IA plus performants. En termes simples, vous supprimez tout ce qui est non essentiel de la phase de mise à l’échelle précédente de l’IA afin de préserver la qualité des performances du modèle pour les tâches principales.
La principale limitation de la réduction est qu’elle se concentre généralement sur un modèle unique et optimisé, ce qui peut compliquer les déploiements de modèles d’IA dans des environnements distribués ou multi-modèles.
DistributionLa prochaine étape dans le raffinement de la qualité des modèles d’IA est la distribution. Elle s’appuie sur les résultats obtenus lors de la réduction. Cependant, elle va plus loin en décomposant un modèle monolithique en un écosystème d’IA avec l’intelligence principale et des modèles spécialisés responsables de tâches spécifiques.
Cette approche de la mise à l’échelle de l’IA nécessite une plus grande sophistication et une collaboration avec des développeurs ayant une expertise dans les solutions basées sur l’IA pour la croissance.
Comment maintenir la qualité des performances des modèles d'IA lors de la mise à l'échelle
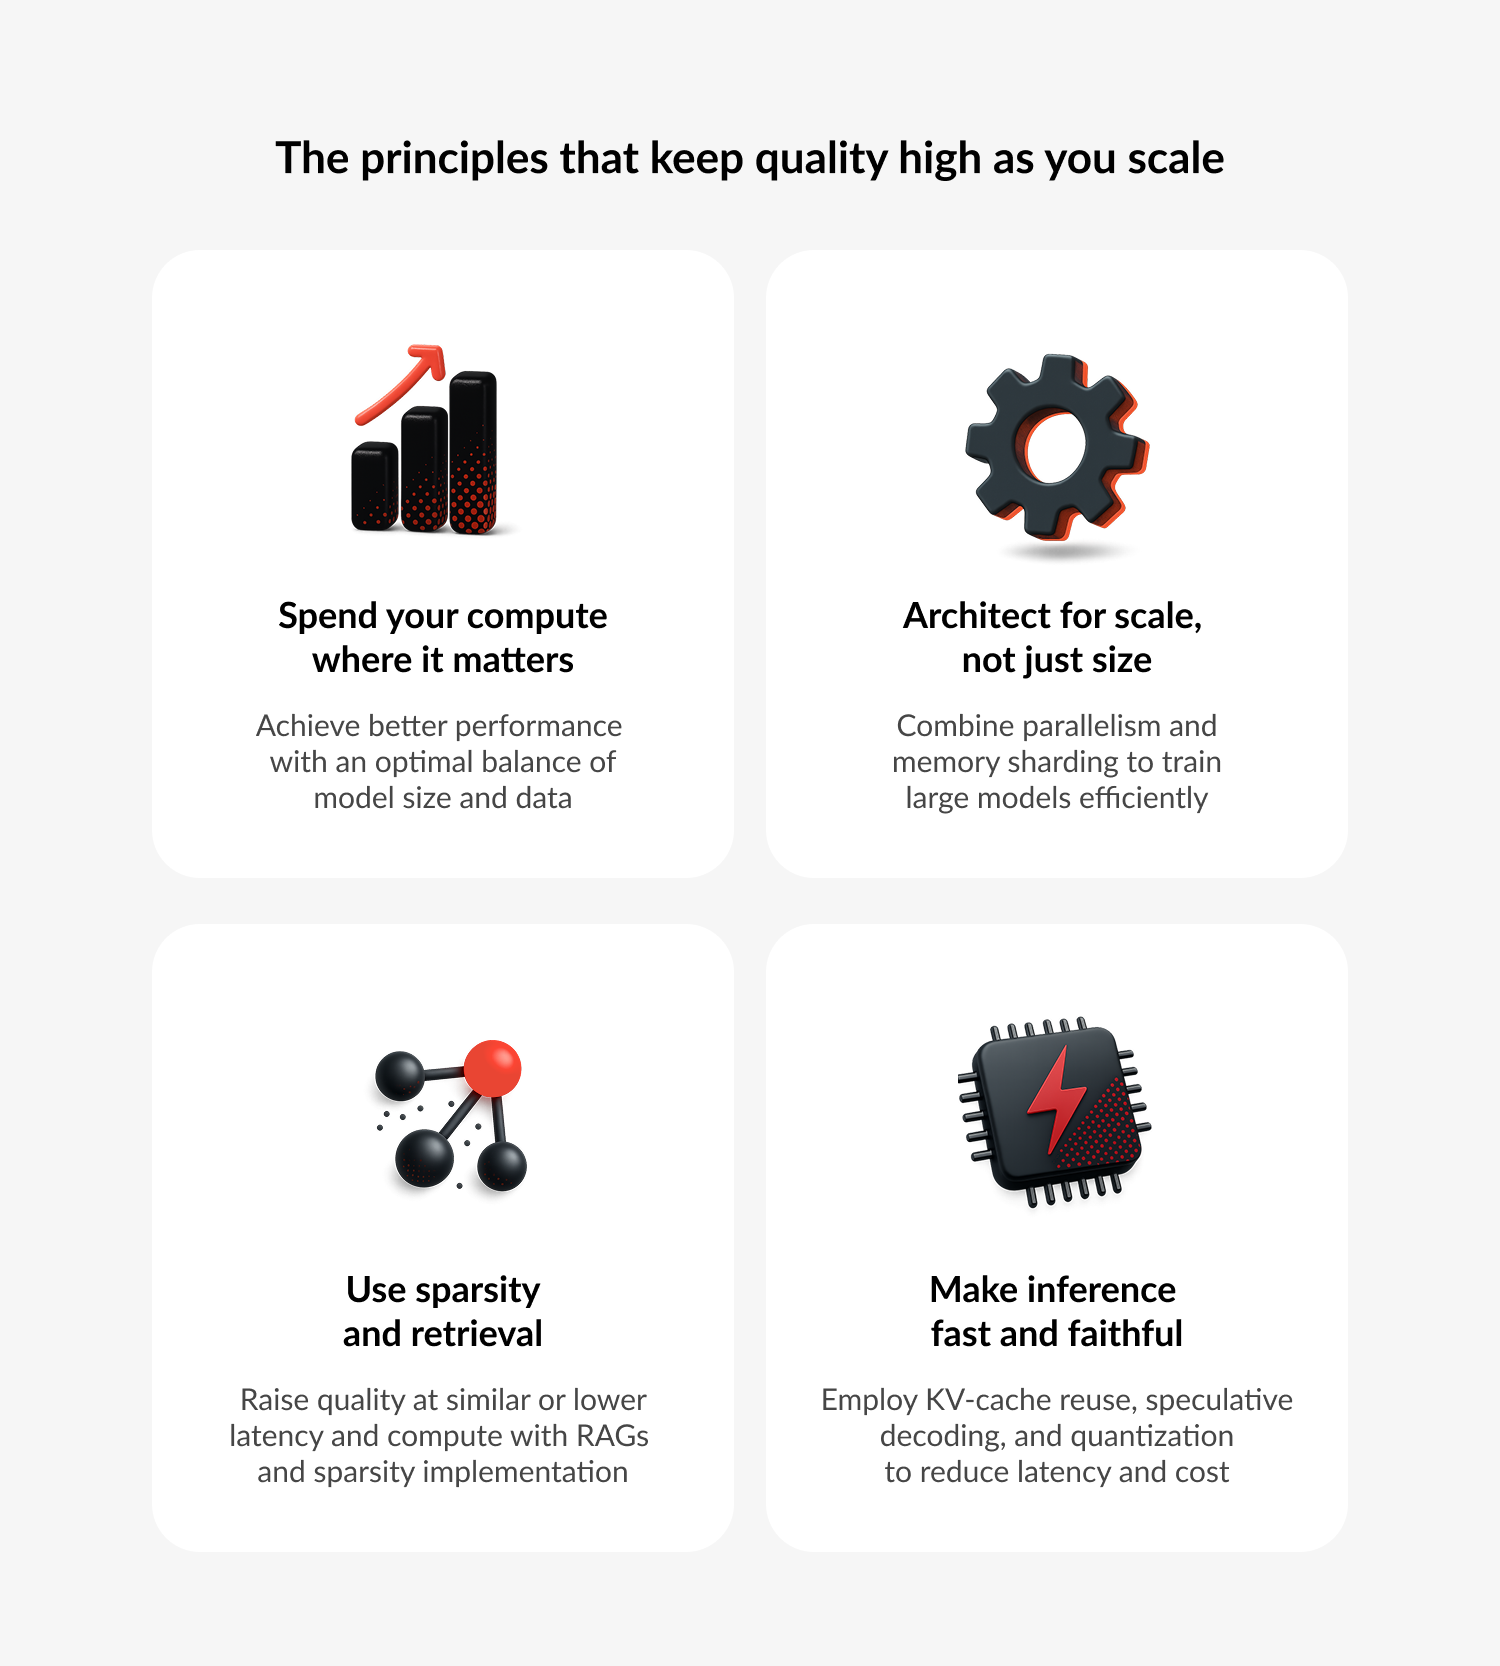
Quelle que soit la voie que vous choisissez lors de la mise à l’échelle des modèles d’IA, vous devez minimiser les perturbations commerciales causées par les changements. Pour ce faire, vous devez assurer une utilisation hautement ciblée de la puissance de calcul et mettre en œuvre des outils qui réduiront la latence et optimiseront le rapport coût-valeur.
Adapter la taille du modèle aux données
N’oubliez pas que plus grand ne signifie pas mieux quand il s’agit d’IA. Selon une étude massive avec le modèle Chinchilla, qui surpasse Gopher et GPT-3 tout en utilisant beaucoup moins de calcul, la clé est d’équilibrer la taille du modèle et le volume des données d’entraînement.
Pour le dire simplement, la qualité du modèle d’IA sera inférieure lorsqu’un grand modèle est entraîné sur un petit ensemble de données, par opposition à l’entraînement d’un modèle plus petit sur des sources de données robustes et vastes. Si votre objectif est d’automatiser les stratégies de mise à l’échelle de l’IA, le principe de base devrait être de s’entraîner plus longtemps en utilisant plus de données au lieu d’augmenter simplement le nombre de paramètres.
Concevoir pour l'évolutivité
Vous pouvez même exécuter des modèles d’IA moyennement grands sur un seul GPU. Cependant, si vous souhaitez continuer à mettre à l’échelle et à optimiser à l’avenir, l’ architecture que vous construisez doit supporter :
- Le parallélisme de modèle pour découper les couches et les tenseurs sur plusieurs GPU.
- Le parallélisme de pipeline pour regrouper les couches sur les appareils.
- Le parallélisme de tenseur pour diviser les opérations matricielles.
- Le sharding d’état/optimiseur pour éviter de répliquer tous les gradients et l’état de l’optimiseur sur les appareils, évitant ainsi la surcharge de mémoire.
Utiliser la parcimonie et la récupération
L’un des moyens les plus efficaces de préserver la qualité des modèles d’IA lors de la mise à l’échelle est de s’appuyer sur la parcimonie. Utilisez des techniques de parcimonie, telles que le Mixture-of-Experts (MoE), pour activer seulement une fraction des poids du modèle par jeton d’entrée, améliorant ainsi l’efficacité sans sacrifier la précision. De cette façon, vous n’activez qu’une fraction des poids du modèle par jeton d’entrée. En termes simples, cela signifie que le modèle utilisera seulement une partie de sa capacité pour obtenir un résultat précis sans augmenter inutilement le calcul ou la latence.
La RAG, ou les méthodes de récupération augmentée, offrent une autre façon d’optimiser les déploiements d’IA et même d’améliorer la qualité des résultats. L’implémentation de la RAG est idéale pour la mise à l’échelle car elle permet au modèle de puiser dans des données provenant de bases de connaissances externes. C’est une méthode d’amélioration de la précision factuelle sans mettre à l’échelle les connaissances du modèle ou surcharger sa capacité interne. De plus, c’est une solution efficace pour réduire les coûts de déploiement des modèles d’IA.
Assurer une inférence rapide et fidèle
L’un des principaux objectifs lors de la mise à l’échelle des modèles d’IA est de réduire la latence lors du service. Utilisez des techniques telles que la réutilisation du cache KV afin de réutiliser les clés/valeurs calculées pour les jetons passés lors du service d’une nouvelle continuation de message.
Implémentez le décodage spéculatif, où un modèle « brouillon » plus petit propose des jetons qui sont vérifiés par un modèle plus grand, augmentant ainsi le débit d’inférence tout en maintenant la fidélité de la sortie. Cela augmente la vitesse de sortie et le débit global. De plus, maintenez la fidélité (gardez les résultats que le modèle livre inchangés lors des optimisations) grâce à une quantification soignée ou à une précision mixte.
Tester avant le déploiement
Les évaluations hors ligne peuvent montrer d’excellents résultats. Cependant, vous devez toujours effectuer des tests lors des déploiements d’IA. Exécutez le mode shadow pour refléter le trafic réel sans afficher directement la sortie de votre modèle mis à l’échelle aux utilisateurs.
La prochaine étape devrait être une libération canary, où vous déployez le nouveau modèle auprès d’une fraction du trafic. Suivez cela avec des tests A/B pour comparer les résultats et détecter les régressions ou d’autres problèmes qui apparaîtront dans les métriques (précision, latence ou toxicité). Une telle approche progressive permet la mise en œuvre d’une surveillance efficace de la dérive des modèles d’IA. Vous éviterez également des échecs massifs lors de l’adoption par les utilisateurs de la nouvelle version du modèle.
Entraînement des modèles d'IA vs. Service à grande échelle
Un autre point à considérer est que l’évolutivité de l’IA varie entre l’entraînement et le service des modèles d’IA. Lorsque vous passez à grande échelle, comme dans le développement de logiciels d’entreprise, vous devez utiliser des approches et des techniques très spécifiques pour prévenir les perturbations et maintenir une qualité de sortie pour les utilisateurs.
Comment fonctionne l'entraînement d'IA à grande échelle
Lorsque vous augmentez l’échelle de l’entraînement de modèles, suivez la liste de contrôle ci-dessous :
- Lors de la gestion des données, sélectionnez des corpus de haute qualité et diversifiés, dédupliquez agressivement et filtrez les contenus toxiques/PII. Assurez-vous également de respecter les contraintes de licence pertinentes à votre domaine.
- Entraînez les modèles d’IA dans un régime de calcul optimal, en veillant à ce que le nombre de jetons d’entraînement soit proportionnel au nombre de paramètres du modèle pour une efficacité maximale.
- Implémentez le parallélisme de modèle pour distribuer les couches et les tenseurs sur plusieurs GPU ou TPU, améliorant ainsi l’évolutivité et réduisant les goulets d’étranglement de mémoire sur un seul appareil.
- Utilisez les techniques ZeRO ou Fully Sharded Data Parallel (FSDP) pour fragmenter les états de l’optimiseur, les gradients et les paramètres sur plusieurs nœuds, permettant ainsi aux modèles plus grands de tenir dans la mémoire disponible.
- Implémentez l’entraînement en précision mixte et le checkpointing des activations pour réduire la consommation de mémoire et maintenir un débit de calcul optimal.
- Augmentez l’efficacité grâce à la sparsité pour faire évoluer le nombre de paramètres sans ressources de calcul proportionnelles.
- Réajustez le poids ou sur-échantillonnez les données de grande valeur lors des dernières étapes de l’entraînement pour améliorer la spécialisation du modèle et réduire le sur-apprentissage.
- Effectuez des arrêts et des évaluations pendant l’entraînement et examinez plusieurs métriques pertinentes.
- Instrumentez tout pour les régressions afin de garantir que vous pouvez restaurer les performances optimales si nécessaire.
Modèles de production pour le service d'IA
L’évolutivité des modèles d’IA en production présente certains défis que vous pouvez résoudre efficacement en gardant à l’esprit les points suivants :
- Dans l’architecture de service, déployez des workers de modèles sans état derrière une passerelle d’inférence à faible latence avec des politiques d’auto-scaling basées sur le débit de jetons et la latence des requêtes. Lors de l’automatisation des stratégies de mise à l’échelle de l’infrastructure IA, assurez l’auto-scaling sur les jetons et isolez les clients bruyants.
- Pour la mise en cache, implémentez un cache de requêtes/résultats et réutilisez le cache KV pour permettre la continuité de session et réduire la latence.
- Utilisez des modèles de brouillon plus petits avec des modèles de vérification pour augmenter la vitesse de génération des jetons (jetons/sec) tout en garantissant une qualité de sortie identique ou équivalente.
- Utilisez la quantification des poids en 4/8 bits et de petits assistants distillés pour les chemins à faible SLA.
- Reposez-vous sur la Génération Augmentée par Récupération (RAG) pour garantir l’accès à des sources de connaissances externes et fraîches sans réentraîner le modèle de base.
- Suivez le modèle de déploiement progressif Shadow-Canary-Gradual dans les déploiements d’IA mis à l’échelle.
- Implémentez une surveillance continue de la dérive des modèles avec un traçage de bout en bout, des évaluations en temps réel sur des tranches de données actives, et des alertes automatisées pour la dérive, les valeurs aberrantes et les violations des métriques de sécurité.
Exemples concrets de déploiements d'IA à grande échelle
Pour comprendre exactement comment la mise à l’échelle de l’IA peut évoluer et quels défis elle présente, nous devons examiner certaines entreprises qui ont réussi avec leurs modèles.
Le lancement de Llama 3 par MetaIl s’agissait d’un projet à grande échelle impliquant une étroite collaboration entre Meta et NVIDIA en tant que partenaire d’infrastructure. Le déploiement des versions de Llama 3 avec 8 milliards et 70 milliards de paramètres a nécessité à Meta de collecter plus de 15 billions de tokens de corpus textuel. Toutes ces données ont dû être affinées et filtrées pour supprimer les segments de faible qualité.
Ils ont mené plusieurs expériences et équilibré de multiples sources de données, telles que des textes issus du web, du code, de dialogues et d’articles scientifiques. Actuellement, Meta utilise des outils étendus pour gérer et surveiller le système et déployer des mises à jour. Ils mettent en œuvre des couches d’orchestration (par exemple, Kubernetes ou des planificateurs internes) et surveillent en permanence la qualité de l’inférence et les métriques de latence.
La mise à l’échelle de l’apprentissage automatique (ML) Michelangelo par UberMichelangelo est l’un des meilleurs exemples publics de pile d’IA/ML à l’échelle de la production que vous puissiez trouver aujourd’hui. Cela a commencé par les équipes individuelles d’Uber créant des pipelines personnalisés, des solutions uniques et des intégrations. Cette approche a entraîné une augmentation de la dette opérationnelle et de la dispersion du ML. Michelangelo a été la solution qui a réuni les fonctions ML nécessaires sur une seule plateforme. Elle combine actuellement l’ingestion de données, les référentiels de caractéristiques, l’entraînement et le déploiement de modèles, la surveillance et la gestion du cycle de vie.
L’exemple réussi de mise à l’échelle de l’IA par Uber montre que même si vous commencez avec un système d’entreprise complexe d’API déconnectées et d’autres solutions, vous pouvez réduire vos coûts et améliorer vos performances grâce à la mise en œuvre de l’IA. Les entreprises qui n’ont pas encore atteint le niveau d’Uber peuvent consulter le cas Evolv AI et voir comment commencer les mises en œuvre de l’IA à plus petite échelle.
L’optimisation Pro-ML de LinkedInLinkedIn utilise plusieurs systèmes ML pour aider ses utilisateurs à trouver des emplois, à filtrer le contenu, à effectuer des recherches, à faire de la publicité et à réaliser d’autres actions. Cependant, avec autant de fonctionnalités ML distinctes, ils ont été confrontés à des défis courants, tels que les efforts redondants, la complexité du déploiement de nouveaux modèles d’IA et la complexité de la gestion des versions, entre autres. La réponse de LinkedIn à ces défis a été le lancement de Pro-ML (Productive Machine Learning), qui leur permet d’unifier l’infrastructure, les outils et les meilleures pratiques tout au long de leur cycle de vie ML.
La mise à l’échelle ML des médias par NetflixTout le monde connaît les célèbres algorithmes de recommandation de Netflix. Cependant, ce n’est que l’une des nombreuses fonctionnalités ML utilisées par le réseau de streaming, et il traite d’énormes quantités de données. Les principaux défis auxquels il est confronté comprennent un volume de données considérable et des pipelines qui doivent être mis à l’échelle pour traiter plusieurs modalités quotidiennement, une complexité de modèle extrême, l’abstraction des données, la fiabilité du streaming et la résilience.
Ils résolvent leurs problèmes grâce à la mise à l’échelle de l’IA et à la création de plateformes comme Data Gateway qui aident à relever chaque défi. La complexité du système nécessite une approche à plusieurs niveaux, allant de la stratification de modèles d’IA multimodaux à une collaboration étroite avec Intel pour les besoins d’infrastructure et l’optimisation matérielle.
En résumé
La mise à l’échelle des modèles d’IA est un défi, surtout si vous voulez éviter une baisse de la qualité des performances. Cependant, c’est aussi une nécessité à mesure que les implémentations d’IA se développent, ce qui aboutit souvent à des systèmes excessivement compliqués qui tombent en panne et coûtent une fortune à maintenir en raison d’un manque de synchronisation entre les composants.
La solution est la mise à l’échelle de l’IA qui incorporera tout ce dont vous avez besoin, améliorera les possibilités et optimisera tout. S’associer à des développeurs d’agents IA expérimentés peut être la première étape de ce projet. Ensemble, nous pouvons élaborer la stratégie qui empêchera les perturbations de vos flux de travail tout en mettant l’ensemble du système à niveau. En conséquence, les entreprises obtiennent des modèles d’IA plus productifs et plus rentables qui peuvent relever efficacement les défis posés par l’intérêt croissant des utilisateurs.
Si vous êtes prêt à franchir cette prochaine étape, à explorer les limites de votre évolutivité IA et à aller plus loin, contactez-nous, et nous verrons comment rendre ce parcours réussi pour votre entreprise.
Découvrez comment nous avons construit une application de recrutement alimentée par l'IA acquise par un géant américain du recrutement