Vous avez lancé votre MVP en un week-end. Trois semaines plus tard, quelques centaines d’utilisateurs se sont inscrits, et le tableau de bord que vous avez construit avec Cursor ou Lovable tient toujours le coup. À la sixième semaine, les demandes de support commencent à s’accumuler : une connexion qui plante pour un client, un webhook Stripe qui laisse tomber silencieusement un paiement, et une facture Vercel qui ne ressemble en rien au niveau gratuit auquel vous vous étiez inscrit.
Cette tendance est désormais courante. Selon TechCrunch, environ un quart de ces startups avaient des bases de code générées à 95 % ou plus par l’IA. Le « vibe coding » pour les startups n’est plus expérimental ; c’est la norme. Comme toute norme, il véhicule des hypothèses qui ne résistent pas au contact avec de vrais utilisateurs.
Le premier mois d’une application créée par « vibe coding » est réservé aux amis et à la famille. Le deuxième mois concerne les vrais clients, les seuils de facturation et les cas limites sur lesquels l’IA n’a jamais été entraînée. C’est là que la dette technique du « vibe coding » se manifeste enfin en surface, et généralement tout à la fois. Si vous voulez avoir une idée des types de produits construits de cette manière, les applications de « vibe coding » les plus connues sont désormais livrées en production.
Vous trouverez ci-dessous les douze éléments que presque aucun tutoriel ne mentionne concernant le deuxième mois. Plus vite vous reconnaîtrez le schéma, moins la correction sera coûteuse.
Pourquoi le deuxième mois révèle la dette technique du « vibe coding »
Trois forces se conjuguent autour des semaines quatre à huit. Chacune est gérable seule. Ensemble, elles créent le gouffre que les fondateurs décrivent comme « tout s’est brisé en même temps ».
Premièrement, les vrais utilisateurs remplacent les premiers adoptants. Les personnes qui ne vous ont pas aidé à construire le produit sondent des entrées que personne n’avait anticipées, et le code généré par l’IA est notoirement peu fiable dans les cas limites. L’analyse de la MIT Sloan Management Review de 2025 a révélé que les gains de productivité refont surface sous forme de dette technique cumulative au cours du premier trimestre de déploiement, en particulier lorsque des développeurs juniors ou non-ingénieurs publient sans revue.
Deuxièmement, les niveaux gratuits atteignent leurs limites. Vercel, Supabase, OpenAI et les autres sont généreux jusqu’à un seuil silencieux. Le comptage continue même lorsque vos fonctionnalités ne le font pas.
Troisièmement, le fossé de la transmission par l’IA apparaît. Vous demandez au modèle d’ajouter une petite fonctionnalité, il apporte la modification, et trois éléments sans rapport se cassent. Personne, ni vous ni l’IA, n’avait l’architecture complète en tête, donc personne n’a remarqué la dépendance. Les douze éléments ci-dessous correspondent clairement à l’une de ces trois forces.
Où les applications « vibe-codées » échouent en premier
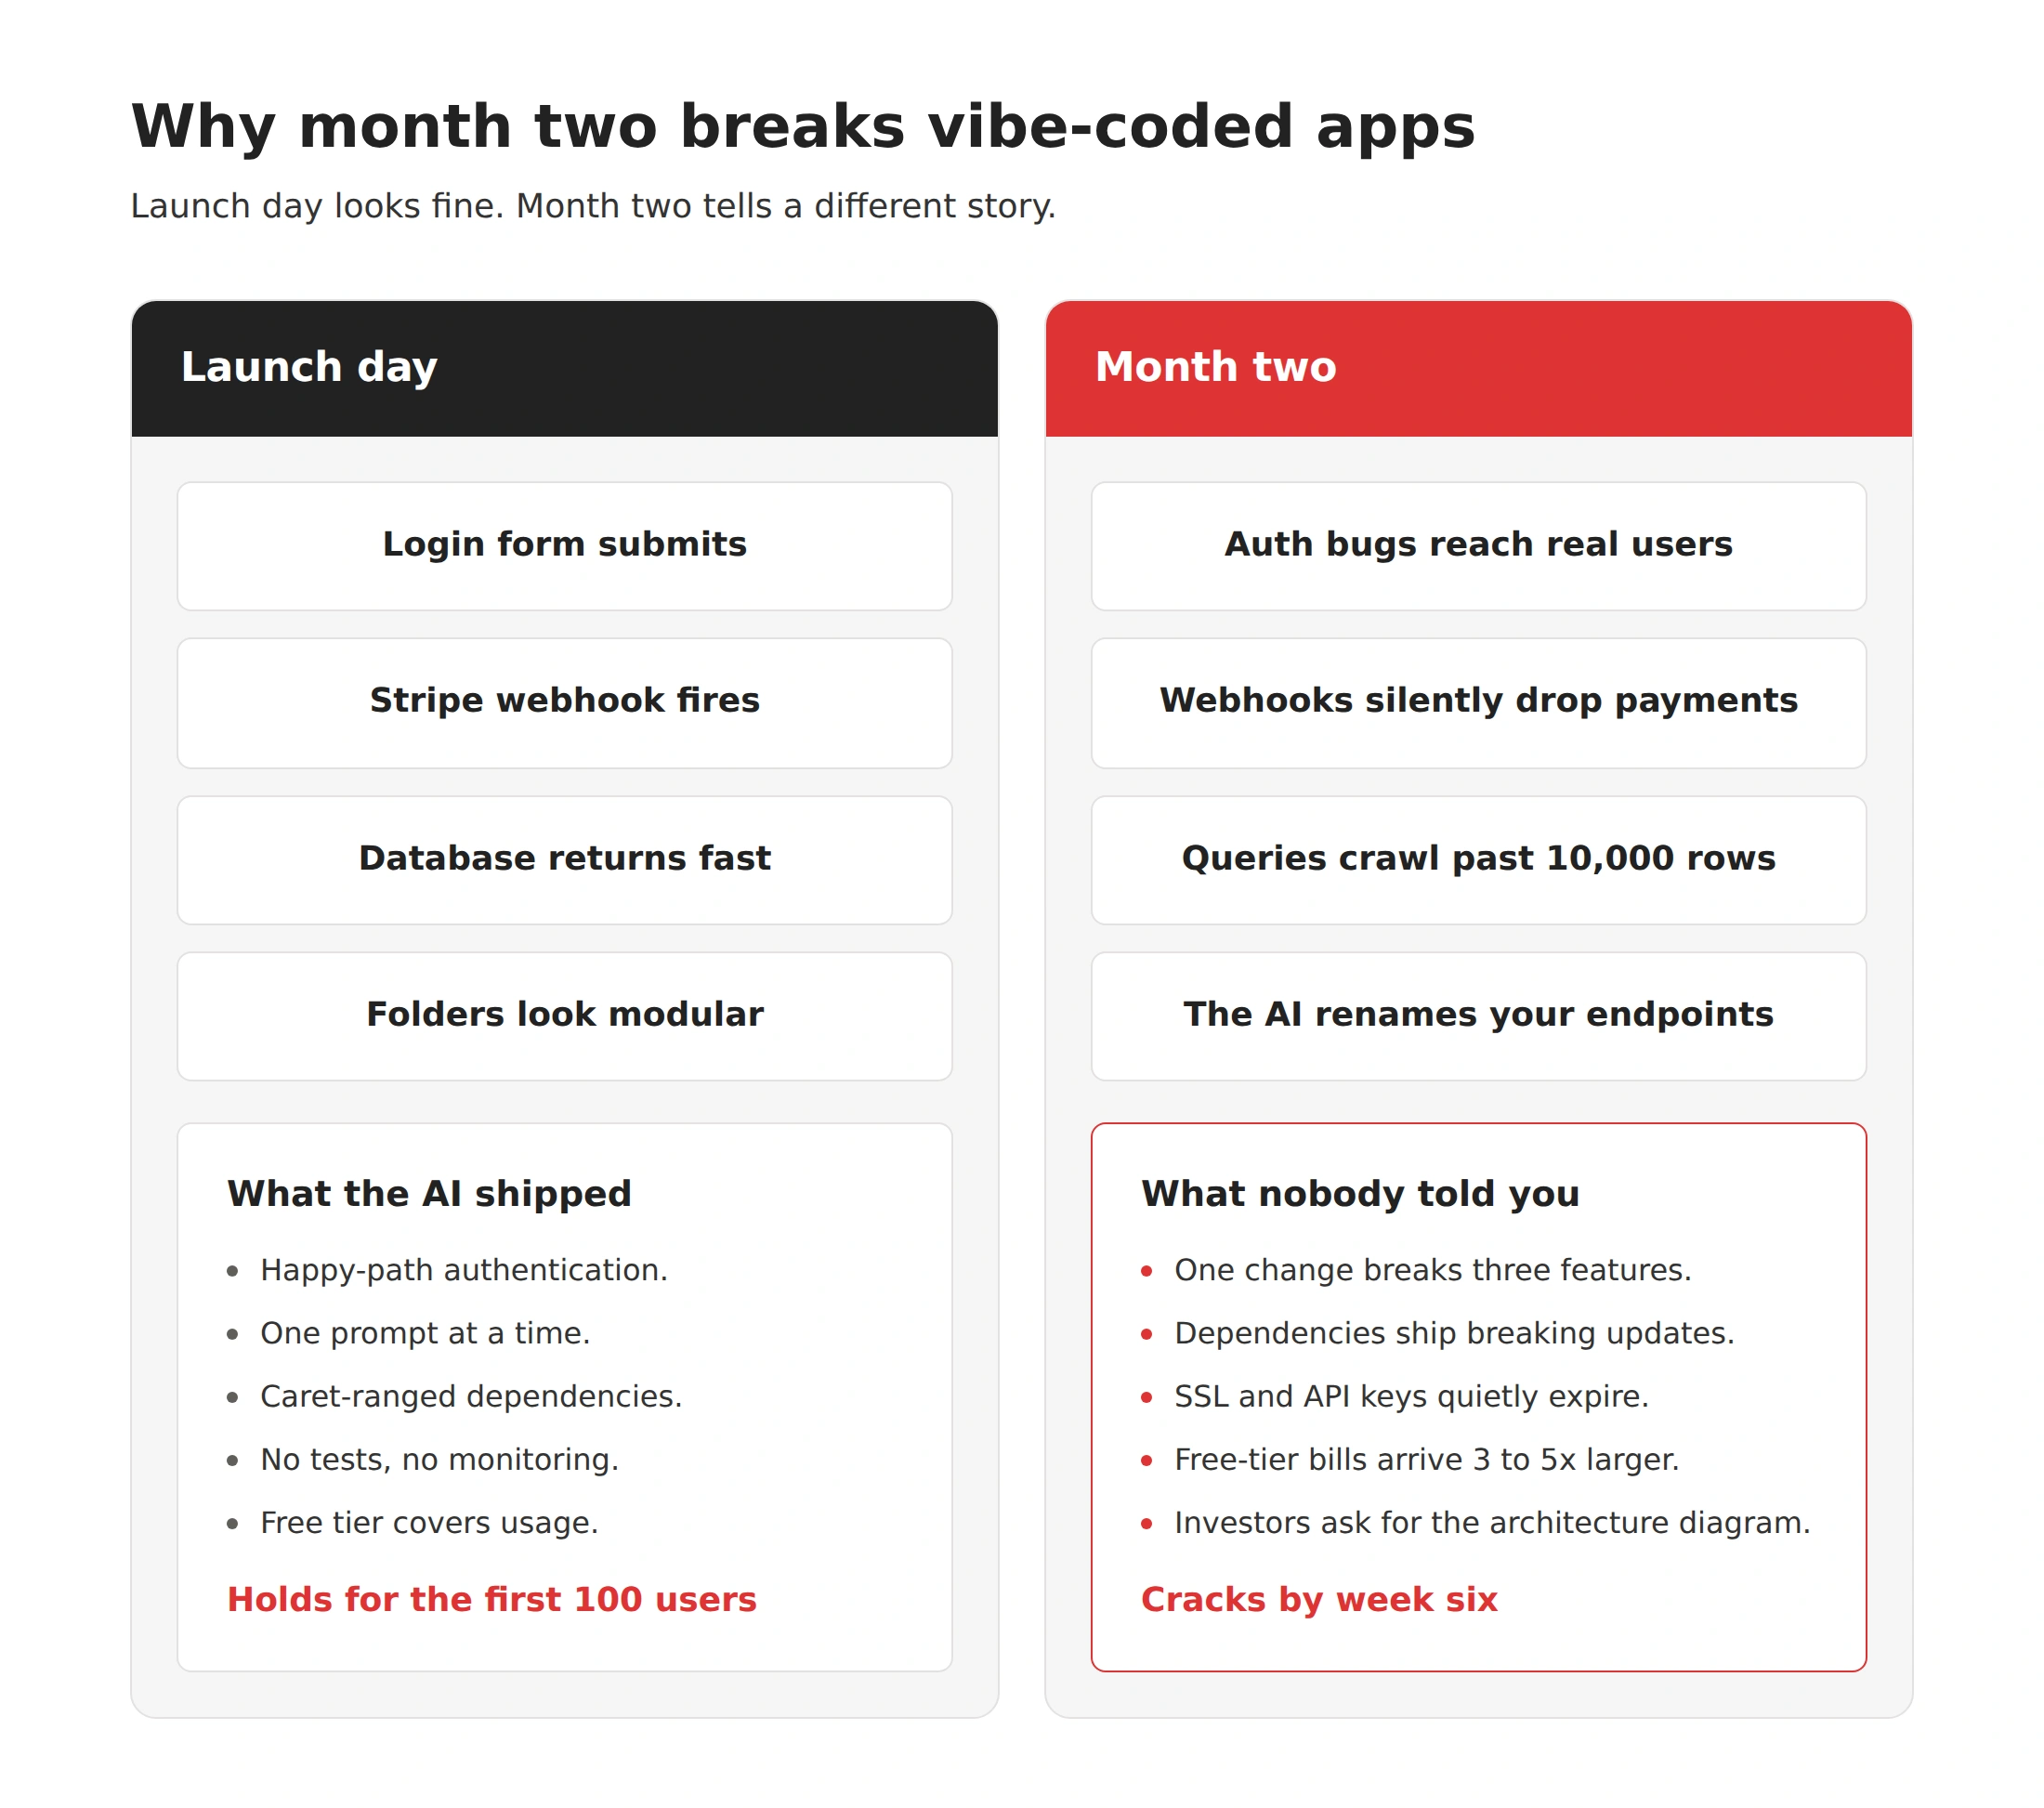
La liste est divisée en quatre thèmes. Trois éléments sont liés à la sécurité, trois sont de la dette architecturale pure, trois impliquent une expiration silencieuse et trois révèlent les lacunes du processus que le deuxième mois expose finalement.
Risques de sécurité que vous ne pouvez pas voir.
1–3
L’IA génère une authentification pour les cas simples et omet les couches de défense.
Dette architecturale sous « ça fonctionne ».
4–6
Le code semble modulaire tout en cachant un état partagé.
Les choses qui expirent silencieusement.
7–9
Aucune invite d’IA ne dit « renouvelez ceci dans 90 jours ».
Lacunes du processus révélées au deuxième mois.
10–12
La génération a dépassé la documentation et les tests.
Le premier utilisateur réel trouve votre bug d’authentification
Les outils d’IA génèrent des flux de connexion qui fonctionnent pour les cas simples. Ils ne proposent rarement la limitation de débit, l’expiration de session ou le contrôle d’accès basé sur les rôles. Le Rapport de sécurité du code GenAI 2025 de Veracode a révélé qu’environ 45 % des exemples de code générés par l’IA contenaient des vulnérabilités exploitables, l’authentification figurant constamment en tête de liste. Les risques de sécurité courants du « vibe coding » apparaissent ici en premier car l’authentification est le premier point d’accès que les utilisateurs réels essaient activement. Une revue de code de sécurité structurée détecte ces schémas avant qu’ils n’atteignent la production.
La réinitialisation du mot de passe a cessé de fonctionner silencieusement
La réinitialisation du mot de passe est le flux le plus livré, le moins testé dans les applications codées « vibe ». L’IA crée le formulaire, génère le jeton et envoie l’e-mail. Ce qu’elle gère rarement proprement :
- Les cas limites d’expiration des jetons (un jeton censé expirer dans une heure vit silencieusement pour toujours).
- La mauvaise configuration SMTP en production (fonctionne localement, échoue derrière un proxy).
- La limitation de débit sur le point d’accès de réinitialisation (le transformant en vecteur de bombardement d’e-mails gratuit).
C’est l’une des erreurs silencieuses de « vibe coding » les plus courantes. Les utilisateurs supposent que le système est peu fiable et abandonnent sans vous le dire.
Le webhook Stripe abandonne silencieusement les événements
Stripe et d’autres webhooks de paiement nécessitent des clés d’idempotence, une gestion des tentatives et une file d’attente pour les événements échoués. Les gestionnaires de webhooks générés par l’IA omettent généralement les trois. Les paiements réussissent, mais votre base de données pense qu’ils n’ont pas réussi, ou le même paiement est enregistré deux fois. Les deux versions vous coûtent de l’argent.
Vous ne le remarquerez pas avant qu’un client n’envoie un e-mail concernant un reçu manquant ou une double facturation. À ce stade, le problème existe depuis deux semaines, et sa résolution prend plus de temps que sa détection.
Votre base de données rampe à 10 000 lignes
La même requête qui retournait en 80 millisecondes au jour du lancement prend sept secondes à 10 000 lignes. La cause est presque toujours identique : le code généré par l’IA utilise par défaut des modèles ORM qui émettent une requête par enregistrement au lieu d’une seule requête groupée.
En plus de cela, les applications issues du «vibe coding» n’ont rarement d’index de base de données sur les colonnes qu’elles interrogent. La construction pour une architecture évolutive dès le départ empêche cela ; la corriger après coup nécessite quelqu’un qui peut lire le plan de requête réel.
Touchez une fonctionnalité, trois autres cassent
C’est le bug caractéristique du «vibe coding». Vous demandez à Claude ou Cursor de mettre à jour un formulaire, et une fonctionnalité à laquelle vous n’avez pas pensé depuis des semaines cesse de fonctionner. La cause profonde est un couplage caché. Les outils d’IA génèrent du code qui semble modulaire mais partage des états, des tables de base de données ou des variables globales en coulisses.
Ce schéma s’aggrave à chaque sprint. Plus il reste non résolu longtemps, plus il devient difficile de prédire quel changement de fichier cassera quel flux utilisateur.
L'architecture «modulaire» est un monolithe déguisé
Votre structure de fichiers semble propre. Il y a un dossier de composants, un dossier d’api, un dossier de lib. Chaque fichier est raisonnablement court. Rien de tout cela n’a de sens en soi. Les applications issues du «vibe coding» ressemblent fréquemment à des microservices de l’extérieur tout en se comportant comme un seul monolithe étroitement couplé de l’intérieur.
Le test est simple : choisissez un fichier et essayez d’expliquer ce qui casserait si vous le supprimiez. Si la réponse nécessite d’ouvrir quatre autres fichiers, votre architecture est théâtrale plutôt que structurelle. La véritable modularité réussit un test de suppression.
Une dépendance non épinglée expédie un changement majeur
Lorsque l’IA génère votre package.json, elle liste généralement les dépendances avec des plages de versions caret ou tilde. Cela signifie que npm récupère la dernière version patch ou mineure à chaque installation. Lorsqu’un de ces paquets en amont expédie un changement majeur, votre build cesse de fonctionner. Vous n’avez rien fait de mal ; vous n’avez juste pas épinglé.
Trois semaines après le déploiement est une fenêtre typique pour que cela apparaisse. Épinglez les versions explicitement le premier jour où vous avez des clients payants.
SSL, domaine ou clé API viennent d'expirer
C’est l’élément le plus absurde de la liste, et celui que les fondateurs refusent de prendre au sérieux jusqu’à ce que cela se produise. Votre certificat SSL se renouvelle à une date que vous avez oubliée, votre enregistrement de domaine expire dans 60 jours, et votre clé OpenAI a été provisionnée avec une expiration de 90 jours que votre ancien co-fondateur a mise en place.
Il n’y a pas de requête d’IA pour “et n’oubliez pas de renouveler ceci dans trois mois”. Les rappels de calendrier ne sont pas glamour, et ils préviennent plus de pannes que n’importe quel choix de framework.
La facture du niveau gratuit arrive dans votre boîte de réception
Vous avez dépassé une limite d’invocation de fonction Vercel, un seuil de ligne Supabase, ou un budget de jetons OpenAI. Aucun de ces fournisseurs ne vous avertit à l’avance avec quoi que ce soit qui ressemble à un avertissement. Ils envoient un e-mail de statut qui ressemble à une facturation de routine.
La première facture surprise est généralement trois à cinq fois supérieure à ce qu’un plan payant aurait coûté à l’avance. La leçon est de définir des alertes, pas des budgets. Les budgets arrêtent les services lorsque vous les dépassez ; les alertes vous donnent une chance de réagir avant que la page ne tombe.
Pas de tests, pas de filet de sécurité pour la prochaine requête
Les applications issues du «vibe coding» n’incluent presque jamais de tests automatisés. Les outils d’IA génèrent des fonctionnalités, pas le filet de sécurité autour d’elles. Chaque requête ultérieure n’a aucun moyen de vérifier que les flux qui fonctionnaient auparavant fonctionnent toujours, donc chaque changement est un jeu de pile ou face.
La couverture minimale utile est faible. Trois tests couvrent la majeure partie de la surface qui importe :
- Inscription et connexion
- L’action principale qui vous rapporte de l’argent (paiement, abonnement, téléchargement, génération)
- Un scénario idéal de bout en bout
Ces trois tests préviennent plus de défaillances du «vibe coding» que toute autre intervention unique que vous pouvez faire ce mois-ci.
L'IA renomme votre point d'accès public
En corrigeant un bug sans rapport, votre assistant IA a décidé que le point d’accès devrait être /api/v1/user-profile au lieu de /api/user. Le frontend a été mis à jour, les tests locaux ont été mis à jour, et le changement a été fusionné. Votre application mobile, le partenaire d’intégration tiers et la page de documentation de votre site web appellent toujours l’ancien point d’accès.
C’est un risque du «vibe coding» invisible pendant le développement et catastrophique en production. Chaque point d’accès API public nécessite un commentaire explicite «ne pas renommer» que l’IA lit en même temps que le fichier.
L'investisseur demande le schéma d'architecture pour la diligence
Vous avez levé un petit tour de table, et le conseiller technique de l’investisseur vous a envoyé un e-mail poli demandant le schéma d’architecture, la carte des dépendances et l’examen de sécurité. Vous n’avez aucune de ces choses, et l’IA ne peut pas les écrire rétroactivement car les décisions n’ont jamais été des décisions, juste des sorties.
Conserver un schéma d’architecture dessiné à la main dès la première semaine vous évite un dimanche frénétique avant l’appel de diligence. Il en va de même pour le suivi de quelques bonnes pratiques de «vibe coding» dès le premier jour, comme écrire une phrase par fusion sur ce qui a changé et pourquoi.
Ce que le mois de février vous dit vraiment
Les douze éléments partagent une cause profonde. Les outils de codage IA optimisent le code qui fonctionne immédiatement, pas le code qui résiste aux vrais utilisateurs, aux vraies données et au vrai temps. Le deuxième mois est le premier moment où votre application réunit les trois simultanément.
C’est le moment où la phase de prototypage s’est terminée et la phase de produit a commencé. Chaque équipe qui dépasse le troisième mois considère cette transition comme un événement planifié. Plus vous acceptez rapidement qu’un MVP codé de manière aléatoire est désormais candidat à la modernisation de bases de code existantes, moins le trimestre suivant coûtera cher.
L’apparence d’un véritable nettoyage de code aléatoire dépend de votre marge de manœuvre, mais l’ordre change rarement. Vous auditez ce qui est structurellement solide, corrigez d’abord les problèmes critiques de sécurité du codage aléatoire, refactorez les modèles architecturaux qui bloquent la mise à l’échelle et ajoutez une couverture de test autour des flux qui vous rapportent. Les outils de refactoring de code IA accélèrent les parties routinières, tandis qu’un ingénieur senior prend les décisions concernant où refactoriser et où réécrire à partir de zéro.
Suivre une poignée de bonnes pratiques de codage aléatoire à l’avenir rapporte plus rapidement que n’importe quel choix de framework. Épinglez les dépendances. Testez les trois flux qui comptent. Gardez un diagramme d’architecture à jour. Définissez des alertes de facturation. La discipline coûte des heures ; son absence coûte des semaines. Si votre équipe n’est pas équipée pour gérer le travail directement, c’est précisément à ce moment-là qu’un engagement structuré de nettoyage de code aléatoire rapporte le plus rapidement, souvent au cours du même trimestre où vous le commencez.
Pour les équipes qui construisent à partir de zéro au lieu de nettoyer, la même logique s’applique en sens inverse. Impliquer des ingénieurs expérimentés dans le développement d’intelligence artificielle dès le premier sprint empêche la plupart des éléments de cette liste d’apparaître. Que vous gériez cela en interne ou par le biais d’une maintenance logicielle continue avec une équipe externe, la courbe des coûts pour corriger les bugs de codage aléatoire augmente à chaque semaine de retard.
En résumé
Le mois de février ne doit pas nécessairement être une crise. Les douze problèmes ci-dessus sont prévisibles, ce qui signifie qu’ils sont planifiables. La plupart peuvent être évités avec quelques jours de travail au début, et tous peuvent être résolus une fois qu’ils apparaissent, généralement plus rapidement que ce que les fondateurs attendent. Les équipes qui dépassent le troisième mois avec leur piste d’atterrissage intacte repèrent les schémas tôt et agissent délibérément, et non réactivement. Si les éléments de cette liste correspondent à ce que vous voyez sur votre tableau de bord en ce moment, contactez-nous et nous vous aiderons à trier le pire avant le prochain cycle de facturation.
FAQ
Qu'est-ce que la dette technique du «vibe coding» ?
Il s’agit du fardeau de maintenance qui s’accumule dans les bases de code générées par l’IA, déployées sans revue d’architecture, de tests automatisés ou de renforcement de la sécurité. Elle apparaît environ quatre à huit semaines plus tard sous forme de bugs d’authentification, de problèmes d’évolutivité et de dépendances brisées. Ce schéma se développe plus rapidement que la dette technique traditionnelle car l’auteur original (l’IA) ne se souvient pas des décisions qu’il a prises, ce qui signifie que personne ne peut expliquer pourquoi le code est configuré ainsi.
Le «vibe coding» est-il prêt pour la production ?
Oui pour les prototypes et les outils internes, non pour les applications gérant des données utilisateur, des paiements ou du trafic réel sans une revue de sécurité et d’architecture préalable. La recherche industrielle montre que près de la moitié du code généré par l’IA contient des failles de sécurité exploitables. Les logiciels construits par IA peuvent être prêts pour la production, mais uniquement après un nettoyage structuré qui ajoute des tests, corrige l’authentification et découple la logique imbriquée.
Une application issue du «vibe coding» peut-elle être corrigée sans être réécrite entièrement ?
Presque toujours, oui. Une réécriture complète est rarement le bon point de départ. Un refactoring ciblé audite ce qui est structurellement sain, corrige les problèmes critiques de sécurité et de base de données, et ajoute une couverture de tests autour des flux qui vous rapportent de l’argent. Cette approche préserve les parties qui fonctionnent et est significativement plus rapide et moins coûteuse que de reconstruire à partir de zéro.
Comment savoir quand une application issue du «vibe coding» nécessite un nettoyage ?
Surveillez quatre signaux : des changements qui cassent des fonctionnalités sans rapport, des performances qui se dégradent sous trafic réel, des erreurs récurrentes à la connexion ou au paiement, et l’incapacité d’expédier de nouvelles fonctionnalités en toute confiance. L’un de ces signes est un avertissement. Les quatre indiquent que la base de code perd activement de la valeur chaque semaine où elle reste inchangée.
Découvrez comment Redwerk a repris une application de fitness en difficulté à un autre fournisseur, a nettoyé la dette technique héritée et a aidé Pridefit à augmenter ses abonnements de 45 %