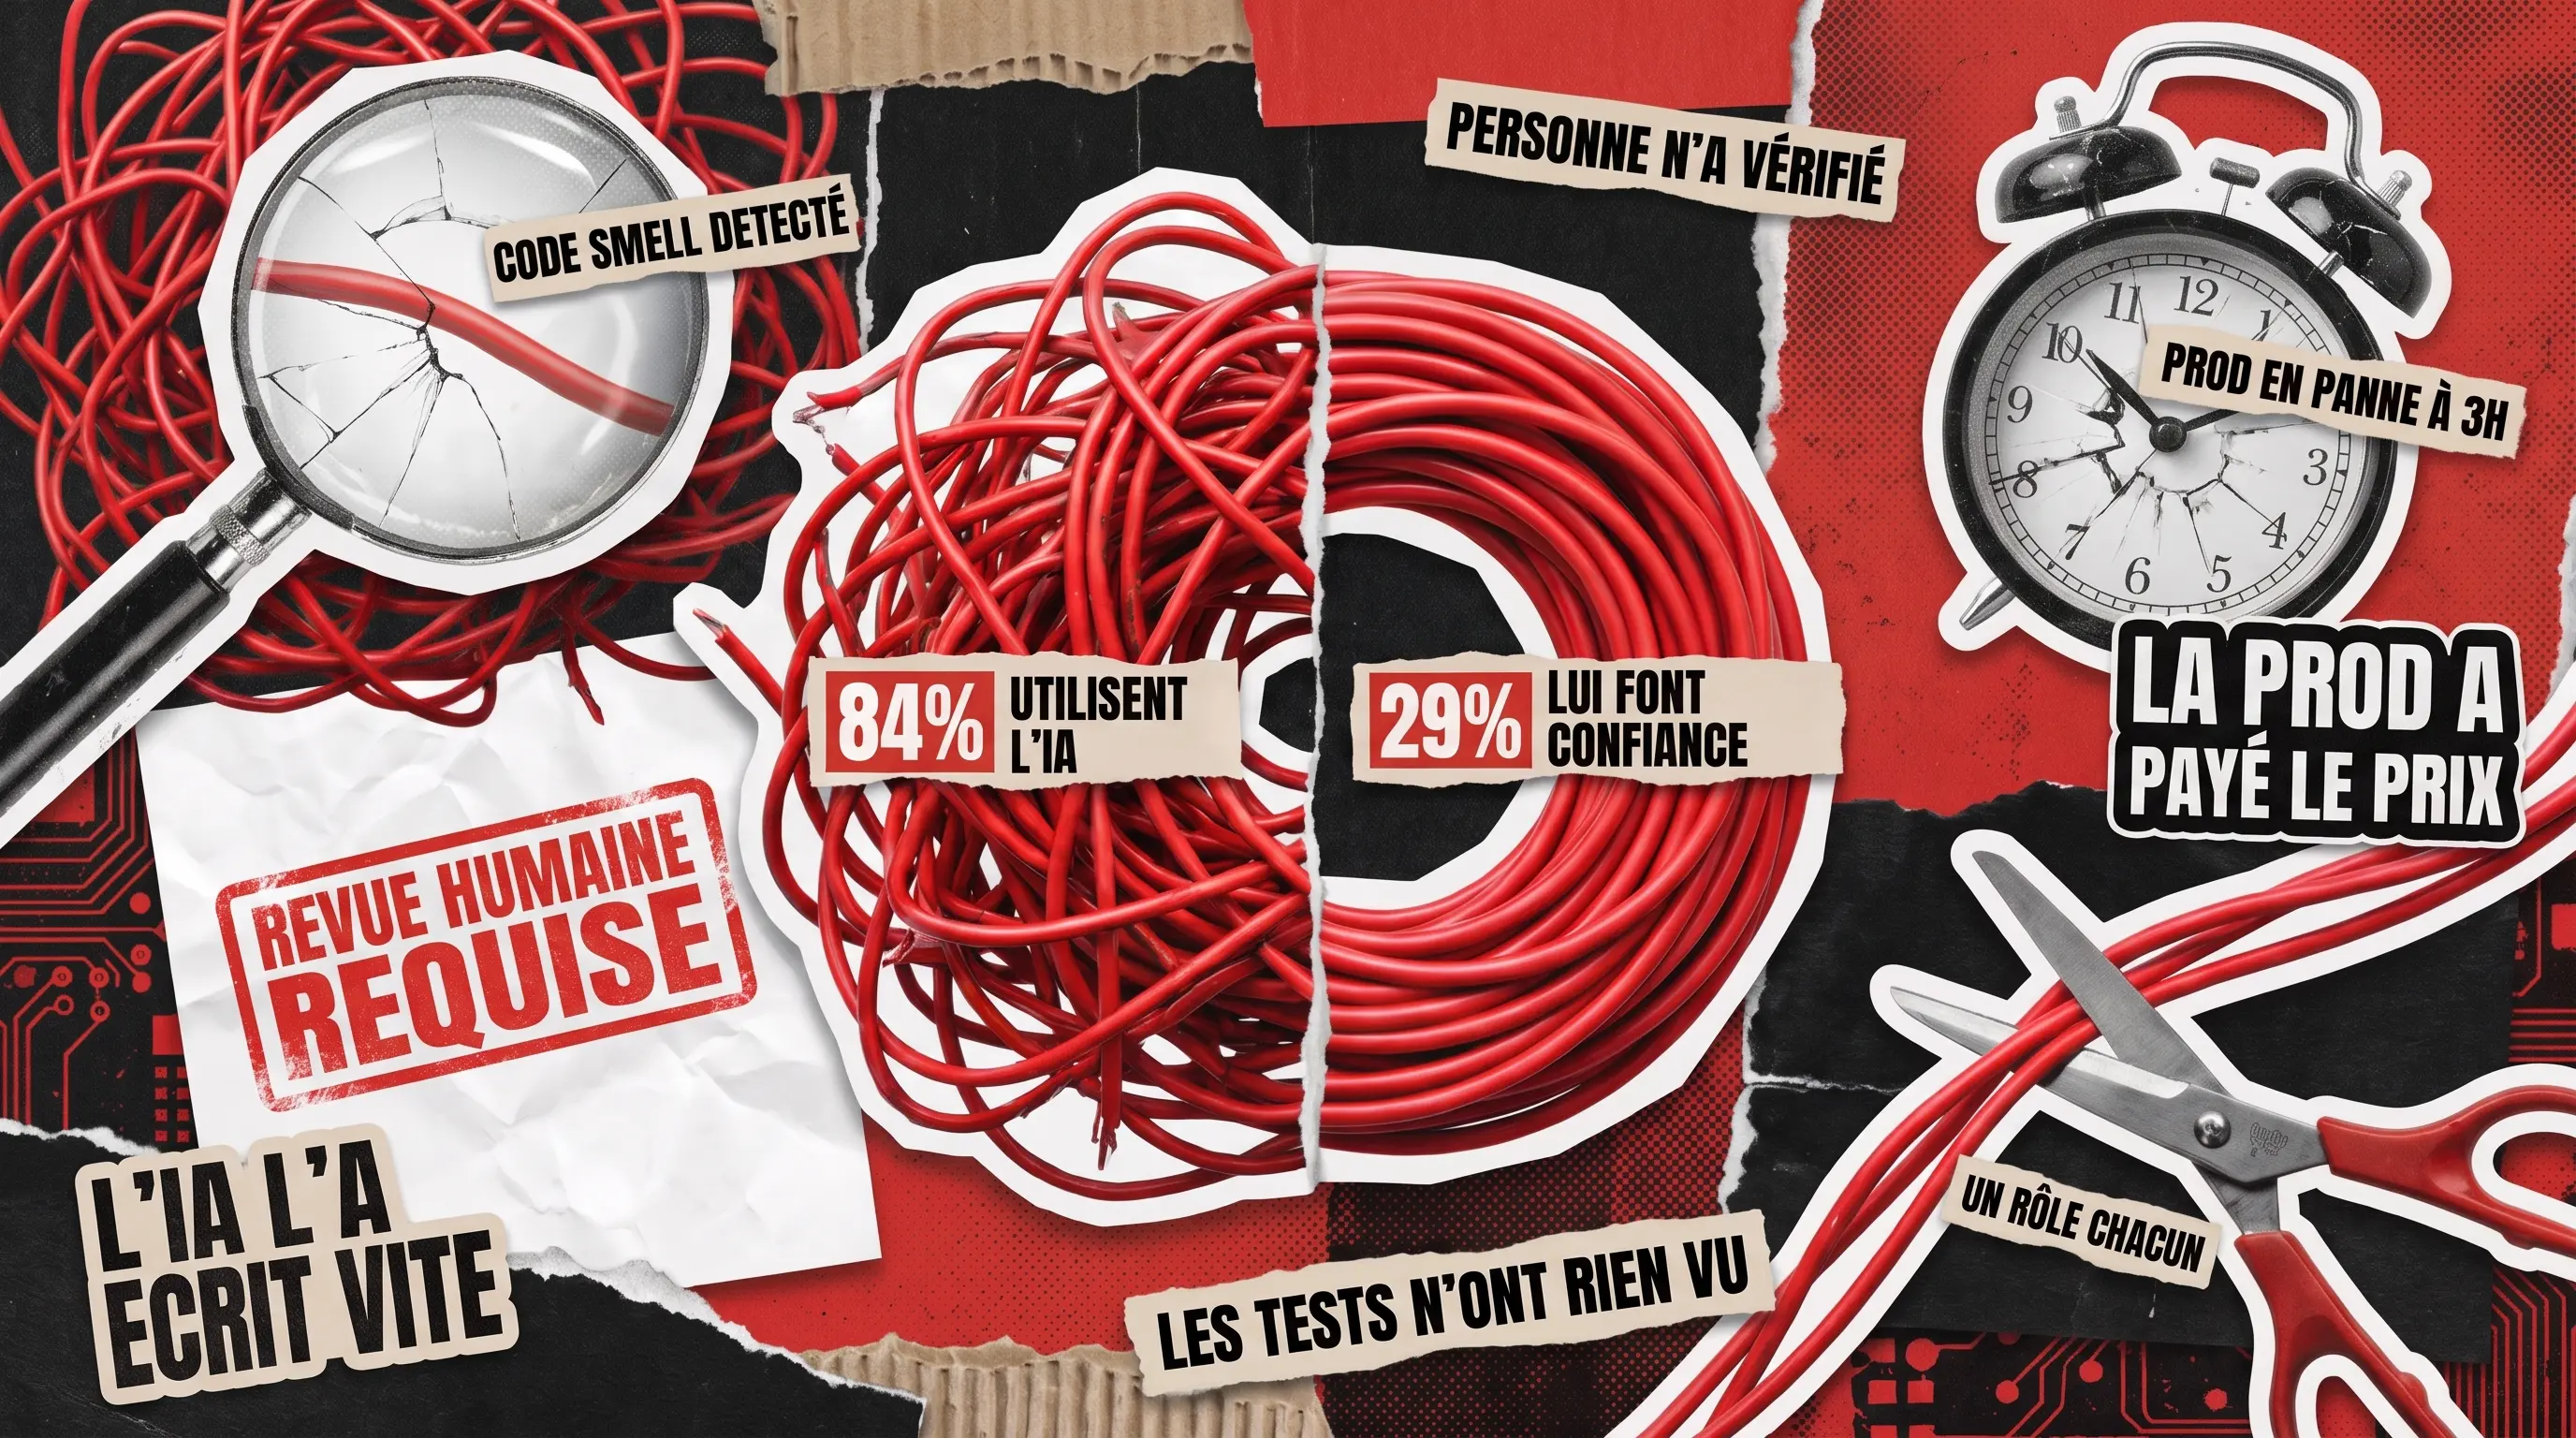
La dette technique est la principale source de frustration pour les développeurs depuis trois ans, et 2025 a ajouté une nouvelle tournure. L’enquête 2025 de Stack Overflow auprès des développeurs, basée sur 49 000 réponses, a révélé que 84 % des développeurs utilisent ou prévoient d’utiliser des outils d’IA, mais seulement 29 % font confiance à l’exactitude des résultats. La plus grande frustration, citée par 66 % des répondants, est que les solutions d’IA sont « presque correctes, mais pas tout à fait », et 45 % déclarent perdre un temps significatif à déboguer du code généré par l’IA.
Les fondateurs et les responsables de l’ingénierie se situent au milieu de cet écart. Ils savent que le refactoring est attendu depuis longtemps et que faire appel à un LLM sans plan transforme le nettoyage en un rapport de régression. Ce guide présente six techniques de refactoring de code qui valent la peine d’être utilisées en 2026, quand les utiliser, et où l’IA aide réellement. Lorsque le nettoyage semble plus important qu’un sprint, une revue de code structurée est le moyen le plus rapide de l’évaluer.
Ce que le refactoring change réellement
Le refactoring restructure le code existant sans changer ce qu’il fait de l’extérieur. Les tests réussissent avant ; les tests réussissent après. La signature de la fonction reste. Le contrat de l’API reste. Ce qui change, c’est la forme du code à l’intérieur : méthodes plus courtes, noms plus clairs, moins de doublons, une conception qui survit aux six prochains mois de travail sur les fonctionnalités.
Cette définition est importante car le terme est mal utilisé de trois manières. Corriger un bug est du débogage. Rendre le code plus rapide est de l’optimisation. Remplacer le système est une réécriture. Le refactoring est le terrain neutre discret, où la plupart des équipes de développement logiciel gagnent ou perdent leurs marges pour l’année à venir.

Les six techniques de refactoring de code à connaître en 2026
Les techniques ci-dessous couvrent environ 90 % du travail de nettoyage auquel une équipe produit de taille moyenne est confrontée par an. Chacune est associée à une odeur de code spécifique, à un langage dans lequel elle excelle, et à un verdict sur la fiabilité des LLM pour ce changement.
Refactorisations mécaniques : Extraire la méthode et Renommer
Ces deux-là vont ensemble. Ce sont les points de départ les plus rapides, les plus sûrs et les plus courants, et les IDE modernes automatisent la plupart du travail. Extraire la méthode prend une longue fonction faisant trois tâches et donne à chaque tâche son propre nom. Renommer remplace les données, tmp ou x par quelque chose qu’un lecteur peut comprendre en une seconde.
Voici un exemple Python. Avant :
def process_order(order):
    subtotal = sum(item.price * item.qty for item in order.items)
    tax = subtotal * 0.2
    total = subtotal + tax - order.discount
    send_email(order.customer, total)
    return total
Après :
def process_order(order):
    subtotal = calculate_subtotal(order.items)
    total = apply_tax_and_discount(subtotal, order.discount)
    notify_customer(order.customer, total)
    return total
Chaque aide à la fonction se lit comme une phrase. La fonction principale se lit comme un plan. Ce type de changement est celui où les assistants IA fonctionnent de manière fiable et où vous devriez les laisser intervenir.
Refactoring par abstraction
Deux composants React partagent 80 % de la même logique avec de légères différences. Trois microservices analysent chacun la même charge utile webhook à leur manière. L’abstraction extrait la logique partagée dans un seul endroit : une classe de base, un hook partagé, un module utilitaire.
Le retour sur investissement est réel. Lorsque le format de la charge utile change, vous modifiez un seul fichier, et cette modification se propage. Le risque est également réel. Abstrait trop tôt, et vous inventez une hiérarchie qui ne convient à rien. Une règle utile issue de décennies de pratique : attendez que trois doublons concrets existent avant d’abstraire. Deux peuvent être une coïncidence. Trois, c’est un schéma.
C’est l’une des techniques où un LLM produira avec confiance une abstraction qui semble propre et échoue silencieusement dans le cas limite qui importe. Un examen humain est requis.
Remplacer le conditionnel par le polymorphisme
L’instruction switch qui grossit chaque trimestre est l’odeur de code classique. Une méthode getShippingCost avec quinze branches if pour quinze types de produits. Exemple Java :
// Avant
double getShippingCost(Product p) {
    if (p.type == BOOK) return p.weight * 0.5 ;
    if (p.type == FRAGILE) return p.weight * 2.0 + 5 ;
    if (p.type == DIGITAL) return 0 ;
    // ...
}
Après cela, chaque type de produit possède son propre calcul de frais d’expédition en tant que sous-classe ou stratégie, et le conditionnel géant disparaît. Les nouveaux types de produits s’insèrent par la hiérarchie de types, laissant le code ancien inchangé. Cette technique explique pourquoi le principe Ouvert-Fermé est au centre de la plupart des références aux techniques de refactoring de code Java.
Rouge-Vert-Refactoriser
C’est la discipline qui rend toutes les autres techniques sûres. Écrivez un test qui échoue. Faites en sorte qu’il réussisse avec le code le plus simple. Ensuite, améliorez le code pendant que le test reste vert. Cela vient directement du développement piloté par les tests, et c’est la raison pour laquelle les équipes matures peuvent refactoriser du code agressivement sans casser la production.
La raison de le nommer ici : la plupart des équipes qui échouent au refactoring sautent cette étape. Elles restructurent sans filet de sécurité, livrent, découvrent une régression plus tard, et blâment le refactoring. L’enquête de McKinsey a révélé que les équipes logicielles de premier quartile utilisant l’IA obtiennent des améliorations de productivité de 16 à 30 % et des gains de qualité logicielle de 31 à 45 %, et le fil conducteur commun à ces meilleures performances est des tests disciplinés autour de chaque changement. Le filet de sécurité est ce qui rend la différence mesurable.
Refactoring préparatoire
La phrase de Kent Beck : rendez le changement facile, puis faites le changement facile. Si une nouvelle fonctionnalité nécessite de toucher un module embrouillé, l’action honnête est de nettoyer le module d’abord, puis d’ajouter la fonctionnalité. Deux commits. Deux revues. Deux points de retour arrière. C’est l’une des meilleures pratiques pour le refactoring de code qui semble évidente dans un article de blog et qui est négligée dans les sprints réels sous la pression des délais.
L’erreur que la plupart des équipes commettent est de regrouper les deux. Le refactoring et la fonctionnalité sont livrés dans une seule et grande pull request ; personne ne peut dire quel changement a cassé la production, et l’équipe abandonne le refactoring pour une autre année. Séparez les commits et le retour sur investissement se multiplie. Sur les produits en direct, maintenir cette discipline au fil des trimestres est au cœur de tout engagement sérieux de maintenance logicielle.
Strangler Fig pour le code hérité
Certaines bases de code se situent au-delà du point où le refactoring sur place a un sens. Un monolithe de douze ans avec 400 000 lignes et aucun test résiste à tout effort de nettoyage que vous lui appliquez. Le modèle de figuier étrangleur enveloppe le système hérité avec une nouvelle interface, redirige le trafic fonction par fonction vers des remplacements modernes, et laisse le vieux code mourir pièce par pièce.
C’est la technique qui se rentabilise sur les projets de modernisation du code hérité. Elle préserve les revenus pendant que l’équipe livre des améliorations incrémentielles. Les anciens monolithes nécessitent souvent une modernisation du code hérité dédiée plutôt qu’un refactoring sur place, et nos notes de terrain sur les meilleures pratiques de modernisation du code hérité couvrent les choix de séquençage qui décident si la migration est livrée en quelques mois ou s’étend sur plusieurs années.
Refactoring assisté par IA
L’IA a changé l’économie du refactoring au cours des dix-huit derniers mois. Elle a également changé le mode d’échec. Un renommage assisté par IA semble parfait dans le diff, est livré en production, et casse un appel basé sur la réflexion que le modèle n’a jamais vu.
Là où les LLM justifient leur coût dans le refactoring :
- Renommages de boilerplate dans un fichier ou un module.
- Suggestions d’extraire la méthode sur des fonctions que le modèle peut lire de bout en bout.
- Échafaudage de tests de caractérisation pour le code hérité sans couverture.
- Remplacements d’API obsolètes au niveau de l’appel.
- Génération de docstrings et de commentaires inline.
Là où ils nuisent :
- Abstractions inter-fichiers qui nécessitent la compréhension de règles métier que le modèle n’a jamais vues.
- Identification de points d’entrée pour les migrations par strangler fig.
- Tout changement apporté à du code qui ne dispose pas d’une suite de tests réussie.
La configuration pragmatique utilisée par les équipes qui tirent parti du refactoring par IA : associez chaque changement assisté par LLM à une suite de tests verte et à une revue humaine du diff. C’est l’une des meilleures pratiques de refactoring de code qui sépare les équipes qui livrent du code plus propre de celles qui livrent des régressions plus rapides. La même enquête de McKinsey a révélé que plus de 90 % des équipes de développement utilisent désormais l’IA pour le refactoring, la modernisation et les tests, économisant en moyenne six heures par développeur par semaine. Déployées avec une discipline de revue, les équipes obtiennent des diffs plus rapides et des versions plus propres. L’intégration de cette couche de revue dans un flux d’ingénierie de produits logiciels continue d’ingénierie de produits logiciels est ce qui empêche les accélérations de l’IA de devenir des régressions plus rapides.
Idiomes spécifiques au langage qui ne correspondent pas aux six universels
Les six techniques ci-dessus sont indépendantes du langage. Chaque langage grand public a également des idiomes qui n’ont de sens qu’au sein de cet écosystème, et les ignorer laisse des nettoyages évidents sur la table.
Python
Les techniques de refactoring de code Python à garder en mémoire : remplacer les boucles for explicites par des compréhensions lorsque l’intention est une transformation ou un filtre, déplacer les valeurs codées en dur dans la configuration ou les variables d’environnement, et utiliser les dataclasses au lieu des dictionnaires lorsque la forme se stabilise. Le passage de la communauté Python vers les indications de type en 2024-2025 a également créé un chemin de refactoring à faible effort : annoter les signatures de fonctions, exécuter mypy, et laisser le vérificateur de type révéler la dérive qui s’est accumulée depuis le dernier nettoyage. C’est une voie fiable pour améliorer la lisibilité d’une base de code mature sans toucher à la logique métier.
Java
L’API Stream et les expressions lambda sont toujours la principale source de gains de nettoyage spécifiques à Java. Les boucles qui filtrent, transforment et agrègent peuvent être compressées en une seule expression qui énonce l’intention plutôt que les mécanismes. De plus, les enregistrements (finalisés en Java 16 et maintenant largement adoptés) remplacent les classes porteuses de données verbeuses par des déclarations de trois lignes. L’application du principe de responsabilité unique aux classes de service gonflées reste le changement structurel le plus impactant dans le backlog de la plupart des équipes Java.
JavaScript / React
Le code React vieillit mal lorsque les composants dépassent quelques centaines de lignes. Deux mouvements permettent de récupérer la plupart de la lisibilité perdue. Premièrement, extraire des hooks personnalisés pour toute logique qui touche à l’état ou aux effets et pourrait être réutilisée. Deuxièmement, remplacer le prop drilling par le contexte ou une bibliothèque d’état une fois que le même prop traverse trois limites de composants. Côté JavaScript, le passage des chaînes de callbacks à async/await reste l’une des réécritures à plus fort effet de levier dans les anciennes bases de code de développement logiciel, et les linters modernes présentent automatiquement chaque candidat.
Quand le refactoring est la mauvaise décision
Le refactoring est un outil. Chaque outil a une mauvaise situation. Trois cas où une réécriture ou un wrapper est préférable à un refactoring :
La plateforme cible est mise à la retraite. Si le framework est en fin de vie ou si le runtime atteint une date de fin de support du fournisseur, refactoriser à l’intérieur repousse le vrai travail. Planifiez la migration.
Le code n’a aucune couverture de test et est activement dans le trafic de production. Refactoriser à l’aveugle est le moyen le plus rapide de livrer une régression aux clients payants. Écrivez d’abord des tests de caractérisation qui verrouillent le comportement actuel, puis refactorisez en toute sécurité avec le filet en place. Si la base de code résiste même à cela, enveloppez-la avec un strangler fig à la place.
Le coût d’apprentissage du code dépasse le coût de sa réécriture. C’est la décision honnête sur certaines bases de code héritées. Si personne dans l’équipe ne peut expliquer ce que fait un module critique en une semaine, et que le module fait 500 lignes, une réécriture de code propre avec les bons tests peut être moins chère que l’archéologie. Cette décision nécessite des données, et une revue de code structurée révèle les chiffres dont vous avez besoin pour la prendre.
Facilitez la prochaine fonctionnalité
Chacune de ces techniques est un investissement pour la prochaine fonctionnalité. Extraire la méthode facilite la tâche du prochain lecteur. L’abstraction rend le prochain doublon moins coûteux. Le strangler fig permet la prochaine migration. La phrase de Kent Beck est toujours valable vingt ans plus tard : rendez le changement facile, puis faites le changement facile.
Deux ancrages sont plus importants que toute technique spécifique. Gardez une suite de tests qui réussit devant chaque refactoring. Gardez le commit de refactoring séparé du commit de fonctionnalité. Les équipes qui font les deux multiplient les gains. Si votre équipe planifie un nettoyage majeur et souhaite un deuxième avis sur le séquençage, contactez-nous, et nous examinerons le plan.
FAQ
Qu'est-ce que le refactoring de code ?
Le refactoring de code est le processus de restructuration du code source existant pour améliorer sa lisibilité, sa maintenabilité et sa structure, sans modifier ce que le logiciel fait extérieurement. Les tests qui ont réussi avant le changement doivent réussir après. L’objectif est une base de code moins coûteuse à étendre, plus facile à déboguer et plus sûre à transmettre.
Quelles sont les techniques de refactoring de code les plus courantes ?
Les techniques les plus utilisées sont Extraire la méthode, Renommer, Refactoring par abstraction, Remplacer le conditionnel par le polymorphisme, Rouge-Vert-Refactoriser, Refactoring préparatoire et le modèle Strangler Fig pour les systèmes hérités. Chacune d’elles traite une odeur de code spécifique et convient mieux à certains langages qu’à d’autres.
Est-il sûr de refactoriser du code avec l'IA ?
Sûr pour les changements mécaniques tels que les renommages et l’extraction de méthodes dans un seul fichier, à condition que la suite de tests réussisse. Risqué pour les abstractions inter-fichiers, la logique axée sur les règles métier et tout changement de code qui manque de couverture de test. Le modèle fiable utilisé par les équipes qui réussissent avec le refactoring par IA est une suite de tests verte plus une revue humaine du diff sur chaque changement généré par LLM.
Quelle est la différence entre refactoring et réécriture ?
Le refactoring préserve le comportement externe et fait évoluer la structure interne du code par petites étapes réversibles. La réécriture remplace le code, modifiant souvent le comportement, l’architecture ou la plateforme. Le refactoring est le défaut le plus sûr. La réécriture l’emporte lorsque la plateforme cible est abandonnée ou lorsque le coût d’apprentissage du code existant dépasse celui de son remplacement.
À quelle fréquence les équipes devraient-elles refactoriser ?
En continu, dans de petits commits aux côtés du travail de développement de fonctionnalités, plutôt que sous forme de projets isolés de plusieurs semaines. Les équipes qui réservent du temps pour le refactoring dans chaque sprint maintiennent la dette technique gérable. Les équipes qui la reportent à un trimestre de nettoyage dédié découvrent généralement que la dette s’est accumulée au-delà de ce que ce trimestre peut gérer.
Découvrez comment une revue de code Redwerk d'un backend Python a révélé 40 problèmes critiques et a entraîné une augmentation de 80 % de la maintenabilité pour le projet Science