
Cet article est une introduction au développement d’applications basées sur les microservices et à leur gestion. Il décrit les approches de conception architecturale et d’implémentation utilisant .NET Core et les conteneurs Docker. Cet article a été rédigé pour les développeurs .NET et les architectes de solutions qui tentent de prendre une décision concernant l’architecture de leur application et qui ne sont pas familiers avec l’architecture basée sur les microservices. Dans cet article, vous découvrirez les avantages de la mise en œuvre d’une architecture basée sur les microservices au lieu du développement d’une application monolithique, ainsi que les approches pour résoudre les principaux problèmes que vous pourriez rencontrer en raison de cette approche.
Le modèle de conception des microservices favorise le développement d’applications complexes sous forme d’un ensemble de petites parties indépendantes (services), qui répondent aux besoins métiers. Chaque microservice est responsable d’une fonction spécifique du système.
Au lieu d’une application monolithique, les microservices peuvent être hébergés à différents endroits et les développeurs peuvent apporter des modifications importantes en temps réel, sans arrêter l’ensemble du système.
Pourquoi les microservices plutôt que l’architecture monolithique ?
Pendant longtemps, le coût, le temps et la complexité de la mise à disposition de nouveau matériel ont eu un impact indéniable sur le développement des applications. Étant donné que les applications étaient écrites pour être dimensionnées statiquement et conçues pour du matériel spécifique, lorsque la charge entraînait une application dépassant les capacités de son matériel, la seule réponse était de « mettre à l’échelle » (scale-up), c’est-à-dire d’améliorer le matériel de l’application pour ajouter de la capacité, afin d’éviter la reconfiguration du centre de données et le refactoring logiciel.
Le modèle d’application monolithique était limité et inefficace. La modification d’une partie de l’application pouvait coûter cher en temps et introduire un bug n’importe où dans le système. Dans ce cas, les développeurs devaient déboguer une base de code énorme pour trouver ce qui avait mal tourné. Toute nouvelle fonctionnalité livrée pouvait tout détruire temporairement.
Les entreprises tentent de plus en plus de résoudre certains problèmes lors de l’utilisation de grandes applications d’entreprise pour répondre à leurs propres besoins :
- Réduire les coûts
- Rendre le processus de déploiement moins douloureux
- Améliorer le DevOps
Ces problèmes peuvent être résolus en utilisant l’architecture de microservices en parallèle avec les conteneurs. La conteneurisation Docker devient la norme dans le déploiement d’applications. Les avantages de la conteneurisation sont une architecture flexible, légère, sécurisée, évolutive et portable. Avec l’aide de Kubernetes, vous pouvez facilement déployer et héberger vos conteneurs, gérer les charges de travail et les services conteneurisés.
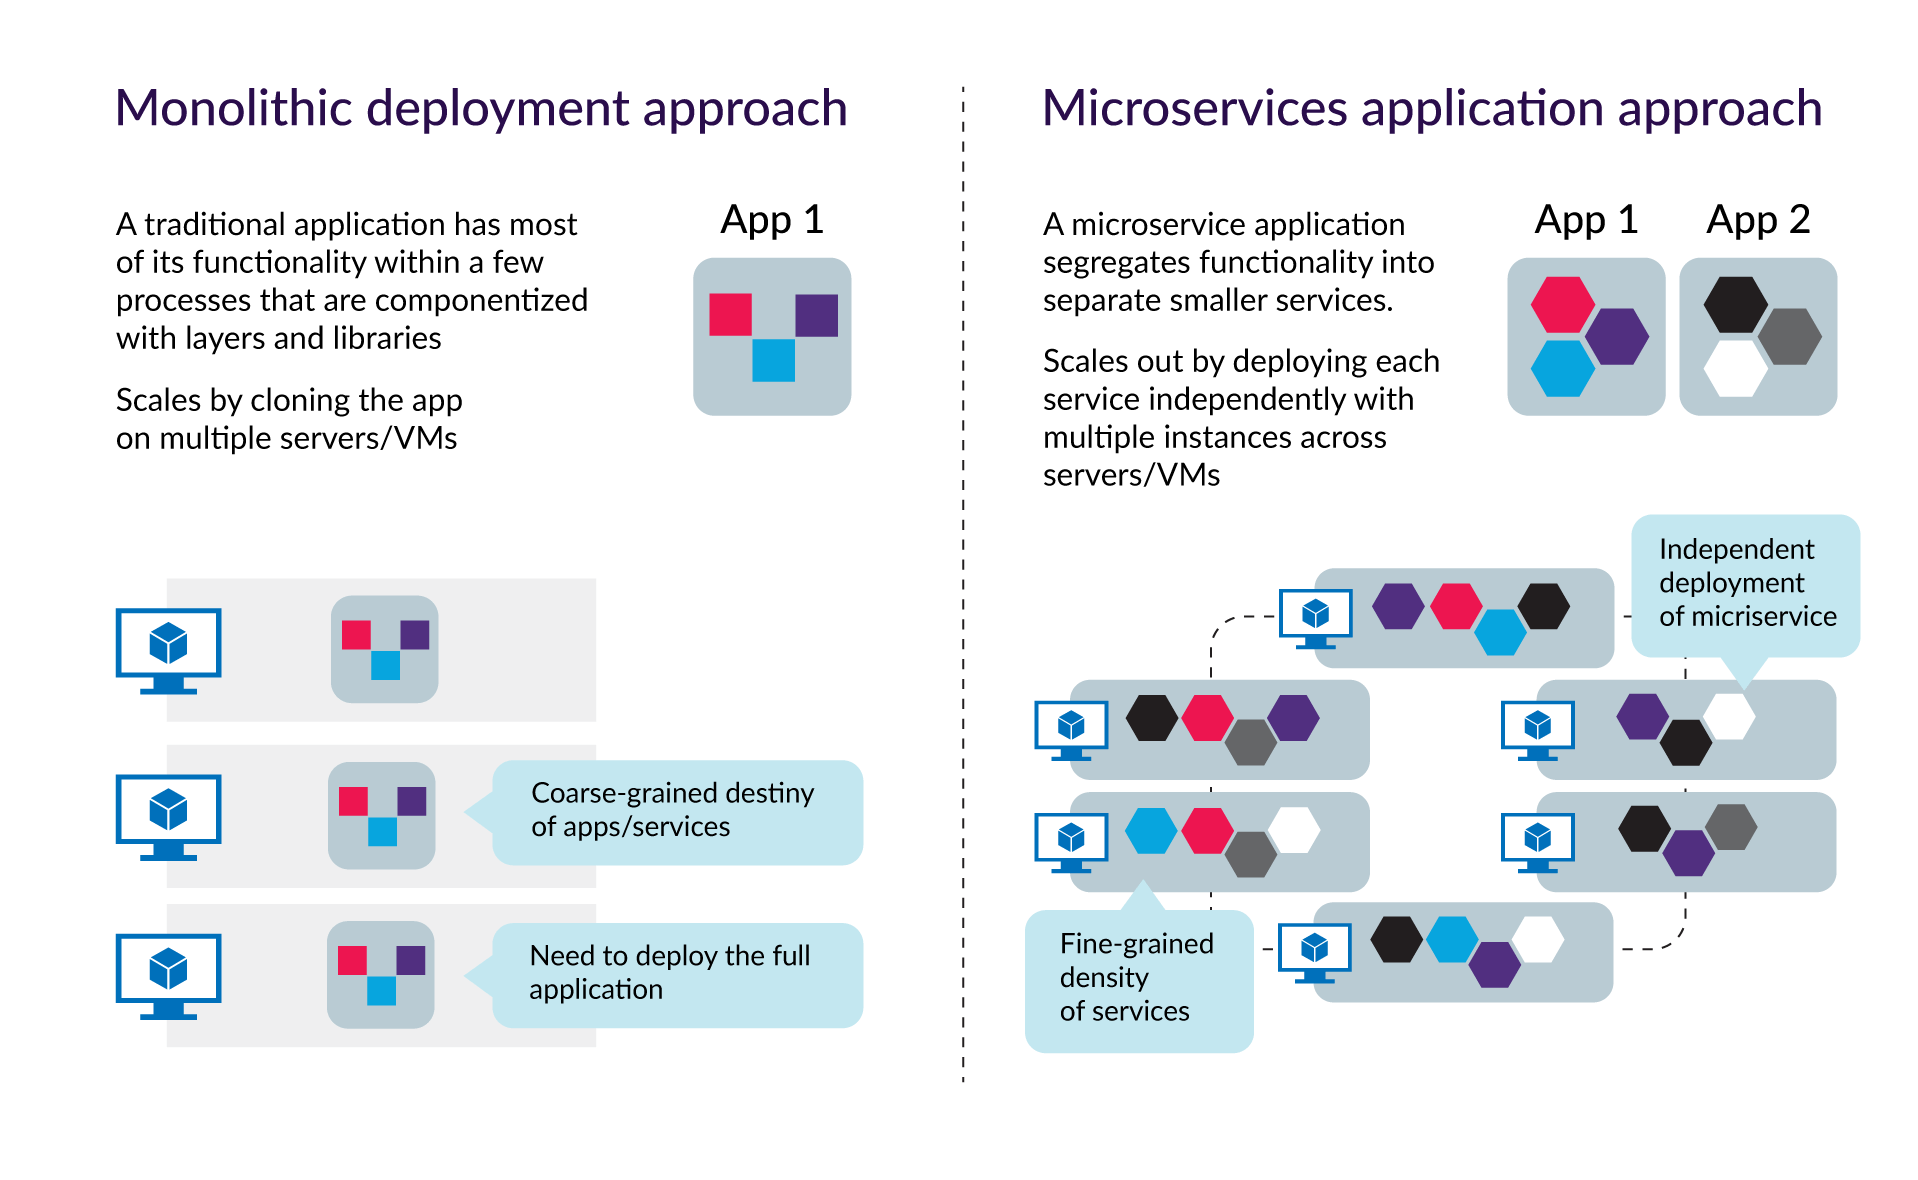
Dans ce cas, lorsque vous avez une application à forte charge, vous n’avez pas besoin de mettre à l’échelle l’application entière, comme ce serait le cas avec une architecture monolithique. Vous pouvez mettre à l’échelle uniquement quelques microservices qui subissent la charge la plus élevée et améliorer vos performances avec une consommation de ressources minimale.
Avantages et inconvénients de l’architecture de microservices
L’architecture de microservices est une approche de construction d’une application serveur sous forme d’un ensemble de petits services. Chaque service doit s’exécuter dans son propre processus et communiquer avec les autres services en utilisant des protocoles tels que HTTP/HTTPS, WebSockets, etc. Toute partie de cette structure (c’est-à-dire le service) doit être développée comme une unité autonome, qui peut être déployée indépendamment. Chaque microservice doit posséder son modèle de données de domaine et sa logique de domaine associés, et peut être basé sur différentes technologies de stockage de données. D’ailleurs, il peut être écrit dans différents langages de programmation.
Le point principal lors du développement de microservices est de créer des services faiblement couplés, afin de permettre un déploiement, une mise à l’échelle et un développement indépendants de chaque service dans l’application. Si nous parlons de la taille des microservices, nous devons essayer de les rendre aussi petits que possible, tout en leur laissant un minimum de dépendances directes vis-à-vis des autres microservices. Cela offre une agilité à long terme, une évolutivité et une meilleure maintenabilité à l’avenir.
La construction d’une architecture de microservices très granulaire permet des pratiques d’intégration continue (CI) et de livraison continue (CD). Elle offre la possibilité d’intégrer facilement de nouvelles fonctionnalités dans des applications déjà en production. Vous pouvez entièrement modifier l’un des microservices pour implémenter une nouvelle fonctionnalité, voire le décomposer, et cela ne cassera pas l’ensemble du système que vous avez construit.
Enfin, vous pouvez ajouter des tests unitaires à chaque microservice, ce qui vous permettra de détecter facilement tout problème ou bug dans votre système avant qu’il n’atteigne la production. Dans ce cas, vous n’avez pas besoin de vérifier l’application entière, vous devez simplement déboguer une petite partie du code – le microservice actuel.
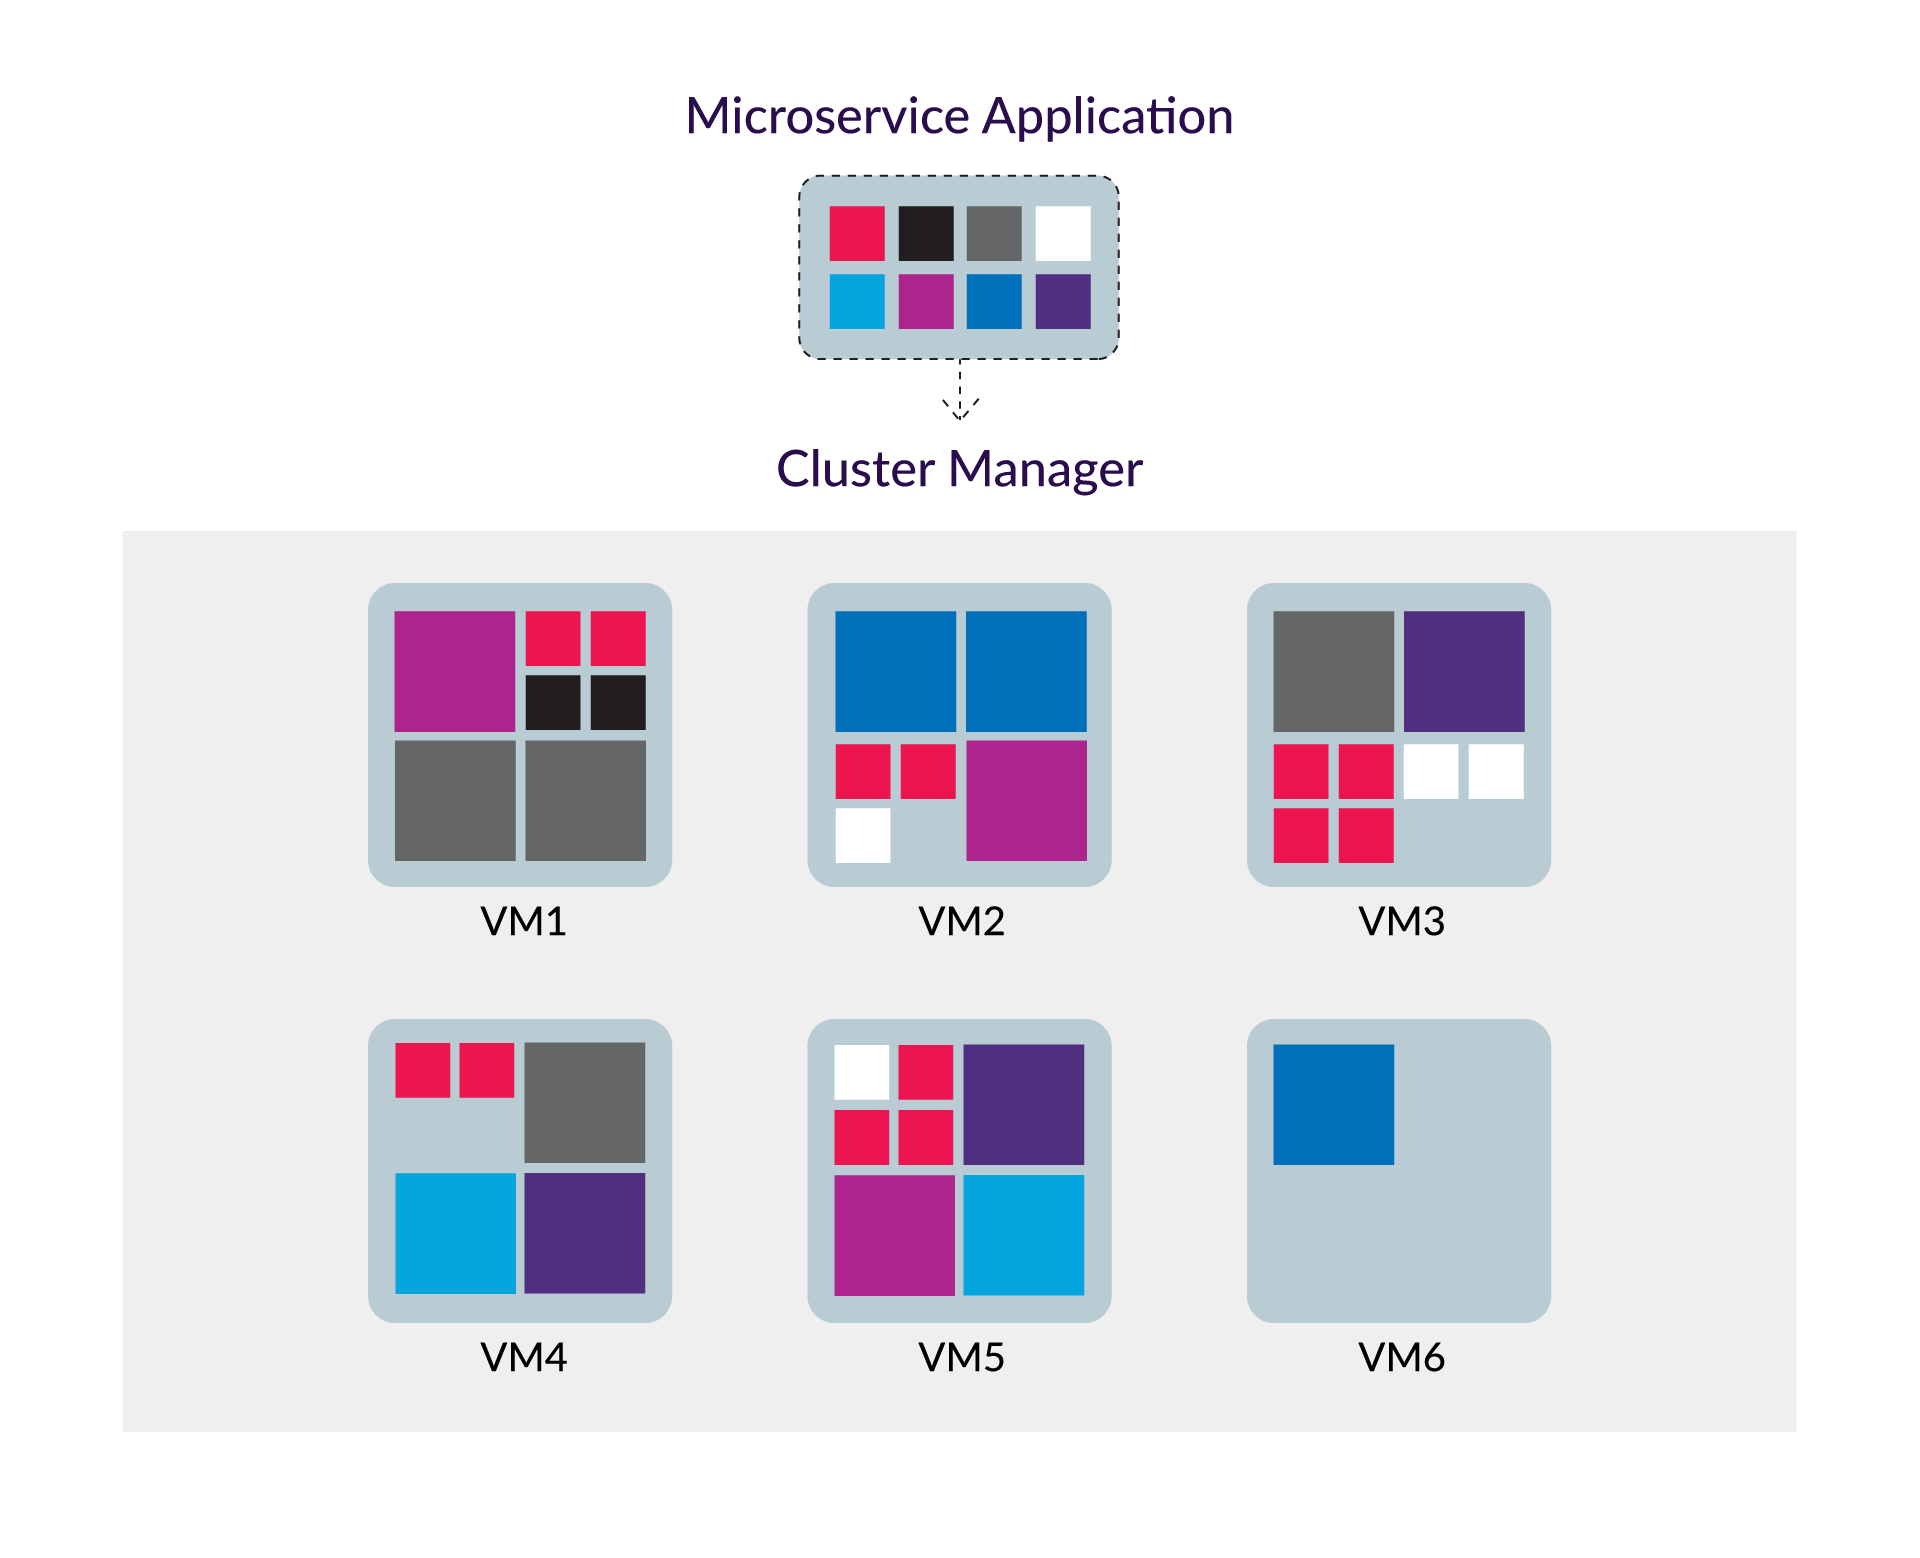
Avoir créé avec succès une application de microservices complète et la déployer sur une plateforme spécifique pour la gestion des microservices signifie que vous bénéficierez de certains avantages, tels que l’efficacité des coûts, l’évolutivité et la disponibilité 24h/24 et 7j/7. Maintenir la santé des microservices peut être assuré en déplaçant les instances vers des machines virtuelles ou des serveurs sains par la plateforme. Ainsi, lorsque le logiciel ou le matériel sur lequel ils s’exécutent échoue ou doit être redémarré pour des mises à niveau, le système les déplace automatiquement vers un endroit sûr où ces microservices peuvent continuer à fonctionner avec succès. D’ailleurs, les microservices peuvent être mis à l’échelle de la même manière, simplement en copiant le service vers une nouvelle machine virtuelle et en démarrant une instance supplémentaire.
Plateformes pouvant être utilisées pour héberger et gérer vos microservices :
- Kubernetes
- Mesosphere DCOS
- Docker Swarm et Docker Compose
- OpenShift
- Pivotal Cloud Foundry
- Service Fabric
Toutes ces plateformes peuvent être utilisées avec succès pour exécuter votre application sur l’infrastructure Azure sans aucun problème ni solution de contournement spécifique. La gestion, la mise à l’échelle, le déploiement et le développement faciles des microservices, n’est-ce pas une révolution dans le développement d’applications ?
Problèmes et solutions pour la gestion distribuée des données
1. Comment définir les limites de chaque microservice
Le premier problème que vous rencontrez lorsque vous essayez de créer une architecture de microservices est de définir les limites des microservices. Chaque service doit être autonome et constituer une partie du système entier. Vous devez conserver tous les avantages que l’infrastructure de microservices peut offrir.
Vous devez vous concentrer sur les modèles de domaine logiques et les données associées. Essayez d’identifier les îles de données découplées et les différents contextes au sein de la même application. Ces contextes doivent être gérés et définis séparément.
2. Comment créer des requêtes qui récupèrent des données de plusieurs microservices
Le problème est que vous essayez d’éviter les références directes du client à différents services. Surtout lorsque l’application cliente doit appeler plusieurs API de microservices pour effectuer une tâche. Par exemple, lorsque vous devez obtenir le rôle d’un utilisateur (service de sécurité) et l’historique des commandes (service de commandes). L’envoi de requêtes différentes pour effectuer une seule action peut être une très mauvaise solution.
Les méthodes les plus populaires pour éviter ce problème sont :
- Créer une passerelle API (API Gateway) pour recevoir toutes les requêtes client et distribuer les requêtes vers d’autres services. Même si l’un de vos microservices a besoin d’obtenir des données d’un autre microservice, vous pouvez envoyer une requête au microservice passerelle. Cette requête sera redirigée vers le bon récepteur.
- CQRS avec tables de requêtes/lectures (CQRS with query/reads tables). Cette solution consiste à agréger les données de plusieurs microservices en utilisant le modèle de vue matérialisée (Materialized View pattern). Dans ce cas, vous générez simplement une table en lecture seule avec les données appartenant à différents microservices. Cette table a un format qui doit être reçu par le client.
3. Comment concevoir la communication entre les limites des microservices
Un autre problème que vous devez résoudre est la communication. Une approche populaire consiste à utiliser des microservices basés sur HTTP, ce qui est parfaitement acceptable. C’est une bonne idée d’utiliser cette solution pour interagir avec une passerelle API ou différents microservices. Mais il y a un risque, car vous pouvez créer une chaîne de requêtes HTTP excessivement longue qui peut transformer votre application basée sur des microservices en quelque chose de monolithique et vous faire perdre tous vos avantages.
Pourquoi les passerelles API sont meilleures que la communication directe avec les microservices
Lorsque vous développez une application, vous ne pouvez rien prédire. Vous devez construire une architecture qui peut être facilement mise à l’échelle, améliorée ou modifiée. Si vous avez des requêtes directes des clients vers vos microservices, toute mise à jour de la réponse de votre microservice peut provoquer des erreurs. Les clients devront être mis à jour pour utiliser différents points de terminaison ou recevoir une réponse dans différents formats. Si vous utilisez une passerelle API, les modifications apportées aux microservices n’affecteront en rien vos clients. Vous devrez simplement modifier les paramètres de la passerelle pour utiliser de nouveaux points de terminaison ou obtenir une nouvelle réponse. Ou même modifier les nouvelles réponses pour les faire correspondre au format que les clients utilisaient auparavant.
Enfin, si vous utilisez la communication directe, vous pouvez rencontrer les problèmes suivants :
- Couplage. Les applications clientes doivent savoir où et comment obtenir les données dont elles ont besoin. Elles doivent avoir des liens directs vers les services qui peuvent fournir les informations nécessaires.
- Trop d’allers-retours. Si vous devez appeler différents microservices pour effectuer une action, vous pouvez obtenir plusieurs allers-retours réseau et une latence significative. Cela peut entraîner des problèmes de performance.
- Problèmes de sécurité. En cas de communication directe, vous devez exposer vos microservices au monde extérieur pour donner aux clients la possibilité d’utiliser votre application. En cas d’utilisation d’une passerelle API, vous pouvez rendre vos microservices accessibles uniquement depuis le microservice passerelle. C’est une méthode plus sûre.
- Préoccupations transversales (Cross-cutting concerns). Tous vos microservices ayant une communication directe avec un client doivent contenir une certaine logique pour vérifier l’autorisation, obtenir les rôles et les permissions des utilisateurs, etc. Cela peut entraîner des problèmes de performance. En cas d’utilisation d’une passerelle, cette vérification des permissions ne devrait se trouver que dans le microservice passerelle.
Résumé
Choisir la bonne architecture pour une application est l’une des décisions les plus précieuses pour créer des solutions de qualité, performantes et optimisées. Et il existe de nombreux facteurs de risque que vous devez prendre en compte.
| Monolithique | Microservices | |
| Gestion des données | Vous pouvez utiliser un seul stockage pour les données de l’application entière | Distribuée. Vous devez trouver un moyen d’isoler vos microservices les uns des autres ou de synchroniser les données entre eux |
| Développement | Tout le monde dans l’équipe doit connaître l’architecture de l’application entière | Chaque service peut être développé indépendamment, par différentes équipes |
| Déploiement | Vous pouvez déployer et mettre à l’échelle uniquement l’application entière | Chaque service peut être déployé indépendamment. Vous pouvez mettre à l’échelle uniquement les services dont vous avez besoin et dépenser moins |
| Obtenir des données | Vous pouvez obtenir toutes les données souhaitées en une seule requête simple | Vous devez trouver des moyens de collecter des données auprès de différents microservices |
| Coûts | Vous dépenserez plus d’argent en cas de mise à l’échelle de votre application | L’hébergement indépendant de chaque service peut permettre d’économiser des coûts |
La solution dépend de la taille de votre application. L’architecture d’application monolithique peut être une bonne idée pour les applications petites et légères. Mais elle n’est pas vraiment adaptée aux applications complexes ou évolutives. Il est beaucoup plus facile de construire une architecture monolithique au début du développement de l’application. Mais à l’avenir, en cas d’évolution, d’extension de fonctionnalités, la poursuite du développement entraînera plus de problèmes et plus de dépenses. Si vous avez besoin de mettre à l’échelle votre application, dans le cas monolithique, vous devrez mettre à l’échelle l’instance entière et volumineuse de votre application. Dans le cas d’une architecture basée sur les microservices, vous pouvez mettre à l’échelle seulement quelques microservices et économiser vos coûts.
Alors, que préférer, les microservices ou le monolithique ? La réponse est assez simple : si vous avez une application petite ou légère, vous pouvez utiliser une architecture monolithique pour construire votre système très rapidement. Mais si vous essayez de créer quelque chose de grand, vous devriez préférer une architecture basée sur les microservices.


