Le sujet de l’architecture microservices est devenu de plus en plus populaire ces dernières années. La raison en réside dans les nombreux avantages qu’apporte le style architectural modulaire, en particulier lorsqu’il s’agit de concevoir des applications complexes.
L’architecture microservices convient parfaitement aux applications qui doivent traiter rapidement les transactions et gérer des volumes de trafic élevés ainsi qu’un grand nombre d’utilisateurs simultanés. C’est pourquoi les entreprises impliquées dans le développement SaaS, qu’il s’agisse d’une plateforme e-commerce, d’une application de médias sociaux, d’un service de streaming ou d’une application de livraison de repas, s’appuient sur les microservices pour rendre leurs solutions évolutives et résilientes aux pannes.
Nous avons déjà abordé les avantages et les inconvénients de la mise en œuvre de l’architecture microservices et comparé les microservices à l’architecture monolithique ici.
Cet article a été écrit pour les développeurs .NET et les architectes de solutions qui souhaitent améliorer leur application basée sur des microservices et trouver la bonne approche pour implémenter la communication entre les microservices.
Les microservices peuvent-ils être entièrement indépendants ?
L’architecture d’application basée sur les microservices est conçue pour permettre le fonctionnement indépendant de petites parties d’un grand système. Chaque microservice est responsable d’une fonction spécifique du système, et chaque service peut être lié à un stockage de données différent. Par exemple, un service peut stocker des données dans une base de données Microsoft SQL, et un autre peut utiliser un stockage NoSQL, comme MongoDB, etc.
D’un autre côté, il existe de nombreux cas où nous ne pouvons pas créer des parties totalement indépendantes. Par exemple, nous créons un microservice de sécurité responsable de la sécurité et de l’autorisation des utilisateurs. Nous avons également besoin d’un microservice de communication pour suivre les messages, les notifications et autres instances d’interaction avec l’utilisateur. Ces deux microservices dépendent de la même base d’utilisateurs, tout en étant indépendants dans le type d’informations utilisateur qu’ils stockent, ne conservant que les données essentielles à leur fonctionnement. Dans un tel scénario, l’idée principale est de minimiser la dépendance de chaque service vis-à-vis d’un autre. Parfois, nous devons effectuer des requêtes inter-services, voire stocker des données similaires à différents endroits. À ce stade, nous devons permettre aux microservices de communiquer entre eux.
Pourquoi devons-nous établir une communication entre les services ?
Comme nous l’avons mentionné ci-dessus, il peut être très difficile de créer une architecture totalement indépendante, car dans certains cas, vos microservices doivent communiquer entre eux. Soit dit en passant, vous pourriez avoir besoin de communication même si vous stockez des données similaires dans un stockage différent. Pour donner des exemples, nous prendrons l’un de nos projets existants, où nous avons dû mettre en œuvre une communication inter-services.
Nous avons une application composée d’une liste de microservices. Pour notre exemple, nous nous concentrerons uniquement sur quelques-uns d’entre eux : autorisation, analyse, commandes, passerelle et service d’e-mail. Chaque service possède sa propre base de données pour stocker les données indépendamment.
Examinons brièvement le but de chaque microservice :
- Passerelle (Gateway). Distribue les requêtes aux autres microservices en fonction de leur destination. Les autres microservices n’acceptent les requêtes que de la passerelle. La passerelle est le seul microservice ouvert aux requêtes externes.
- Autorisation. Fournit les principales fonctionnalités de sécurité pour l’ensemble de l’application : connexion, déconnexion, enregistrement, récupération de mot de passe, etc.
- E-mail. Permet d’envoyer divers messages électroniques aux utilisateurs, tels que des rappels, des newsletters, des e-mails de récupération de mot de passe, etc.
- Commandes (Orders). C’est le microservice responsable de l’exécution de toutes les opérations principales de commande, telles que la création, la mise à jour, la suppression, la visualisation, le calcul, la tarification, le suivi des commandes, et bien plus encore. Ce service contient toutes les informations sur les commandes dans le système, et c’est le stockage de données principal de l’application.
- Analyse (Analytics). Fournit certaines fonctionnalités pour visualiser les statistiques et les analyses, telles que le nombre de commandes ouvertes dans le système, leur durée d’ouverture, et d’autres données nécessaires à une prise de décision efficace. Ce service ne stocke peut-être pas tous les détails de la commande, mais il permet d’accéder rapidement et facilement à des données cruciales présentées dans un format visuellement attrayant.
Comme vous pouvez le constater, chaque microservice est responsable d’opérations différentes et n’a généralement pas besoin du même stockage de données, car les données pour chaque microservice sont assez distinctes. L’exception concerne le microservice d’analyse. Il devrait avoir les mêmes informations sur les commandes dans le système. Cependant, devrions-nous utiliser le même stockage de données ?
Pourquoi est-il préférable d’avoir un stockage de données différent pour chaque microservice ?
Si vous construisez une architecture basée sur des microservices pour votre application, vous devez vous soucier de l’évolutivité de celle-ci. Dans le cas d’une utilisation du même stockage de données pour différents microservices, vous rencontrerez des problèmes d’évolutivité. Si l’un de vos services est surchargé, cela peut également affecter le stockage de données. Vous devrez donc augmenter le nombre d’éléments pour améliorer les performances de l’un de vos services. Dans ce cas, les instances d’application sont beaucoup plus importantes. Notez que les données placées dans un seul stockage peuvent affecter les performances. De plus, cela peut entraîner une charge importante.
Pour éviter ces problèmes, vous pouvez utiliser un stockage de données différent pour chaque microservice. La conception d’un stockage adapté aux besoins d’un service précis peut améliorer les performances des opérations de traitement des données. De plus, elle peut simplifier le développement et le travail avec les données, car les données sont stockées dans un format pratique et prêt à l’emploi, évitant ainsi la conversion des données.
Toute modification de votre microservice n’entraînera aucun bug caché dans les autres microservices, car ils sont indépendants. Si vous utilisez le même stockage et décidez de modifier un modèle d’entité, vous n’aurez pas à répéter ces modifications dans tous les autres services qui utilisent le même stockage de données.
Dans notre cas avec les microservices d’analyse et de commandes, nous avons quelques détails supplémentaires. Le service Commandes peut modifier les commandes à tout moment et il subit une charge élevée. Le service d’Analyse ne doit que calculer certaines données pour les graphiques et les tableaux de bord. Il n’est pas nécessaire de récupérer toutes les modifications immédiatement, nous pouvons donc effectuer ces opérations selon un planning (horaire, quotidien, etc.).
En résumé, nous devons synchroniser nos données dans ces deux services et les recalculer lorsque les entités de données sont modifiées. Cela peut être résolu à l’aide de la communication inter-services via des files d’attente de messages. Nous avons utilisé un courtier de messages Azure Service Bus à cet effet.
Qu’est-ce qu’Azure Service Bus ?
Azure Service Bus est un courtier de messages d’intégration d’entreprise entièrement géré. Azure Service Bus peut découpler les applications et les services et offre une plateforme fiable et sécurisée pour le transfert asynchrone de données et d’état. L’idée principale est d’envoyer n’importe quelles données entre les services en utilisant des messages. Ces messages sont au format binaire et peuvent contenir du JSON, du XML, ou même du texte brut.
Les principales fonctionnalités d’Azure Service Bus sont les suivantes :
- Envoi de messages via des files d’attente. Le récepteur doit commencer à écouter une file d’attente spéciale, et si un message est envoyé à cette file d’attente, l’écouteur le recevra. Il n’est pas nécessaire que les deux instances (expéditeur et récepteur) soient en ligne en même temps. Les messages sont envoyés à la file d’attente et attendent qu’un récepteur souhaite les recevoir.
- Topics et abonnements. Vous pouvez créer des éditeurs et des abonnés qui écoutent des sujets spécifiques. Ainsi, un éditeur peut partager un message avec différents récepteurs (relation 1:n).
- Planification de l’heure. Vous pouvez planifier un message pour une heure spécifique, et les abonnés le recevront à l’heure prévue.
Files d’attente (Queues)
Tous les messages sont envoyés et reçus des files d’attente. Vous envoyez simplement un message à une file d’attente spécifique, et les messages attendront un récepteur qui recevra et traitera ce message. À la fin du traitement du message, le récepteur doit compléter un message pour le supprimer de la file d’attente.
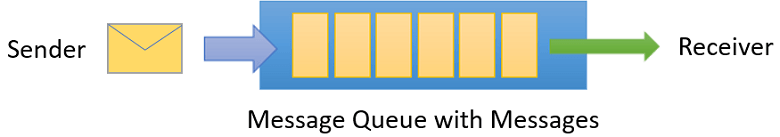
De plus, vous pouvez configurer votre file d’attente pour compléter automatiquement votre message dès la première réception. Dans ce cas, le message sera supprimé dès que l’écouteur l’aura reçu.
Sujets (Topics)
Il existe une autre façon d’utiliser les messages, basée sur les sujets et les abonnements. Vous pouvez configurer des filtres, une durée de vie, et même des conditions pour recevoir des messages dans différentes instances. De plus, différents récepteurs peuvent gérer les messages d’un seul expéditeur. Un abonné peut recevoir une copie de chaque message envoyé au sujet, mais les messages peuvent expirer ou être supprimés automatiquement.
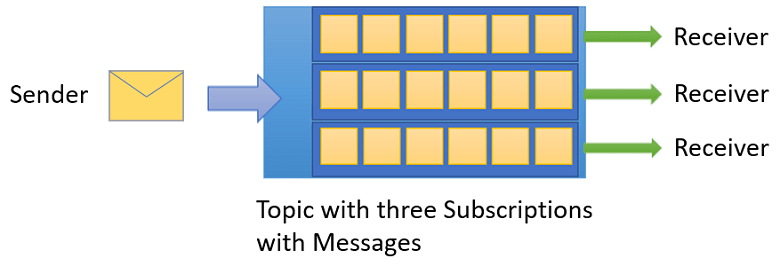
Nous avons préféré utiliser des files d’attente car nous n’avons qu’un seul service (analyse) qui doit écouter tous les messages concernant les mises à jour de commande.
Implémentation d’Azure Service Bus
Azure Service Bus est très facile à utiliser. Nous pouvons implémenter cette fonctionnalité en quelques lignes. Mais d’abord, nous devons aller sur le portail Azure et créer une ressource Service Bus.
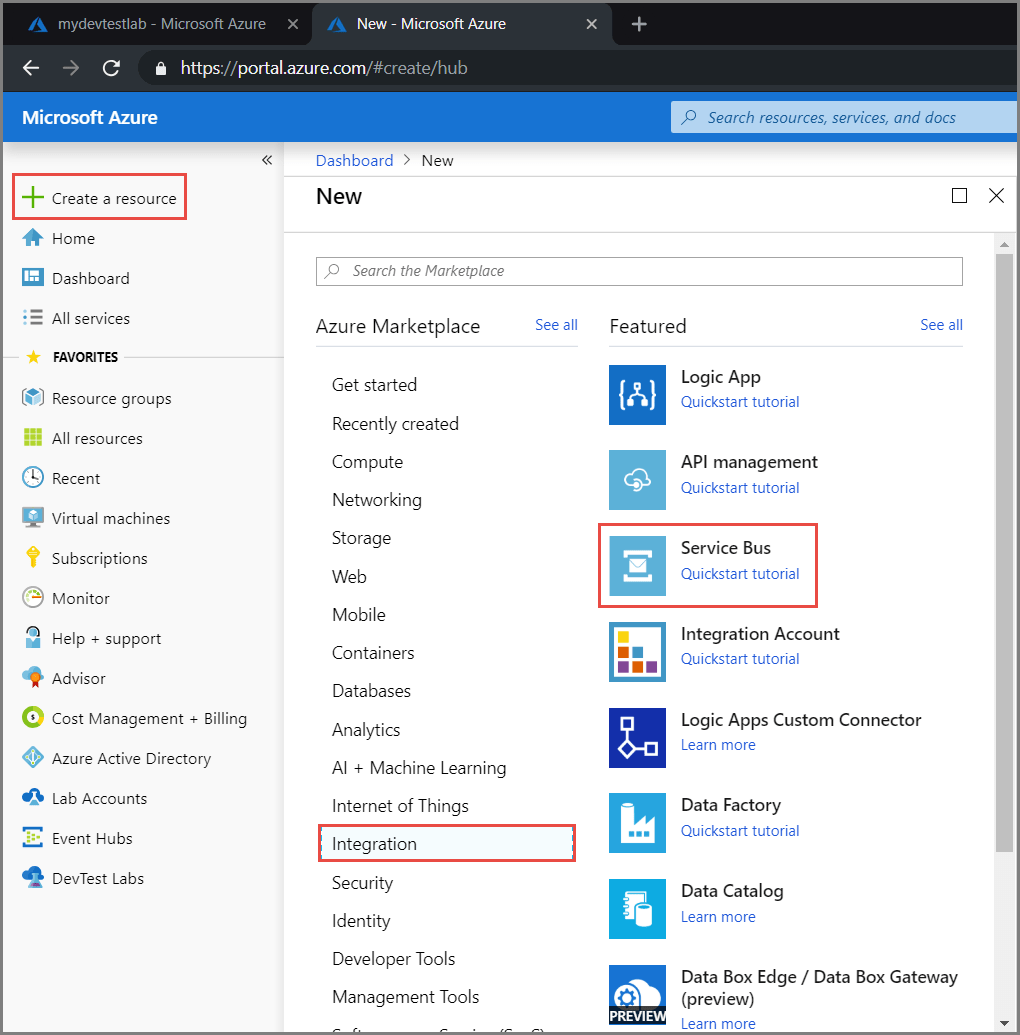
L’étape suivante consiste à remplir les champs principaux : nom, groupe de ressources, emplacement. Si tout se passe bien, vous recevrez une notification et vous pourrez voir votre espace de noms Service Bus. Pour commencer à travailler avec Service Bus, nous devons obtenir une chaîne de connexion. Vous pouvez le faire en cliquant sur « Stratégies d’accès partagé ». Vous devez insérer ces données dans le fichier de configuration de votre application.
L’étape suivante consiste à créer une File d’attente. Cela peut être fait sur le portail Azure.
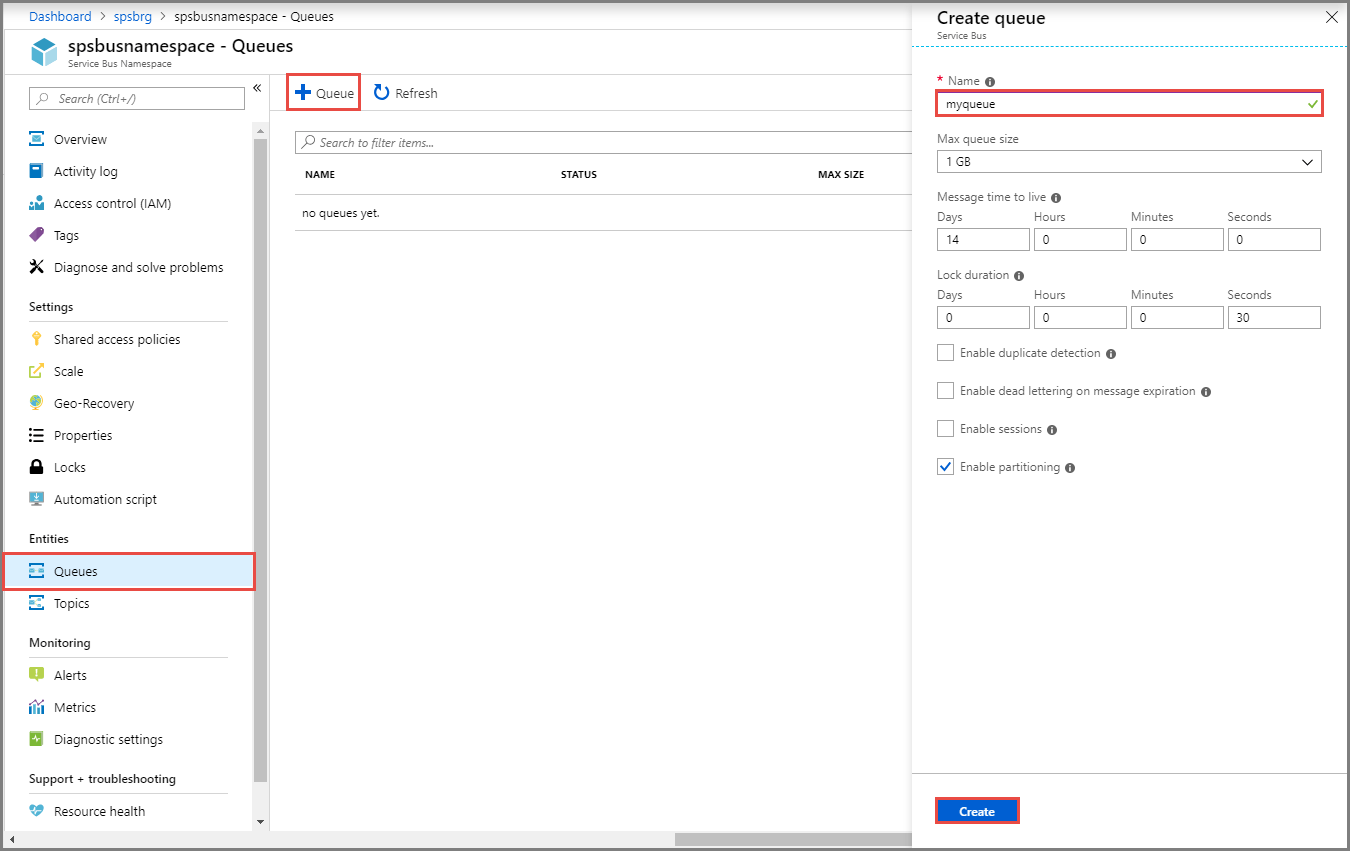
À ce stade, vous pouvez configurer votre file d’attente. Vous devez définir le nom de votre file d’attente, et vous pouvez continuer sans aucun paramètre spécial.
Cependant, il y a quelques points importants à connaître sur les valeurs de configuration :
- Durée de vie du message (Message time to live). Indique combien de temps votre message pourra être reçu et traité. Si votre message a expiré, il est envoyé à la file d’attente “Dead Letter”.
- Durée du verrou (Lock duration). Lorsqu’un écouteur reçoit un message, il dispose d’un certain temps pour le traiter. Pendant cette période, le message sera verrouillé, et personne d’autre ne pourra le recevoir. Si ce délai expire, le message devient disponible pour être reçu par toute instance qui écoute cette file d’attente.
- File d’attente Dead Letter. Une autre chose à savoir est que si un message est reçu dix fois et n’est pas complété, ce message sera envoyé à la file d’attente “Dead Letter”. Si, lors du traitement du message, votre application génère une erreur non gérée, ce message sera renvoyé à la file d’attente.
La première étape consiste à installer le package Microsoft.Azure.ServiceBus. Cela peut se faire via le gestionnaire de package NuGet.
Pour envoyer votre premier message à la file d’attente, vous devez vous connecter à la file d’attente Azure Service Bus. Cela peut se faire comme suit :
const string ServiceBusConnectionString = "votre chaîne de connexion";
const string QueueName = "votre nom de file d'attente";
static IQueueClient queueClient;

static async Task MainAsync() {
    queueClient = new QueueClient(ServiceBusConnectionString, QueueName);
    // Enregistrer le gestionnaire de messages de QueueClient et recevoir les messages en boucle
    RegisterOnMessageHandlerAndReceiveMessages();

    Console.ReadKey();

    await queueClient.CloseAsync();
}
Nous devons maintenant enregistrer un gestionnaire de messages pour commencer à écouter la file d’attente.
static void RegisterOnMessageHandlerAndReceiveMessages() {
    // Configurer les options du gestionnaire de messages en termes de gestion des exceptions, nombre de messages simultanés à livrer, etc.
    var messageHandlerOptions = new MessageHandlerOptions(ExceptionReceivedHandler) {
        // Nombre maximal d'appels simultanés à la fonction de rappel `ProcessMessagesAsync`, défini sur 1 pour simplifier.
        // Définissez-le en fonction du nombre de messages que l'application souhaite traiter en parallèle.
        MaxConcurrentCalls = 1,

        // Indique si le MessagePump doit automatiquement compléter les messages après leur retour de la fonction de rappel utilisateur.
        // False ci-dessous indique que le `Complete` sera géré par la fonction de rappel utilisateur, comme dans `ProcessMessagesAsync` ci-dessous.
        AutoComplete = false
    };

    // Enregistrer la fonction qui traitera les messages
    queueClient.RegisterMessageHandler(ProcessMessagesAsync, messageHandlerOptions);
}
Avant d’envoyer notre premier message à la file d’attente, nous devons préparer une méthode pour traiter les messages qui seront reçus de la file d’attente. Dans le code ci-dessus, nous avons enregistré la méthode de gestionnaire nommée « ProcessMessagesAsync ». Implémentons cette méthode comme suit :
static async Task ProcessMessagesAsync(Message message, CancellationToken token) {
    // Traiter le message
    Console.WriteLine($"Message reçu : SequenceNumber:{message.SystemProperties.SequenceNumber} Body:{Encoding.UTF8.GetString(message.Body)}");

    // Compléter le message pour qu'il ne soit pas reçu à nouveau.
    await queueClient.CompleteAsync(message.SystemProperties.LockToken);
}
Notez que si vous ne complétez pas votre message avec la méthode CompleteAsync, ou si vous le configurez pour l’auto-complétion, vous le recevrez à nouveau.
La dernière étape consiste à envoyer notre premier message à la file d’attente.
// Créer un nouveau message à envoyer à la file d'attente
var message = new Message(Encoding.UTF8.GetBytes(messageBody));

// Envoyer le message à la file d'attente
await queueClient.SendAsync(message);
Après cette étape, vous pouvez aller sur le portail Azure et constater que le compteur de messages est maintenant supérieur à zéro. Si vous regardez votre console, vous verrez que vous avez reçu un nouveau message de la file d’attente.
Comme vous pouvez le constater, c’est vraiment facile à utiliser. Vous n’avez pas besoin d’écrire beaucoup de code pour implémenter la messagerie inter-services en utilisant Azure Service Bus. De plus, vous n’avez pas besoin de contrôler le traitement de vos messages. En cas d’erreur, ce message sera automatiquement renvoyé à la file d’attente. De plus, vous n’avez pas à vous soucier d’une réception de message infinie (boucle), car lorsque le message cause une erreur plusieurs fois, il est dirigé vers la file d’attente “Dead Letter”. Par la suite, le message ne sera plus reçu.
Nous obtiendrons le flux suivant une fois la commande mise à jour :
- Le microservice Commande envoie un message contenant la commande mise à jour à la file d’attente des commandes ;
- Le microservice d’Analyse, qui écoute cette file d’attente, reçoit ce message ;
- Le microservice d’Analyse traite ce message, met à jour les entités concernant le nouveau modèle de commande et déclenche le recalcul des analyses ;
- Le microservice d’Analyse recalcule certaines données analytiques et complète ce message.
Dans ce cas, nous aurons des données analytiques à jour immédiatement après la mise à jour de la commande. Nous devrions implémenter le même flux pour la création et la suppression de commandes.
Avantages de cette approche :
- Nous pouvons facilement synchroniser les données entre les services ;
- Nous n’avons pas besoin que les deux services soient en ligne, et nous pouvons simplement exécuter le microservice d’analyse selon un calendrier pour recevoir et traiter les messages, calculer les données nécessaires, puis mettre le microservice en veille ;
- Si le traitement des messages échoue, il sera automatiquement renvoyé. Pas besoin de créer des fonctions spéciales ou même des blocs try-catch ;
- Les messages ne peuvent pas être perdus. Même s’ils ne peuvent pas être traités, ils sont envoyés à la file d’attente “Dead Letter”, et vous pouvez facilement contrôler vos messages échoués.
Notes importantes :
- Les données ne seront pas synchronisées immédiatement. D’abord, elles vont dans la file d’attente, puis elles sont reçues et enfin traitées. Si vous avez besoin d’une synchronisation immédiate des données, vous devriez utiliser des requêtes directes pour mettre à jour une entité, mais cela peut nuire aux performances et poser des problèmes supplémentaires ;
- Vous devez contrôler les instances de l’application qui écoutent la file d’attente. Utilisez des classes singleton pour écouter la file d’attente, sinon vous pourriez obtenir une erreur lorsque le même message est reçu plusieurs fois par la même application.
File d’attente Dead Letter dans Azure Service Bus
Lorsque vous rencontrez des erreurs ou des échecs de traitement de message à plusieurs reprises, ou si votre message a simplement expiré, il peut être déplacé vers la file d’attente “Dead Letter”. Ces messages seront stockés dans cette file d’attente jusqu’à ce que vous les supprimiez ou les traitiez. La file d’attente “Dead Letter” peut envoyer des messages au récepteur, et vous pouvez facilement travailler avec ces messages comme avec n’importe quelle autre file d’attente. La seule différence entre ces files d’attente est le nom. Si vous souhaitez commencer à écouter la file d’attente “Dead Letter”, vous devez utiliser l’instruction suivante :
const string ServiceBusConnectionString = "votre chaîne de connexion";
const string QueueName = "votre nom de file d'attente";
static IQueueClient deadLetterQueueClient;

static async Task MainAsync() {
    deadLetterQueueClient = new QueueClient(ServiceBusConnectionString, EntityNameHelper.FormatDeadLetterPath(QueueName));
    RegisterOnMessageHandlerAndReceiveMessages();

    Console.ReadKey();

    await queueClient.CloseAsync();
}
Vous devez simplement passer le nom de votre file d’attente à la méthode `FormatDeadLetterPath` de `EntityNameHelper` et utiliser le résultat comme nom de file d’attente. Pour chaque file d’attente que vous avez créée dans Azure Service Bus, il existe une file d’attente “Dead Letter” supplémentaire.
De plus, vous pouvez visualiser les messages “Dead Letter” dans le portail Azure sans aucune implémentation de code. Cependant, vous pouvez utiliser cet exemple de code pour créer, par exemple, une fonction de traitement des messages “Dead Letter” qui vous notifiera des erreurs dans votre application ou même les résoudra.
Résumé
Dans certains cas, nous ne pouvons pas créer de microservices entièrement indépendants. À ce stade, nous pouvons avoir besoin de mettre en œuvre une communication entre les services, ce qui peut se faire par messagerie inter-services. Nous vous recommandons d’utiliser Azure Service Bus pour transférer des données dans l’application, créer une messagerie inter-services et synchroniser les données entre les microservices de votre application.
Cette fonctionnalité est très facile à implémenter dans n’importe quelle application existante. Grâce à ce service, vous pouvez réduire la charge du système, car votre application pourra traiter les tâches une par une, et non simultanément, comme avec les requêtes directes.
Dans une architecture basée sur des microservices, la communication entre les microservices jouera un rôle important en termes de performances. Vous devez donc choisir l’approche appropriée pour la communication inter-services en fonction de vos besoins.
Découvrez comment nous avons développé une solution pour une logistique fitness claire en utilisant le framework .NET