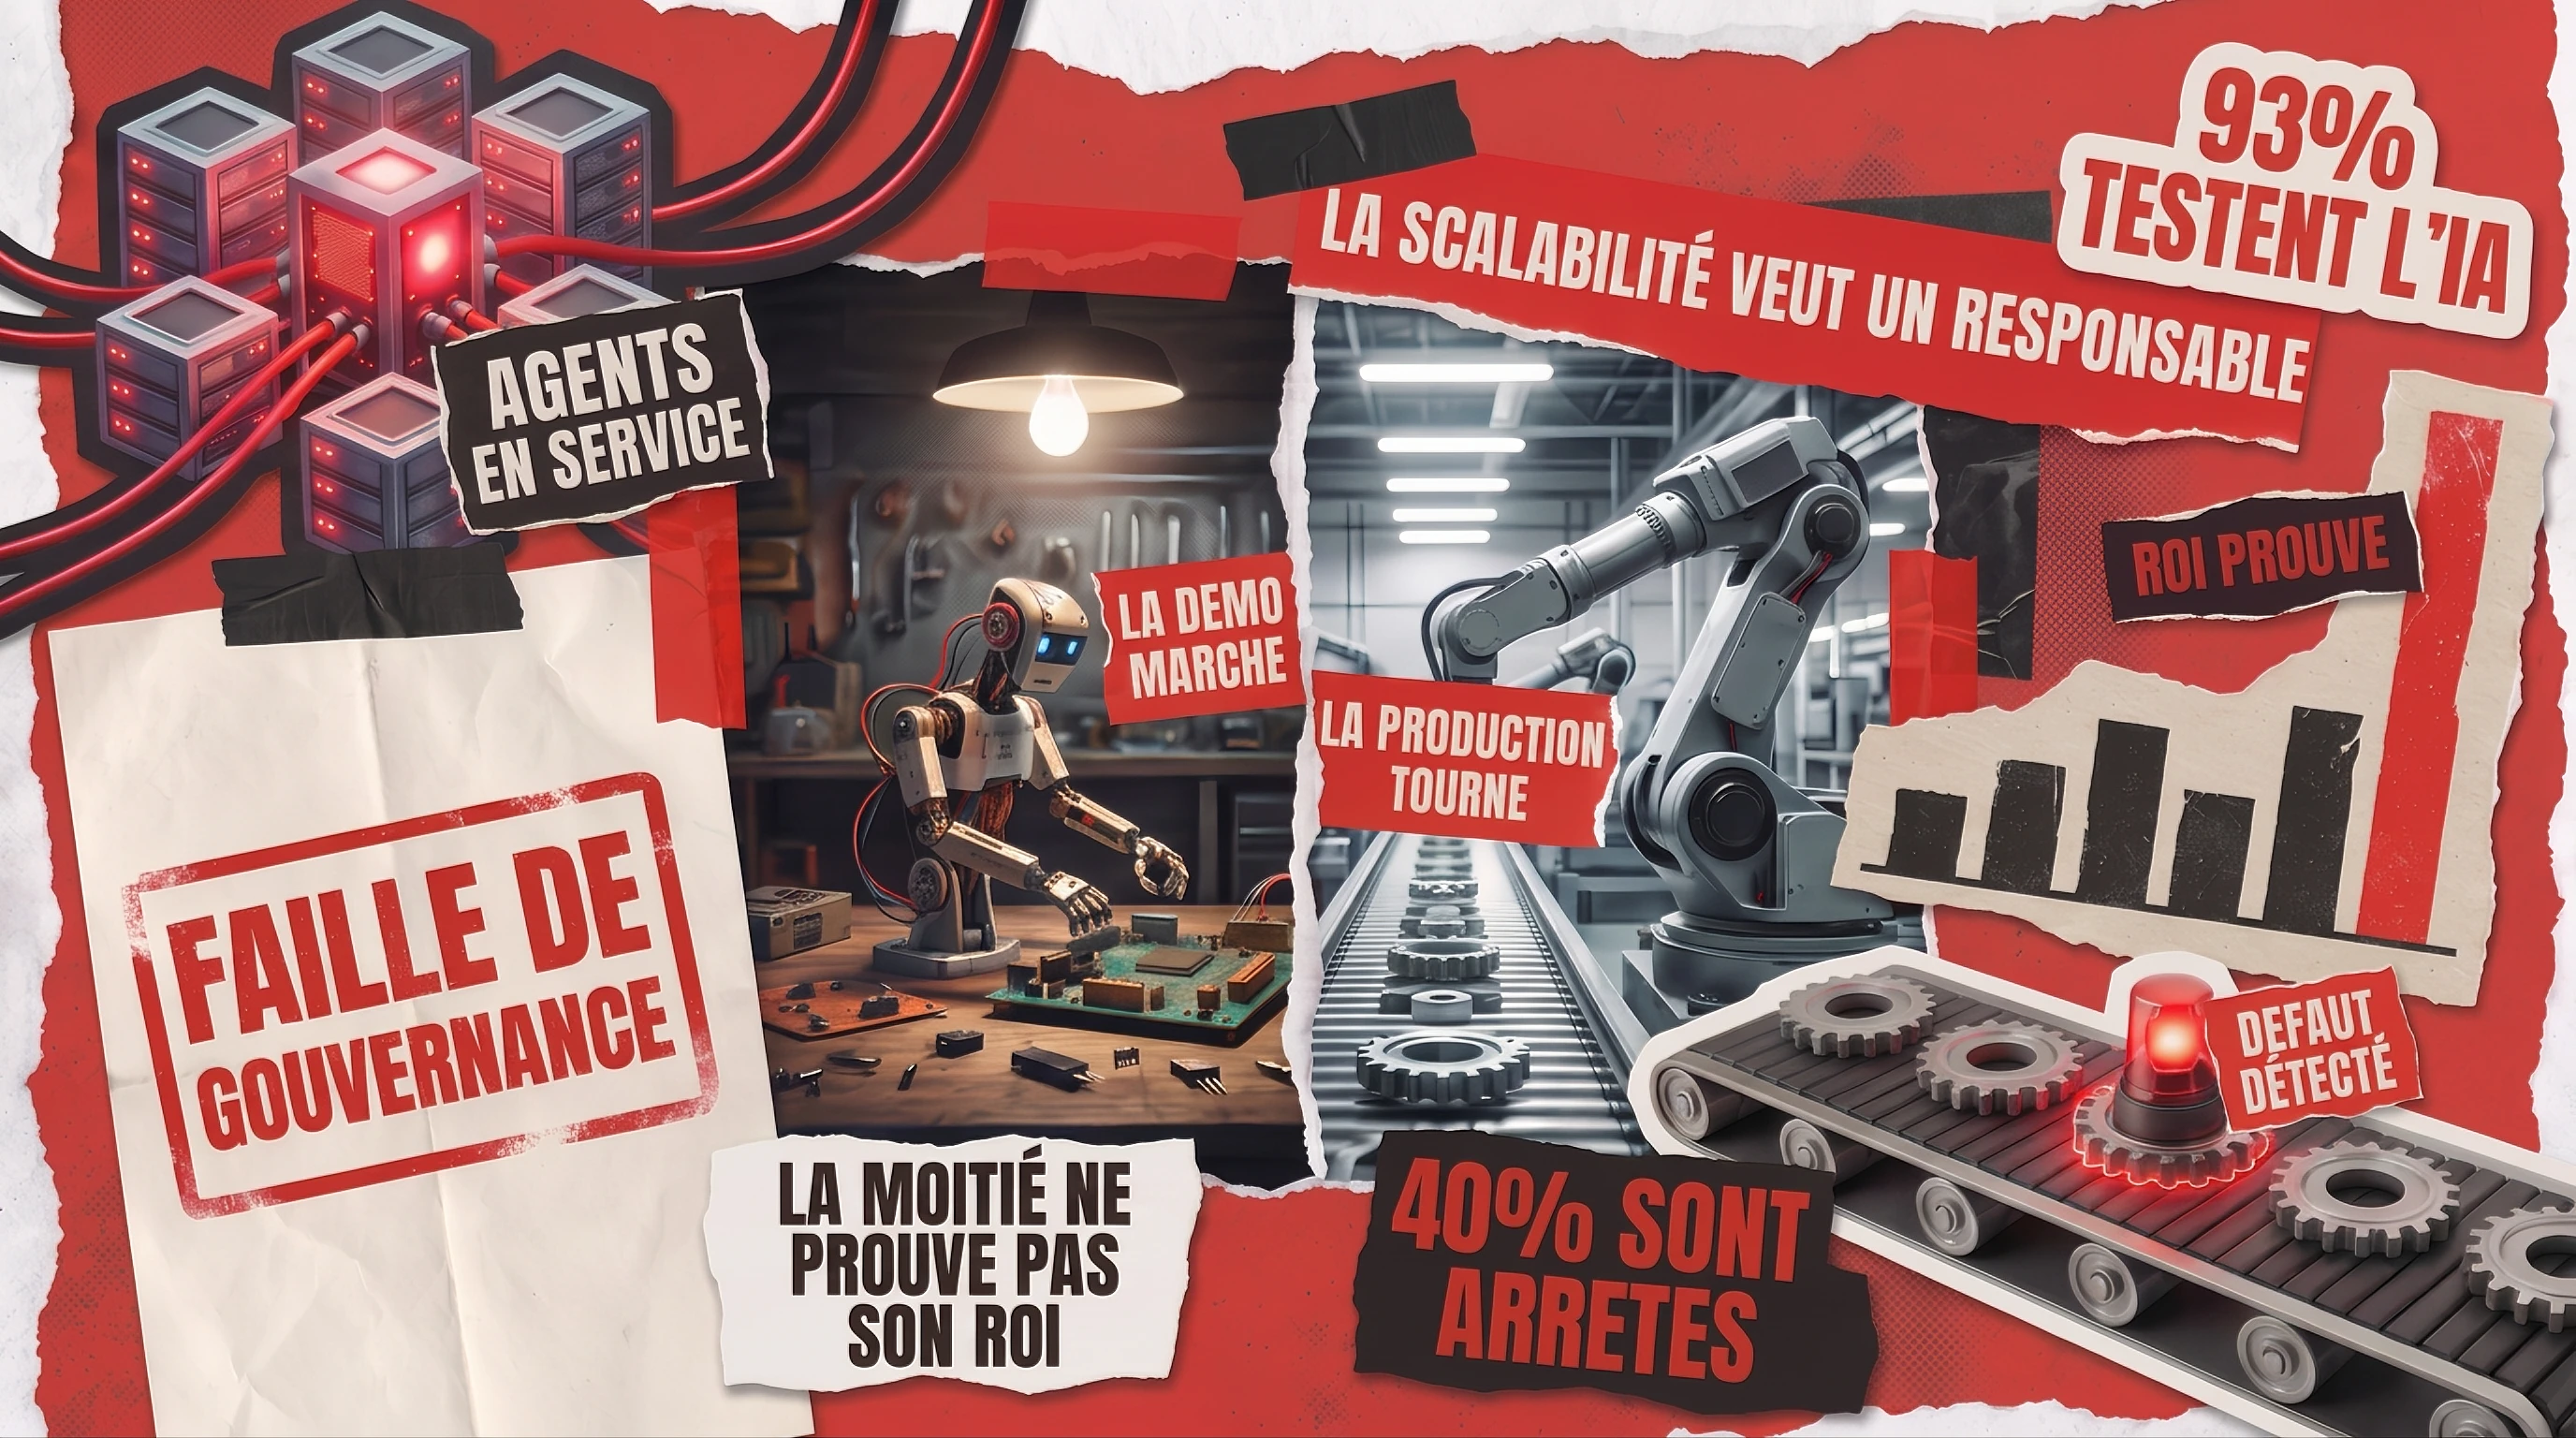
La plupart des cas d’usage de l’IA en entreprise s’enlisent pour des raisons étrangères à la qualité du modèle. L’Enterprise AI Strategy Pulse Survey 2026 de Plug and Play révèle que 74 % des plus grandes entreprises mondiales exploitent au moins une solution d’IA en production et que 93 % sont en phase pilote ou au-delà, alors que la moitié de ces entreprises en production ne parviennent pas à mesurer le ROI de façon constante.
Un déploiement d’IA en entreprise s’appuie sur des données de production gouvernées, sert plusieurs services ou flux de travail, dispose d’un propriétaire désigné responsable de ses résultats, et se répète de façon fiable à grande échelle. Un pilote montre qu’un modèle peut fonctionner une fois. Un déploiement d’entreprise montre que l’organisation autour de lui peut l’absorber.
Si vous évaluez un partenaire, la question utile est plus précise. Vous devez savoir quels cas d’usage de l’IA ont fait leurs preuves dans des entreprises de votre taille, ce que chacun coûte en préparation des données, et lesquels déclenchent une revue de conformité que personne n’avait prévue.
Du pilote à la production : ce qui rend l'IA prête pour l'entreprise
Quatre conditions transforment un prototype en un système qu’une entreprise peut exploiter. Les données d’entreprise doivent être gouvernées, avec un système d’enregistrement de référence, une politique de rétention, et quelqu’un capable de dire d’où provient un champ. Le flux de travail a besoin d’un propriétaire responsable lorsque le résultat est erroné, ainsi que d’un moyen pour une personne d’intervenir.
Troisième condition : la mesure par rapport à une référence établie avant le lancement, exactement ce que les répondants de Plug and Play ont omis de faire. Sans cela, le ROI est impossible à démontrer par construction, si bien que ce chiffre de 50 % décrit davantage un échec de mesure qu’un échec technologique.
Quatrième condition : la répétabilité, qui met en échec la plupart des projets internes. Un modèle ajusté par un analyste sur un export CSV est une étude ; un système suppose un réentraînement planifié, des entrées surveillées et un moyen de revenir en arrière. Les équipes qui réussissent à faire passer l’IA de la démo à la production traitent cette plomberie comme le livrable en soi. Si vos données sont réparties sur trois systèmes sans propriétaire, attendez-vous à ce que les six à huit premières semaines ressemblent à un travail d’intégration.

Cas d'usage de l'IA en entreprise par fonction métier
Classer par fonction est plus pertinent que classer par technologie, car le budget et la responsabilité relèvent des fonctions. Les cas d’usage métier de l’IA qui survivent à la production se concentrent là où trois conditions se rejoignent : un volume élevé de transactions, une réponse vérifiable par rapport à un enregistrement, et un travail déjà numérisé. Lorsqu’une condition manque, il faut d’abord repenser le processus.
Support client et collaborateurs
Le support est le point d’entrée le plus courant car le volume est élevé et la vérité terrain se trouve déjà dans un système de tickets. La version réaliste consiste à interroger votre propre documentation avec un seuil de confiance et une transmission à une personne. Les services d’assistance IT et RH internes devancent souvent le support client comme première cible, car une mauvaise réponse à un collaborateur coûte des excuses, alors qu’une mauvaise réponse à un client peut coûter un contrat. Le piège, c’est le périmètre : un bot censé répondre à tout sur quarante systèmes est un programme d’intégration déguisé en interface de chat.
Finance, RH et Revenue Operations
Les fonctions back-office produisent les gains les plus nets, car leurs documents sont structurés et leurs erreurs sont auditables. Voici les cas d’usage de l’IA en entreprise qui passent le plus souvent une revue financière :
- Extraction de factures et de documents. Lignes de détail extraites de PDF fournisseurs vers un ERP, champs à faible confiance orientés vers une file d’attente humaine. La précision est mesurable par champ, ce qui plaide en sa faveur.
- Présélection et mise en correspondance des candidats. Classement des candidats par rapport à des exigences structurées, le schéma derrière les outils de recrutement pilotés par le ML que Redwerk a développés. L’auditabilité est plus difficile que la précision, car un classement que vous ne pouvez pas expliquer est une exposition juridique.
- Prévision des revenus et scoring du churn. Modèles prédictifs appliqués au CRM et à l’historique de facturation, nécessitant deux ans de données cohérentes. Une entreprise ayant changé de CRM l’an dernier ne peut pas encore les prendre en charge.
- Revue de contrats. Extraction de clauses et signalement des écarts par rapport à un modèle standard, efficace lorsque vos contrats sont standardisés et faible lorsque chaque accord est sur mesure.
Supply chain et opérations IT
Les opérations sont le domaine où les modèles prédictifs rapportent plus que les modèles génératifs. La prévision de la demande, l’optimisation des stocks et la détection d’anomalies dans les journaux sont des problèmes statistiques avec des décennies d’antériorité, qui appellent une ingénierie ML et data science plutôt qu’un modèle de langage. Redwerk construit des moteurs de prévision de la demande sur cette base, où le plafond de précision vient des données plutôt que de l’algorithme.
Les opérations IT offrent le point de départ le plus simple de toutes les fonctions. La corrélation d’alertes et la prévision de capacité réduisent le bruit par rapport à une référence déjà présente dans votre pile de supervision, si bien que personne n’a besoin d’inventer une métrique pour la justifier.
Cas d'usage de l'IA agentique en entreprise
Un agent se distingue d’un chatbot par un aspect qui change tout le profil de risque : il agit dans d’autres systèmes. Il peut émettre un remboursement, déplacer un enregistrement ou appeler une API pour vous, si bien qu’une erreur s’inscrit dans vos systèmes au lieu de simplement mal informer quelqu’un. La gouvernance doit donc précéder la capacité.
Gartner a chiffré cela en mai 2026, en prédisant que d’ici 2027, 40 % des entreprises rétrograderont ou mettront hors service des agents d’IA autonomes suite à des lacunes de gouvernance découvertes seulement après des incidents en production. Le mode d’échec identifié est une gouvernance uniforme appliquée sans tenir compte du niveau d’autonomie de l’agent, ce qui soit étouffe les agents à faible risque sous les validations, soit sous-supervise ceux qui ont une réelle portée.
Les cas d’usage de l’IA agentique que les équipes d’entreprise mettent en production partagent une forme étroite : des actions autorisées bornées, un résultat réversible, un enregistrement vérifiable. Les agents de détection de fraude qui signalent et bloquent une transaction pour révision correspondent à ce schéma, tout comme les agents de mise en correspondance immobilière qui constituent la shortlist d’un courtier et les agents de recommandation retail ou voyage qui classent un inventaire dans lequel le client choisit encore. Le travail de Redwerk en développement d’agents d’IA couvre ces trois schémas, et dans chacun une personne garde la dernière signature sur tout ce qui est coûteux.
Les cas d’usage des agents d’IA en entreprise tournent mal à la frontière de l’écriture. Donnez à un agent l’autorité non supervisée d’émettre des paiements ou d’écrire aux clients, et vous avez besoin des mêmes contrôles que pour un jeune employé disposant d’accès en production : un accès délimité, un journal d’audit et un moyen testé de l’arrêter en cours de tâche. La plupart des équipes découvrent que le troisième manque justement pendant l’incident qui en aurait eu besoin.
IA générative et cas d'usage de LLM sur mesure
Les modèles génératifs produisent du texte, du code, des images et des brouillons structurés, et leur valeur se concentre là où un premier jet compétent fait gagner plus de temps qu’une réponse parfaite. Les cas d’usage les plus solides de l’IA générative en entreprise se situent donc en amont d’un relecteur humain plutôt qu’à sa place. Deux familles regroupent la plupart des cas d’usage de l’IA générative en entreprise qui atteignent la production, et leurs profils de coût diffèrent nettement.
Génération de contenu et de code
La génération de code offre ici l’histoire de mesure la plus claire, car la production d’ingénierie est déjà instrumentée via le débit de pull requests, le délai de revue et le taux de défauts échappés. Les assistants de type Copilot accélèrent de façon fiable le code répétitif, l’échafaudage de tests et les travaux de migration, mais n’apportent rien à l’architecture. Redwerk fournit du développement logiciel assisté par IA sur cette base, y compris des copilotes exécutés on-premise lorsque le code source ne peut pas sortir des locaux.
La génération de contenu suit la même logique, avec une histoire de mesure plus faible. Le volume augmente vite et le contrôle qualité devient le goulot d’étranglement, si bien que l’échange honnête consiste à troquer du temps de rédaction contre du temps de relecture.
Connaissances métier spécifiques et LLM on-premise
La seconde famille est la recherche sur des contenus propriétaires : contrats, documentation d’ingénierie, historique des sinistres, protocoles cliniques, une décennie de tickets de support. Un modèle généraliste n’en connaît rien, si bien que l’ingénierie réside dans la couche de recherche, la stratégie de découpage, le modèle de permissions et le jeu d’évaluation. C’est concrètement ce que recouvre le développement de LLM sur mesure, construit autour du domaine et des données propres à une entreprise.
La confidentialité détermine l’architecture. Une entreprise soumise au RGPD, à l’HIPAA, ou à un contrat interdisant le traitement par un tiers ne peut pas envoyer ce corpus vers une API publique, ce qui met sur la table un déploiement on-premise ou en cloud privé, avec ses coûts : capacité GPU, mises à niveau du modèle, un harnais d’évaluation à maintenir. L’arbitrage consiste à accepter un coût fixe plus élevé en échange d’une garantie de résidence des données que vous pouvez mettre par écrit.
Cas d'usage de l'IA en entreprise par secteur
Le secteur d’activité change le séquencement plus que la technologie. Le même modèle d’extraction de documents sert aussi bien un assureur qu’un industriel, et la différence tient à qui l’approuve, combien de temps cela prend, et quelles preuves sont exigées en premier. Le poids réglementaire prédit mieux le calendrier que le secteur lui-même.
Secteurs réglementés : services financiers et santé
Dans les services financiers, la détection de fraude et de blanchiment (AML), le scoring de crédit et de risque, et l’onboarding à forte intensité documentaire sont les applications établies, et toutes trois exigent un impératif d’explicabilité. Un modèle produisant des décisions que personne ne peut reconstituer échoue à une revue de supervision même lorsqu’il est précis, ce qui explique pourquoi des modèles interprétables l’emportent ici sur des modèles opaques plus puissants.
Le secteur de la santé ajoute une seconde contrainte : les données patients ne peuvent généralement pas quitter un environnement contrôlé. Le support à la documentation clinique, le traitement des autorisations préalables et le tri des images sont tous viables, chacun nécessitant un déploiement privé, une piste d’audit par inférence, et la validation d’un clinicien sur un jeu de test. Budgétez ce cycle d’approbation comme une ligne à part entière, car il dure souvent plus longtemps que le développement lui-même.
Opérations physiques : industrie et retail
Lorsque le résultat est physique, l’IA est généralement prédictive plutôt que générative. Le retour sur investissement est aussi plus facile à calculer, car les arrêts de production et les ruptures de stock ont déjà un prix :
- Maintenance prédictive. Données de vibration, de température et de cycle lues par rapport à l’historique des pannes. Elle nécessite une couverture de capteurs et quelques pannes réelles pour apprendre, ce qui empêche les usines équipées de matériel neuf de commencer ici.
- Inspection visuelle qualité. Détection de défauts sur une ligne, où la contrainte déterminante est un jeu de données étiquetées de défauts réels plutôt que la disponibilité du modèle.
- Prévision de la demande et planification de l’assortiment. L’équivalent côté retail, sensible aux promotions et dépendant d’un historique de point de vente propre.
- Recommandation et personnalisation. Classement de l’inventaire pour un acheteur, mesurable via la taille du panier et la conversion.
Le retail est le secteur où la transformation numérique et l’IA arrivent comme un seul et même programme. Un moteur de recommandation appliqué à un catalogue aux données produit incohérentes renvoie des résultats absurdes avec assurance, si bien que le nettoyage de données que personne ne veut financer est le vrai prérequis.
Build vs. buy : où le développement d'IA sur mesure trouve sa place
Achetez la commodité, construisez le différenciateur. Une transcription générale, un assistant de code grand public, ou une interface de chat standard coûtent moins cher sur étagère que tout ce que vous pourriez construire. Le développement sur mesure justifie son coût lorsque la valeur dépend de quelque chose que vous seul détenez : vos données, votre processus, votre position réglementaire.
C’est dans le séquencement que les budgets disparaissent, et les données sur le ROI montrent pourquoi. Le Global AI Pulse du T2 2026 de KPMG, portant sur 2 145 dirigeants de comité exécutif et responsables métier dans 20 pays, révèle que seulement 7 % des organisations font état d’un ROI établi sur l’IA, tandis que les dirigeants disposant d’une forte visibilité sur les coûts avaient cinq fois plus de chances d’y parvenir.
Acheter sur étagère
La capacité est générique et vos données n’apportent aucun avantage : transcription, traduction, assistant de code.
Licence par utilisateur ou par token, plus l’intégration dans un flux de travail existant.
Configurer une plateforme
Un éditeur sert votre secteur et votre processus reste proche de leur configuration par défaut, comme pour les services d’assistance et les modules CRM.
Configuration et conduite du changement, en hausse à mesure que votre processus s’écarte des hypothèses de l’éditeur.
Construire sur mesure
La valeur réside dans des données propriétaires, un déploiement réglementé, ou une intégration qu’aucun éditeur ne propose.
Préparation des données et ingénierie des pipelines, qui pèsent plus lourd que le travail sur le modèle, plus une évaluation continue.
L’argument du sur mesure est le plus solide dans deux cas. D’abord les données propriétaires : quand l’actif qui rend la réponse pertinente est votre propre historique de sinistres, votre archive de capteurs ou votre bibliothèque de contrats, alors un logiciel d’IA sur mesure construit autour de vos propres données est le seul moyen de capter cet avantage, car un modèle d’éditeur partagé ne peut pas le voir. Ensuite la conformité, où le déploiement privé et la piste d’audit sont des obligations contractuelles.
La question à poser à tout partenaire est ce qu’il fait pendant le premier mois. Redwerk a livré plus de 250 projets depuis 2005 avec plus de 90 ingénieurs seniors, et sur les projets d’IA, les premières semaines sont consacrées à la traçabilité des données, aux limites d’accès et à une référence d’évaluation avant même de choisir un modèle. Deux points comptent pour les équipes du mid-market : un projet d’IA à moitié construit peut être repris et terminé par des ingénieurs qui connaissent déjà la stack, et le travail ne nécessite pas de spécification complète en amont.
Le schéma commun à toutes les catégories ci-dessus est que le modèle est la partie la moins chère. Ce qui décide si un déploiement survit à sa première année, c’est si les données sous-jacentes sont gouvernées, si une personne désignée est responsable des résultats, si ceux-ci sont mesurés par rapport à une référence pré-lancement, et s’il peut être arrêté proprement.
Concrètement, choisissez une fonction à fort volume avec un enregistrement vérifiable, instrumentez-la avant de construire quoi que ce soit, et considérez le premier engagement comme la preuve que votre organisation peut absorber un système en production. Le second devient bien plus facile une fois cette plomberie en place. Si vous hésitez sur par où commencer, contactez-nous et nous passerons en revue le séquencement adapté à votre stack.
FAQ
Qu'est-ce qu'un cas d'usage de l'IA en entreprise ?
C’est un déploiement d’IA qui s’appuie sur des données de production gouvernées, sert plusieurs équipes ou flux de travail, dispose d’un propriétaire responsable de ses résultats, et se répète de façon fiable à grande échelle. La distinction par rapport à un pilote est organisationnelle plutôt que technique : un pilote montre qu’un modèle peut fonctionner une fois, tandis qu’un déploiement d’entreprise montre que le processus, les permissions et la supervision qui l’entourent peuvent le soutenir dans la durée.
Quelle est la différence entre l'IA générative et l'IA agentique ?
L’IA générative produit du contenu tel que du texte, du code ou des images, et une personne décide quoi en faire. L’IA agentique agit dans d’autres systèmes, en appelant des API, en mettant à jour des enregistrements ou en déclenchant des transactions, si bien que ses erreurs s’inscrivent dans vos systèmes au lieu de simplement s’afficher à l’écran. Cette différence de rayon d’impact explique pourquoi les agents ont besoin de limites de permissions, de journaux d’audit et d’un moyen testé de les arrêter en cours de tâche.
Quels secteurs utilisent le plus l'IA en entreprise ?
Les services financiers, la santé, l’industrie, le retail et la technologie mènent l’adoption, car chacun combine un volume élevé de transactions avec de longs historiques numériques pour apprendre. La répartition la plus utile se fait par poids réglementaire : les secteurs réglementés avancent plus lentement car les règles d’explicabilité ajoutent des cycles d’approbation, tandis que le retail et l’industrie avancent plus vite car le retour sur investissement se voit dans les ruptures de stock et les arrêts de production.
Découvrez comment nous avons transformé un produit legacy en plateforme de croissance pilotée par l'IA : le projet Evolv, plus de 20 mises en production avec une équipe de 9 personnes