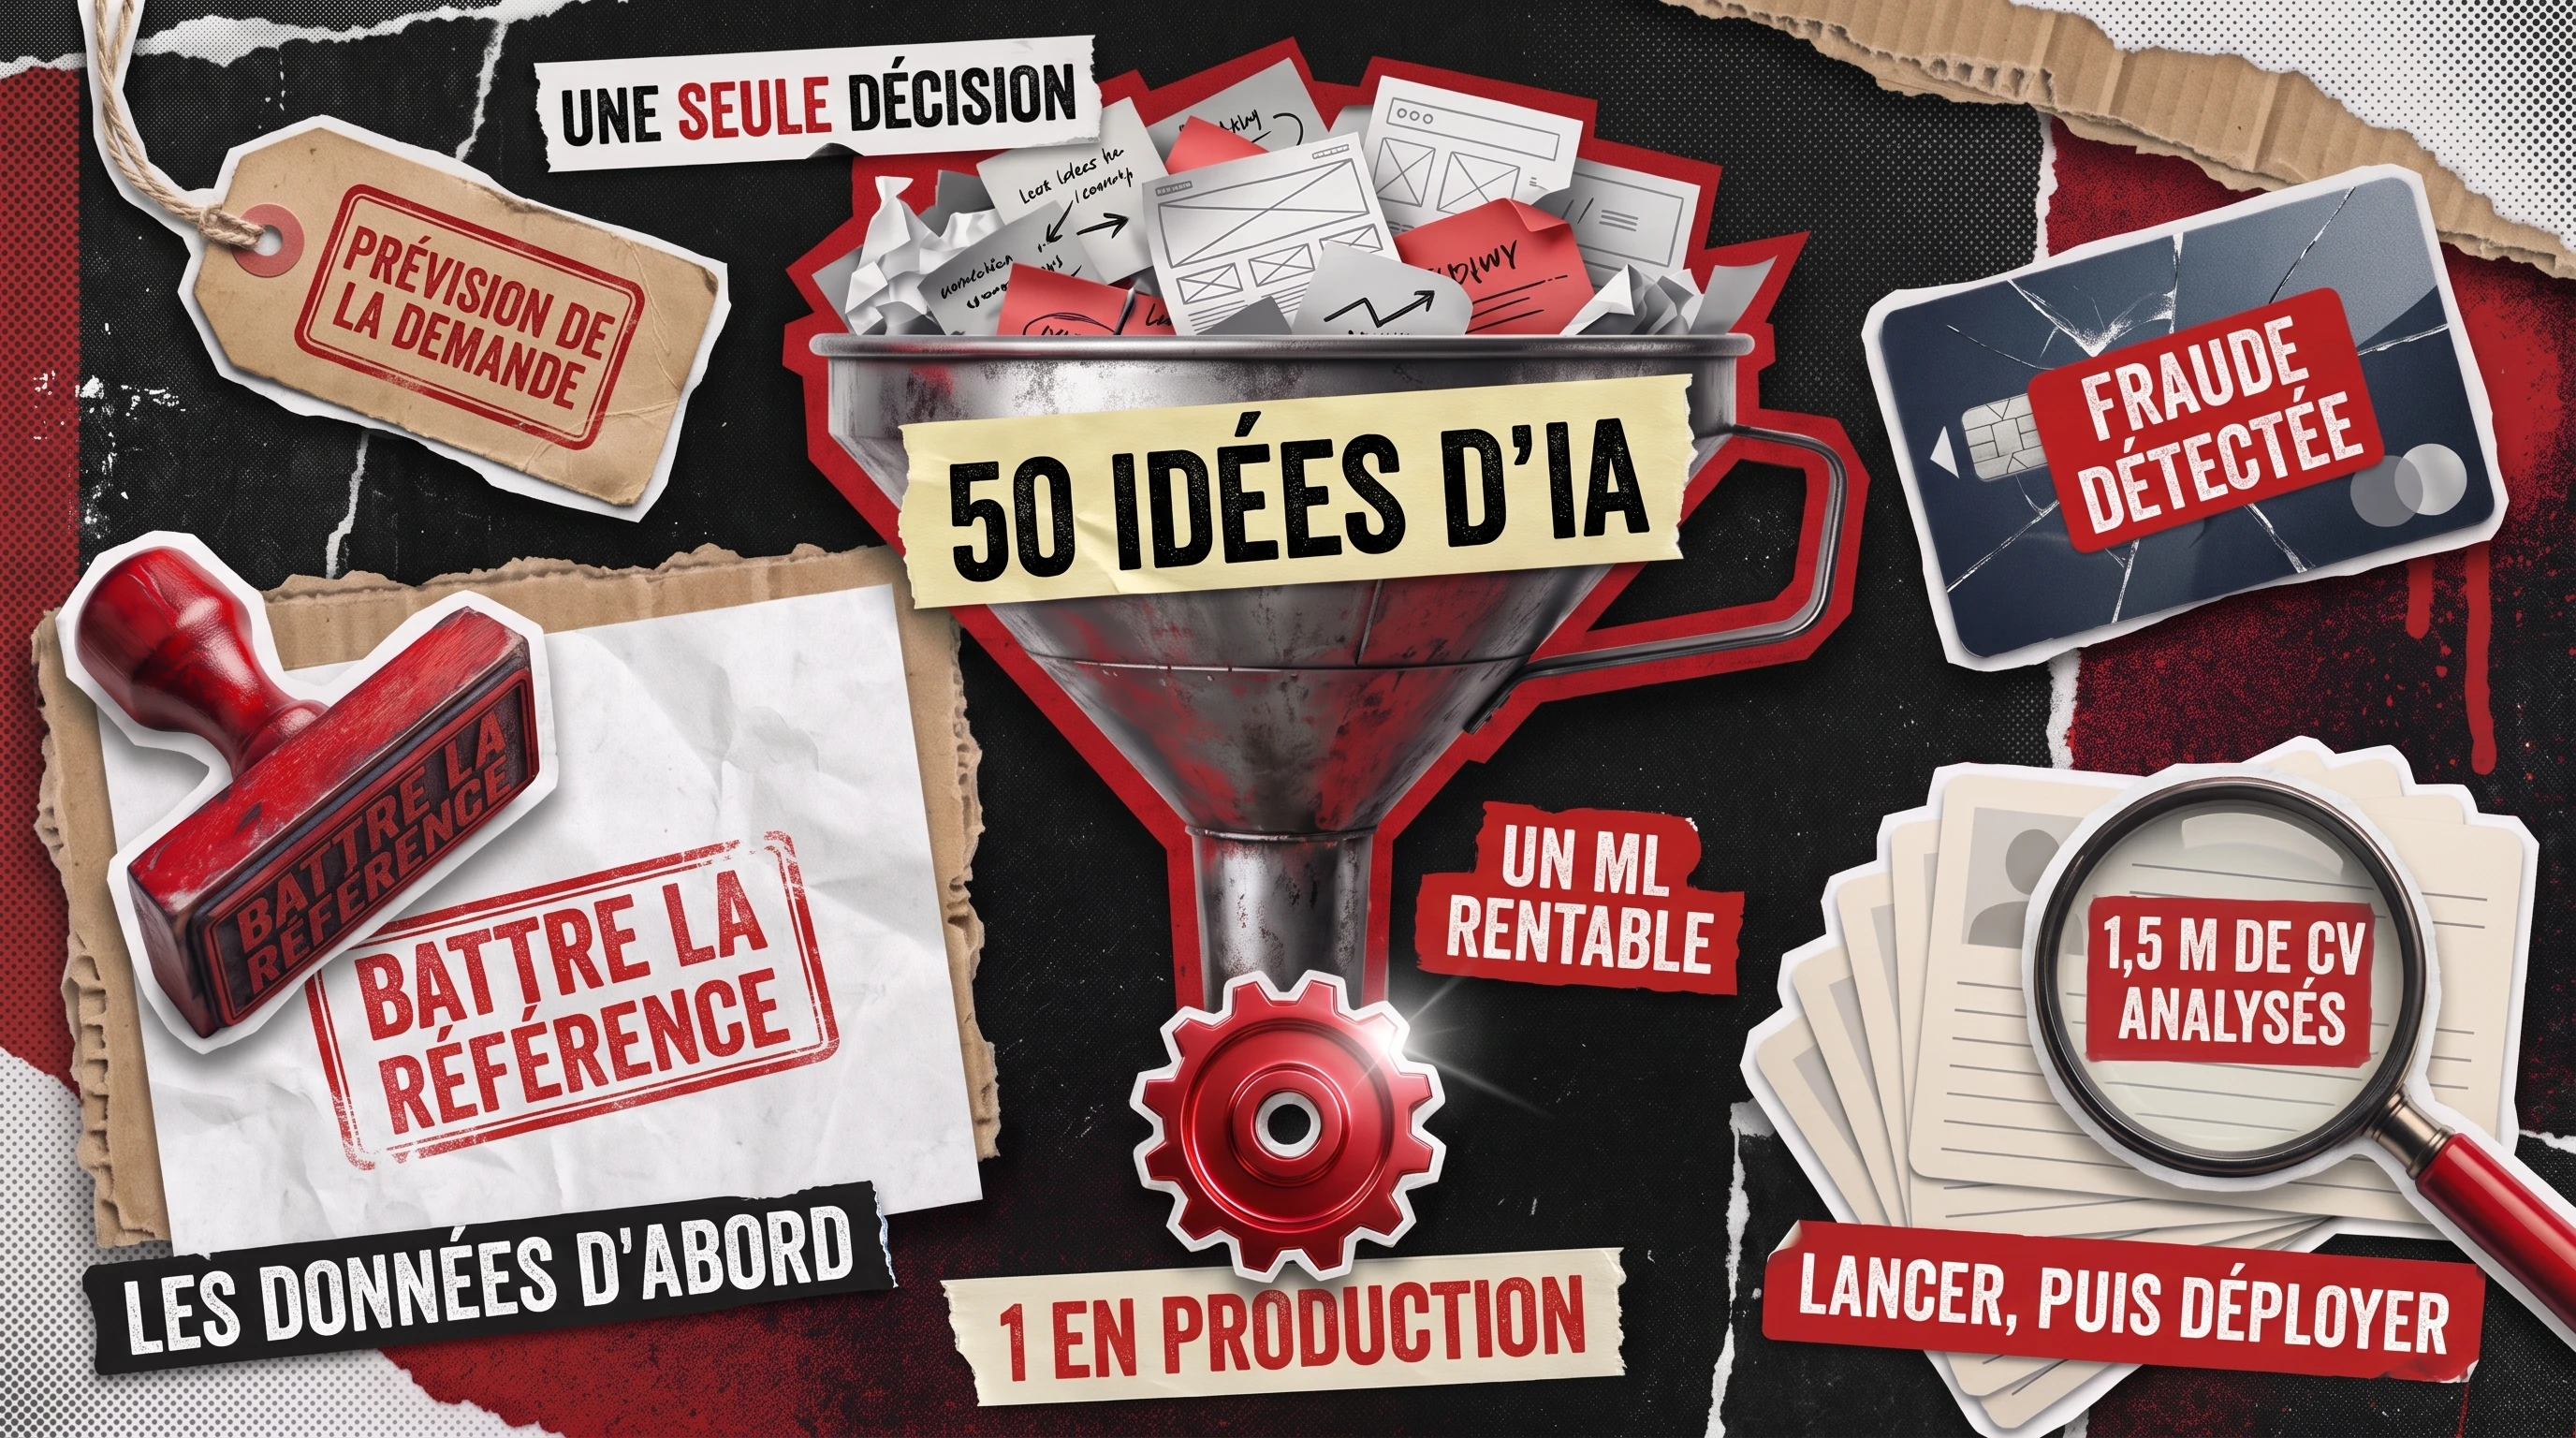
Les cas d’usage du machine learning qui méritent d’être financés en 2026 partagent trois caractéristiques : une décision que votre équipe prend encore et encore, des données historiques qui enregistrent l’issue de cette décision, et une référence que le modèle doit battre. La prévision de la demande, la prédiction de l’attrition, le scoring de fraude, l’extraction de documents et le matching de candidats remplissent ces trois conditions, ce qui explique pourquoi ils dominent les déploiements en production dans les entreprises de taille intermédiaire.
La plupart des panoramas listent cinquante idées et s’arrêtent là. Ce guide couvre ce qu’une entreprise de taille intermédiaire peut réalistement mettre en production cette année, classé par fonction et associé aux secteurs où chaque cas d’usage a fait ses preuves. Les exemples proviennent de nos propres projets, dont une plateforme de recrutement pour laquelle nos ingénieurs ont entraîné un modèle de matching de CV sur plus de 1,5 million de textes. Si vous hésitez entre un recrutement en interne et des services de développement en intelligence artificielle, la dernière section vous donne un filtre en cinq étapes pour choisir le premier projet.
Cas d'usage de l'analyse prédictive
L’analyse prédictive est le domaine où la plupart des entreprises obtiennent leur premier retour sur le machine learning, car les données d’entraînement se trouvent déjà dans leur ERP, leur CRM ou leur système de facturation. Des historiques dont l’issue est connue apprennent à un modèle à évaluer de nouveaux enregistrements avant que cette issue ne se produise. Le modèle remplace rarement une personne. Il réordonne une file d’attente, signale une exception ou restreint une liste, pour que l’équipe consacre son temps aux cas qui comptent.
Prévision de la demande dans le retail et l'e-commerce
La prévision de la demande estime combien d’unités de chaque SKU seront vendues par magasin, par canal et par semaine, à partir de l’historique des ventes, des prix, des promotions, de la saisonnalité et des ruptures de stock. Les modèles de gradient boosting comme LightGBM traitent bien ces données tabulaires et se réentraînent en quelques minutes.
La difficulté réside dans les données qui entourent les chiffres de vente. Une promotion non enregistrée ressemble à un pic aléatoire, et une rupture de stock ressemble à une baisse de la demande, si bien que les deux enseignent au modèle une mauvaise leçon. Les nouveaux produits nécessitent une approche de démarrage à froid (cold start) qui emprunte les tendances d’articles similaires.
Prédiction de l'attrition client pour les SaaS et les modèles par abonnement
Un modèle d’attrition attribue à chaque compte un score de risque de résiliation ou de passage à une offre inférieure dans les 30 à 90 prochains jours. Les signaux les plus déterminants sont comportementaux :
- Baisse des connexions ou des licences actives par rapport à la taille de l’abonnement
- Moindre utilisation des fonctionnalités liées au flux de travail principal du client
- Tickets de support répétés sur le même problème
- Échecs de paiement et litiges de facturation
- Départ du champion initial de l’entreprise cliente
Définissez ce que recouvre « attrition » avant le début de l’entraînement, car un non-renouvellement, un passage à une offre inférieure et un compte suspendu nécessitent des libellés différents. Une liste hebdomadaire transmise au customer success, avec les principales raisons par compte, transforme le score en appel de fidélisation.
Scoring de crédit et détection de fraude dans la fintech
La détection de fraude doit repérer une infime part de transactions frauduleuses dans les millisecondes qui séparent le passage d’une carte de son autorisation. La plupart des équipes font tourner le modèle en parallèle de leur moteur de règles existant et lui confient progressivement les décisions à mesure qu’il réduit à la fois les pertes liées à la fraude et les faux refus, puisque chaque faux refus est un vrai client bloqué au moment du paiement.
Le scoring de crédit ajoute une couche juridique. Aux États-Unis, les prêteurs doivent communiquer aux demandeurs les raisons précises d’un refus, ce qui pousse les équipes vers des modèles interprétables ou vers des outils d’explicabilité appliqués aux modèles complexes. Les cas limites sont envoyés dans une file de revue par un analyste crédit.
Maintenance prédictive : une note rapide pour les équipes industrielles
La maintenance prédictive anticipe les pannes d’équipement à partir des données de vibration, de température, de pression et de durée de fonctionnement. Elle nécessite des mois d’historique de capteurs ainsi qu’un journal des pannes réelles, et de nombreuses usines disposent des capteurs mais de peu de pannes étiquetées, car les bonnes équipes de maintenance réparent les machines avant qu’elles ne tombent en panne. Dans ce cas, commencez par une détection d’anomalies qui signale les relevés inhabituels à un technicien, et collectez les étiquettes de pannes au fil de l’eau.
Cas d'usage de la vision par ordinateur et du NLP
Les données non structurées (PDF, formulaires numérisés, photos de produits, e-mails et historiques de chat) sont le terrain où les cas d’usage du ML en entreprise se sont le plus développés ces deux dernières années. Les modèles de vision et de langage pré-entraînés permettent de lancer un projet avec un jeu de données étiquetées bien plus réduit qu’il y a quelques années. La contrepartie, c’est le coût : un grand modèle hébergé permet de prototyper rapidement mais coûte cher à grande échelle, tandis qu’un modèle plus petit et affiné (fine-tuned) coûte moins cher par requête.
Compréhension documentaire pour la finance, le juridique et l'assurance
Factures, contrats, formulaires de sinistre et documents d’onboarding suivent le même pipeline. L’OCR transforme le scan en texte, un modèle de mise en page repère les champs, un modèle d’extraction les lit, des règles métier valident les valeurs, et tout ce qui passe sous un seuil de confiance est confié à une personne. Ce seuil détermine combien de documents sont traités sans intervention.
Les modèles classiques ont encore toute leur place ici. Notre équipe a construit un pipeline de classification de texte dans Azure Machine Learning reposant sur une régression logistique appliquée à des features TF-IDF et n-grammes, entraîné sur 160 000 enregistrements et déployé en tant que service web. Ce modèle est rapide, peu coûteux et facile à expliquer, tandis que les grands modèles de langage conviennent à l’extraction complexe, comme les conditions de renouvellement enfouies dans des contrats.
Recherche visuelle et étiquetage produit dans le retail
La vision par ordinateur dans le retail est rentable là où le travail sur le catalogue est manuel et répétitif :
- Étiquetage des attributs. Un modèle lit les photos de produits et renseigne la couleur, le motif, la matière et la coupe, pour une mise en ligne plus rapide et des filtres cohérents.
- Recherche par similarité visuelle. Les acheteurs téléchargent une photo ou cliquent sur « articles similaires » et obtiennent des produits correspondants.
- Modération de contenu. Les contenus envoyés par les utilisateurs sont filtrés avant leur mise en ligne. Sur une plateforme de recrutement que nous avons livrée, le service de modération de contenu d’Azure analysait les textes, les images et les vidéos et transmettait les éléments signalés à un workflow d’approbation.
Des bibliothèques comme OpenCV gèrent le prétraitement, et la reconnaissance s’appuie sur un modèle pré-entraîné affiné sur le catalogue du retailer. Cet affinage est essentiel, car les photos studio, les images fournisseurs et les photos des clients sont très différentes aux yeux d’un modèle.
Chatbots et assistants virtuels avec logique d'escalade
Le Stanford AI Index 2026 résume des études montrant des gains de productivité de 14 % à 15 % dans le support client. Ces gains proviennent d’assistants qui répondent aux questions courantes et transmettent tout le reste à une personne, avec l’ensemble du contexte.
Les déclencheurs d’escalade déterminent si les clients adorent ou détestent l’assistant. Les bons déclencheurs incluent une faible confiance du modèle, un sentiment négatif, la même question posée deux fois, les comptes à forte valeur et les sujets réglementés comme les litiges de facturation. Lors du transfert, l’agent voit la transcription et les données du compte.
Recrutement et matching de talents à grande échelle
Le recrutement est le domaine où notre équipe a l’expérience ML la plus approfondie. Pour un SaaS de recrutement construit sur .NET et Azure, nous avons utilisé Azure ML Studio pour entraîner un réseau de neurones sur plus de 1,5 million de textes de CV et de descriptions de poste. Le modèle suggère les mots-clés les plus pertinents pour chaque profil et chaque offre, et alimente la recherche de la plateforme. La plateforme, Recruit Media, a ensuite été rachetée par HireQuest.
Les modèles de recrutement impliquent une responsabilité supplémentaire. L’AI Act européen classe l’IA utilisée pour le recrutement et l’évaluation des candidats comme à haut risque, avec des exigences de documentation, de supervision humaine et de tests de biais. Consignez donc les features qui ont déterminé chaque correspondance et gardez un recruteur sur chaque liste restreinte.
Cas d'usage du machine learning par secteur
L’adoption est inégale selon les secteurs, et cet écart montre où les méthodes sont les plus matures. En mai 2026, le US Census Bureau a constaté que 39,7 % des entreprises du secteur de l’information et 33,9 % de celles de la finance et de l’assurance utilisaient l’IA, contre environ 14 % dans le commerce de détail. Étudier les cas d’usage du machine learning par secteur vous permet d’emprunter un modèle éprouvé à un secteur voisin, à la manière dont le lead scoring est passé de la vente SaaS aux CRM immobiliers dotés d’IA. Les quatre secteurs ci-dessous sont ceux sur lesquels se concentrent nos projets.
Santé
Dans la santé, le ML est d’abord rentable dans les opérations. La prédiction des rendez-vous non honorés permet aux cliniques de surréserver les bons créneaux, le tri des orientations classe les documents entrants par urgence, et la synthèse automatique transforme les notes cliniques en champs de facturation structurés. L’automatisation des workflows dans la santé montre où ces processus échouent aujourd’hui.
Les cas d’usage cliniques impliquent des obligations plus lourdes. Un modèle d’aide au diagnostic peut être considéré comme un dispositif médical, et tout projet touchant aux données des patients nécessite un hébergement conforme à HIPAA et des jeux d’entraînement anonymisés. Anticiper ces deux aspects dès le premier sprint de développement de logiciels informatiques pour la santé évite une refonte coûteuse avant le lancement.
Retail et e-commerce
Le retail offre le plus large éventail de cas d’usage éprouvés :
- Recommandations et classement des résultats de recherche, entraînés sur les données de clics, de paniers et d’achats
- Optimisation des prix en fonction de la demande, des niveaux de stock et des mouvements des concurrents
- Prédiction des retours, qui signale les commandes susceptibles d’être renvoyées
- Allocation des stocks entre entrepôts en fonction des prévisions régionales
La faible adoption dans le retail reflète l’effort nécessaire pour connecter les modèles aux systèmes e-commerce, de caisse (POS) et d’entrepôt existants. Cette intégration prend généralement plus de temps que la modélisation.
RH et recrutement
Au sein du service RH, le ML aide à prendre des décisions sur la fidélisation, les compétences et les effectifs. Les modèles d’attrition signalent les équipes dont les signaux d’engagement diminuent, l’inférence de compétences construit des profils consultables à partir de l’historique des projets, et la planification des effectifs anticipe les besoins de recrutement. Les données des employés sont sensibles : agrégez donc le risque au niveau de l’équipe avant d’exposer des scores individuels, et expliquez aux employés ce qui est mesuré et pourquoi.
Industrie manufacturière
L’inspection visuelle de la qualité est le cas d’usage phare. Des caméras détectent les défauts de surface, les désalignements et les composants manquants à la cadence de la ligne, en apprenant à partir d’images de pièces conformes et rejetées, tandis que l’optimisation du rendement et de l’énergie s’appuie sur des données que les historians de l’usine stockent déjà.
La plupart des projets de ML industriels bloquent au moment de l’intégration avec les automates (PLC), le MES et l’ERP. Traiter le modèle comme un composant du développement de logiciels industriels, aux côtés des pipelines de données, des tableaux de bord opérateurs et des alertes, donne au pilote une trajectoire vers le reste de l’usine.
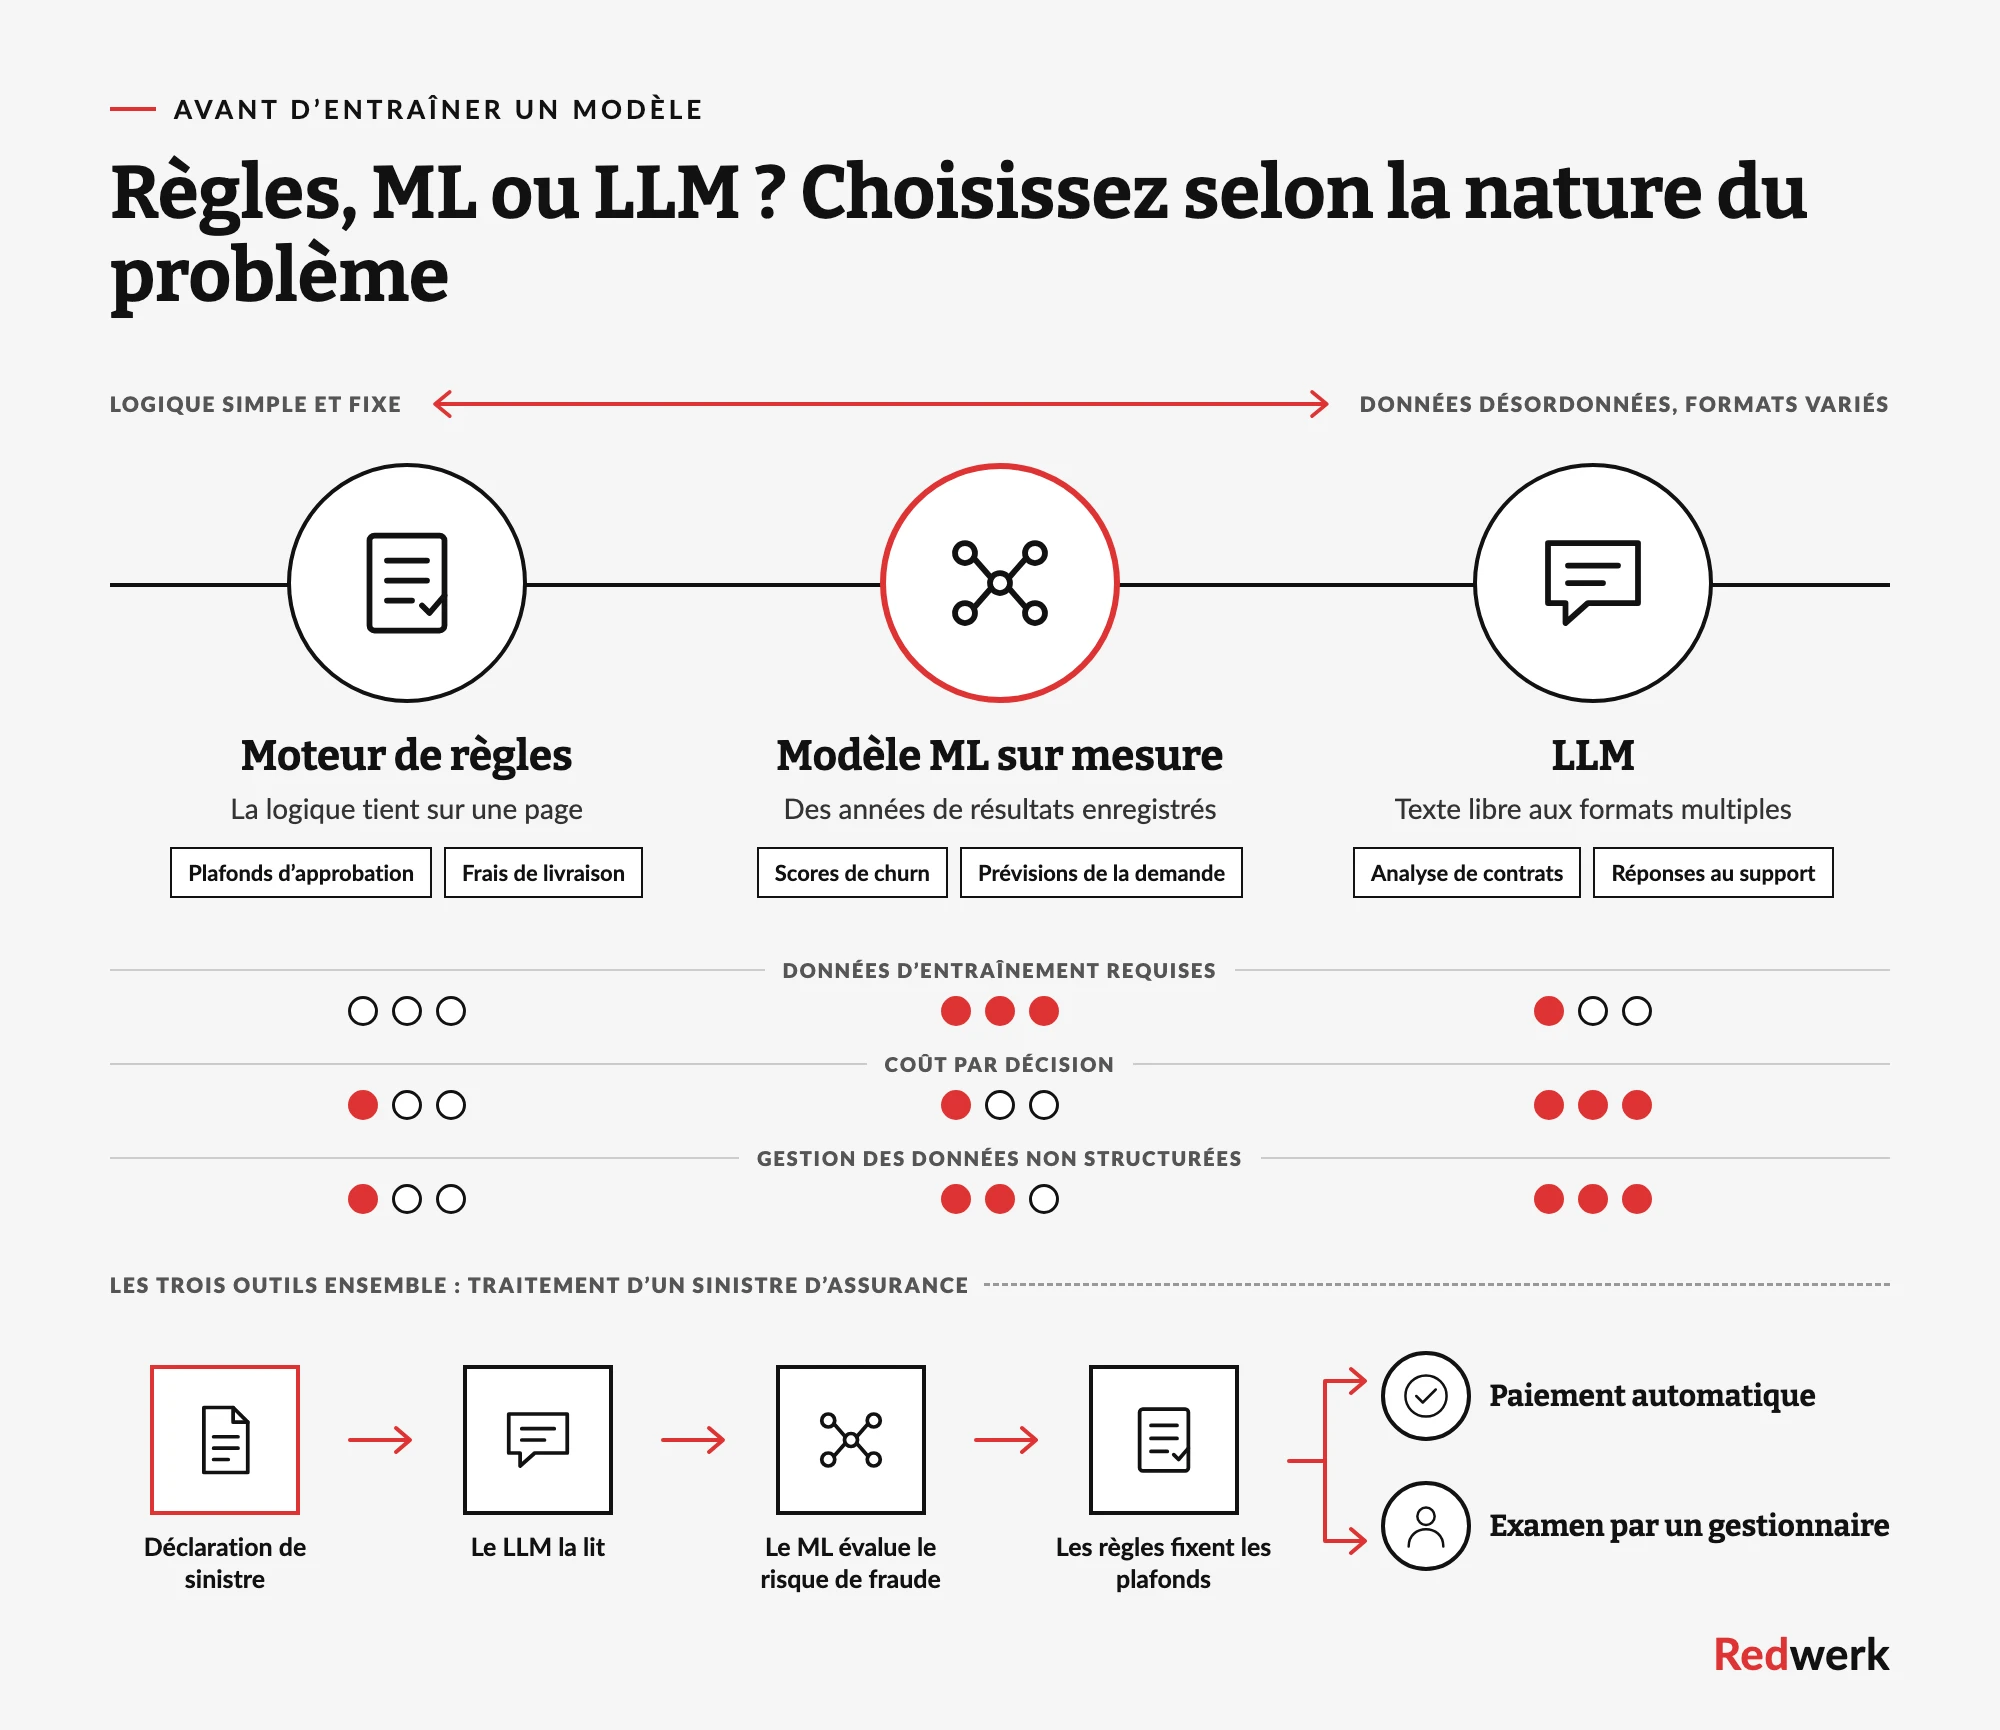
Comment choisir votre premier cas d'usage du machine learning
Le choix du premier projet compte davantage que le choix de l’algorithme. Selon le rapport 2026 d’Eurostat, seules 5,1 % des entreprises de l’UE utilisaient le machine learning pour l’analyse de données en 2025, et 70,3 % des entreprises qui avaient envisagé l’IA puis y avaient renoncé citaient le manque d’expertise pertinente comme principale raison. Les entreprises qui mettent en production des applications métier du machine learning commencent petit, mesurent leurs résultats par rapport à une référence claire et se développent à partir d’un système qui fonctionne. Ces cinq étapes constituent le filtre que nous appliquons avec nos clients avant l’entraînement de tout modèle.
Partir d'une décision, pas d'un jeu de données
Notez la décision que le modèle va modifier, qui la prend aujourd’hui et à quelle fréquence. « Quels comptes le customer success doit-il appeler cette semaine » est une décision, tandis que « nous avons cinq ans de données CRM, que peut en faire le ML » aboutit généralement à un tableau de bord que personne n’ouvre. Une décision prise des centaines de fois par mois est une candidate sérieuse, car les petits gains s’additionnent rapidement.
Vérifier que les données existent sous leur forme de production
Le modèle a besoin des mêmes champs, avec la même qualité, au moment de la prédiction. Vérifiez quatre points avant de vous engager :
- Le résultat que vous voulez prédire est enregistré, avec une date, pour les cas passés.
- Les champs d’entrée sont disponibles au moment de la prédiction, sans fuite d’informations futures.
- Les données des différents systèmes se joignent sur une clé fiable.
- Chaque source a un responsable qui signalera les changements de format.
Définir la référence à battre
Chaque projet de ML a besoin d’un point de comparaison, généralement la règle ou le processus manuel déjà en place. Si le modèle ne le bat pas avec une marge qui justifie son coût de fonctionnement, l’option la plus simple l’emporte.
Prévision de la demande
Même semaine l’année précédente, ou une moyenne mobile
Erreur de prévision (WAPE), ruptures de stock
Prédiction de l’attrition
Une règle « aucune connexion depuis 30 jours »
Revenus conservés sur les comptes signalés
Détection de fraude
Le moteur de règles actuel
Pertes liées à la fraude, taux de faux refus
Extraction de documents
Saisie manuelle des données
Documents par heure, taux d’erreur par champ
Assistant de support
File d’attente 100 % humaine
Résolution sans escalade, CSAT
Matching de candidats
Recherche par mots-clés du recruteur
Taux de passage de la liste restreinte à l’entretien
Limiter le périmètre à une équipe et un indicateur
Un premier projet porté par une seule équipe, mesuré par un seul indicateur et livré en un trimestre a de réelles chances d’atteindre la production. Les programmes d’IA à l’échelle de l’entreprise ont tendance à disperser le budget sur trop de pilotes, dont aucun ne bénéficie du travail d’intégration nécessaire. Si votre équipe manque d’ingénieurs ML, le développement de logiciels sur mesure en IA apporte ces compétences sans long cycle de recrutement, et un partenaire habitué aux exigences incomplètes définit le périmètre avec vous.
Prévoir le circuit de supervision humaine
Décidez tôt de ce qui se passe lorsque le modèle hésite ou se trompe. Les prédictions à faible confiance sont envoyées dans une file de revue, les relecteurs corrigent le résultat en un clic, et ces corrections alimentent le prochain entraînement. La supervision détecte ensuite la lente dérive de précision qui survient à mesure que les prix, les comportements et les formats évoluent.
De la liste restreinte à la production : les paris ML qui valent la peine
Les projets rentables sont ciblés, bien mesurés et intégrés aux logiciels que votre équipe utilise déjà. Choisissez une décision répétée, confirmez les données, fixez la référence et planifiez le circuit de revue avant que quiconque n’écrive de code d’entraînement. Cette séquence transforme une liste d’idées en un système qui justifie son budget et finance le deuxième projet.
Redwerk développe des logiciels depuis 2005, avec plus de 250 projets livrés et plus de 90 ingénieurs seniors maîtrisant Python, .NET, Azure et les principaux frameworks de ML. Nous accompagnons les cas d’usage de la phase de discovery jusqu’à la production, et nous reprenons les projets de ML bloqués après le pilote. Pour discuter de votre liste de projets, contactez-nous.
FAQ
Quels sont les cas d'usage du machine learning les plus courants en entreprise ?
Les plus courants sont la prévision de la demande, la prédiction de l’attrition, la détection de fraude, le scoring de crédit, l’extraction de documents, les recommandations de produits, les chatbots de support et le matching de candidats. Chacun associe une décision répétée à des résultats historiques et à un indicateur clair.
Quels secteurs tirent le plus de valeur du machine learning ?
La finance et l’assurance, l’information et le logiciel, le retail, la santé et l’industrie manufacturière obtiennent les meilleurs résultats. La finance est en tête sur les décisions de fraude et de crédit, le retail sur la prévision et la personnalisation, la santé sur la planification et le tri des documents, et l’industrie sur l’inspection visuelle.
Quel est le ROI du machine learning pour une entreprise de taille intermédiaire ?
Le ROI dépend de la fréquence à laquelle la décision est prise et de la valeur de chaque amélioration. Un modèle d’attrition qui retient quelques grands comptes chaque trimestre, ou un pipeline documentaire qui supprime chaque jour des heures de saisie manuelle, démontre son retour dans des indicateurs que l’entreprise suit déjà.
Comment une entreprise choisit-elle son premier projet de machine learning ?
Partez d’une décision métier fréquente, vérifiez que les données existent sous la forme que le modèle verra en production, et définissez la règle ou le processus manuel qu’il doit battre. Limitez le périmètre à une équipe et un indicateur, et prévoyez une revue humaine pour les prédictions incertaines.
Quelle est la différence entre les cas d'usage de l'IA et ceux du machine learning ?
L’IA est le domaine au sens large, qui inclut les moteurs de règles et les grands modèles de langage. Le machine learning est le sous-ensemble qui apprend des schémas à partir de données historiques pour faire des prédictions. La prévision et le scoring sont des cas d’usage du ML, tandis qu’un chatbot reposant sur un LLM hébergé est un cas d’usage de l’IA qui peut ne nécessiter aucun entraînement sur mesure.
Découvrez comment Redwerk a repris le développement principal d'une plateforme d'optimisation AI et l'a menée jusqu'à un lancement de produit réussi