Les web crawlers sont des programmes destinés au téléchargement et au traitement en masse de contenu Internet. Ils sont aussi souvent appelés « robots d’indexation », « spiders » ou simplement « bots ». Dans leur essence, un crawler effectue les mêmes actions qu’un navigateur web ordinaire : il envoie des requêtes HTTP aux serveurs et récupère le contenu de leurs réponses. Mais ce qui se passe ensuite est une autre histoire : alors qu’un navigateur traitera et affichera ce contenu pour que les utilisateurs puissent interagir avec, un crawler l’analysera et en extraira les données répondant à certains critères. Cela inclut la récupération des liens vers d’autres pages et leur parcours également. Récupérer une page, analyser la page, traiter les données, trouver des liens vers d’autres pages, répéter le processus : voilà, en résumé, ce qu’est un crawler basique.
Qu’est-ce qu’un Web Crawler ?
Les web crawlers sont des programmes destinés au téléchargement et au traitement en masse de contenu Internet. Ils sont aussi souvent appelés « robots d’indexation », « spiders » ou simplement « bots ». Dans leur essence, un crawler effectue les mêmes actions qu’un navigateur web ordinaire : il envoie des requêtes HTTP aux serveurs et récupère le contenu de leurs réponses. Mais ce qui se passe ensuite est une autre histoire : alors qu’un navigateur traitera et affichera ce contenu pour que les utilisateurs puissent interagir avec, un crawler l’analysera et en extraira les données répondant à certains critères. Cela inclut la récupération des liens vers d’autres pages et leur parcours également. Récupérer une page, analyser la page, traiter les données, trouver des liens vers d’autres pages, répéter le processus : voilà, en résumé, ce qu’est un crawler basique.
Cependant, les crawlers du monde réel font bien plus que cela. Ils sont utilisés dans de nombreux contextes pour des objectifs variés. À titre d’exemple, les crawlers constituent les éléments centraux des moteurs de recherche tels que Google, Yahoo, Bing et d’autres. Ces armées de crawlers recherchent, récupèrent, analysent et indexent constamment le contenu du web. Grâce à leur labeur incessant, vous pouvez trouver du contenu correspondant à vos intérêts en tapant simplement votre requête dans une petite boîte de recherche.
L’archivage de sites web est une autre tâche où les crawlers sont très présents. Des crawlers avancés peuvent créer des copies complètes du contenu d’un site web régulièrement et les sauvegarder dans un dépôt où elles pourront être récupérées, consultées et comparées, formant ainsi une chronologie des changements au fil des jours, des mois, voire des années. Le contenu stocké de cette manière est signé numériquement, il peut donc même servir de preuve devant un tribunal.
Une autre utilisation populaire des crawlers est l’exploration de données, consistant à extraire des informations du contenu web et à les convertir dans un format compréhensible pour une utilisation ultérieure. Le bot Google AdSense en est un bon exemple, qui recherche les pages présentant des publicités AdSense et vérifie leur conformité aux règles.
Les web crawlers sont également souvent utilisés à des fins de surveillance. Les crawlers peuvent vérifier automatiquement si les sites web et les applications web fonctionnent correctement, contribuant ainsi à minimiser les temps d’arrêt et à corriger rapidement les erreurs.
Enfin, les web crawlers sont également utilisés pour le scraping. La plupart des portails d’entreprise ne fournissent aucun moyen simple d’exporter le contenu qu’ils proposent dans un format utile, et ceux qui le font ont tendance à proposer des interfaces complexes et des API lentes. Ces obstacles ne diminuent cependant pas la demande pour ces données, et les web crawlers sont parfaitement adaptés pour les extraire. Des crawlers spécialisés appelés « scrapers » sont conçus pour contourner les mesures anti-crawl que ces portails mettent en œuvre en imitant le comportement de navigation ordinaire, les trompant en leur faisant croire qu’un humain navigue sur le site plutôt qu’un bot.
Il ressort clairement de ces exemples que les crawlers sont constamment occupés à explorer Internet, mais nous pensons qu’il est toujours important d’illustrer l’ampleur du travail qu’ils accomplissent avec quelques chiffres :
- Un crawler appelé IRLbot a fonctionné sur un supercalculateur pendant deux mois. Il a collecté plus de 6,4 milliards de pages pendant cette période, à un rythme moyen d’environ 1 000 pages par seconde, et extrait plus de 30 milliards d’URL.
- Depuis 1995, les crawlers de Google et Yahoo ont indexé plus de 1 trillion de pages combinées.
Défis de l’exploration Web
Les crawlers sont très demandés et peuvent représenter un investissement rentable. Mais il y a aussi un certain nombre de mises en garde à garder à l’esprit concernant leur fonctionnement et leur maintenance :
Défis techniques de haut niveau
- Les crawlers à l’échelle industrielle sont des systèmes distribués à forte charge avec d’énormes besoins en stockage et en bande passante. Vous aurez besoin d’une flotte de serveurs haut de gamme pour en faire fonctionner un, ainsi que d’une équipe qualifiée pour le mettre en œuvre et le maintenir. Plus votre crawler est complexe, plus il vous en coûtera en termes d’infrastructure et de support.
- Le web crawling est un domaine concurrentiel – non seulement entre les crawlers et les mesures anti-crawl, mais aussi entre différents crawlers dans le même domaine d’activité. Un crawler naïf gaspillera de précieux cycles d’horloge et de bande passante que d’autres crawlers plus intelligents dépenseront pour traiter du contenu plus pertinent. Sans optimisation adéquate, vous pourriez aussi bien ne pas vous embêter à faire fonctionner un crawler du tout.
- En parlant de crawling naïf, une approche indiscriminée de collecte de contenu peut avoir de graves répercussions si votre crawler récupère du matériel protégé par copyright. Si vous ne prenez pas de mesures pour garantir que cela ne se produise pas, vous pourriez faire face à des poursuites judiciaires si votre crawler viole le droit d’auteur de quelqu’un.
Compte tenu de ces facteurs, il est clair qu’un crawler basique ne suffira pas pour une application du monde réel. Le développement d’un crawler efficace demande des efforts et de la réflexion, et cela commence par la prise en compte des défis suivants :
Défis d’implémentation
Échelle de la tâche. Internet est un endroit immense, et il grandit chaque seconde. Afin de suivre les données les plus récentes (ou même relativement récentes), votre crawler doit être rapide et efficace. Avec toutes les différentes capacités qu’un crawler efficace doit posséder, cela peut être délicat !
Traitement du contenu. Idéalement, votre crawler traitera chaque page dont il a besoin et ignorera chaque page dont il n’a pas besoin. Cela semble assez simple comme exigence, n’est-ce pas ? Malheureusement, il est très facile de se retrouver avec un crawler qui ingère d’énormes quantités de contenu non pertinent ou ignore des montagnes de données précieuses. L’une des différences cruciales entre un crawler intelligent et rapide et un crawler lent et inefficace réside dans la manière dont il choisit les données à collecter.
Respect des ressources que vous parcourez. Appliquer toute la puissance de votre crawler à chaque site web que vous rencontrez est une bonne façon de lancer par inadvertance un DDoS sur une victime méritante – et potentiellement de vous exposer à une poursuite judiciaire. Ne soyez pas une menace pour Internet : vous devez vous assurer que votre crawler est capable de se limiter en fonction du débit maximal de tout serveur auquel il tente d’accéder.
Problèmes de contenu dynamique. Nous avons déjà mentionné que les navigateurs et les crawlers font des choses très différentes avec le contenu qu’ils récupèrent des serveurs : les navigateurs traitent et affichent, tandis que les crawlers analysent et extraient. Cela peut être un obstacle lorsqu’un site web génère du contenu dynamiquement, par exemple en utilisant JavaScript. Imaginez une pièce de théâtre où les acteurs lisent les indications scéniques au lieu de les exécuter : c’est le comportement typique d’un crawler face aux scripts. Il est toujours possible pour un crawler de capturer du contenu et des liens générés de cette manière, mais attention, cela a un coût en termes de performances.
Problèmes de contenu multimédia. Les sites qui utilisent Flash, Silverlight et HTML5 présentent leur propre problème unique : il n’y a tout simplement aucun moyen pour un crawler d’analyser et d’extraire des données d’un plugin ou d’un objet canvas. Ce que vous pouvez faire, c’est capturer le contenu indirectement : par exemple, en suivant les requêtes effectuées depuis un conteneur Flash. Chaque type de multimédia doit être abordé séparément, et encore une fois, cela aura un impact sur les performances globales de votre crawler.
Problèmes de crawling des réseaux sociaux. Les réseaux sociaux – Facebook, Twitter, Tumblr, Google+, Instagram, etc. – sont une source inépuisable de données utiles et précieuses. Malheureusement, ils présentent tous les obstacles décrits ci-dessus pour les crawlers simultanément – et même plus ! Il peut être tentant de simplement traverser ce désordre en utilisant les moyens fournis par les réseaux sociaux eux-mêmes et leurs API client, mais celles-ci sont limitées en termes de types de données accessibles et d’efficacité d’accès – vous n’obtiendrez certainement pas un aperçu complet en les utilisant.
Obtenir un crawler qui en vaille la peine ressemble déjà à un parcours d’obstacles, mais nous ne faisons que commencer. Il existe une tâche supplémentaire qui fait que tout ce qui précède semble un jeu d’enfant, une tâche qui mérite un chapitre à elle seule : le crawling des zones protégées.
Défis du Crawling des Zones Protégées
Le crawling des zones protégées est l’une des tâches les plus difficiles de l’exploration Web. Il existe d’innombrables systèmes d’authentification différents, et votre crawler doit prendre en charge chacun d’eux – sinon, d’énormes pans de contenu lui seront inaccessibles. Nombre de nos clients nous ont même demandé d’implémenter le crawling des zones protégées comme une fonctionnalité spécifique, mais sa mise en œuvre est plus facile à dire qu’à faire. Voici un aperçu des défis que présente le crawling des zones protégées :
Préoccupations relatives au comportement du crawler
La première règle du crawling des zones protégées est aussi simple que vitale : soyez prudent. Vous vous souvenez de ce que nous avons dit précédemment sur « ne pas être une menace pour Internet » ? Suivre chaque lien et effectuer chaque action à votre disposition est une recette infaillible pour des données détruites, des utilisateurs en colère et des poursuites judiciaires vous visant, vous et votre crawler irresponsable. Vous devez vous assurer que votre crawler :
- Ne supprimera rien que les utilisateurs soient autorisés à supprimer (y compris le compte utilisateur lui-même !)
- N’essaiera pas de modifier les données utilisateur (noms d’utilisateur, mots de passe, etc.)
- N’effectuera pas d’actions de modération de contenu (par exemple, signaler le contenu d’autres utilisateurs)
- Ne publiera pas de contenu
- Ne rejettera pas les notifications utilisateur
- Et ainsi de suite !
En bref, vous devez trouver un moyen de vous assurer que votre crawler fonctionne en mode « lecture seule ». C’est plus compliqué qu’il n’y paraît ! Imaginez laisser un enfant en bas âge manipuler les données précieuses de quelqu’un, un enfant qui n’a aucune idée de ce qui est sûr ou non à toucher, de ce qui peut résister à ses coups de doigts et à ses secousses sans se casser – et s’il est sur le point de gâcher quelque chose d’important, il y a de fortes chances que vous ne puissiez pas l’arrêter à temps. C’est ce à quoi ressemble un crawling naïf des zones protégées, et il faut une programmation sophistiquée pour s’assurer que votre crawler sait ce qu’il peut toucher en toute sécurité et ce qu’il ne peut pas.
Mais assez parlé des catastrophes potentielles de crawler – comment y accéder en premier lieu ? Nous allons examiner certains mécanismes d’autorisation courants pour vous donner une idée de l’ampleur du problème :
Mécanismes d’authentification
Authentification HTTP basique (BA). C’est le moyen le plus simple de contrôler l’accès aux ressources web : pas de cookies, pas d’identifiants de session, pas de pages de connexion, juste des en-têtes HTTP standard. Presque toutes les bibliothèques réseau que vous trouverez prennent en charge cette fonctionnalité immédiatement, il est donc trivial de la prendre en charge dans votre crawler, mais le prix de cette simplicité est l’absence de sécurité : la BA ne fait rien pour protéger les identifiants transmis, si ce n’est les encoder en Base64, ce qui n’est qu’à une étape de les diffuser simplement en texte brut. Pour cette raison, la BA – si elle est utilisée – doit l’être sur HTTPS pour assurer un minimum de sécurité.
Authentification basée sur certificat. Alors que le mot « certificat » peut vous faire penser à quelque chose que vous accrocheriez au mur ou offririez en cadeau en guise d’argent, ici il fait référence à une implémentation d’authentification à clé publique. Un certificat est un document numérique prouvant la possession d’une clé publique : si le certificat porte une signature valide d’une autorité de confiance, le navigateur sait qu’il est sûr d’utiliser cette clé publique pour une communication sécurisée. Comme l’authentification basique, l’authentification basée sur certificat est suffisamment courante dans les bibliothèques réseau pour que vous ne devriez pas avoir de mal à la prendre en charge dans votre crawler, mais vous devez obtenir des certificats valides pour chaque zone protégée que vous souhaitez parcourir.
OAuth. OAuth est une norme d’autorisation ouverte qui permet aux utilisateurs d’accorder aux sites et applications un accès sécurisé à leurs données sans avoir à partager leurs informations de connexion. Si vous avez déjà utilisé votre connexion Microsoft, Google, Twitter ou Facebook pour vous connecter à un site web tiers sans mot de passe, vous avez rencontré OAuth en action. Implémenter le support OAuth à partir de zéro peut être délicat, nous vous recommandons donc de profiter des bibliothèques existantes, telles que Scribe pour Java.
OpenID. OpenID est une norme d’authentification ouverte qui permet aux utilisateurs de se connecter à des sites web via un service tiers. Contrairement à OAuth, qui ne gère que l’autorisation (c’est-à-dire l’octroi d’accès aux données entre sites), OpenID fournit un moyen par lequel les utilisateurs peuvent s’authentifier auprès de plusieurs sites en utilisant un seul ensemble d’identifiants. OpenID est largement pris en charge par les bibliothèques existantes, ce qui facilite sa mise en œuvre.
Et nous arrivons maintenant au type d’authentification le plus courant sur le web : l’authentification par formulaire. Cela ne nécessite pratiquement aucune introduction : l’utilisateur se voit présenter un ensemble de champs pour saisir ses identifiants (généralement un nom d’utilisateur et un mot de passe), qui sont ensuite vérifiés par le serveur. Examinons étape par étape un processus d’authentification par formulaire typique :
- Un utilisateur non autorisé tente d’accéder à une page sécurisée
- Le serveur répond avec une page contenant un formulaire d’authentification
- L’utilisateur saisit et soumet ses identifiants à l’aide du formulaire
- Le serveur vérifie les identifiants soumis
- Si les identifiants sont valides, l’utilisateur reçoit un jeton d’authentification/un cookie/etc. et est redirigé vers la page sécurisée
Et maintenant, examinons un formulaire d’authentification typique :
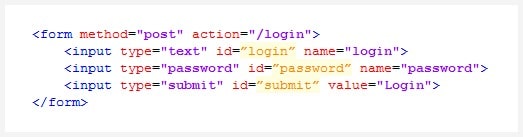
Pas vraiment intimidant, n’est-ce pas ? À première vue, il semble trivial d’intégrer l’authentification via ce formulaire ou tout autre dans votre crawler. Ce serait aussi simple que :
- Récupérer et analyser la page d’authentification
- Trouver le formulaire d’authentification et en extraire le point de terminaison et les paramètres
- Générer une requête POST avec les paramètres extraits du formulaire et nos identifiants
- Exécuter la requête et recevoir le jeton d’authentification/cookie/etc. du serveur
- Parcourir !
Si seulement c’était vraiment aussi simple ! En pratique, vous rencontrerez des scénarios comme ceux-ci :
- Le formulaire d’authentification se trouve dans un iframe et ne fonctionne que sur la page de connexion
- Le formulaire d’authentification est généré par JavaScript
- Le site utilise un serveur d’authentification tiers
- Le point de terminaison et/ou les paramètres d’authentification sont créés dynamiquement
- L’autorité du domaine du serveur cible ne correspond pas à l’autorité du domaine d’authentification
- La requête nécessite une signature numérique dynamique
Votre crawler pourrait avoir à gérer n’importe quelle combinaison de ces complications – comme un formulaire d’authentification généré par JavaScript à partir d’un serveur tiers avec des paramètres générés dynamiquement qui nécessite une signature numérique. Ce n’est pas juste un scénario catastrophe hypothétique, d’ailleurs : c’est ainsi que fonctionnaient autrefois les portails d’entreprise internes de McDonald’s !
Une autre complication potentielle d’authentification est les « tempêtes de redirections » : être renvoyé entre plusieurs serveurs d’authentification, chacun définissant ses propres cookies d’authentification. Encore une fois, pour un navigateur, ce n’est pas un problème du tout, mais pour un crawler, vous devez vous assurer que chaque page est correctement évaluée afin d’obtenir tous les cookies et en-têtes nécessaires à l’authentification. Pour citer un autre exemple réel, les portails d’entreprise de RJR Tobacco géraient auparavant l’authentification de cette manière !
Ce ne sont là que quelques-uns des défis auxquels vous serez confronté lors du crawling des zones protégées. Le codage direct de solutions pour chaque cas individuel n’est tout simplement pas une option : il y a trop de scénarios différents à aborder. Ce que vous pouvez faire, cependant, c’est implémenter une solution « taille unique » qui peut être ajustée pour gérer toutes les situations qu’un site web pourrait présenter à votre crawler. Nous en parlerons dans le chapitre suivant.
Approches d’Implémentation
Comme mentionné dans le chapitre précédent, la meilleure façon de gérer l’authentification dans un crawler est une approche « couteau suisse » : plutôt qu’une myriade d’outils pour gérer chaque scénario différent, vous avez un seul outil qui peut gérer tous les scénarios. Cela semble être une tâche ardue, n’est-ce pas ? Ça peut l’être – mais c’est un territoire bien exploré, et il existe deux sentiers éprouvés pour y parvenir :
1. Personnalisation des mécanismes d’authentification à la demande (c’est-à-dire le scripting).
Pour cette approche, il va sans dire que vous devrez ajouter une sorte de support de scripting à votre crawler. Une fois cela fait, créez un script par défaut – un ensemble d’instructions pour gérer les formulaires de connexion basiques nom d’utilisateur-mot de passe que la plupart des sites web utilisent. Et chaque fois que votre crawler rencontre quelque chose que votre script par défaut ne peut pas gérer (hachages supplémentaires, paramètres dynamiques, tempêtes de redirections, etc.), tout ce que vous avez à faire est d’écrire un script d’authentification personnalisé pour vous en occuper. Simple !
Il n’y a que deux problèmes avec cette approche :
- Vous ne pouvez pas savoir si votre crawler rencontre des problèmes de connexion à moins que quelqu’un ne signale le problème
- Vous devez constamment vérifier les changements sur les sites web pour maintenir vos scripts à jour
Voici encore un scénario réel pour illustrer le problème. Il y a quelque temps, Redwerk a implémenté le crawling de Facebook et Twitter. Au lieu de simplement collecter des informations à l’aide de leurs API, notre crawler a été configuré pour prendre des instantanés complets et fonctionnels que vous pouviez réellement parcourir et naviguer comme si vous étiez sur le site d’origine. Ce n’est pas la façon la plus efficace de faire les choses, et certainement pas la plus simple, mais nous y sommes parvenus en utilisant des scripts d’authentification personnalisés – pendant deux mois seulement. Facebook et Twitter ont changé leurs systèmes d’authentification, et nous avons dû réécrire nos scripts d’authentification pour qu’ils correspondent. Cela a été un jeu constant du chat et de la souris depuis : de temps en temps, ils ajustent leur authentification, et nous devons réviser nos scripts pour qu’ils fonctionnent avec la nouvelle configuration. Quoi qu’il en soit, le scripting était le meilleur moyen, et probablement le seul, d’accomplir ce que nous avons réalisé, mais cela a un coût en termes de maintenance !
2. Services basés sur un moteur de navigateur
Une approche alternative consiste à créer un service d’authentification basé sur un moteur de navigateur ou un toolkit web tel que PhantomJS, CasperJS, ou Node.js. Compte tenu de tous les problèmes qui surviennent en raison des différences entre la façon dont les crawlers et les navigateurs traitent les sites web, il est logique de traiter l’un d’eux en comblant le fossé entre les deux : à moins de mesures anti-crawl sévères, un service d’authentification basé sur un moteur de navigateur garantira que les sites web fonctionneront de la même manière pour votre crawler que pour les utilisateurs. Même le contenu Flash et HTML5 fonctionnera parfaitement pour votre crawler !
Le processus est simple : votre crawler interroge votre service d’authentification avant d’essayer de parcourir une zone protégée d’un site web, et votre service gère le processus de connexion requis.
Vous pouvez également inclure un mécanisme de ré-authentification qui permettra à votre crawler de renouveler automatiquement son authentification si elle expire pour une raison quelconque. Les fonctionnalités que votre service devrait fournir incluent :
- Servir les requêtes du crawler pour effectuer l’authentification (généralement via une API REST)
- Effectuer ladite authentification en utilisant les paramètres reçus du crawler (URL de connexion, identifiants, délais, etc.)
- Collecter et renvoyer les résultats d’authentification pertinents (cookies, en-têtes, jetons, etc.)
- Garantir que les données d’authentification sont uniques et ne sont pas partagées entre les tâches (vous ne voudriez pas que quelqu’un parcoure votre profil, n’est-ce pas ?)
Avec l’authentification basée sur un moteur de navigateur, vous n’avez pas besoin d’une solution personnalisée pour chaque situation inhabituelle (bien que vous deviez toujours implémenter des moyens de gérer la myriade de cas extrêmes et de coins oubliés). Un autre avantage est que vous pouvez mettre en place un système de notification qui vous informera quand – et pourquoi – votre crawler ne parvient pas à se connecter à un site.
Et maintenant que vous disposez d’un service basé sur un moteur de navigateur, pourquoi s’arrêter là ? Votre service peut faire d’autres choses qui peuvent vous simplifier la vie : par exemple, suivre les requêtes serveur et extraire les ressources, ce qui rend trivial la récupération de contenu généré dynamiquement. Vous pouvez même implémenter toute la fonctionnalité de votre crawler de cette manière, mais ce n’est pas une tâche simple, et cela pourrait ne pas en valoir la peine en fonction de l’objectif de votre crawler.
Les deux approches ont leurs avantages dans différentes circonstances. Ne vous laissez pas enfermer dans l’une ou l’autre : la fidélité à une pile technologique particulière ne vous aidera pas à accomplir votre travail.
Résumé
Nous sommes bien conscients que ce n’est pas le guide définitif sur les web crawlers : vous êtes libre de ne pas être d’accord avec tout ce que nous avons dit à ce sujet. Cela dit, ce guide est basé sur notre propre expérience de travail avec les crawlers, et nos conseils sont basés sur des solutions aux problèmes que nous avons rencontrés. Nous espérons qu’il vous aidera au moins à éviter certains des pièges que les nouveaux venus au web crawling rencontrent couramment. Les crawlers sont des systèmes complexes, mais si vous les gérez correctement, vous pouvez obtenir des résultats étonnants.
À propos de Redwerk
La société Redwerk est spécialisée dans la fourniture de services de développement logiciel de qualité pour diverses industries. L’une de nos forces est de fournir aux entreprises des solutions de data mining et de logiciels d’exploration Web, visant à collecter des informations pour des décisions stratégiques et l’amélioration des processus métier. L’équipe Redwerk est toujours prête à développer de nouveaux produits et à améliorer ceux existants pour nos clients.
Projets automatisés d’exploration Web que nous avons réalisés
Ce que disent nos clients
«Redwerk est un fournisseur de services informatiques compétent, spécialisé dans le développement d’applications complexes, le QA et le support. Leur équipe est très qualifiée, respecte les délais et reste généralement dans le budget. Ils disposent d’un modèle de déploiement rentable et répondent aux besoins techniques et commerciaux de LinkTiger. J’ai recommandé leurs services à de nombreux collègues d’affaires et ils m’ont remercié pour cela.» — Steve Moskowski, Propriétaire chez Linktiger.com
Découvrez comment nous avons développé un système de crawling haute performance à partir de zéro