La plupart des tutoriels donnent l’impression que la distillation des LLM est un projet de fin de semaine. Quarante lignes de code Hugging Face, un échange BERT contre DistilBERT, terminé. Le vrai pipeline représente une échelle de travail différente. Vous choisissez un enseignant que vous êtes légalement autorisé à utiliser, générez un ensemble de données synthétiques qui ne contamine pas l’étudiant, entraînez avec LoRA, et prouvez que l’étudiant n’a pas régressé silencieusement sur les entrées que vos utilisateurs envoient réellement.
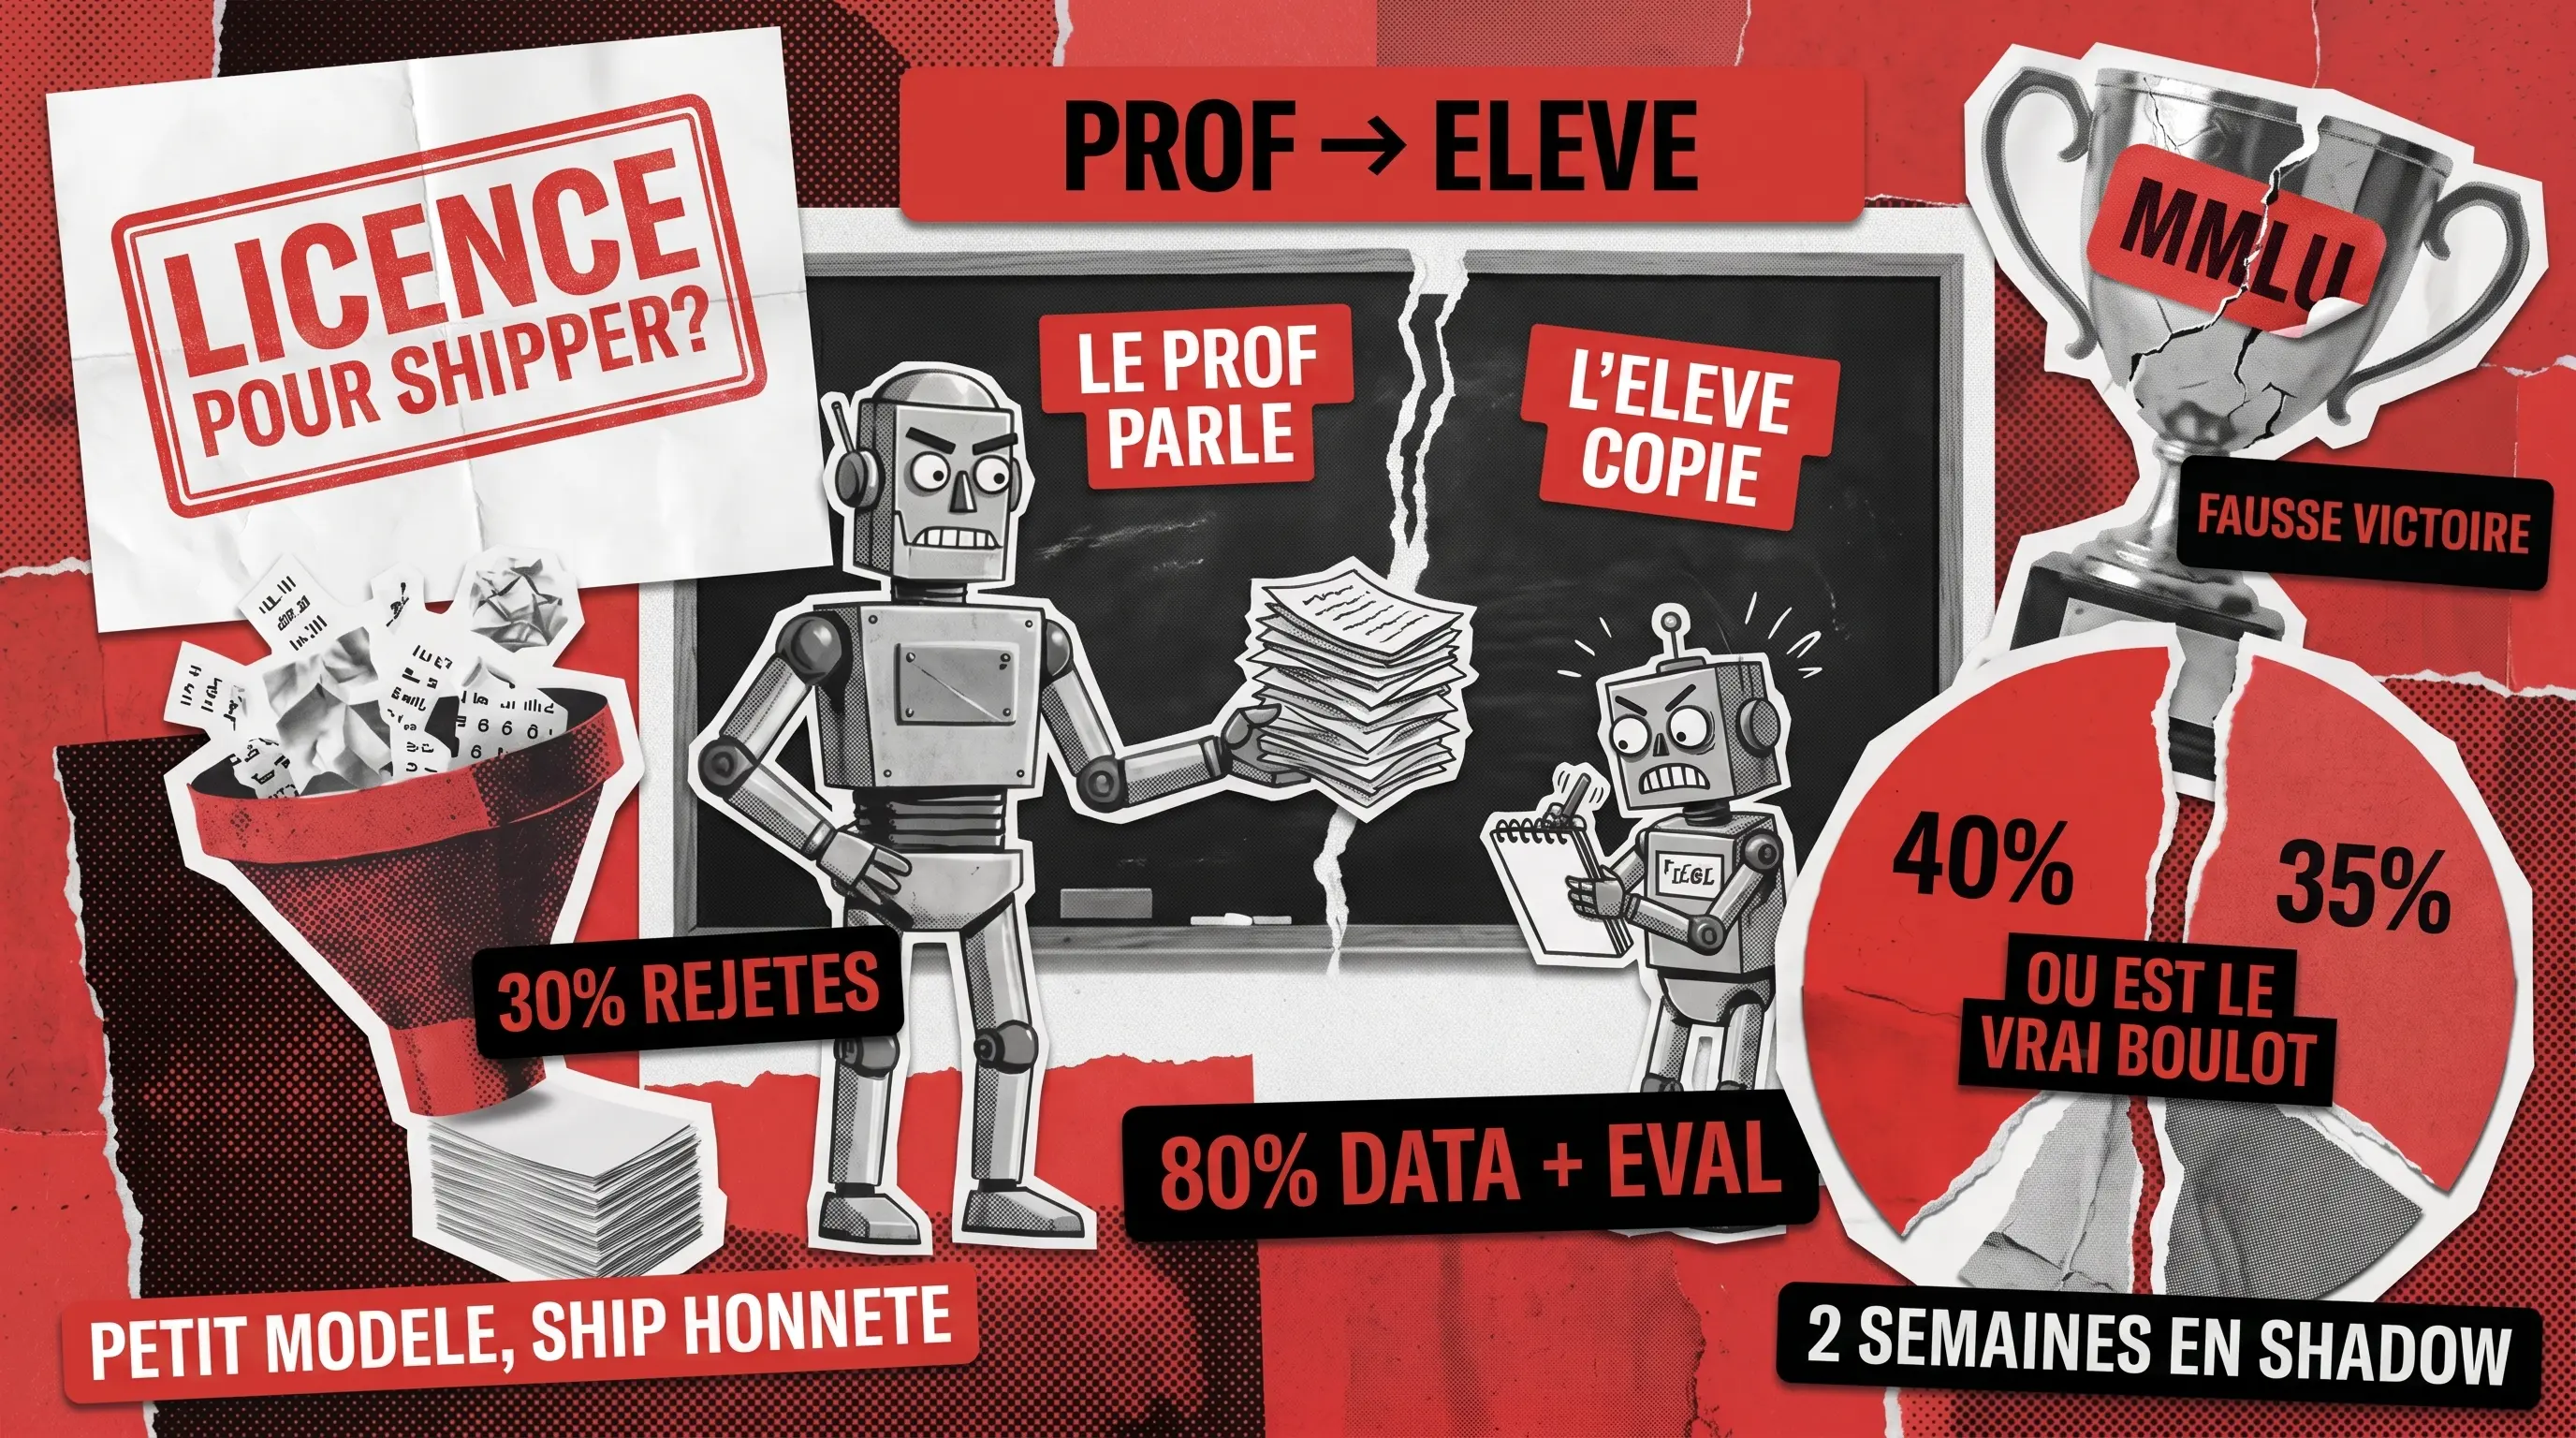
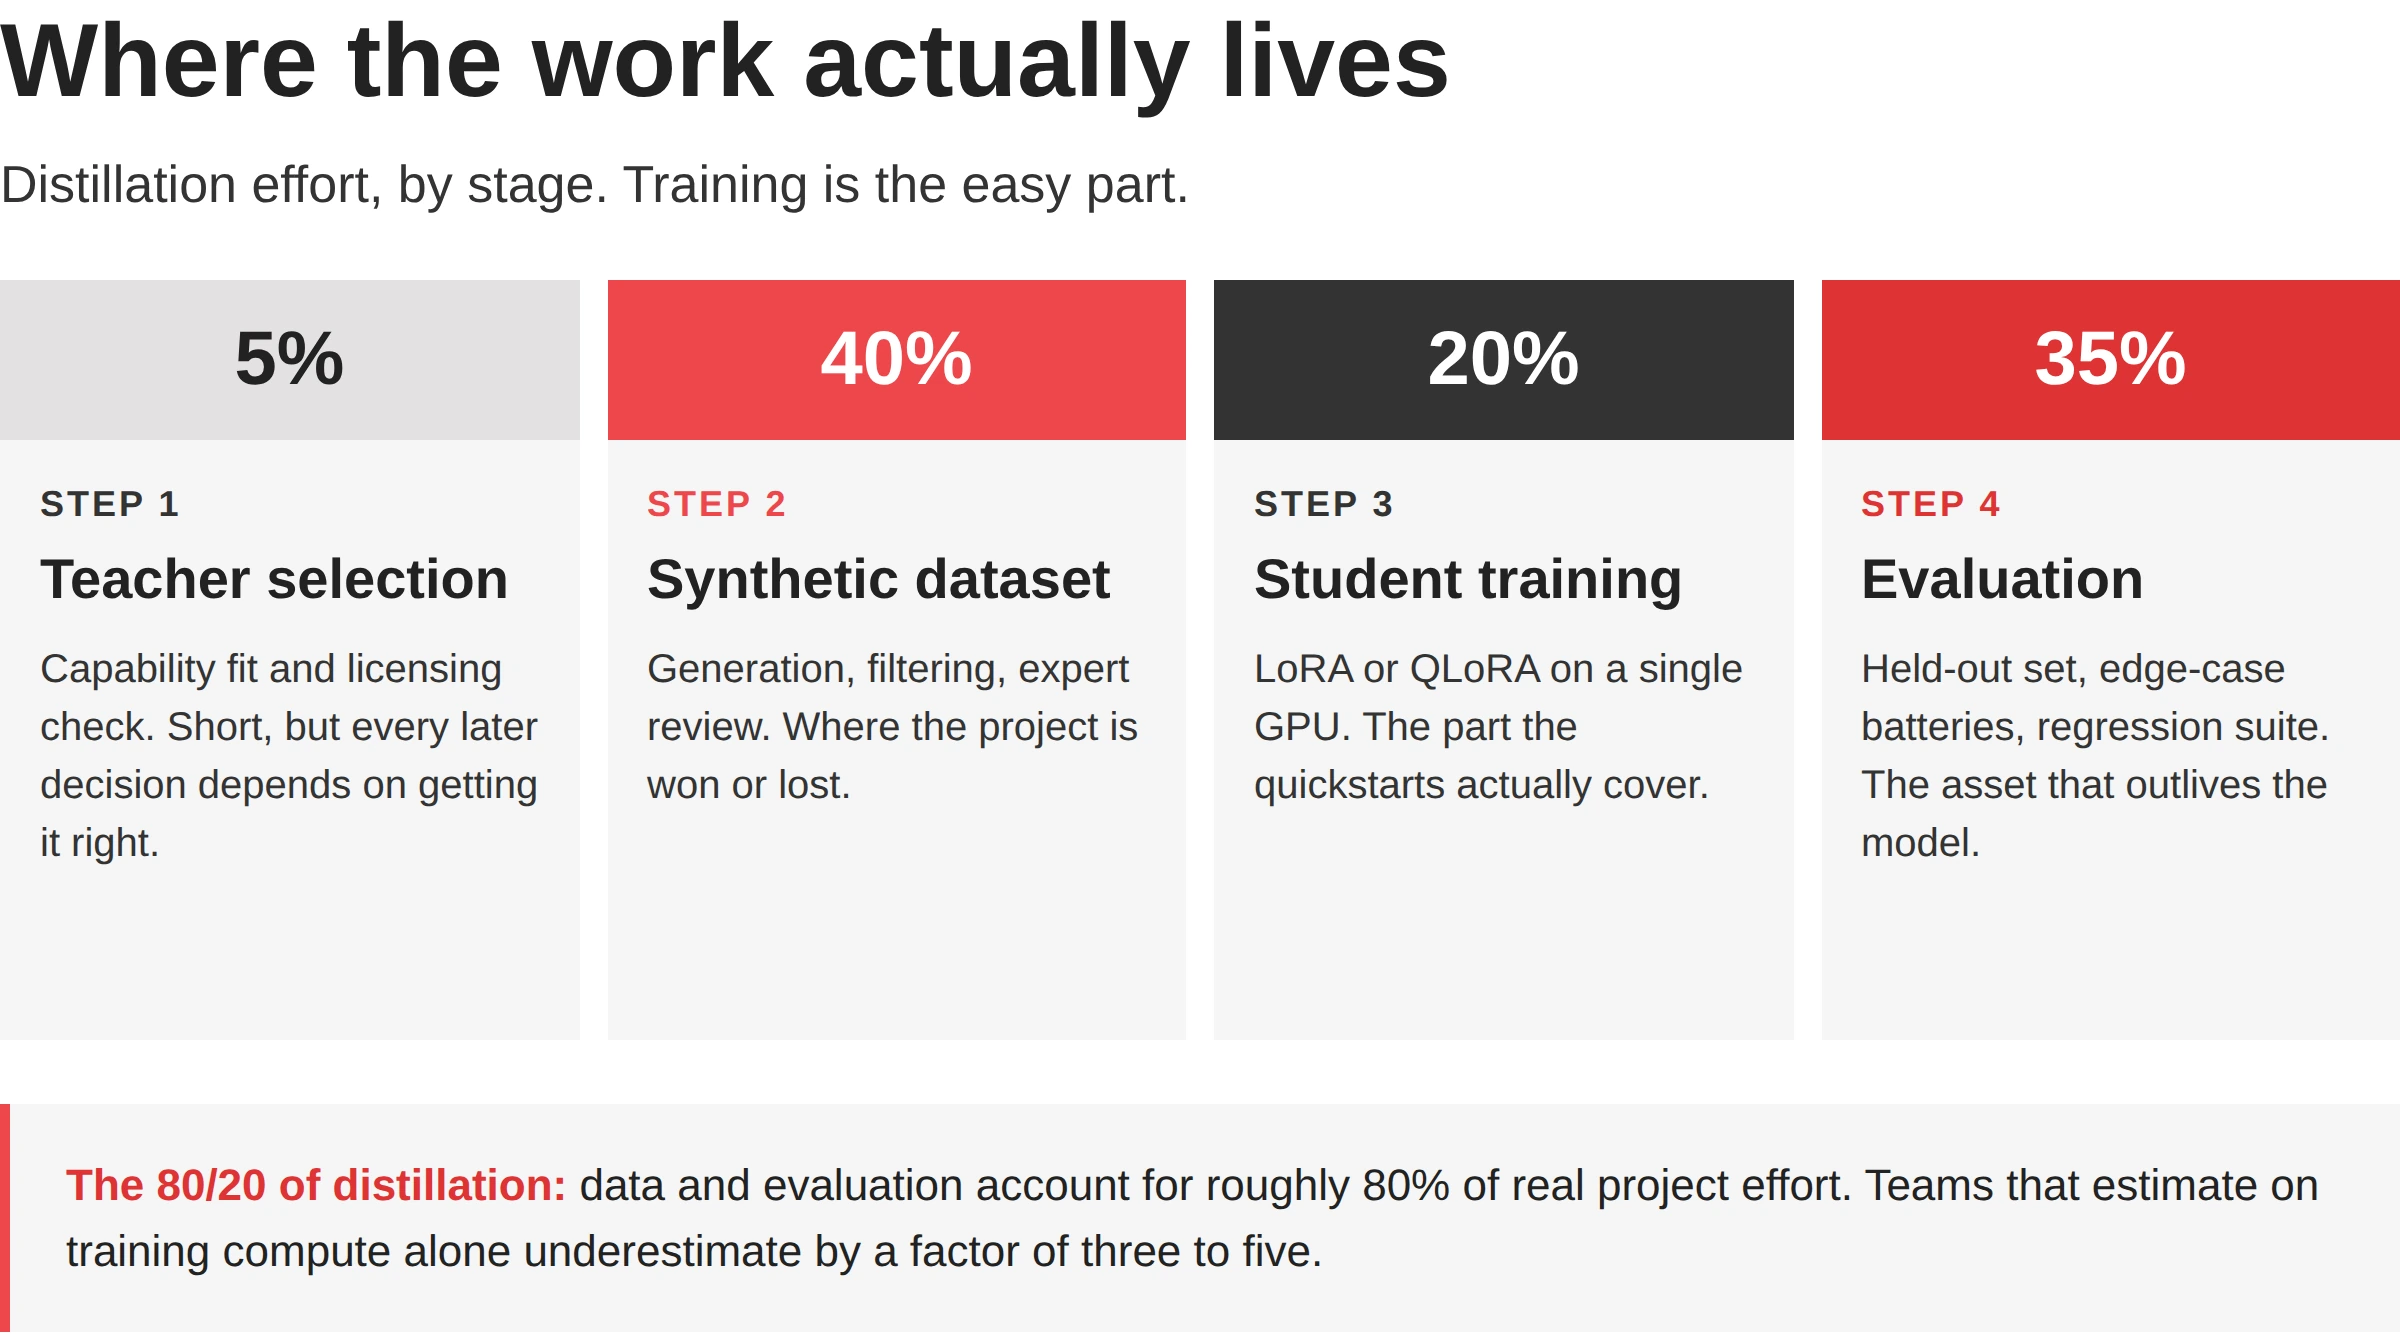
La partie entraînement représente 20 % du travail facile. Les données et l’évaluation représentent les 80 % qui décident si le projet aboutit ou stagne. C’est aussi pourquoi la plupart des équipes qui s’investissent pleinement dans les services de distillation de modèles finissent par avoir besoin d’aide sur les couches de données synthétiques et d’évaluation, pas sur la boucle d’entraînement. Avant de détailler comment distiller un LLM de bout en bout, il est utile de définir ce que la distillation enseignant-étudiant signifie réellement en pratique.
Ce que signifie réellement la distillation enseignant-étudiant
Un grand modèle enseignant produit des sorties sur un ensemble d’entrées, et un étudiant plus petit est entraîné à les reproduire. L’étudiant hérite d’une grande partie des performances de tâche de l’enseignant pour une fraction du coût d’inférence. La distillation en boîte blanche utilise la distribution de probabilité complète de l’enseignant sur les jetons, ce qui apporte plus de signal d’apprentissage mais nécessite un accès aux logits, donc uniquement avec des enseignants à poids ouverts. La distillation en boîte noire utilise uniquement le texte retourné par l’enseignant, ce qui fonctionne avec n’importe quelle API hébergée mais donne moins de signal par échantillon.
C’est ainsi que se présente l’entraînement des modèles enseignant-étudiant au niveau conceptuel. La preuve que tout le monde retient est DistilBERT. L’équipe de Hugging Face a montré qu’elle pouvait réduire BERT de 40 % et le rendre 60 % plus rapide tout en conservant 97 % de sa compréhension du langage sur le benchmark GLUE. C’est le plafond. Le plancher, lorsque les équipes sautent les étapes ci-dessous, est un petit modèle qui se trompe avec assurance sur les entrées qui comptent. La distillation est également différente de la recherche, et notre cadre de décision pour le fine-tuning par rapport au RAG est le meilleur point de départ si vous n’avez pas encore fait ce choix.
Étape 1 : Choisir l'enseignant
L’enseignant décide de deux choses que vous ne pouvez pas changer plus tard : à quel point l’étudiant peut devenir bon, et si vous êtes autorisé à le commercialiser. Les deux questions méritent une réponse réelle avant de générer un seul jeton de données d’entraînement.
Adéquation des capacités
L’étudiant hérite du plafond de l’enseignant, pas de votre ambition. Si l’enseignant hallucine sur votre domaine ou échoue sur vos cas limites, l’étudiant reproduira ces échecs plus rapidement et à moindre coût. Exécutez vos 50 invites les plus difficiles sur l’enseignant candidat avant de vous engager. Si l’enseignant obtient 70 %, l’étudiant n’obtiendra pas 90 %. Choisissez un enseignant qui est déjà performant sur la tâche spécifique que vous souhaitez compresser, pas le modèle avec les chiffres de benchmark les plus bruyants.
Licence
C’est la section que la plupart des tutoriels sautent. Après janvier 2025, les fournisseurs de modèles fermés ont resserré leurs conditions publiquement. OpenAI, Anthropic, Mistral et xAI incluent tous des clauses interdisant l’utilisation de leurs sorties pour entraîner des modèles concurrents, « concurrents » étant interprété largement. Selon le Financial Times, OpenAI a trouvé des preuves que DeepSeek utilisait ses modèles pour entraîner un rival, et le différend est devenu le cas de référence que toutes les équipes juridiques citent désormais. En février 2026, Anthropic a publiquement accusé DeepSeek, Moonshot et MiniMax d’attaques par distillation sur Claude, indiquant clairement que les fournisseurs surveillent cela.
Les enseignants à poids ouverts ont leurs propres conditions. La licence communautaire Llama a des seuils d’utilisation commerciale, plusieurs versions de recherche interdisent l’utilisation commerciale pure et simple, et les modèles Apache 2.0 constituent le chemin le plus clair si votre examen juridique est averse au risque. En bref : lisez la carte du modèle, lisez les conditions de l’API et documentez la décision par écrit. Chaque examen juridique ultérieur demandera quel enseignant vous avez utilisé et ce que sa licence autorisait.
Étape 2 : Générer l'ensemble de données synthétiques
C’est là que le projet est gagné ou perdu. L’étudiant apprend tout ce qui se trouve dans les données, y compris les biais de l’enseignant, les hallucinations et les tics stylistiques. Un exemple typique de distillation de LLM dans les articles de recherche utilise des dizaines de milliers d’échantillons soigneusement filtrés, et le temps passé au filtrage dépasse généralement le temps passé à l’entraînement.
Entrées initiales et volume
Commencez par des invites de domaine réelles : journaux de production, tickets de support, requêtes utilisateur anonymisées, documents internes. La diversité compte plus que le volume brut au-delà d’un certain point. Pour une tâche étroite, 1 000 à 5 000 amorces bien organisées battent souvent 50 000 amorces bruitées. Pour un étudiant plus généraliste suivant les instructions, prévoyez 20 000 à 100 000. Si des invites réelles ne sont pas disponibles, générez des amorces avec un modèle séparé et faites examiner la distribution par un humain avant de passer à l’échelle.
Trois stratégies de génération
Chaque méthode troque l’effort contre la qualité du signal.
Distillation à étiquettes douces
Logits (poids ouverts uniquement)
Élevé
Classification, tâches étroites
Distillation basée uniquement sur la sortie
Toute API hébergée
Faible
Tâches génératives, usage général
Distillation pas à pas
Tout enseignant capable d’expliquer
Moyen
Tâches de raisonnement, régimes à faible volume de données
La distillation pas à pas vaut la peine d’être connue. L’enseignant génère une justification à côté de la réponse, et l’étudiant s’entraîne sur les deux. Des chercheurs de Google et Snorkel ont montré que cela pouvait égaler un modèle plus grand avec nettement moins de données, ce qui est important lorsque votre pool d’amorces est petit.
Filtrage et révision par experts
La partie peu glamour du pipeline. Dédupliquez et appliquez un filtrage ROUGE-L pour les quasi-doublons. Éliminez les valeurs aberrantes de longueur et de format qui pourraient confondre l’étudiant. Vérifiez au hasard un échantillon de 5 % pour les hallucinations. Pour les sorties réglementées, faites approuver un échantillon représentatif par un expert du domaine. Attendez-vous à rejeter 20 à 40 % des générations en cours de route. Les équipes qui sautent le filtrage livrent des étudiants qui sur-optimisent les particularités de l’enseignant. Pour les tâches juridiques, médicales ou financières, la révision par des experts n’est pas facultative, et si cette capacité de révision constitue la contrainte, nos services de développement d’agents IA incluent souvent cette couche.
Étape 3 : Entraîner l'étudiant
Les 20 % faciles. LoRA injecte de petits adaptateurs de rang faible dans les poids existants et gèle le reste, réduisant les paramètres entraînables à environ 1 % du total. QLoRA ajoute une quantification en 4 bits du modèle de base en plus de LoRA, réduisant encore la mémoire nécessaire de moitié environ. Le résultat pratique : un étudiant de 7 milliards de paramètres devient affinable sur un seul GPU de 24 Go au lieu d’un cluster multi-GPU.
Configuration qui tient pour la plupart des tâches :
- Rang entre 8 et 64. Alpha à peu près deux fois le rang.
- Taux d’apprentissage proche de 2e-4 avec une planification cosinus.
- Accumulation de gradient pour atteindre votre taille de lot effective.
- Pour la distillation à étiquettes douces : combinaison pondérée de la divergence KL (distributions enseignant vs étudiant) et de l’entropie croisée sur les étiquettes dures, avec mise à l’échelle de température sur le softmax, T = 2 à 4.
Un conseil sur lequel les équipes de production s’accordent : commencez avec l’étudiant le plus petit et viable. Un modèle de 1 milliard de paramètres prend 20 minutes par exécution et révèle immédiatement les problèmes d’infrastructure. Un modèle de 70 milliards de paramètres prend une journée et les masque. Faites fonctionner la boucle de bout en bout sur un petit modèle, puis augmentez l’échelle une fois que vous lui faites confiance. Les équipes qui construisent des systèmes plus importants sur le modèle distillé ont généralement besoin de travaux de développement de grands modèles de langage qui vont au-delà de la boucle d’entraînement elle-même.
Étape 4 : Évaluer correctement
C’est là que la plupart des projets de distillation échouent silencieusement. L’entraînement se termine, MMLU semble correct, l’équipe livre, et trois semaines plus tard, les tickets de support révèlent que l’étudiant échoue sur les entrées longues, les instructions ambiguës et tout ce qui sort de la distribution des données synthétiques.
Les benchmarks publics sont le signal le plus faible de l’image. MMLU, GLUE et HellaSwag sont utiles principalement pour repérer les régressions catastrophiques, car la contamination des données est endémique et l’ensemble de test peut avoir fui dans le pré-entraînement ou dans les sorties de l’enseignant. L’actif qui compte réellement est un ensemble d’évaluation mis de côté, construit à partir du trafic réel. Cinq cents à deux mille cas, étiquetés à la main si possible, couvrant la longueur des entrées, la complexité, les cas limites, les invites adverses et la longue traîne que vos utilisateurs envoient réellement.
Utilisez plusieurs méthodes ensemble. Des métriques spécifiques à la tâche comme la correspondance exacte ou BLEU pour des sorties étroites. LLM-as-judge utilisant une famille de modèles différente de votre enseignant, pour éviter les biais de même famille. Vérifications manuelles sur les 10 % inférieurs des scores jugés, c’est là que se cachent les régressions. Suivez les performances par catégorie, jamais juste la moyenne. Un étudiant qui obtient 96 % au total peut obtenir 40 % sur les entrées longues tandis que la moyenne semble saine.
La construction et la maintenance de ce système sont un travail d’ingénierie plus soutenu que l’entraînement lui-même. Les équipes sans infrastructure ML dédiée le sous-construisent, livrent et découvrent les problèmes en production. C’est là que les entreprises font souvent appel à de l’aide extérieure, à la fois pour la construction initiale et pour la suite de régression qui survit à chaque échange de modèle. Le développement de l’IA en production repose sur cette couche plus que sur tout modèle individuel.
Quand la distillation est rentable et quand elle ne l'est pas
La décision porte rarement sur le fait que la distillation fonctionne. Il s’agit de savoir si votre tâche et votre équipe sont préparées pour cela.
Bonne adéquation lorsque :
- Tâche étroite à haut volume.
- Surface produit sensible à la latence.
- Cible de coût d’inférence prévisible.
- Journaux de production réels disponibles pour les données synthétiques.
Une approche modèle enseignant-étudiant est rentabilisée le plus rapidement lorsque le volume d’inférence est suffisamment important pour que la différence de coût par rapport à une API hébergée récupère l’investissement en ingénierie en un trimestre ou deux.
Mauvaise adéquation lorsque :
- L’enseignant ne performe pas bien sur votre tâche.
- Aucune donnée d’évaluation réelle n’existe.
- Aucune expertise du domaine disponible pour la révision.
Dans ces cas, la génération augmentée par la recherche, la mise en cache des invites ou un modèle hébergé plus petit offrent souvent 60 à 80 % de l’avantage en termes de coûts sans toute la complexité de l’entraînement. La question de savoir comment affiner un petit modèle par rapport à la recherche ou à la distillation mérite une comparaison structurée avant de vous engager en temps d’ingénierie.
Le calendrier réaliste
Les guides rapides de Hugging Face ne montrent pas cette partie. Un pipeline de qualité professionnelle pour une tâche modérément complexe prend 2 à 4 semaines pour la génération et le filtrage de données synthétiques, 1 semaine pour l’entraînement et l’itération, et 2 à 3 semaines pour la construction de la plateforme d’évaluation, plus la maintenance continue à mesure que le domaine source évolue.
Les équipes qui estiment le temps en se basant uniquement sur le calcul d’entraînement sous-estiment systématiquement le projet d’un facteur de trois à cinq. La plateforme d’évaluation est l’actif qui survit à chaque modèle individuel. Vous la réutilisez chaque fois que vous échangez l’étudiant, ré-entraînez sur des données fraîches, ou testez un nouvel enseignant. Considérez-la comme un investissement durable, pas comme le modèle lui-même.
La barre de lancement
Un modèle distillé est prêt lorsqu’il réussit votre suite d’évaluation mise de côté, y compris les batteries de cas limites, et qu’il survit à deux semaines de trafic en ombre sans surprendre l’équipe. Pas quand la perte d’entraînement est propre. Pas quand MMLU est acceptable. Le plus petit étudiant qui franchit ces portes est celui qui mérite d’être mis en production. Résister à l’envie de compresser davantage jusqu’à ce qu’il ait été utilisé par de vrais utilisateurs est généralement la bonne décision.
Un modèle distillé est un projet. Maintenir le pipeline de données synthétiques honnête, la suite d’évaluation à jour, et l’étudiant réglé à mesure que votre domaine évolue en est un autre. La plupart des équipes gèrent le premier confortablement et sous-estiment le second. Si vous préférez ne pas pourvoir les deux postes, contactez-nous, et nous pourrons discuter des parties pour lesquelles il est utile de faire appel à de l’aide.
Découvrez comment nous avons transformé une plateforme IA héritée en une solution de croissance numérique de qualité production.