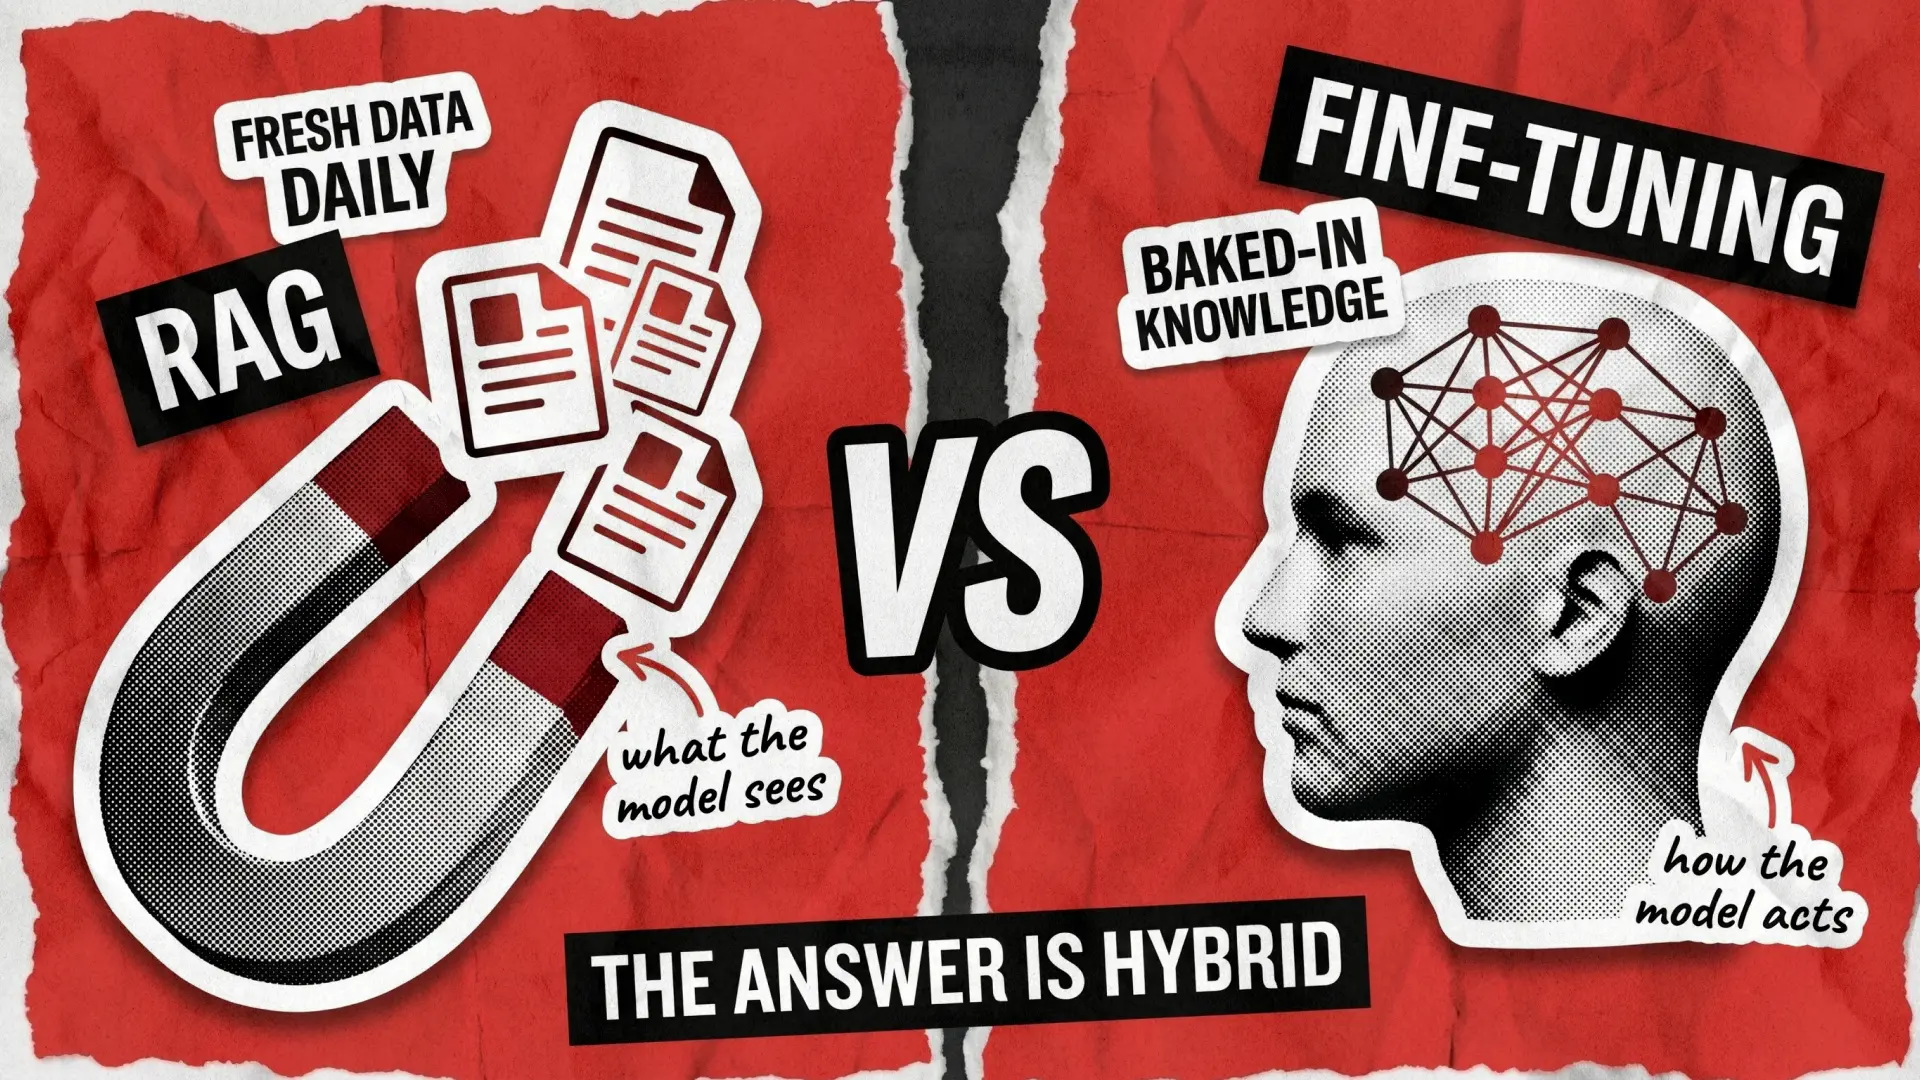
La plupart des équipes choisissent entre le fine-tuning et le RAG en fonction du dernier article qu’elles ont lu. Trois mois plus tard, elles ont implémenté la mauvaise technique et reconstruisent en silence. La technologie n’est pas la partie difficile. La décision est prise avant les critères.
Les enjeux ne sont pas abstraits. Une étude de 2025 du MIT Sloan Management Review et du BCG portant sur 2 102 répondants dans 116 pays a révélé que l’adoption de l’IA agentique dépassait celle de l’IA traditionnelle et générative, la plupart des organisations luttant encore pour transformer les pilotes en production. Le rapport Stanford AI Index 2026 a enregistré 362 incidents liés à l’IA en 2025, contre 233 l’année précédente, et a noté que l’amélioration d’une dimension des performances d’un modèle dégradait souvent une autre. Choisissez la mauvaise technique et votre LLM sera quand même expédié. Les problèmes se manifestent simplement dans les interactions avec l’utilisateur.
Si vous pesez le pour et le contre du fine-tuning par rapport au RAG, vous avez dépassé le stade du « qu’est-ce que c’est ». Cela relève de la phase de découverte. Ce qui suit est le cadre que nous utilisons sur chaque projet de LLM. Six questions, un tableau évaluable, trois scénarios où le cadre pointe dans des directions différentes, et les erreurs qui consomment des semaines de planification.
Le cadre de décision pour le RAG vs Fine Tuning
Six questions, une phrase de raisonnement chacune. Évaluez-les par rapport à votre projet, puis consultez le tableau récapitulatif. L’objectif n’est pas de désigner un gagnant. Il est de rendre les une ou deux décisions qui devraient être évidentes effectivement évidentes.
- À quelle vitesse vos connaissances changent-elles ? Des mises à jour quotidiennes ou hebdomadaires tuent le fine-tuning. Un modèle fine-tuné est un instantané, et dès que vos documents changent, l’instantané est obsolète. Le RAG échange la fraîcheur contre une recherche de récupération. Si vos données évoluent plus vite que votre cadence de réentraînement, le RAG est la réponse honnête.
- Avez-vous besoin de citer des sources ou de passer un audit ? Le RAG renvoie le document qu’il a utilisé pour répondre. Le fine-tuning incorpore les faits dans des poids que vous ne pouvez pas inspecter. Les industries réglementées ont presque toujours besoin du reçu, et le fine-tuning sans RAG survit rarement à un examen de conformité.
- Votre base de connaissances est-elle volumineuse ou propriétaire ? Documentation interne, données clients, corpus de niche, tout ce qui ne faisait pas partie de l’entraînement du modèle : c’est le territoire du RAG. Tout y intégrer dans un fine-tune est coûteux, fragile et ne dépasse pas le contenu d’une seule équipe.
- Avez-vous besoin d’un ton, d’une voix ou d’un format de sortie stricts ? Voix de marque, schémas JSON fixes, style de rédaction juridique, langage de domaine spécifique : ce sont des problèmes de comportement, pas des problèmes de connaissances. Le prompting vous permet d’aller au bout, et le fine-tuning comble le fossé que le prompting et le RAG seuls ne peuvent pas.
- Avez-vous au moins 1 000 exemples étiquetés propres prêts à l’emploi ? Sinon, la décision se prend d’elle-même : d’abord le RAG, puis l’hybride. Le fine-tuning sans un véritable ensemble de données est la façon dont les équipes déploient des modèles défectueux et blâment la mauvaise technologie.
- Quel est votre budget de latence ? Le RAG ajoute une étape de récupération, généralement de 100 à 400 millisecondes. Pour la plupart des applications, c’est invisible. Pour les interfaces vocales, les jeux en temps réel ou les copilotes de trading à haute fréquence, c’est rédhibitoire.
Voici la même logique condensée en un tableau de scores. C’est le format que nous utilisons lors de chaque lancement de projet de développement IA, car il transforme un argument philosophique en un exercice de 10 minutes.
Les connaissances changent chaque semaine ou plus rapidement
✓
Attribution des sources ou piste d’audit requise
✓
La base de connaissances est volumineuse ou propriétaire
✓
Ton, voix ou format de sortie stricts requis
✓
Plus de 1 000 exemples d’entraînement de haute qualité à disposition
✓
Latence inférieure à 500 ms à grande échelle requise
✓
Additionnez les points. Plus de marques pour le RAG, commencez par le RAG. Plus de marques pour le fine-tuning, commencez par le fine-tuning. Un partage trois-trois signifie presque toujours hybride, dont nous reparlerons plus bas.
Trois projets, trois réponses différentes
Même cadre, trois scénarios, trois résultats différents. Les questions ne changent pas, mais le poids relatif de chacune d’elles si. Ce qui suit est la manière dont la décision rag vs fine tuning se déroule lorsque vous l’appliquez à des contraintes réelles.
FinTech : un assistant pour les changements réglementaires destiné aux équipes de conformité
Une banque régionale souhaite un outil interne qui réponde à la question : « Cette réglementation a-t-elle changé et que devons-nous mettre à jour ? ». Les réglementations évoluent chaque mois. Les équipes de conformité doivent voir la source.
Exécutez le framework. La fraîcheur des connaissances penche fortement vers le RAG. L’attribution penche encore plus. Le ton et le format sont neutres, car un outil interne n’a pas besoin de personnalité. Le langage du domaine est spécifique mais gérable avec un contexte de récupération. Il n’y a pas de jeu de données d’entraînement étiqueté, car la banque a des politiques, pas des exemples. La latence est relâchée.
Score : le RAG gagne de manière décisive.
Le fine-tuning échoue ici pour deux raisons. Retraîner un modèle chaque fois que l’Autorité bancaire européenne publie des directives est opérationnellement impossible. Les auditeurs s’attendent à une citation, pas à une paraphrase confiante qu’ils ne peuvent pas vérifier. La couche de récupération est là où ces systèmes gagnent ou perdent, et une bonne ingénierie des données fait plus pour la précision que n’importe quel changement de modèle.
Les équipes des produits financiers portent le poids supplémentaire de la conformité de l’IA dans le domaine financier : l’AI Act de l’UE, le MiCA, et tout ce que votre régulateur ajoute par-dessus.
HealthTech : un assistant d'aide à la décision clinique
Une entreprise de dispositifs médicaux crée un assistant de triage pour les cliniciens. L’outil doit raisonner comme un jeune médecin, citer les directives à jour et répondre dans le format structuré de l’hôpital.
Exécutez le framework. La fraîcheur penche vers le RAG, car les interactions médicamenteuses et les directives sont mises à jour. L’attribution penche vers le RAG, car les cliniciens n’agiront pas sans source. Le ton, la structure de sortie et le langage du domaine penchent vers le fine-tuning. L’équipe dispose d’un corpus de notes de cas historiques, donc des exemples étiquetés existent. La latence est modérée.
Score : hybride, par conception.
C’est là que RAFT (retrieval-augmented fine-tuning) mérite son acronyme. Fine-tunez le modèle de base sur le raisonnement médical et le ton clinique. Utilisez le RAG au moment de la requête pour extraire les directives actuelles, les interactions médicamenteuses et les protocoles locaux. Vous obtenez la voix d’un médecin avec la mémoire de travail d’une pharmacie bien indexée.
Choisir l’approche du modèle n’est que la moitié du travail. L’autre moitié est le framework d’agent, où la comparaison LangChain vs LangGraph est celle sur laquelle la plupart des équipes s’accordent.
eCommerce : un agent de support client IA avec une voix de marque
Une marque en vente directe aux consommateurs souhaite un bot de support qui sonne comme son équipe, connaisse le catalogue actuel et gère la logique de remboursement selon sa politique. La voix de la marque est le produit, et l’inventaire change quotidiennement.
Exécutez le framework. La fraîcheur, l’attribution et l’exactitude de la politique penchent vers le RAG. Le ton, le format et la cohérence penchent vers le fine-tuning. Le langage du domaine est neutre. Le jeu de données est solide, car les tickets de support sont une mine d’or d’exemples étiquetés. La latence est inférieure à une seconde.
Score : hybride, pondéré vers le fine-tuning plus RAG.
Fine-tunez pour la voix, le ton et le format de réponse. Utilisez le RAG pour le catalogue, la tarification, la politique et l’historique des commandes des clients. C’est l’architecture par défaut pour la plupart des projets sérieux d’agents de support client IA destinés aux consommateurs, et c’est la pile que nous utilisons dans la plupart de nos travaux de développement de chatbots.
Pourquoi la production finit généralement par être hybride
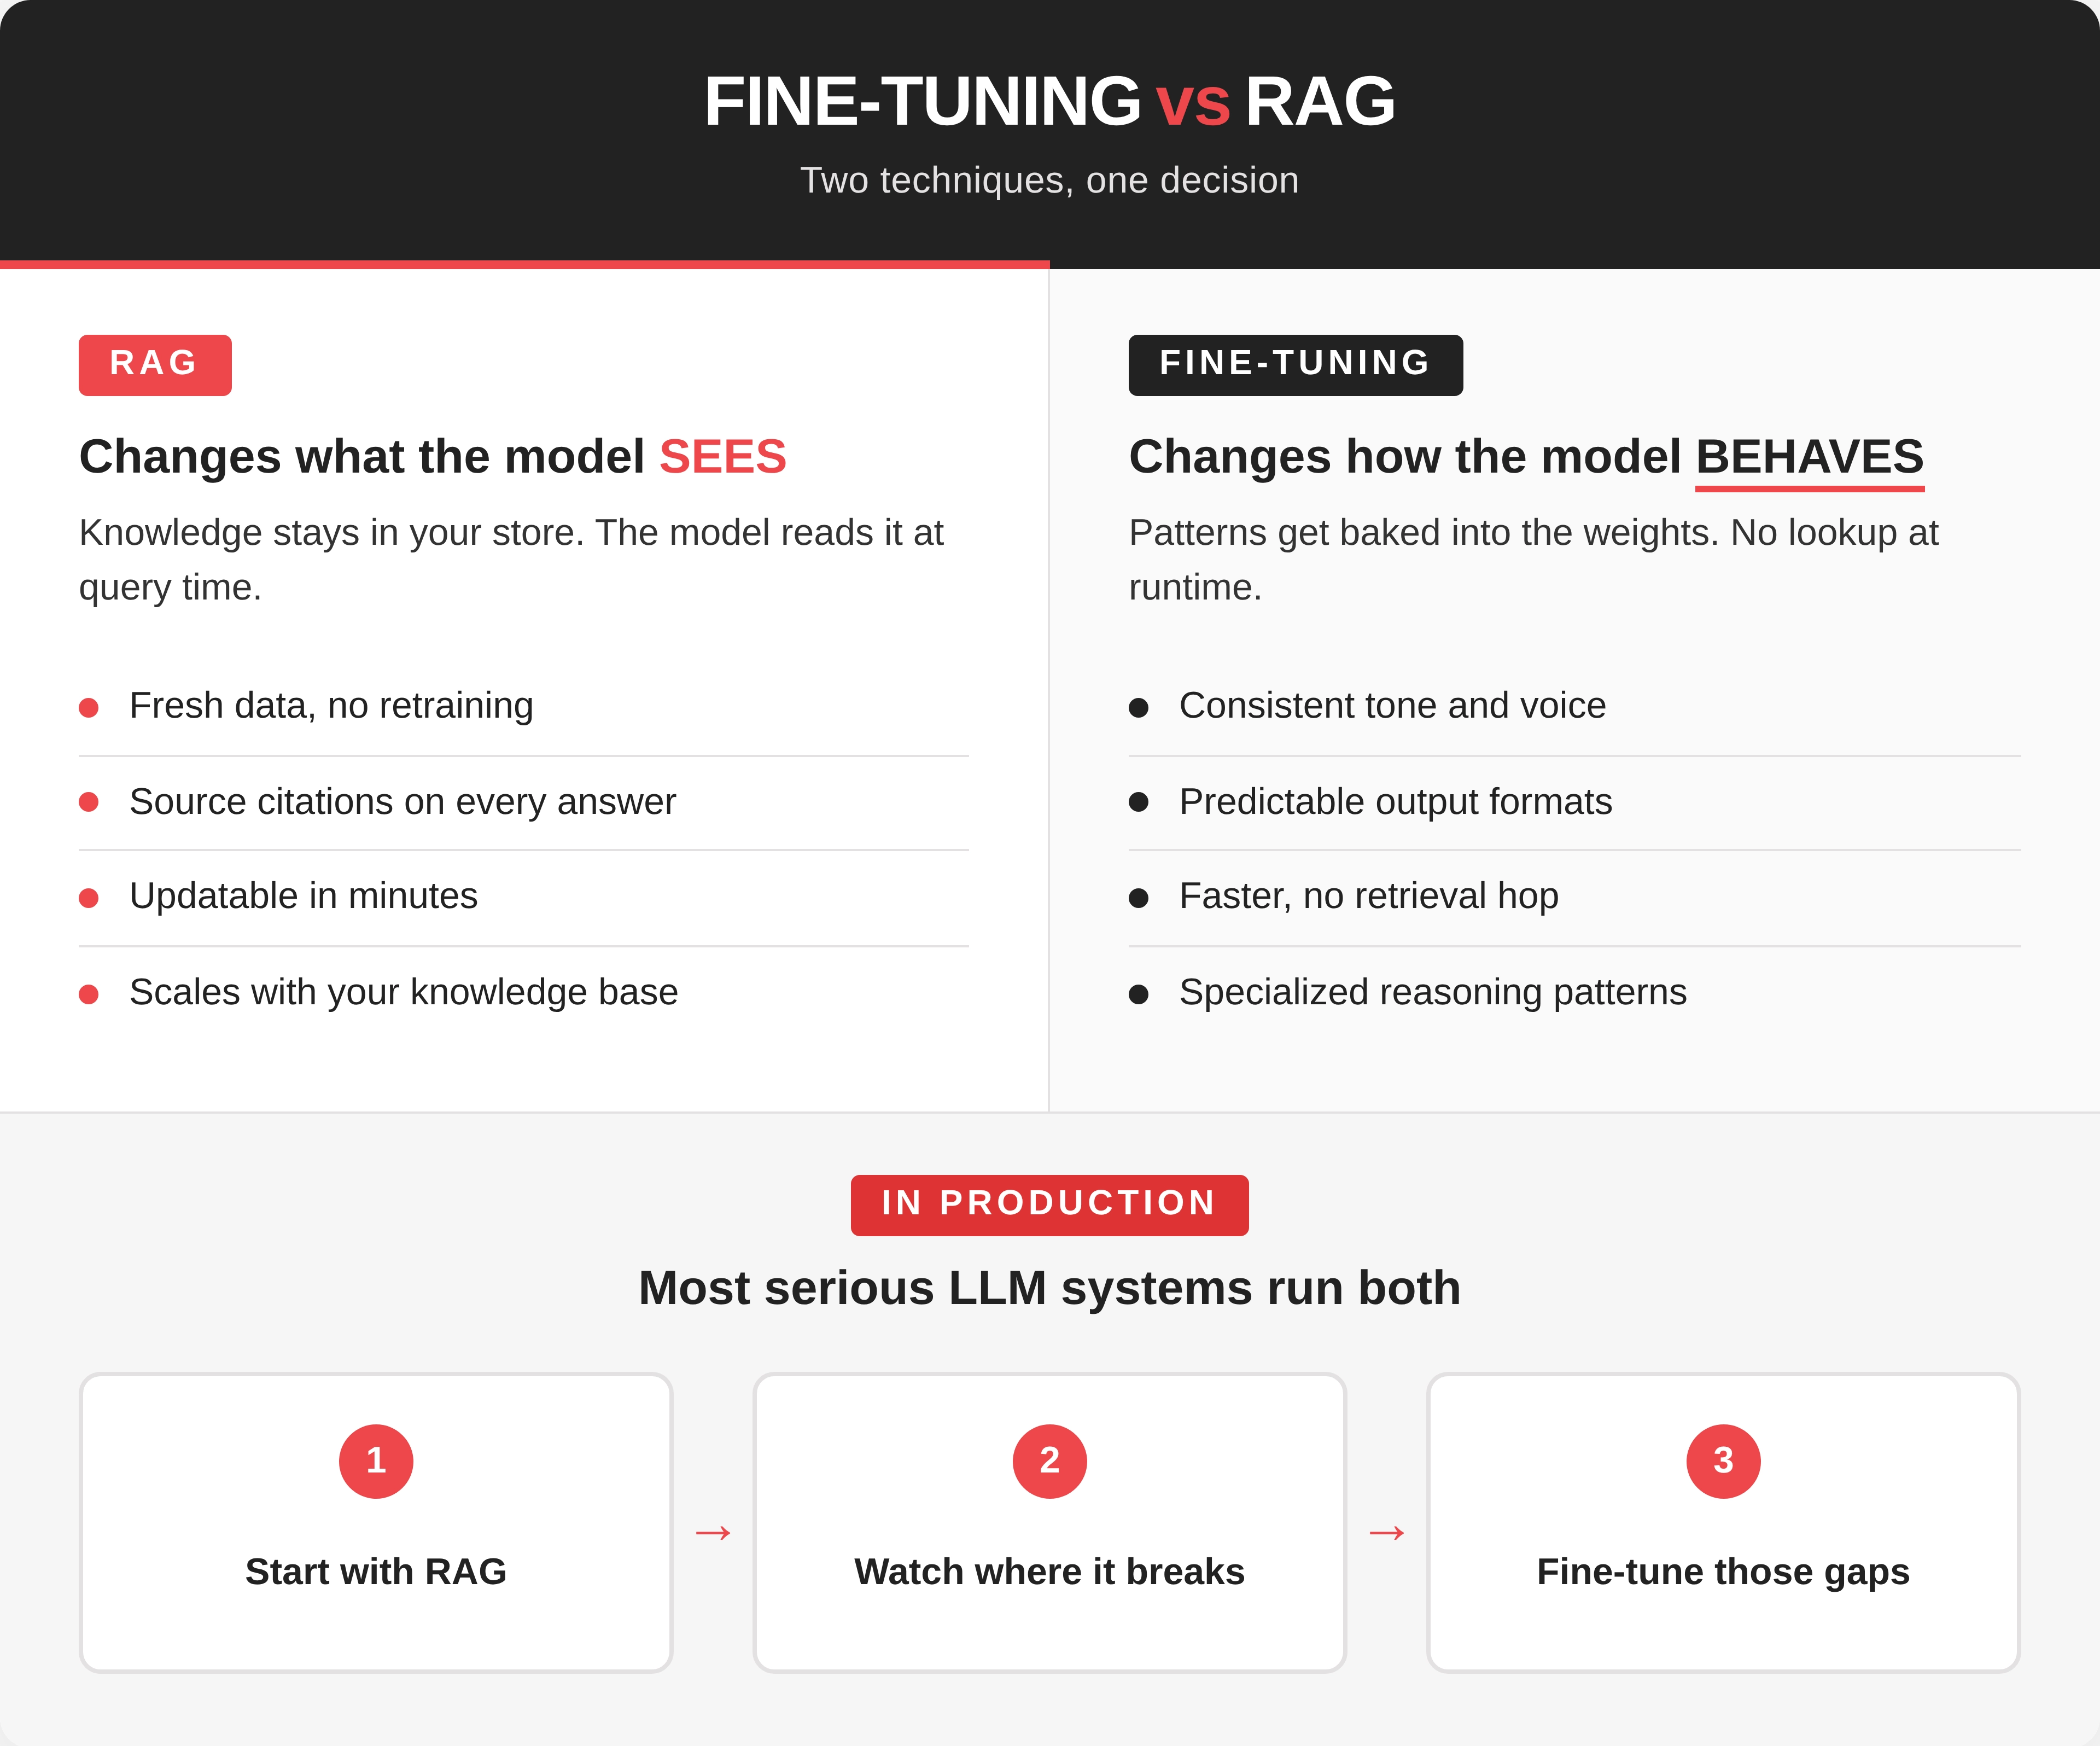
L’hybride est souvent rejeté comme un compromis. En production, c’est la règle, et les déploiements sérieux de LLM suivent généralement un chemin en trois étapes qui maintient le risque, le coût et la vitesse d’apprentissage dans des proportions raisonnables.
- Expédiez le RAG en premier, car il est plus rapide, moins cher à itérer, et révèle quelles parties du comportement du modèle se cassent réellement sous le trafic réel.
- Mesurez pendant quelques semaines, en recherchant les erreurs de ton, les formats de sortie incorrects et les lacunes de raisonnement qu’aucun prompting ne peut corriger.
- Fine-tunez uniquement ce que le RAG ne peut pas atteindre, ce qui correspond généralement à la voix, aux sorties structurées et aux modèles de raisonnement étroits.
Ce chemin étagé correspond également au compromis réel entre RAG et fine-tuning pour les LLM. Vous ne choisissez pas pour toujours dès le premier jour. Vous choisissez le point d’entrée le moins cher et le plus rapide, vous apprenez où ça fait mal, et vous investissez dans l’option la plus coûteuse uniquement là où elle en vaut la peine.
C’est pourquoi l’argument RAG vs fine-tuning est souvent une question piège. La vraie question est : lequel en premier, et la plupart du temps, c’est le RAG.
Trois erreurs qui font perdre des semaines
Certaines erreurs proviennent d’une mauvaise compréhension de la technologie. Celles-ci proviennent d’une mauvaise compréhension de vos propres contraintes. Attrapez-les avant que la technique ne soit figée et vous gagnerez des semaines de retravail.
Fine-tuner un modèle pour lui enseigner des faits
Le fine-tuning modifie le comportement, pas les connaissances. Les équipes qui font du fine-tuning sur un catalogue de produits regardent régulièrement le modèle halluciner des SKUs qui n’existent pas, citant avec confiance des spécifications d’une génération précédente. Pour les faits, utilisez le RAG. Point final.
Construire le RAG avant d'essayer le contexte long
Si votre base de connaissances complète tient en 200 000 tokens, les modèles modernes peuvent tout contenir dans le prompt avec mise en cache. Pas de base vectorielle, pas de saut de récupération, pas de pipeline à maintenir. Cas où le contexte long remplace silencieusement le RAG :
- Catalogues de produits de moins de 500 SKUs avec des métadonnées stables.
- Manuels de politique interne et documentation des employés.
- Corpus de recherche sur lesquels vous interrogez mais que vous étendez rarement.
- Contenu d’intégration et FAQ qui change trimestriellement, pas quotidiennement.
Testez cela avant de construire quoi que ce soit. C’est le moyen le plus rapide de mettre fin au débat sur la génération augmentée par récupération (RAG) vs fine-tuning pour votre projet avant même qu’il ne commence.
La plupart des échecs de projets d’IA remontent à une mesure inadéquate, pas au choix du modèle. Si vous ne pouvez pas mesurer la précision de la récupération et l’ancrage, vous n’expédiez pas, vous espérez. Un ensemble d’évaluation de 30 prompts, exécuté chaque semaine, attrape la plupart des régressions avant les utilisateurs.
Prendre la décision
La bonne réponse n’est pas RAG ou fine-tuning. C’est savoir par quoi commencer, quand ajouter l’autre, et quelle question arrêter de débattre.
Pour la plupart des équipes, cela signifie d’abord le RAG. Ajoutez le fine-tuning lorsque le RAG atteint sa limite en matière de ton, de format ou de raisonnement spécialisé. Mesurez tout, déployez par étapes, et ne retrainez pas un modèle pour lui enseigner un fait.
Si vous souhaitez un deuxième avis sur votre approche avant que la première ligne de code ne soit écrite, contactez-nous. Vingt minutes, pas de présentation, directement à la décision.
FAQ
Peut-on utiliser le RAG et le fine-tuning ensemble ?
Oui, et en production, vous devriez généralement le faire. Le modèle hybride, parfois appelé RAFT (retrieval-augmented fine-tuning), fait en sorte que le fine-tuning gère le ton et le format tandis que la récupération gère les faits. La plupart des systèmes LLM non triviaux finissent par y arriver.
Le RAG est-il meilleur que le fine-tuning ?
C’est la mauvaise question. Le RAG gère les connaissances qui changent. Le fine-tuning gère le comportement qui ne devrait pas. Ils résolvent des problèmes différents, et les deux appartiennent souvent à la même architecture.
Lequel est le plus facile à maintenir à long terme ?
Le RAG, tant que la qualité de la récupération se maintient. Les modèles fine-tunés nécessitent une cadence de ré-entraînement, tandis que le RAG nécessite une maintenance de l’index et un réglage des requêtes. Choisissez la charge de travail continue que votre équipe peut raisonnablement prendre en charge.
Découvrez comment Evolv a transformé une solution SaaS héritée en la première solution de croissance numérique basée sur l'IA, a stabilisé le pipeline de modèles et s'est développée auprès de clients d'entreprise.