
Lorsque nous entendons « Ruby », nous l’associons souvent à « Ruby on Rails ». Rails est un framework très fonctionnel et populaire, largement utilisé pour la création d’API et d’applications web. Rails est composé de gems indépendantes, et ActiveRecord en fait partie. Cette puissante gem simplifie les opérations avec les bases de données, permet de travailler avec elles de manière orientée objet et rend également Ruby on Rails extrêmement populaire auprès des développeurs.
Mais il existe de nombreux goulets d’étranglement dans l’utilisation d’ActiveRecord. De nombreux développeurs oublient souvent, ignorent ou ignorent simplement ces problèmes. Au début du développement d’un projet, cela n’affecte pas les performances de l’application, mais plus tard, cela peut devenir un véritable casse-tête.
Selon notre expérience, nous avons traité de nombreux grands projets incluant des bases de données avec de nombreuses tables, des relations simples et complexes. Dans l’un de ces projets, nous avons rencontré un problème : les requêtes vers un serveur entraînaient trop de requêtes vers une base de données. Et parallèlement aux opérations utiles, il y avait beaucoup de requêtes inutiles qui ralentissaient considérablement les performances.
Lorsque nous avons examiné pour la première fois le journal de la console, notre réaction fut un peu écrasante, et la résolution de tous ces problèmes aurait nécessité beaucoup de temps et d’efforts. Nous avons donc accepté le défi de nettoyer le système de ces requêtes, de réécrire certaines d’entre elles pour optimiser le temps d’exécution, de réorganiser le code et de faire « tout le nécessaire pour accélérer le système ».
Vous trouverez ci-dessous des erreurs typiques et des solutions qui nous ont aidés à atteindre nos objectifs.
Pour vous montrer la différence de vitesse d’exécution des requêtes, tous les exemples décrits dans cet article utilisent une structure de base de données simple que nous avons créée pour les tests. Elle contient quatre modèles : User, Hotel, Company, Country avec des colonnes typiques. Nous avons initialisé la base de données avec des données de test et ajouté 100 000 utilisateurs, 100 hôtels et 1 000 entreprises.
Nous utilisons également le module Benchmark de Ruby pour tester le temps d’exécution de nos exemples de code.
Commençons.
Requête N+1
L’erreur la plus facile et l’une des plus typiques, qui ralentit en réalité les performances globales du système. Bien que cela soit assez évident, nous avons décidé de mentionner ce problème, car les moyens de le résoudre peuvent également affecter le résultat.
À titre d’exemple, nous prenons un modèle User et un modèle Country. Le modèle User a la relation « belongs_to :country ».
Le résultat devrait être la liste des utilisateurs avec leurs pays.
users = User.limit(10)
users.each do |user|
puts “#{user.full_name} - > #{user.country.name}”
end
Lorsque vous commencez à travailler avec RoR, vous pensez d’abord que ce code est « Wow !!! C’est si simple et propre. Et ça marche ! ».
Mais regardons de plus près. À chaque itération de boucle, RoR appelle une requête SQL pour trouver le pays associé à l’utilisateur de l’itération actuelle. Ainsi, il appelle 1 requête pour charger les utilisateurs, et 10 requêtes pour charger les pays à chaque boucle.
Nous pouvons facilement optimiser ce problème en traitant la liste avec deux requêtes :
Users.includes(:country).each do |user|
puts “#{user.full_name} - > #{user.country.name}”
end
À ce stade, les chiffres peuvent sembler très petits, mais cette différence sera d’autant plus grande que vos volumes de données et la charge sur les serveurs seront importants.
Bien que cette erreur semble typique et facile, il est crucial de l’éviter. Vous pouvez trouver une description détaillée de ce problème dans la documentation officielle de Ruby on Rails.
Utiliser JOINS pour éviter la requête n+1
ActiveRecord dispose de la méthode JOINS. Lorsque nous l’utilisons, ActiveRecord joint la table passée dans la requête (ou, selon la syntaxe que vous utilisez, il ajoutera la chaîne JOINS passée à la requête). Généralement, JOINS est utilisé pour ajouter des clauses aux requêtes.
Comme ceci :
staff = User.joins(:hotel).where("hotels.name like '%Rixos%'")
Vérifions à quoi ressemblent les résultats de la requête :
staff.each do |user|
puts “#{user.full_name} - > #{user.hotel.name}”
end
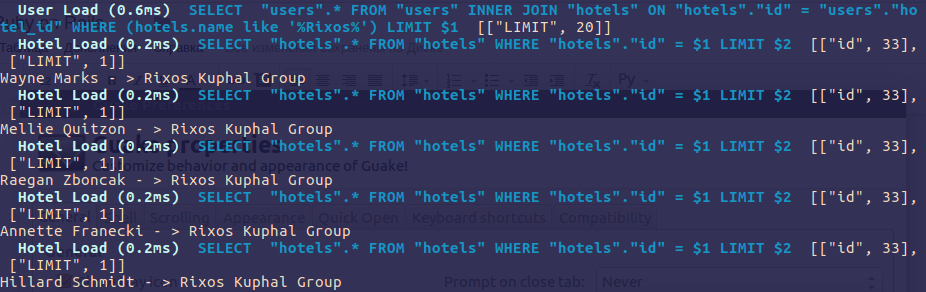
Regardez les journaux : JOINS ne charge pas les relations et il est utilisé uniquement pour filtrer les données d’une table associée. En utilisant ce code, nous revenons au **problème n+1** décrit ci-dessus.
Utiliser INCLUDES au lieu de SELECT+JOINS
Lorsque vous chargez des enregistrements et des relations, vous n’avez souvent besoin que d’un ou deux champs d’une ou plusieurs tables associées.
users = User.includes(:hotel).limit(20)
users.each do |user|
puts "#{user.full_name} - > #{user.hotel.name}"
end
Le problème réside dans le fait que Rails alloue de la mémoire pour chaque champ chargé. Dans certains cas, la table associée contient de nombreuses colonnes et stocke beaucoup de données. Alors pourquoi charger ces données inutiles si vous n’avez besoin que d’un seul champ (comme dans l’exemple) ? Vous pouvez réécrire le code comme suit :
users = User.select('users.*, hotels.name as hotel_name').joins(:hotel).limit(20)
users.each do |user|
puts "#{user.full_name} - > #{user.hotel_name}"
end
COUNT/SIZE/LENGTH sur les objets chargés
L’une des tâches de base est d’afficher un nombre d’enregistrements. Il existe trois méthodes différentes pour le faire : COUNT, SIZE, LENGTH.
Et toutes ces méthodes fonctionnent différemment :
- LENGTH charge tous les enregistrements de la base de données (s’ils n’ont pas encore été chargés) et calcule leur taille.
- COUNT exécute une requête SQL pour calculer le nombre d’enregistrements dans la base de données.
- SIZE vérifie si les enregistrements ont été chargés – appelle la méthode LENGTH pour la portée, sinon exécute une requête SELECT COUNT(*).
Donc, si vous êtes absolument certain de ne pas avoir besoin d’une liste d’enregistrements limités, vous devriez plutôt utiliser COUNT. Si vous ne savez pas si les données seront chargées ou non, utilisez la méthode SIZE. Cela vous évitera des requêtes excessives.
De plus, nous aimerions partager une petite astuce avec vous. Imaginez que vous avez une portée (scope) et que vous savez que vous devez charger des données de cette portée et calculer son nombre. Mais nous voulons d’abord obtenir le nombre d’enregistrements.
users = User.where(hotel_id: 1)
users_count = users.size
users.each do |user|
puts “#{user.full_name}”
end
Voici les journaux d’exécution :
SELECT COUNT(count_column) FROM (SELECT  1 AS count_column FROM "users"
WHERE "users"."hotel_id" = 1) subquery_for_count
SELECT  "users".* FROM "users" WHERE "users"."hotel_id" = 1
Mais vous pouvez en fait le faire avec une seule requête, plus optimisée. Tout ce que vous avez à faire est d’ajouter la méthode LOAD à la portée. Les enregistrements limités seront chargés immédiatement et la méthode SIZE n’exécutera pas de requête SQL supplémentaire.
users = User.where(hotel_id: 1).load
users_count = users.size
users.each do |user|
puts “#{user.full_name}”
end
Avec ce code, il n’y aurait qu’une seule requête dans les journaux :
SELECT "users".* FROM "users" WHERE "users"."hotel_id" = 1
Cette astuce est pertinente dans les situations où nous chargeons des données limitées dans tous les cas, et n’ajoutons pas de portées supplémentaires en dessous.
Utiliser les calculs côté Ruby
Une autre tâche populaire consiste à afficher des informations complexes sur un utilisateur, qui ne peuvent pas être chargées depuis la base de données dans la condition où elles sont stockées.
Par exemple, prenons deux modèles – *User et Company* avec des associations beaucoup-à-beaucoup. De plus, le modèle *User* appartient au modèle *Hotel*. Nous voulons afficher le nombre d’utilisateurs uniques par hôtel pour chaque entreprise.
Vous pouvez le calculer en Ruby comme ceci :
companies = Company.includes(:users).limit(100)
companies.each do |company|
puts company.users.map(&:hotel_id).uniq.count
end
Et nous pouvons faire les mêmes calculs, mais en traitant le compte côté SQL :
companies = Company.limit(100)
.select('companies.*, companies_hotels.hotels_count as hotels_count')
.joins('
INNER JOIN (
SELECT companies_users.company_id,
COUNT(DISTINCT users.hotel_id) as hotels_count
FROM users
INNER JOIN "companies_users" ON "users"."id" = "companies_users"."user_id"
GROUP BY companies_users.company_id
) as companies_hotels ON companies_hotels.company_id = companies."id"
')
companies.each do |company|
puts company[:hotels_count]
end
L’augmentation des performances apparaît car tous les calculs sont effectués côté SQL, et vous ne chargez pas de données inutiles depuis la base de données.
Abus de rappels ActiveRecord
Un rappel (callback) dans les modèles ActiveRecord est un outil très puissant qui aide à gérer le comportement des entités. Mais une surutilisation des rappels peut considérablement ralentir le système.
Lorsque nous ajoutons un rappel à un modèle, il est déclenché pour chaque événement (lié à ce rappel), mais certains appels peuvent être redondants. Ils n’effectuent aucune action utile et peuvent, par exemple, exécuter des requêtes SQL inutiles, effectuer des calculs inutiles, etc. Ainsi, lorsque vous ajoutez un rappel à un modèle, vous devez d’abord vous demander si ce rappel est vraiment nécessaire pour chaque exécution d’événement.
Pour éviter cette situation, vous pouvez déplacer le code des rappels dans des méthodes ou des classes et les exécuter uniquement lorsque cela est vraiment nécessaire. Cela nettoie et accélère réellement votre système.
Résumé
Comme vous pouvez le voir, il existe de nombreuses approches pour implémenter des tâches de base avec Ruby on Rails, mais toutes ne sont pas utiles. Choisir les bonnes solutions accélérera sans aucun doute votre application et vous évitera des optimisations douloureuses ultérieures.
Pour ceux qui préfèrent s’appuyer sur des services innovants, il existe un excellent outil qui aide à prévenir certaines des erreurs décrites ci-dessus. Il s’appelle Bullet et vous pouvez le trouver ici : https://github.com/flyerhzm/bullet
À propos de Redwerk
Si vous recherchez des développeurs externes compétents, Redwerk est l’endroit idéal. Nous offrons des services de développement logiciel en externalisation de haute qualité, basés sur notre vaste expérience de travail avec différents langages de programmation et technologies. Que vous ayez besoin de création de base de données ou de services de développement Ruby on Rails, notre équipe sera ravie de s’impliquer et de faire partie de votre projet. Nous sommes également reconnus comme l’une des meilleures entreprises Ruby on Rails sur DesignRush.


