
La première partie de cet article a présenté un exemple de création de modèle et nous a familiarisés avec les étapes les plus importantes de l’apprentissage automatique (ML) : préparation des données, sélection des caractéristiques, entraînement du modèle (sélection des paramètres du modèle) et évaluation finale des résultats (AUC, Précision, Rappel, etc.).
Examinons maintenant un exemple concret d’utilisation de Studio pour résoudre un problème pratique d’apprentissage automatique. Ce projet a été mis en œuvre avec succès et est déjà utilisé pour des prédictions basées sur du texte de CV/opportunités.
La première chose que nous devons réaliser en apprentissage automatique, ce sont les données. Toutes les données nécessaires à l’entraînement sont stockées dans Azure Document DB (Cosmos DB). Pour améliorer le processus de préparation des données et l’entraînement futur, nous récupérons les données et les stockons dans un jeu de données dans Azure ML Studio.
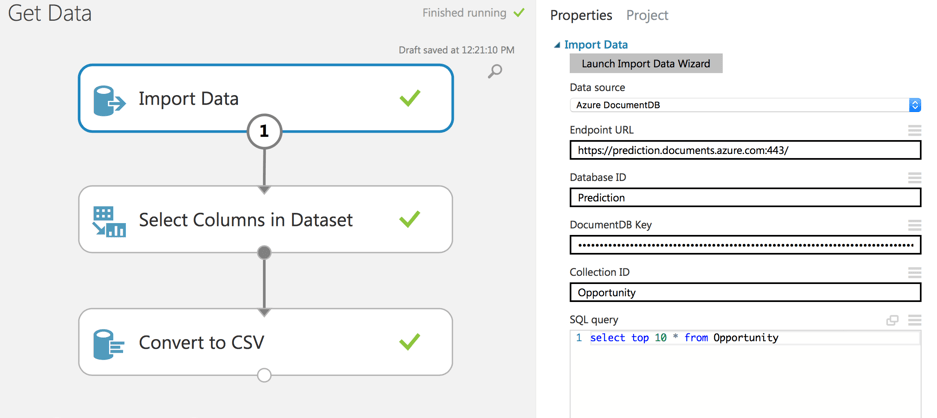
Une fois l’importation terminée, nous pouvons la visualiser.
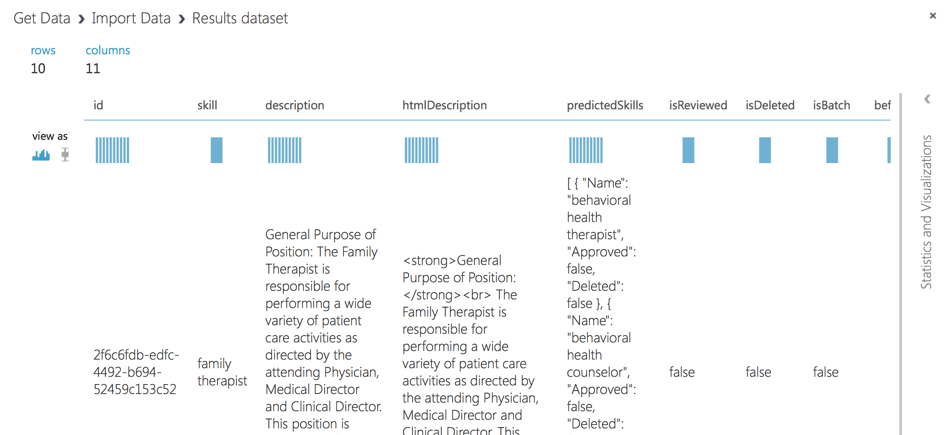
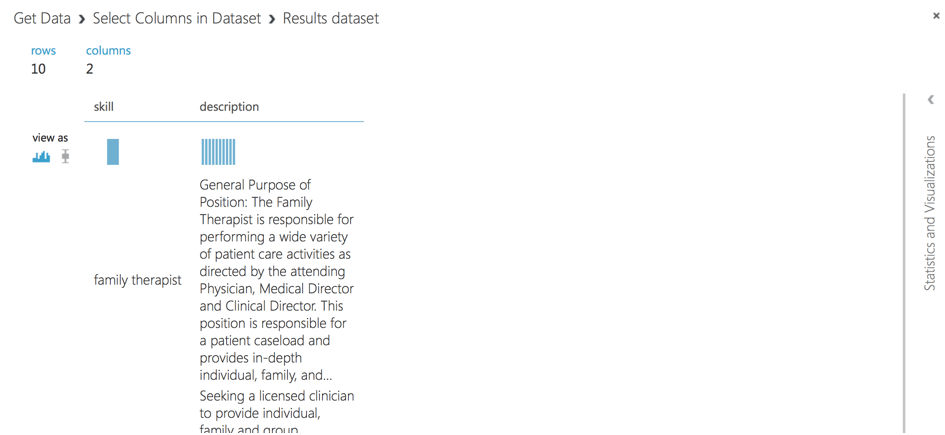
De plus, comme Document DB contient des champs supplémentaires, nous devons sélectionner des champs spécifiques tels que la compétence, la description…
Comme étape finale, nous stockons le jeu de données au format .csv dans le stockage Azure ML Studio.
Un jeu de données nécessite généralement un prétraitement avant de pouvoir être analysé. Par exemple, nous aurions pu remarquer la présence de valeurs manquantes dans les colonnes de diverses lignes. Ces valeurs manquantes doivent être nettoyées pour que le modèle puisse analyser correctement les données. Dans ce cas, nous supprimerons toutes les lignes contenant des valeurs manquantes. Ensuite, nous nettoyons le texte à l’aide du module Prétraiter le texte. Le nettoyage réduit le bruit dans le jeu de données, vous aide à trouver les caractéristiques les plus importantes et améliore la précision du modèle final. Nous supprimons les mots vides (stop words) – mots courants tels que “le” ou “un”, les nombres, les caractères spéciaux, les caractères dupliqués, les adresses e-mail et les URL. Nous convertissons également le texte en minuscules, lemmatisons les mots et détectons les limites de phrases qui sont ensuite indiquées par le symbole “|||” dans le texte prétraité.
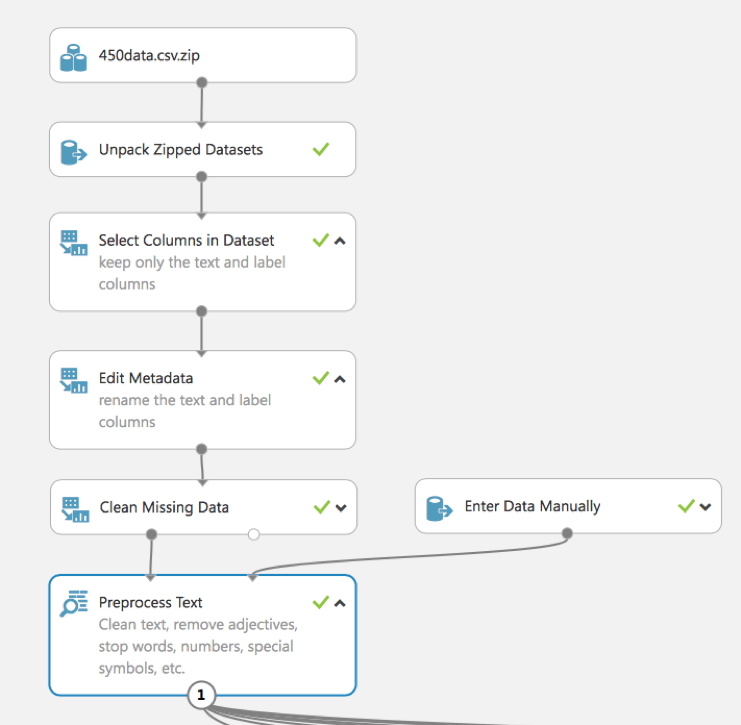
Comme nous le voyons, dans cette expérience (contrairement à l’exemple de la partie 1), le module intégré Prétraiter le texte (auparavant nous avions montré l’utilisation d’un script R) est utilisé. Il nous permet de nettoyer le texte, de supprimer les mots vides, les nombres, les symboles spéciaux, etc.
L’objectif principal de cette étape est de recevoir un texte nettoyé (description d’opportunité) sans mots vides, nombres, e-mails, URL, etc. Par exemple, voici une description avant le prétraitement :
General Purpose of Position: The Family Therapist is responsible for performing a wide variety of patient care
activities as directed by the attending Physician, Medical Director andClinical Director. This position is
responsible for a patient caseload and provides in-depth individual, family, and group counseling. Counseling
includes the ongoing completion of psychosocial and bio-psychosocial assessments. The Family Therapist collaborates
with the Clinical Team to develop individualized treatment plans and assists in coordinating discharge planning.
This position follows patients' progress from a psychological standpoint, beginning with admittance through
discharge. During this time, the Family Therapist maintains frequent and open communication with the Clinical
Director and Therapists regarding any issues or problems. Primary Responsibilities (include but are not limited to):
Establish individualized family therapy programs, through face to face and/or phone communication with families of
Sunspire Health patients. Conduct and evaluate family assessments...
Et après :
purpose ||| therapist perform variety care activity as direct physician | director director ||| caseload | depth |
family | group counsel ||| counsel include completion bio | assessment ||| family therapist collaborate develop
treatment plan assist discharge plan ||| follow patient | progress standpoint | begin admittance discharge ||| |
therapist maintain communication director therapist issue problem ||| | include but limit | ||| | establish therapy
program | face face | or communication family sunspire health patient ||| | conduct evaluate assessment ||| |
conduct family counsel session patient ||| | referral resource patient | family area ||| | coordinate patient |
family patient treatment plan discharge | aftercare plan ||| | basis | coordinate lead retreat consist group therapy
| lecture question answer period | facility | finalization discharge aftercare plan ||| | participate | site
activity that relate therapy ||| | create group group sunspire health facility | focus system issue recovery ||| |
maintain documentation family counsel activity ||| | may ask complete review | utilization review | as ||| | |
college or university psychology | | or field ||| | health set ||| family therapist | | maintain licensure | lcs w |
lmh c | lmf t | aarn p. | acquire licensure ||| |license proof insurance ||| | maintain cp r aid certification ||| |
strong ||| | detail ||| | pressure as as ||| | strong | ||| | structure english language mean spell word | rule
composition | grammar ||| | principle process service ||| include assessment| standard service | evaluation
satisfaction ||| | behavior performance | difference | personality | | learn motivation | research method |
assessment treatment disorder ||| | patient | patient service resolve issue ||| | acumen ||| | car f standard ||| |
problem review develop evaluate option implement solution ||| | logic reason identify strength weakness solution |
conclusion or approach problem ||| | cost benefit action choose ||| | handle priority urgency ||| | communication | |
presentation ||| | | people ||| as||| | other | reaction | understand react ||| as | adjust action relation other |||
| bring other try reconcile  difference||
Pour construire un modèle pour des données textuelles, nous devons généralement convertir du texte libre en vecteurs de caractéristiques numériques. Dans notre expérience, nous utilisons le module Extraire des caractéristiques N-grammes à partir du texte pour transformer les données textuelles dans ce format. Ce module prend une colonne de mots séparés par des espaces et calcule un dictionnaire de mots, ou de N-grammes de mots, qui apparaissent dans votre jeu de données. Ensuite, il compte combien de fois chaque mot, ou N-gramme, apparaît dans chaque enregistrement et crée des vecteurs de caractéristiques à partir de ces comptages. Dans notre expérience, nous avons défini la taille des N-grammes à 2, de sorte que nos vecteurs de caractéristiques incluent des mots uniques et des combinaisons de deux mots consécutifs.
Nous appliquons la pondération TF-IDF (Term Frequency Inverse Document Frequency) aux comptages de N-grammes. Cette approche ajoute le poids des mots qui apparaissent fréquemment dans un enregistrement unique, mais sont rares sur l’ensemble du jeu de données. D’autres options incluent la pondération binaire, TF et graphique.
De telles caractéristiques textuelles ont souvent une grande dimensionnalité. Par exemple, si votre corpus contient 100 000 mots uniques, votre espace de caractéristiques aura 100 000 dimensions, ou plus si des N-grammes sont utilisés. Le module Extraire des caractéristiques N-grammes vous offre un ensemble d’options pour réduire la dimensionnalité. Vous pouvez choisir d’exclure les mots trop courts ou trop longs, ou trop rares ou trop fréquents pour avoir une valeur prédictive significative. Dans notre expérience, nous excluons les N-grammes qui apparaissent dans moins de 5 enregistrements.
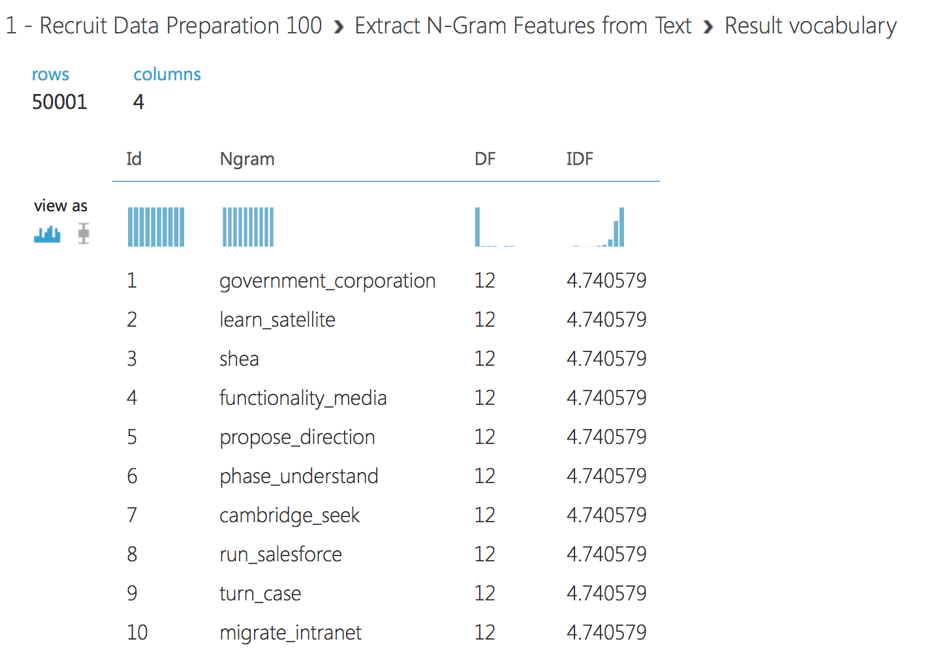
De plus, nous utilisons la sélection de caractéristiques pour obtenir uniquement les valeurs les plus corrélées à notre prédiction cible. Nous utilisons la sélection de caractéristiques Chi-Carré pour choisir 50000 caractéristiques. Nous pouvons visualiser le vocabulaire des mots ou N-grammes sélectionnés en cliquant sur la sortie droite du module Extraire des N-grammes.
Nous utilisons le module Réseau neuronal multiclasse pour créer un modèle de réseau neuronal qui peut être utilisé pour prédire une cible ayant plusieurs valeurs. Nous utilisons également le module Ajuster les hyperparamètres du modèle pour construire et tester des modèles en utilisant différentes combinaisons de réglages, afin de déterminer les hyperparamètres optimaux pour la tâche de prédiction et les données données.
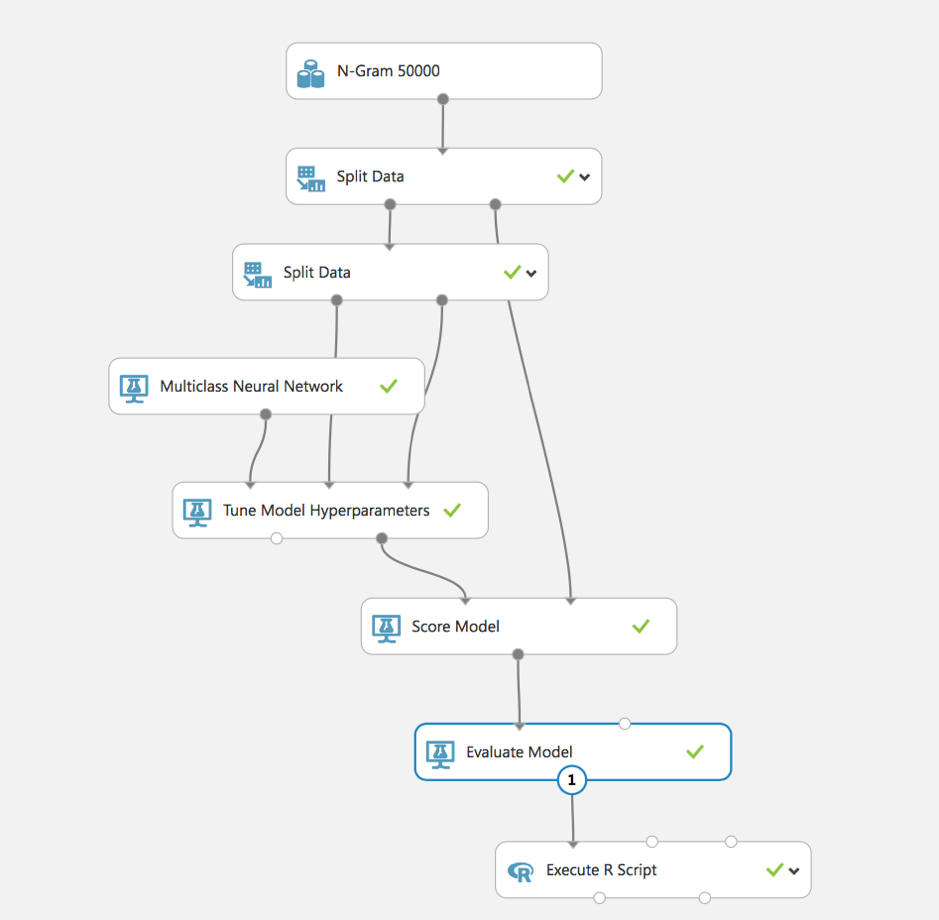
Dans un premier temps, nous divisons les données pour l’entraînement et le jeu de données de score, ce qui signifie que nous sélectionnons une partie des données qui ne sera pas incluse dans le processus d’entraînement mais qui sera utilisée comme données de test pour le calcul de la précision.
Dans la deuxième étape, nous divisons également le jeu de données d’entraînement pour Ajuster les hyperparamètres du modèle. Après cela, nous configurons le modèle principal de notre expérience : le Réseau neuronal multiclasse.
Après l’entraînement, nous pouvons scorer et évaluer le modèle pour analyser la précision obtenue.
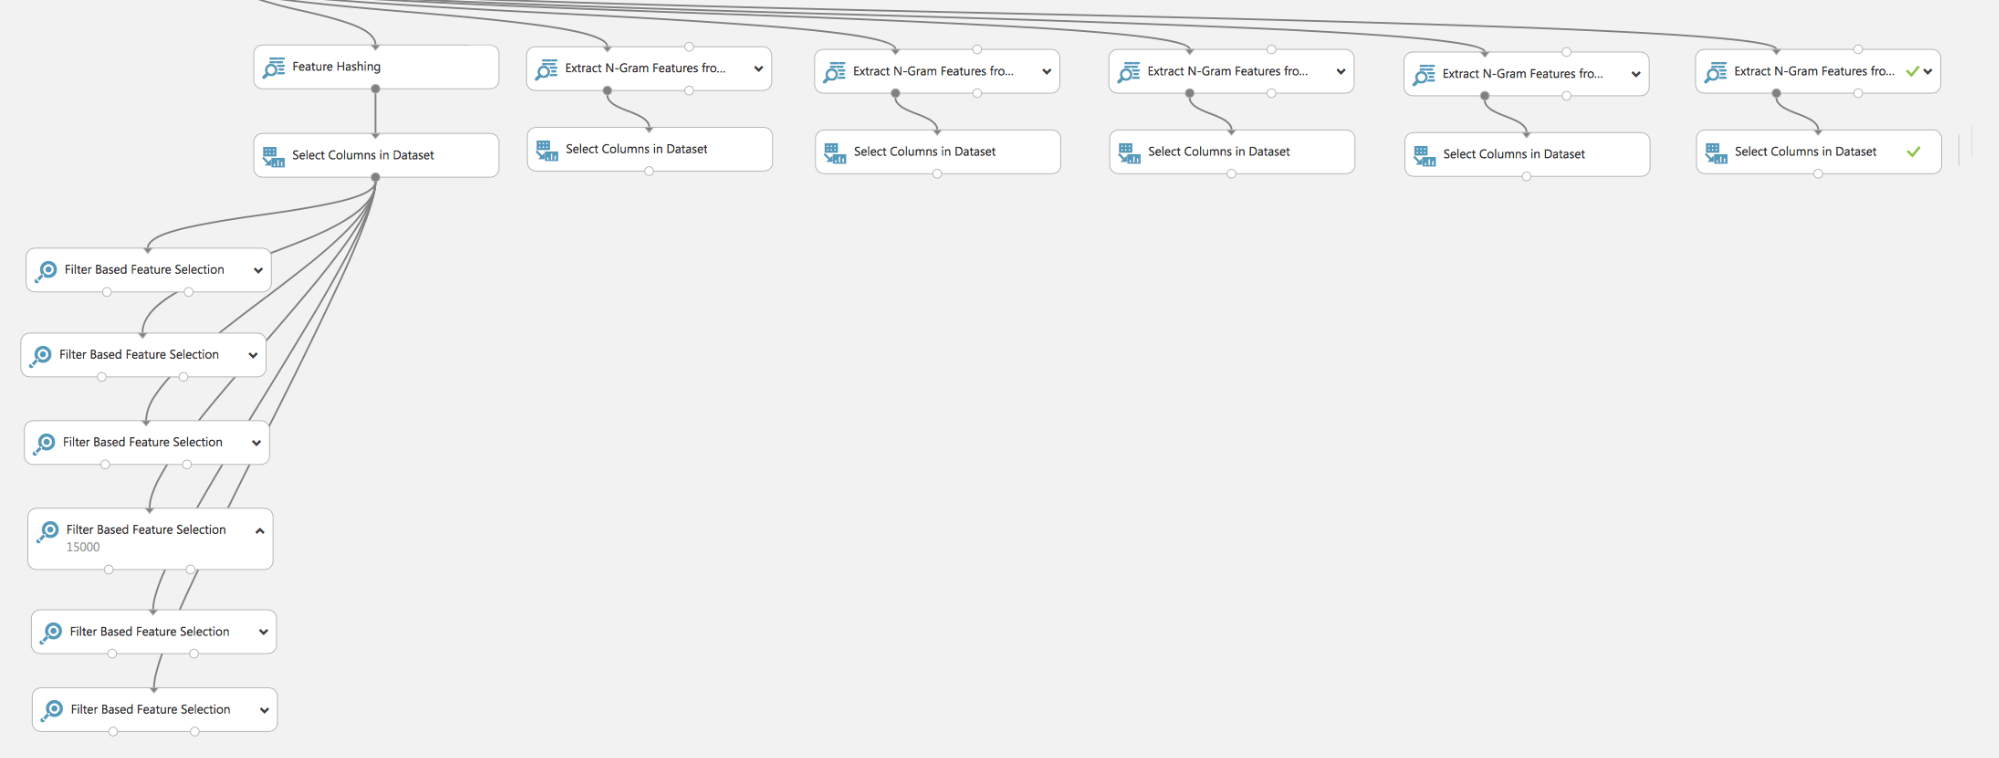
Comme nous le voyons, en quelques étapes assez simples, nous avons construit un modèle pour résoudre un problème pratique. Bien sûr, certaines étapes ont été omises, par exemple, la recherche de la méthode de traitement de texte optimale TF / TF-IDF et de ses paramètres :
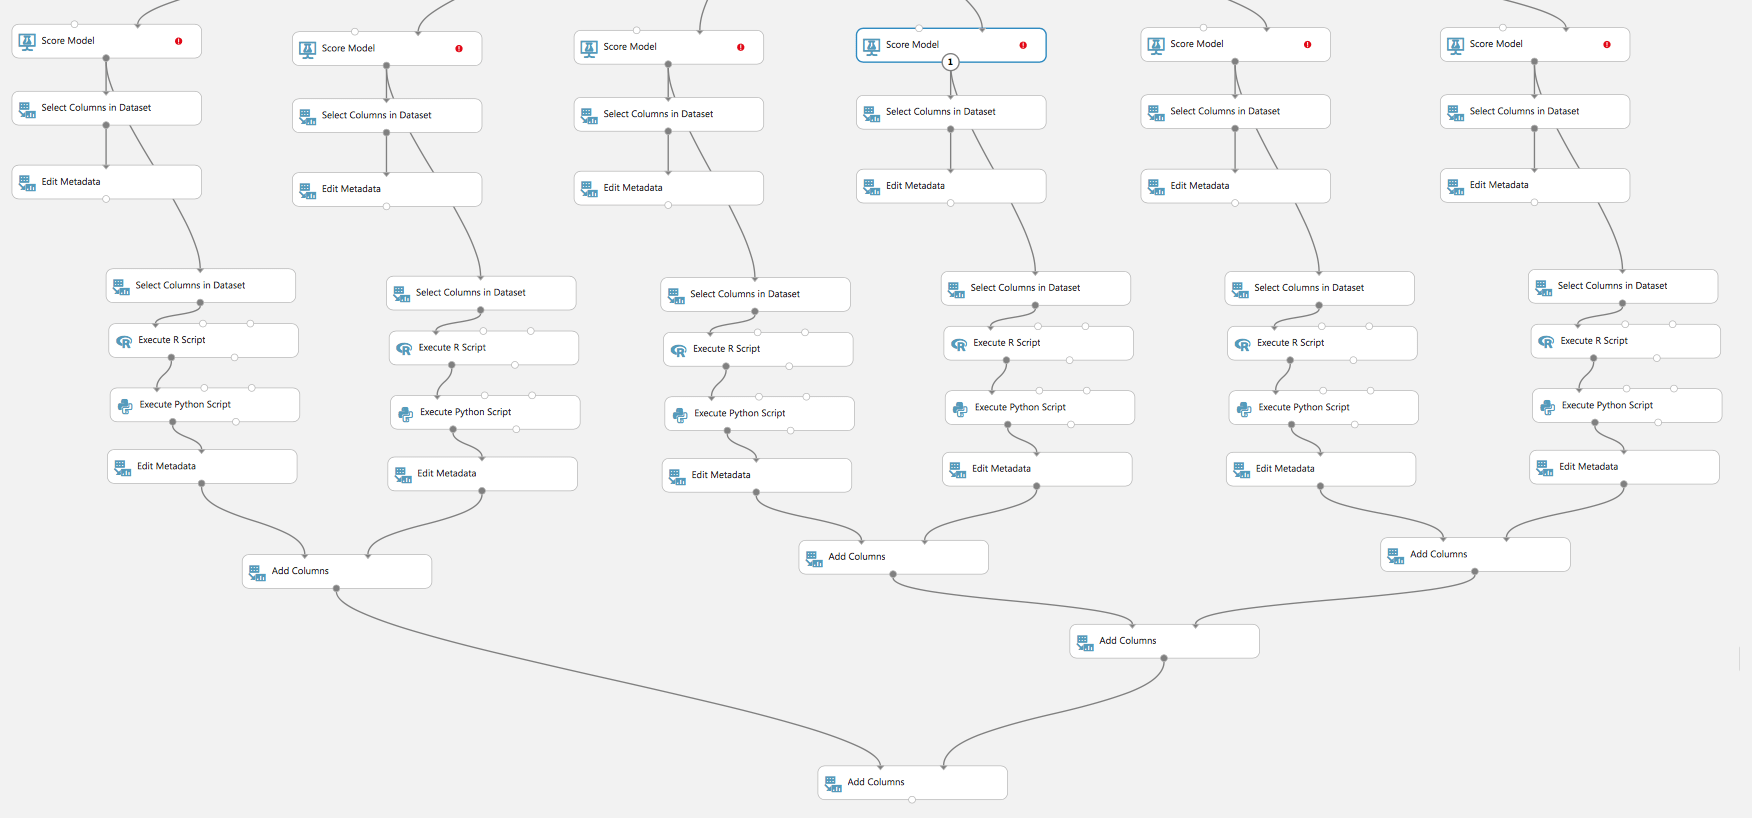
Ou la comparaison de la qualité de différents modèles :
Dans cet article, nous avons essayé de montrer un exemple d’utilisation du ML et d’Azure ML Studio pour résoudre un problème pratique. Bien sûr, nous l’avons montré brièvement – car le développement de modèles pour le traitement du langage naturel (NLP) est un sujet pour un livre entier, et l’article pourrait se transformer en manuel de ML, NLP, Azure ML Studio.
Mais l’essentiel est que nous avons prouvé qu’il est possible de construire de tels modèles simplement et rapidement, en ayant des connaissances initiales en ML ; l’outil démontré, Azure ML Studio, le permet.
Bien sûr, nous n’avons pas couvert tous les aspects du ML et de ML Studio, nous n’avons pas considéré d’autres types de modèles, nous n’avons pas montré comment sélectionner efficacement les paramètres des modèles – des régressions logistiques simples aux réseaux neuronaux. Nous n’avons pas montré comment construire des réseaux neuronaux avec différents types de fonctions d’activation et des réseaux multicouches. Tout cela pourra être abordé dans le prochain article.
À propos de Redwerk
Redwerk est une société de développement de produits logiciels en externalisation, spécialisée dans la fourniture de solutions informatiques complètes pour les entreprises de toutes tailles. Nos secteurs de prédilection sont le commerce électronique, l’automatisation des processus métier, la santé numérique, les médias et le divertissement, le e-gouvernement, le développement de jeux, les startups et l’innovation. L’un des points forts que nous avons acquis au fil d’une longue expérience professionnelle est d’apporter les avantages des technologies cloud aux entreprises. Nous optimisons les flux de travail et utilisons la meilleure boîte à outils à cette fin : le service de développement d’applications Azure. Pour libérer la puissance des capacités numériques de pointe, embauchez une équipe dédiée que nous avons minutieusement constituée au fil des ans pour devenir le dépannage des problèmes quotidiens et stratégiques des entreprises.


