
L’apprentissage automatique est appliqué à un large éventail de tâches commerciales, de la détection de fraudes à la sélection du public cible et aux recommandations de produits, en passant par la surveillance de la production en temps réel, l’analyse de la tonalité des textes et le diagnostic médical. Il peut prendre en charge les tâches qui ne peuvent pas être effectuées manuellement en raison de l’énorme quantité de données à traiter. Dans le cas d’un grand ensemble de données, l’apprentissage automatique révèle parfois des dépendances non évidentes qui ne peuvent être détectées par un examen manuel rigoureux arbitraire. Dans ce cas, la combinaison de l’ensemble de telles «relations faibles» donne des mécanismes de prévision parfaitement fonctionnels.
Le processus d’apprentissage à partir des données et l’application ultérieure des connaissances pour justifier les décisions futures constituent un outil extrêmement puissant. L’apprentissage automatique se transforme rapidement en moteur d’une économie moderne axée sur les données.
Ces dernières années, l’apprentissage automatique («ML») est devenu une activité commerciale majeure : les entreprises l’utilisent pour gagner de l’argent. La recherche appliquée se développe rapidement dans les milieux industriels et universitaires, et les développeurs curieux du monde entier recherchent une opportunité d’améliorer leur niveau d’expérience dans ce domaine. Néanmoins, la demande émergente dépasse largement la vitesse d’apparition de bonnes techniques et d’outils.
Dans ce billet, nous aimerions décrire comment vous pouvez utiliser Microsoft Azure Machine Learning Studio pour créer des modèles d’apprentissage automatique, ainsi que les problèmes que vous pourriez rencontrer lors de l’utilisation d’Azure ML et comment les résoudre.
Outils et bases
Machine Learning Studio vous permet de créer rapidement des modèles, de les entraîner et de choisir ceux qui conviennent le mieux à votre tâche. L’énorme avantage de cette plateforme est sa rapidité de prise en main, ce qui est positif pour les débutants en ML. Mais pour les développeurs expérimentés, la plateforme offre de nombreuses opportunités, du cloud computing (qui permet de traiter de grandes quantités de données) à la facilité de déploiement du modèle entraîné en tant que service Web.
Vous pouvez facilement explorer la plateforme ou même le ML en général en utilisant un compte Microsoft gratuit. Cela impose certaines limitations, mais vous permet de vous familiariser avec le système. De plus, un compte gratuit convient pour créer des modèles pour de petites quantités de données.
Faisons connaissance avec la plateforme elle-même. Commencez par créer un compte dans Azure Machine Learning Studio et examinez le menu :
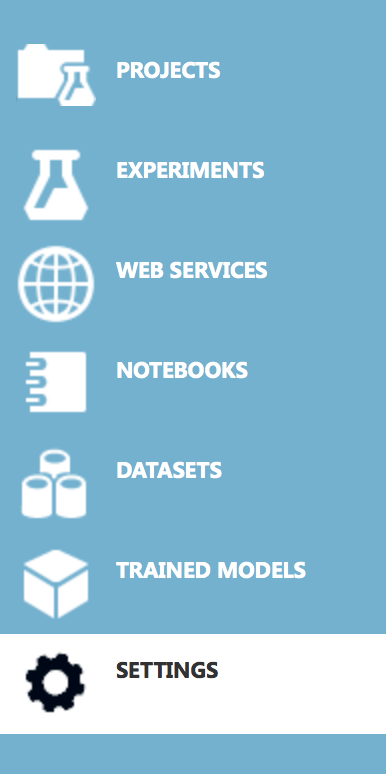
Ici, nous avons plusieurs onglets :
- Projets – représentent des groupes d’expériences
- Expériences – similaires aux notebooks ipython
- Services Web
- Notebooks – notebooks ipython
- Données sauvegardées
- Modèles
- Paramètres
Faites attention à l’onglet Paramètres :
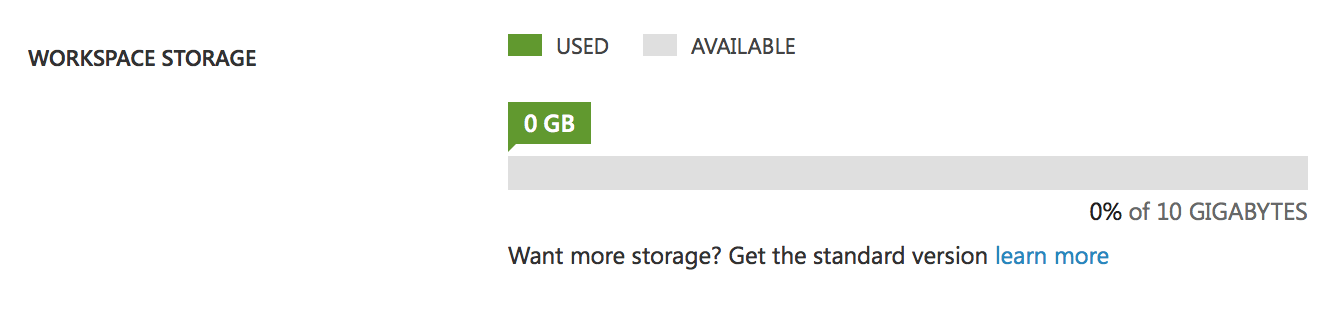
C’est notre espace de stockage pour les données, les modèles et les expériences. 10 Go de stockage est l’une des limitations du compte gratuit. Il peut sembler que ce soit suffisant, mais rappelez-vous que Studio stocke toutes les données intermédiaires des expériences, c’est-à-dire que si vous avez une expérience avec un volume de données de 1 Go, alors après plusieurs modifications ou le lancement de l’expérience, votre disque sera plein et vous devrez effacer les données intermédiaires. Dans un compte payant, cette restriction n’existe pas, vous aurez un disque quasi infini. De plus, il y a une autre différence entre les comptes : le compte gratuit ne peut exécuter qu’une seule expérience à la fois, c’est-à-dire que vous n’aurez qu’un seul fil d’exécution, tandis que le compte Premium offre la possibilité d’exécuter de nombreuses expériences simultanément ou de créer des processus parallèles au sein d’une même expérience.
Créer votre première expérience
Créons une expérience et familiarisons-nous avec le processus de construction d’un modèle.
Sélectionnez – ajoutez l’expérience et trouvez un exemple de classification de texte.
Studio créera une expérience et téléchargera automatiquement les données.
Voici notre première expérience :
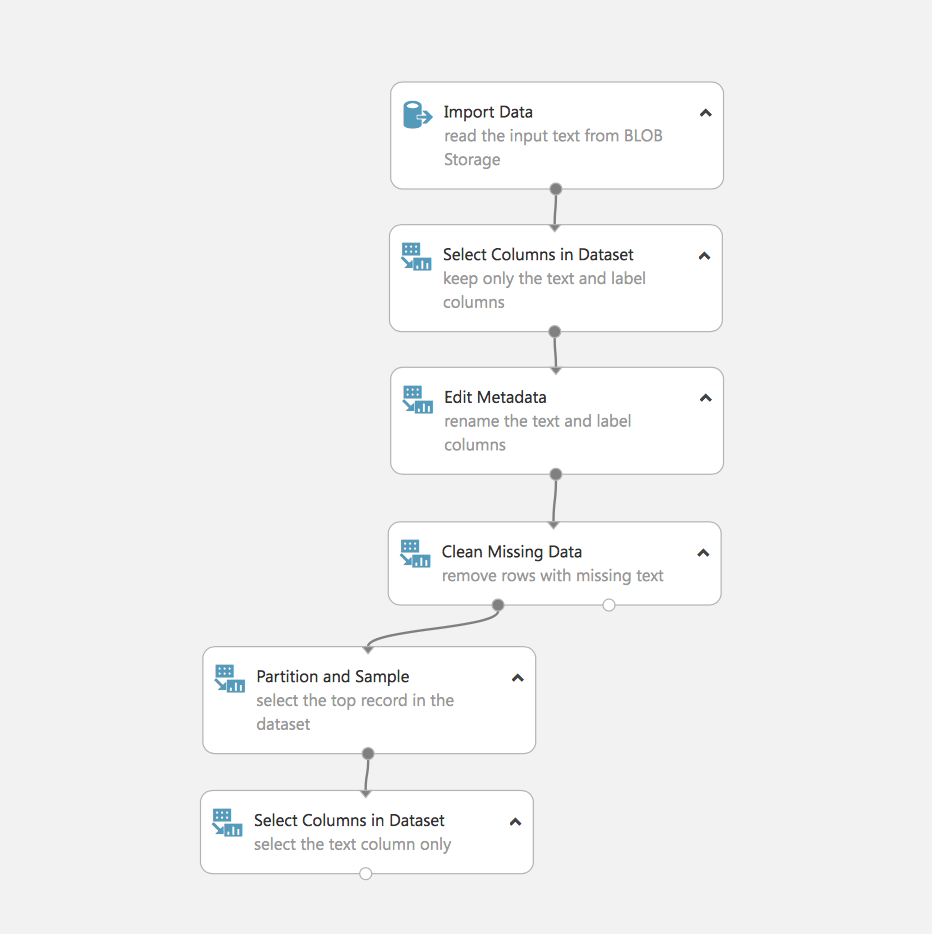
Voyons ce qui se passe ici. En fait, nous voyons la première tâche à laquelle le ML doit faire face : le traitement et la préparation des données.
- Chargement des données (dans notre cas, elles sont stockées dans Azure Blob)
- Sélection des champs requis
- Modification des métadonnées
- Suppression des données avec des champs manquants
- Division des données
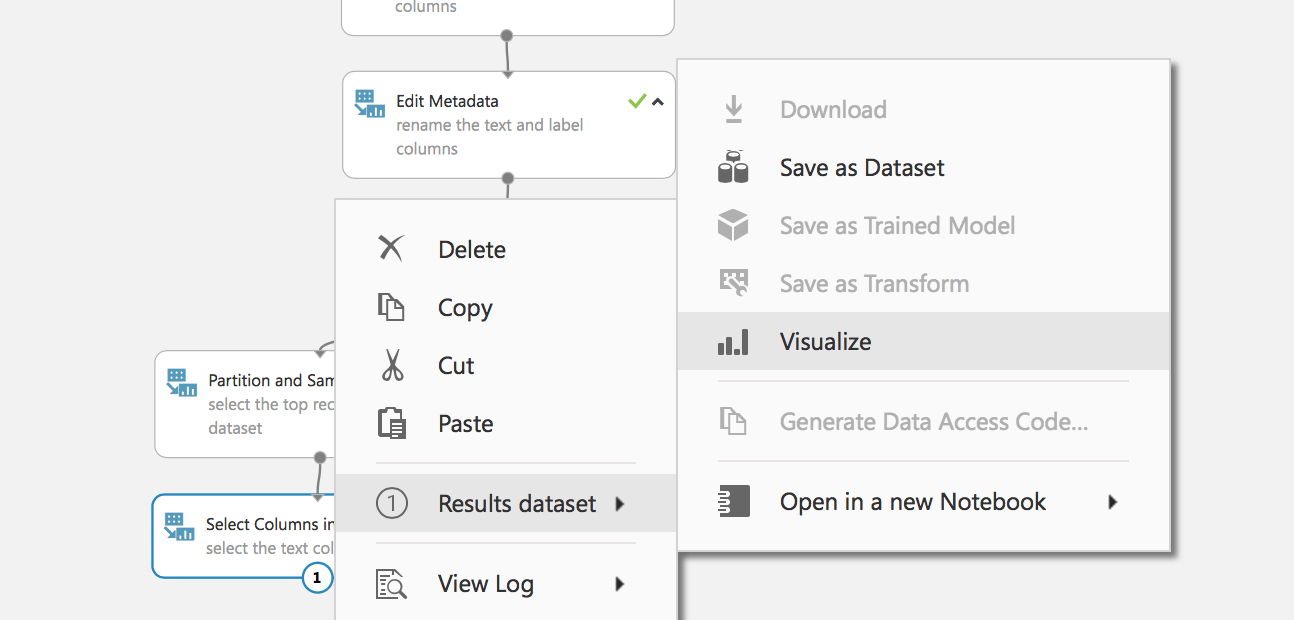
Exécutez l’expérience et examinez les données collectées :
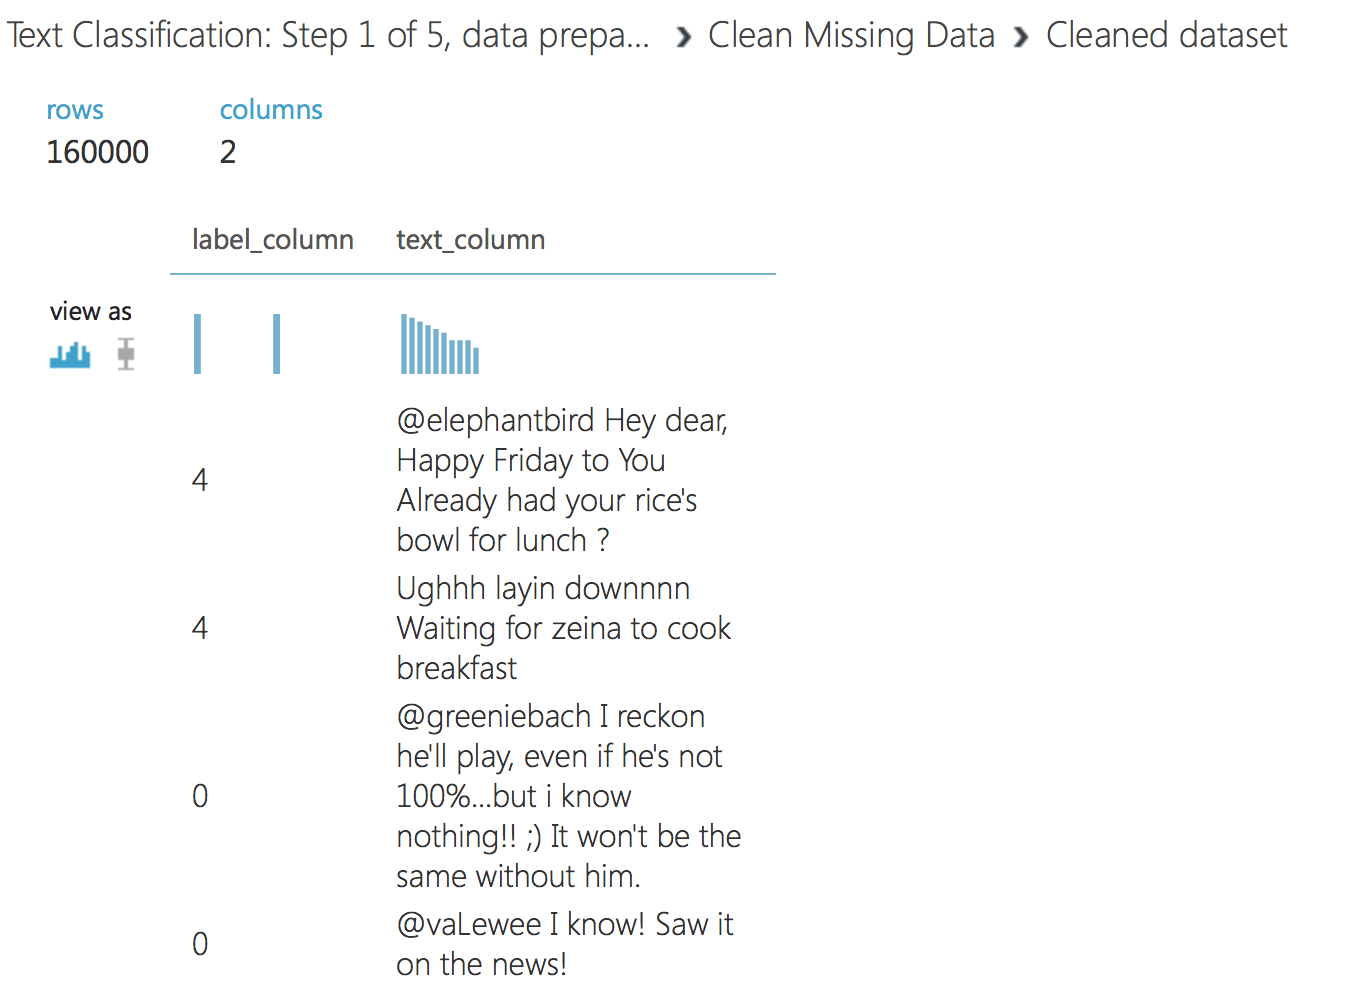
Nous avons préparé les données et sommes prêts à passer à l’étape suivante. Chargez l’expérience suivante – Classification de texte : Étape 2 sur 5, prétraitement du texte
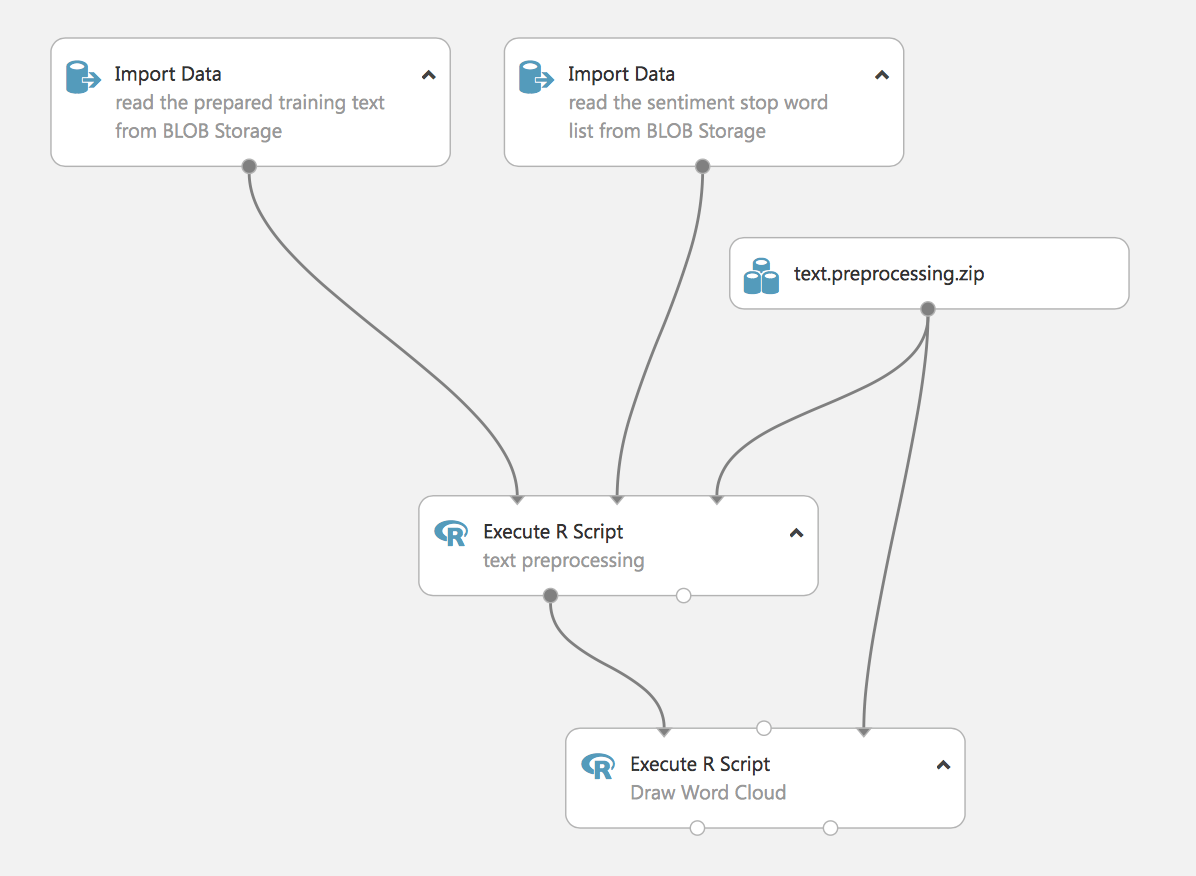
À ce stade, nous chargeons les données et les traitons. Cette expérience utilise des scripts en R pour supprimer les mots vides (nous les chargeons également à partir de blob).
La dernière étape consiste à visualiser le nuage de mots. Il s’agit d’une expérience à valeur pratique, elle démontre la capacité de Studio à utiliser des scripts R pour des tâches de ML, et nous pouvons également intégrer des scripts Python dans le processus. Plus loin, dans l’article, nous montrerons un exemple de traitement de texte à l’aide des méthodes standard de Studio.
Exécutons l’expérience et étudions les résultats.
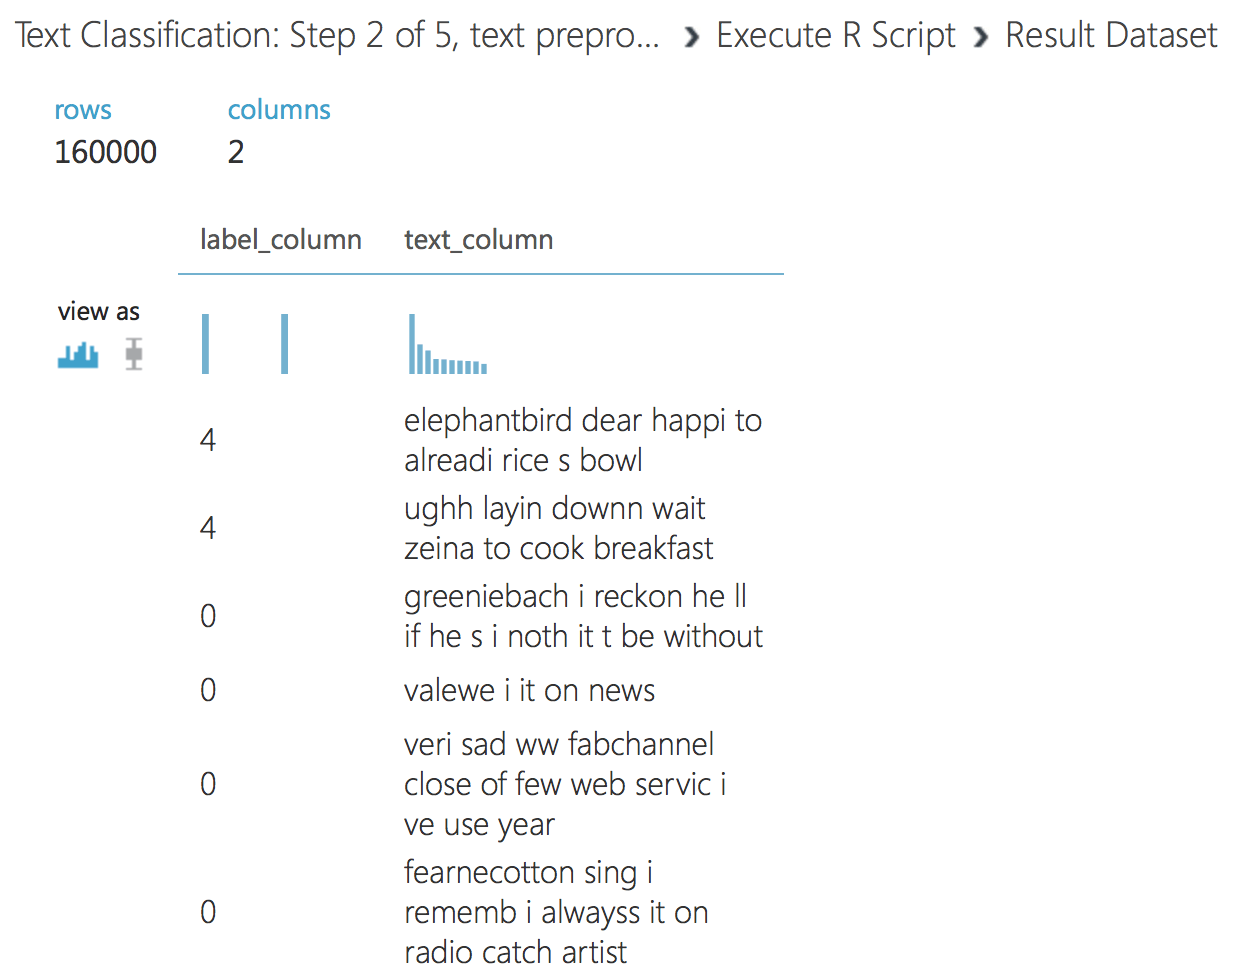
À la sortie du premier script R, nous voyons le texte rédigé.
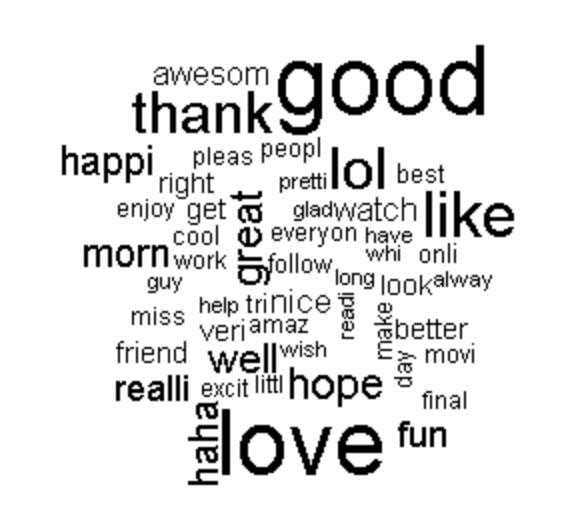
Le deuxième script génère un nuage de mots. Ceci est parfois nécessaire pour la visibilité des données.
Passons à autre chose, créons l’expérience suivante, elle utilise les données du premier script de l’expérience précédente.
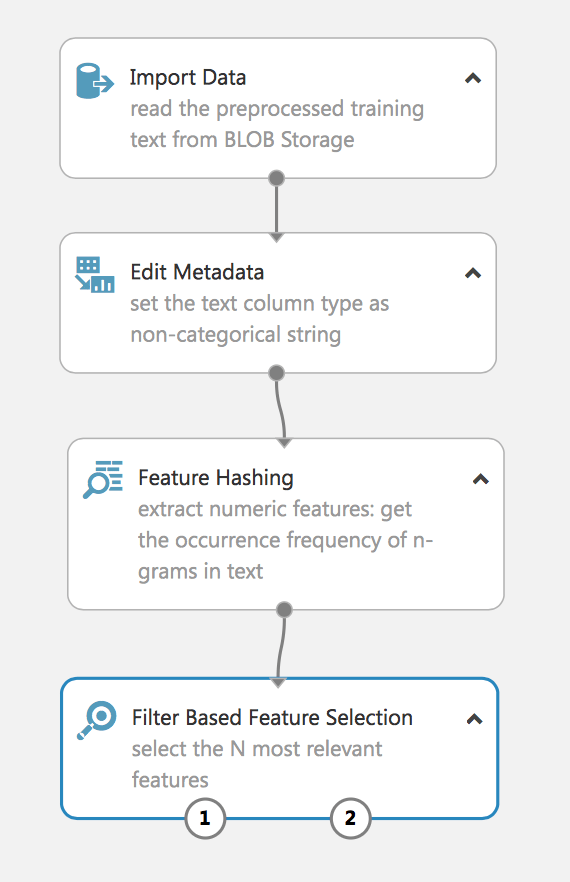
L’expérience extrait les N-grammes des données textuelles en utilisant la méthode Term Frequency, puis sélectionne les plus pertinents. Un processus similaire est souvent utilisé pour traiter le langage naturel.
Vérifions les données reçues :
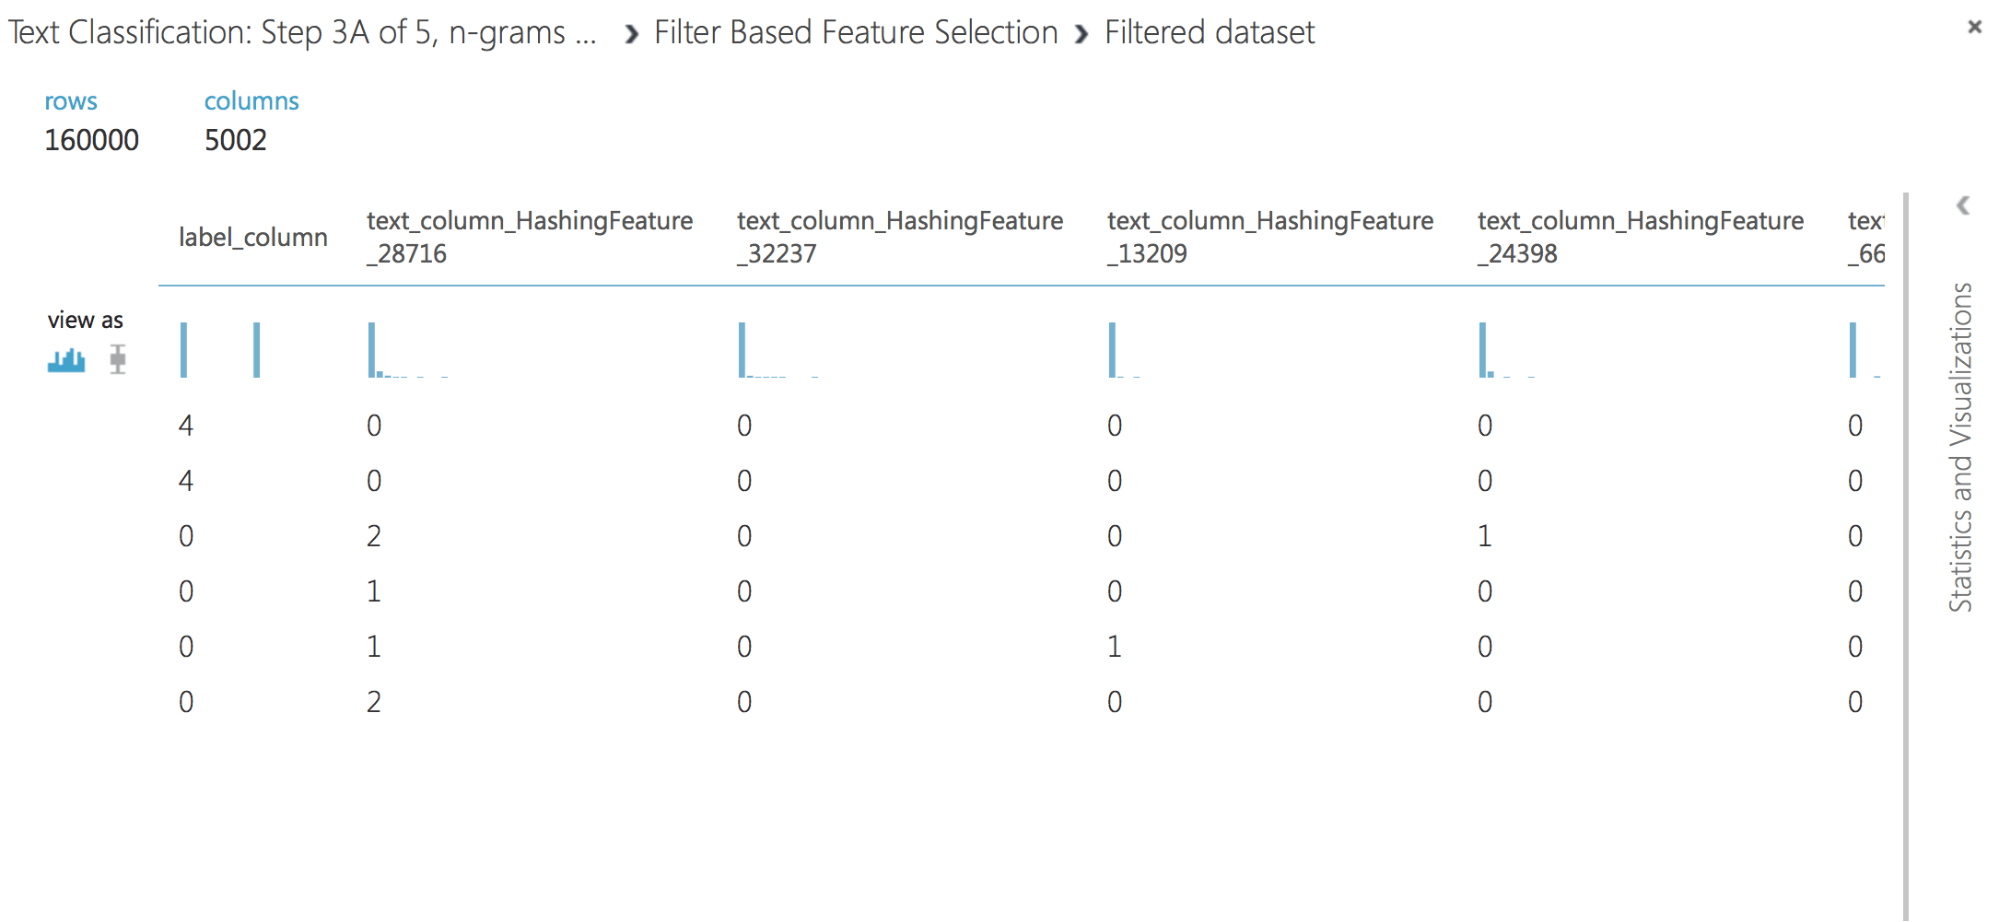
Comme vous pouvez le constater, nous avons extrait avec succès la caractéristique de hachage des données textuelles et filtré la plus pertinente. Si vous n’utilisez pas de filtre, sur un échantillon de 160 000, nous obtiendrons un vecteur de dizaines de milliers de caractéristiques, ce qui compliquera la tâche d’apprentissage du modèle et peut entraîner un réapprentissage.
L’expérience suivante démontre une autre approche pour le traitement NL-TF-IDF (Term Frequency Inverse Document Frequency).
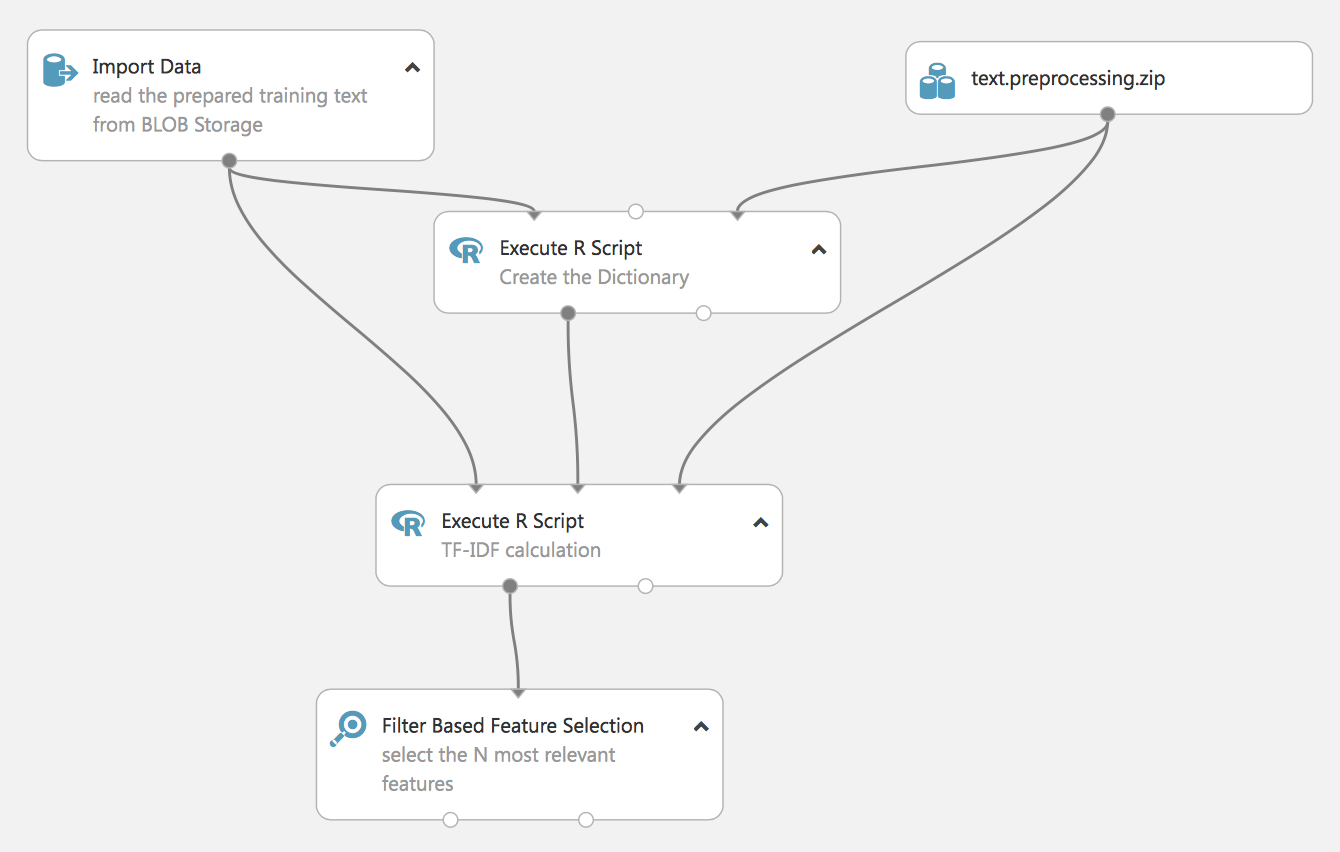
Il est également construit en langage R, plus tard nous montrerons comment cela peut être fait avec les outils standard de Studio.
Le résultat de l’expérience sera également le vecteur de caractéristiques le plus pertinent, mais construit sur un dictionnaire préalablement créé (qui est également basé sur nos données), il n’est pas montré dans l’expérience – mais n’oubliez pas de sauvegarder le dictionnaire, car il sera nécessaire pour préparer les données réelles par la suite.
Construisons un modèle d’apprentissage par flux.
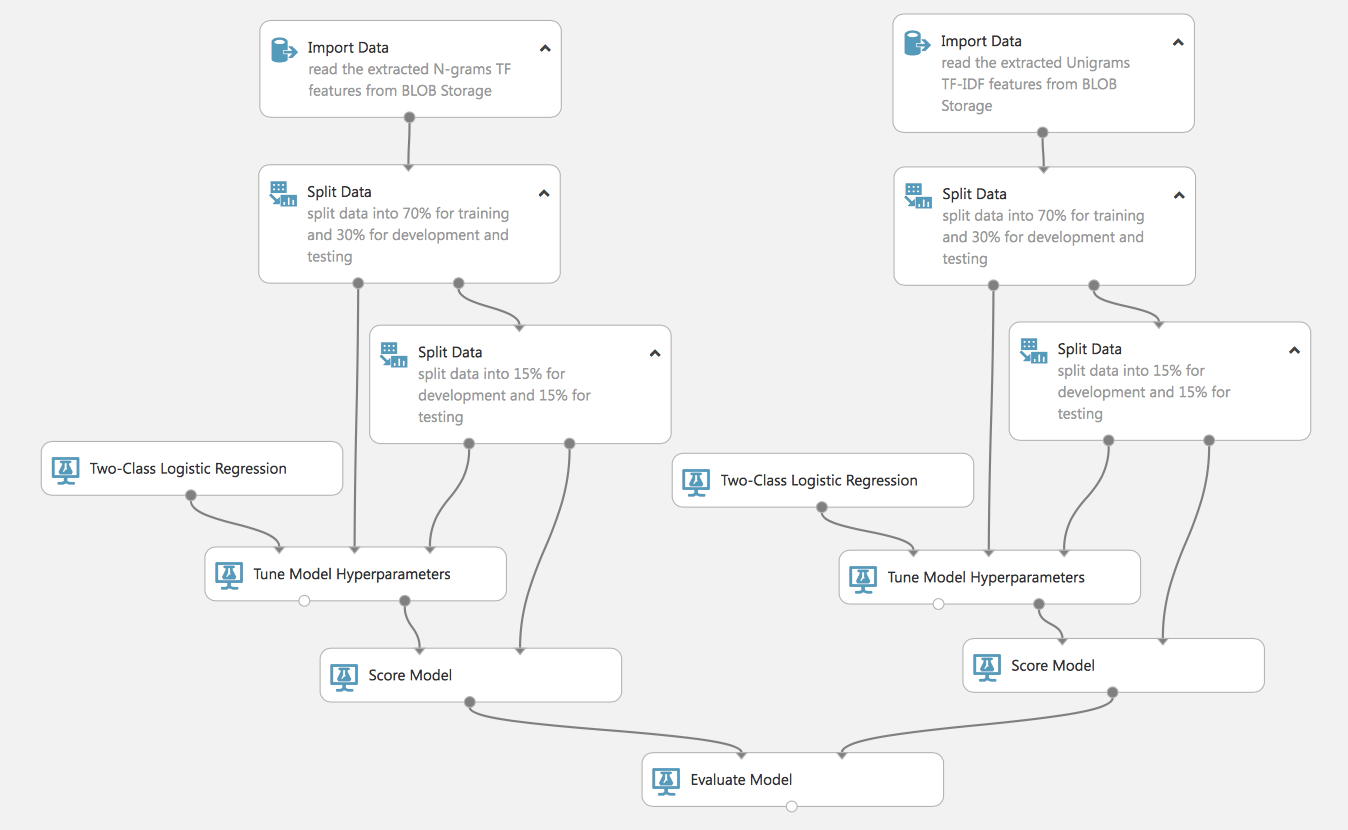
Comme vous le voyez, nous pouvons construire des processus complexes et parallèles (rappelez-vous que sur le compte gratuit, tout cela sera fait séquentiellement, sur le compte payant – simultanément, cela réduit le temps d’apprentissage des modèles). De même, un tel flux nous permettra d’entraîner 2 modèles et de comparer leur efficacité, c’est très pratique pour choisir les modèles les plus appropriés ou les méthodes de préparation des données.
Regardons de plus près ce processus. Au départ, il dispose de 2 ensembles de données préparées à l’aide de diverses méthodes TF, TF-IDF. Nous divisons ces deux ensembles en données d’entraînement et de test (qui ne participent pas à l’entraînement du modèle et seront utilisées pour évaluer sa qualité). Remarquez que nous divisons une deuxième fois le jeu de données de test, ce qui est nécessaire pour l’étape suivante.
Nous déclarons un modèle (dans cet exemple, nous utiliserons la régression logistique), mais pour plus d’efficacité, nous inclurons l’analogue le plus proche de GridSearchCV dans le processus d’optimisation des hyperparamètres du modèle (pour les bibliothèques sklearn familières à Python). C’est-à-dire que nous ne définissons pas rigidement les paramètres du modèle, mais nous définissons une plage de paramètres et les transmettons au bloc Tune Model, qui sélectionnera les plus efficaces lors de l’entraînement du modèle. C’est pour ce bloc que nous avons besoin d’un deuxième ensemble de données de test.
Exécutons ce flux et examinons les résultats.
Résultats de l’optimisation du modèle :
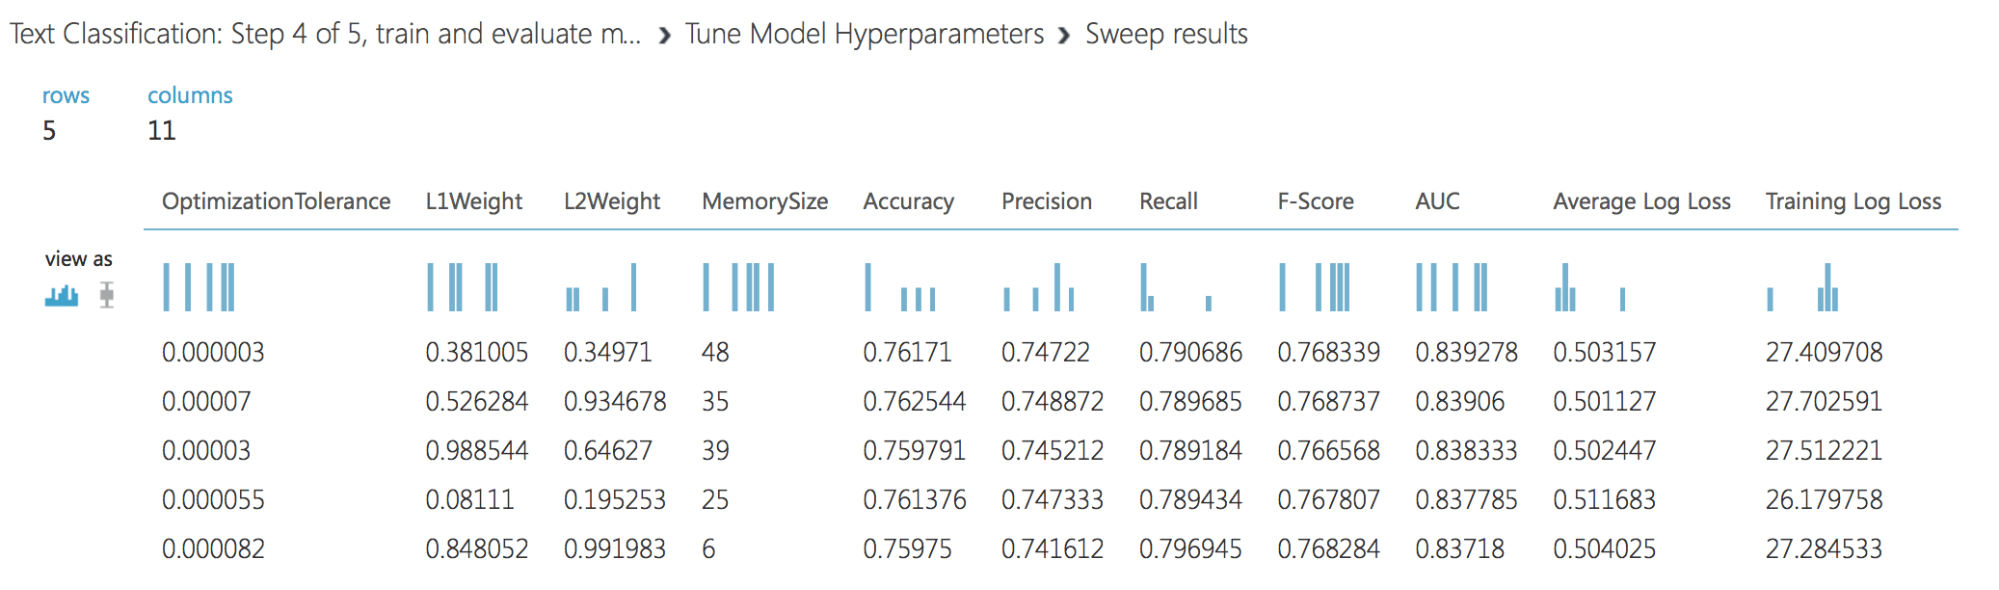
Et les paramètres du meilleur modèle (qui est utilisé pour l’évaluation) :
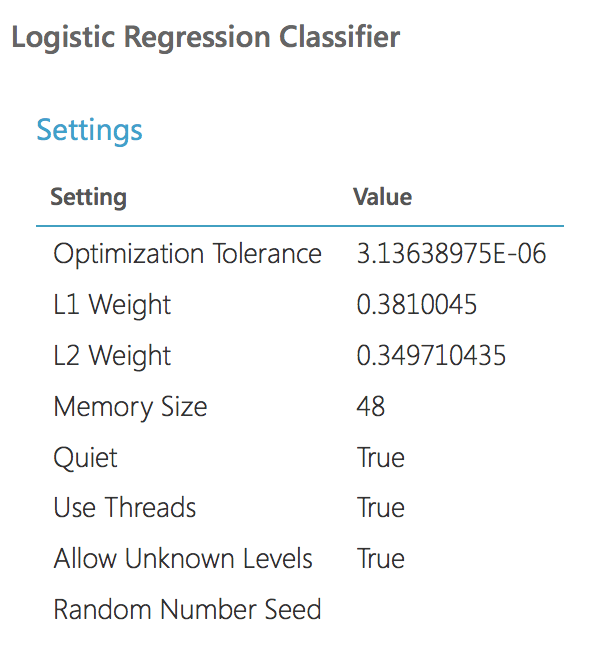
Comme nous le voyons, les paramètres des modèles sont identiques. Comparons la qualité. C’est le graphique ROC pour deux modèles :
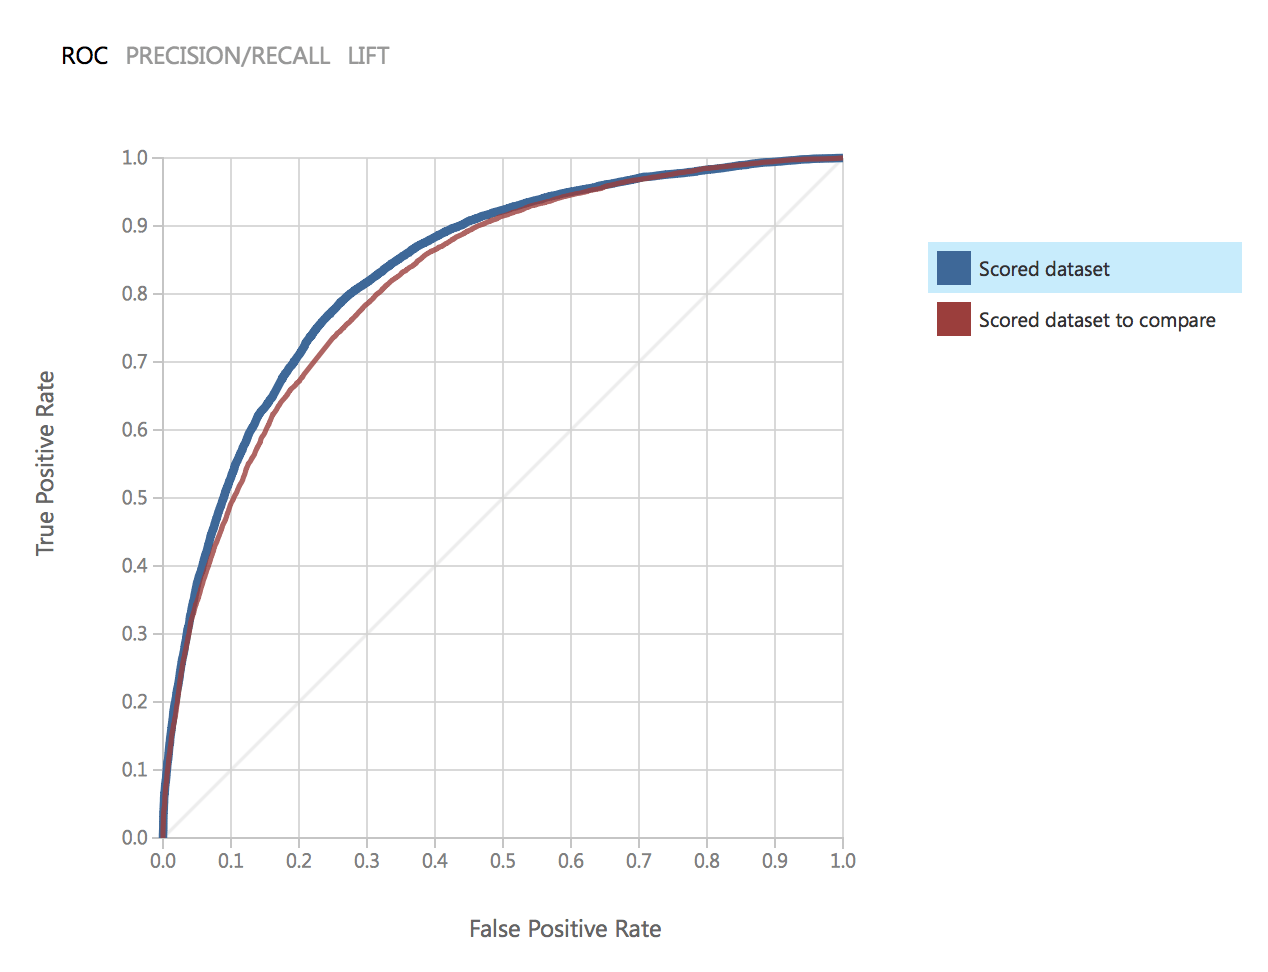
Comme on peut le noter, les résultats des deux modèles sont très proches et satisfont notre précision.
Allons plus loin, et construisons une expérience qui permettra d’utiliser le modèle pour des données réelles (par exemple, venant via le service Web).
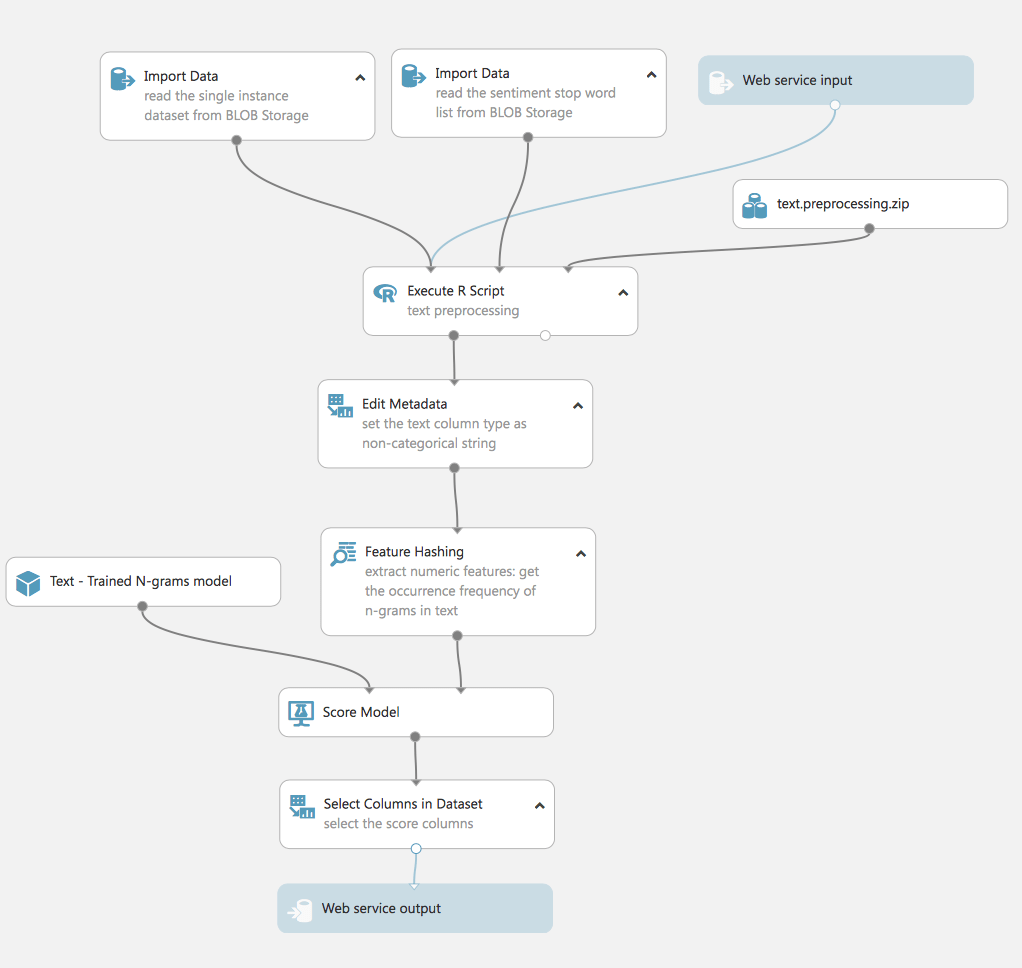
Cette expérience utilise un modèle entraîné par le processus TF. Pour les données réelles, nous répétons les mêmes étapes que pour le processus de préparation des données d’entraînement : nettoyage des données, extraction des caractéristiques, filtre.
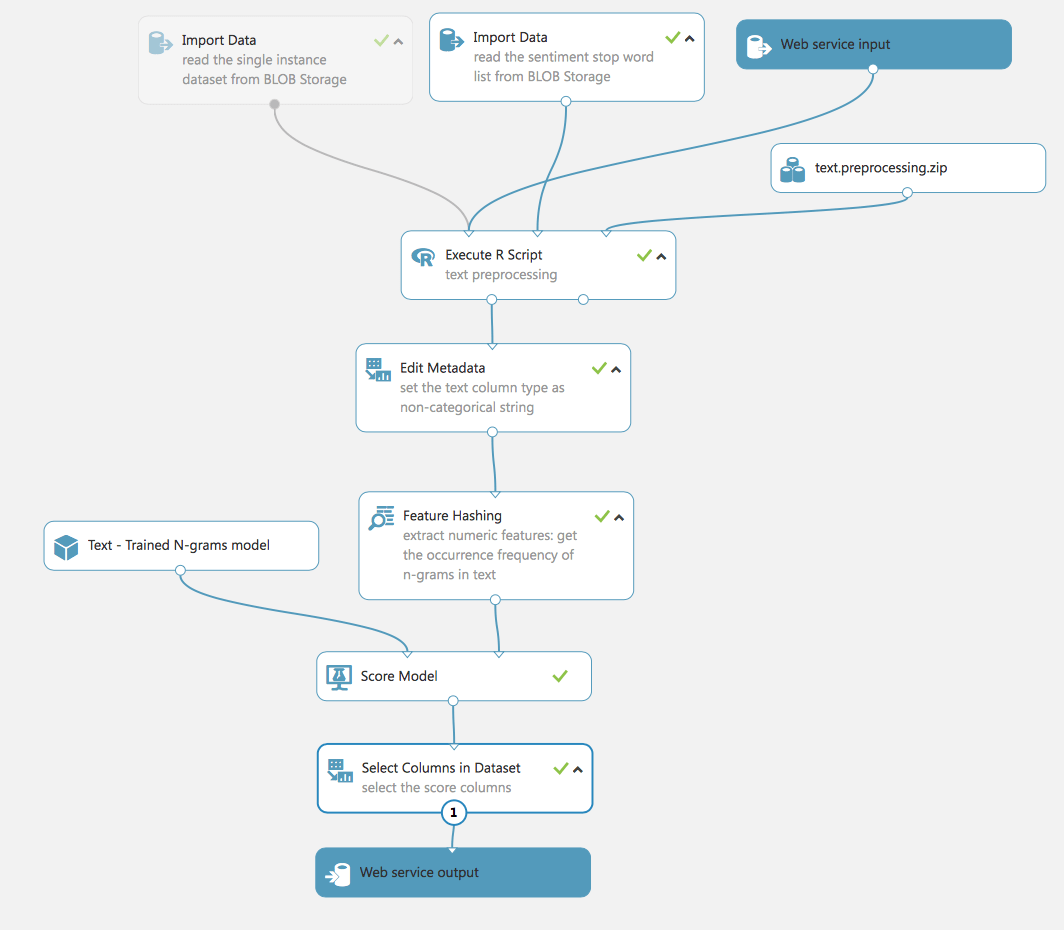
Ainsi, il faut souligner que l’expérience a 3 entrées : les données pour le test (1 ligne du jeu de données original), le jeu de données avec les mots vides pour la préparation du texte (nous l’avons déjà utilisé dans les expériences précédentes) et l’entrée du service Web.
L’entrée et la sortie du service Web sont exactement ce qui transforme notre expérience en un projet réel disponible pour utilisation. En passant l’expérience en mode Vue service Web, nous pouvons déployer l’expérience et la rendre accessible depuis l’extérieur de Studio.
Aller plus loin
Dans cette partie de l’article, nous avons jeté un bref coup d’œil à l’exemple de création d’un modèle et nous nous sommes familiarisés avec les étapes les plus importantes en ML : préparation des données, sélection des caractéristiques, entraînement du modèle (sélection des paramètres du modèle) et évaluation finale des résultats (AUC, Précision, Rappel, etc.)
Dans la prochaine partie, nous considérerons le processus de création d’un modèle pour résoudre un problème réel, sur des données réelles et à appliquer dans un projet réel.


