Votre fournisseur de CRM vous vend déjà un module d’IA, et le devis de renouvellement part du principe que vous allez le prendre. La vraie question que votre équipe doit trancher est de savoir si ce module couvre la logique de scoring, de routage et de prévision sur laquelle repose votre activité, ou si vous vous apprêtez à payer un abonnement par utilisateur pour quelque chose qui vous mène à soixante-dix pour cent du chemin.
L’IA dans les systèmes CRM désigne les modèles de machine learning et de langage intégrés aux logiciels de gestion de la relation client pour scorer les leads, router les demandes, prédire l’attrition et prévoir le chiffre d’affaires. Toutes les grandes plateformes livrent désormais ces capacités nativement. L’intégration sur mesure devient nécessaire dès lors que la logique de scoring, les données sources ou les actions que le système doit exécuter sortent du modèle de données de la plateforme.
L’adoption est à la fois large et superficielle, et c’est pourquoi cette dernière phrase décide de tant de budgets. Le Business Trends and Outlook Survey du U.S. Census Bureau chiffrait l’usage global de l’IA dans les entreprises américaines à 19,8 % en mai 2026, et à environ 37 % chez les entreprises d’au moins 250 salariés. Le mid-market est donc précisément l’endroit où l’écart entre acheter un module d’IA et changer sa façon de vendre est le plus large. Cet article couvre les capacités réellement prêtes pour la production, les conditions qui font atteindre leurs limites aux fonctionnalités natives, et ce qui change lorsque vous faites appel à des services de développement CRM pour combler l’écart. Il part du principe que vous possédez déjà un CRM et que vous décidez de ce que vous allez poser dessus.
Scoring et segmentation des leads pilotés par l'IA
Le scoring des leads est le plus mature des cas d’usage de l’IA dans le CRM, parce qu’il s’agit d’un problème d’apprentissage supervisé doté d’un label propre : le fait que l’affaire ait fini par se conclure ou non. Le modèle apprend de votre propre historique d’affaires gagnées et perdues, puis classe les nouveaux enregistrements par probabilité de conclusion. Les versions natives sont livrées dans la couche Agentforce et Einstein de Salesforce, dans Breeze de HubSpot, dans Microsoft Dynamics 365 Sales Copilot et dans Zia de Zoho, et toutes suivent à peu près la même recette.
Ce qui sépare un score sur lequel vos commerciaux agissent d’un score qu’ils ignorent poliment, c’est le jeu de variables qui le nourrit. Un modèle natif lit ce qui se trouve déjà dans le CRM :
- Firmographie. Taille de l’entreprise, secteur, région et tranche de chiffre d’affaires sur la fiche du compte.
- Événements d’engagement. Ouvertures d’e-mails, formulaires remplis, participation aux réunions et pages vues captées par le tracking de la plateforme.
- Comportement du pipeline. Vitesse de passage d’une étape à l’autre, nombre de contacts engagés chez un compte et durée pendant laquelle un enregistrement est resté sans activité.
- Historique des affaires. Taux de réussite par segment, durée médiane du cycle et schémas de remise extraits des affaires closes.
La segmentation tourne sur la même table de variables, label retiré, et utilise le clustering pour regrouper les comptes qui se comportent de la même manière plutôt que les comptes qui se ressemblent simplement sur le papier. Le gain apparaît dans la conception des territoires et le ciblage des campagnes, où un groupe de comptes lents à conclure mais à fort potentiel d’expansion mérite un traitement différent d’un groupe qui conclut vite et part tôt. La limite honnête, c’est le volume : ces modèles ont besoin d’assez d’affaires closes par segment pour apprendre quoi que ce soit de réel, et une équipe qui conclut quelques dizaines d’affaires par an obtiendra un score qui ne fait guère que répéter ce que ses commerciaux croient déjà.
IA conversationnelle et routage automatisé des demandes
Les boîtes de réception du support et des ventes sont l’endroit où les modèles de langage rentabilisent le plus vite leur place, parce que le travail sous-jacent consiste à lire du texte non structuré et à décider où il doit aller. Un modèle de routage lit un message entrant, classe l’intention, extrait des entités comme un numéro de commande ou une gamme de produits, puis affecte la demande à une file ou à un propriétaire. L’indicateur qu’il déplace, c’est le délai de première réponse, une métrique que la plupart des équipes support du mid-market suivent déjà.
Le mécanisme compte davantage que le discours marketing ici, car chaque étape porte son propre mode de défaillance. La classification d’intention fonctionne bien quand vos catégories sont réellement distinctes et que vous disposez de quelques centaines d’exemples étiquetés pour chacune, et elle se dégrade vite dès que deux catégories se chevauchent, comme le font en général les questions de facturation et les demandes de remboursement. L’extraction d’entités est fiable pour les chaînes structurées comme les identifiants de facture, et fragile pour les noms de produits en texte libre que les clients écrivent de six façons différentes. Tout système de routage en production a donc besoin d’un seuil de confiance et d’une file de repli humaine, parce qu’une demande mal routée avec assurance coûte plus d’heures qu’une demande non routée qui attend dans une boîte générique.
La couche conversationnelle se pose sur cette même pile de classification : elle répond aux questions dont les réponses existent déjà dans votre base de connaissances et transmet tout le reste à une personne. Les équipes qui construisent cela correctement suivent le taux de déflexion et la justesse des escalades comme deux chiffres distincts, puisqu’un bot qui dévie 60 % des tickets tout en faisant remonter les mauvais 10 % crée plus de travail qu’il n’en supprime. Resserrer ce partage est en général la première chose que nous faisons quand un client fait appel à nous pour des services de développement de chatbots IA après une première tentative décevante.
Analytique prédictive
L’analytique prédictive est le moment où un CRM cesse de décrire ce qui s’est déjà produit et s’engage sur un chiffre concernant ce qui va se produire ensuite. Deux prévisions pèsent réellement sur le budget des équipes du mid-market : quels clients sont sur le point de partir, et quel chiffre d’affaires va effectivement tomber ce trimestre. Les deux s’entraînent sur les mêmes enregistrements historiques, et les deux échouent de la même manière quand cet historique est mince ou saisi de façon inconstante.
Prédiction de l'attrition
Un modèle d’attrition lit les signaux qui précèdent une résiliation et attribue à chaque compte une probabilité de départ dans une fenêtre définie, en général 30, 60 ou 90 jours. Les variables qui pèsent le plus lourd sont rarement celles que les dirigeants attendent. Le volume de tickets support sur les 30 derniers jours, une baisse d’usage du produit mesurée par rapport à la ligne de base du compte lui-même, un changement d’interlocuteur principal et un retard de paiement de facture devancent tous, le plus souvent, la taille du contrat ou le secteur.
La définition de la fenêtre est la partie que les équipes ratent le plus souvent. Un modèle entraîné à prédire l’attrition à 90 jours laisse au customer success un vrai temps d’action tout en portant une confiance plus faible par prédiction, tandis qu’un modèle à 30 jours est plus net mais se déclenche souvent après que la conversation de renouvellement a déjà mal tourné. Choisissez la fenêtre qui correspond à la durée réelle de votre plan de rétention, puis tenez le modèle à cet horizon au lieu de le réajuster chaque trimestre.
Prévision des ventes
Les modèles de prévision estiment si chaque opportunité ouverte se conclura dans la période annoncée, puis agrègent ces probabilités en un chiffre de pipeline. Cela surpasse les catégories d’engagement saisies par les commerciaux pour une raison structurelle : le modèle lit les preuves comportementales contenues dans l’enregistrement lui-même, tandis qu’une catégorie d’engagement reflète l’humeur d’un commercial lors de la revue de pipeline du lundi. Les signaux qui font bouger la prévision sont concrets et auditables :
- La durée passée à chaque étape, mesurée par rapport à la médiane historique des affaires de cette taille.
- L’ancienneté et la nature de la dernière activité enregistrée sur l’opportunité.
- Le fait que plus d’un contact chez le compte soit activement engagé.
- Le fait que la date de clôture ait été repoussée, et combien de fois.
Le mode de défaillance mérite d’être nommé clairement. La prévision hérite de la discipline de votre hygiène CRM, si bien qu’un pipeline où les dates de clôture sont mises à jour une fois par trimestre produit une prévision qui se trompe avec assurance au moment précis où la finance commence à s’appuyer dessus. Corriger la saisie des données coûte bien moins cher que corriger le modèle, et cela doit venir en premier.
Quand l'IA native de la plateforme ne suffit plus
L’IA native couvre le cas courant avec compétence, et le cas courant représente une large part de ce que font chaque jour la plupart des équipes commerciales et support. L’argument en faveur d’un développement IA CRM sur mesure commence là où votre logique commerciale cesse de vivre dans les objets CRM standard. Trois conditions poussent de façon fiable les équipes au-delà de cette ligne, et les trois méritent d’être vérifiées avant de commander quoi que ce soit, y compris des services de développement d’agents IA qui promettent une automatisation de bout en bout.
Délai jusqu’au premier résultat
De quelques jours à quelques semaines, activée dans les paramètres
6 à 12 semaines jusqu’à un premier modèle en production
Variables de scoring
Champs situés dans les objets propres à la plateforme
Tout système doté d’une API, y compris l’ERP, la télémétrie produit et la facturation
Transparence du modèle
Définie par l’éditeur, visibilité limitée sur les variables
Visibilité complète sur les variables, les poids et les données d’entraînement
Structure de coûts
Par utilisateur ou par crédit, évolue avec les effectifs
Coût de construction en amont, puis hébergement et maintenance
Actions inter-systèmes
Limitées à l’écosystème et aux connecteurs de l’éditeur
Tout système que vous pouvez autoriser, sous votre propre modèle de permissions
Propriété
La logique vit dans la plateforme et s’en va avec elle
La logique et les données d’entraînement restent chez vous
Cas idéal
Pipeline standard, données CRM propres, démarche commerciale classique
Logique propriétaire, données réparties entre plusieurs systèmes, décisions auditables
Une logique métier qui vit hors du modèle de données de la plateforme
Chaque CRM présuppose une forme pour votre activité : comptes, contacts, opportunités, étapes. Les entreprises dont la démarche commerciale est réellement différenciée portent en général une logique de scoring qui refuse d’entrer dans cette forme. Un fournisseur de matériaux de construction dont la qualité des leads dépend des permis de construire publics, ou un opérateur logistique dont la santé des comptes dépend de volumes d’expédition conservés dans un système d’inventaire distinct, ont tous deux leur meilleur prédicteur entièrement hors du CRM.
Le test est assez simple pour être fait en un après-midi. Notez les cinq variables que votre meilleur commercial utilise pour juger un lead, puis comptez combien d’entre elles existent comme champ du CRM. Les équipes qui n’en retrouvent que deux ou trois se dirigent vers un pipeline de variables sur mesure, car un modèle natif ne peut jamais apprendre qu’à partir de ce que la plateforme voit.
Des agents IA qui agissent d'un système à l'autre
Le basculement de 2026 va d’une IA qui recommande à une IA qui exécute, met à jour des enregistrements, envoie des relances, crée des tickets et déclenche des workflows en aval sans qu’une personne clique à chaque étape. Les agents natifs des plateformes gèrent cela avec compétence à l’intérieur de leur propre écosystème et butent sur un mur à sa frontière, puisqu’un agent ne peut appeler que les outils que son éditeur a choisi d’exposer. C’est à cette frontière que la plupart des projets d’agents calent ou sont reconstruits.
Le tableau de la fiabilité mérite de l’honnêteté. L’AI Index 2026 de Stanford HAI rapporte que les agents IA sont passés de 12 % à environ 66 % de tâches réussies sur OSWorld, un benchmark de tâches informatiques générales, ce qui les laisse encore échouer près d’une tentative sur trois. Ce chiffre plaide pour cantonner d’abord les agents à des actions réversibles et auditables, comme rédiger une relance qu’un humain approuvera ou signaler un enregistrement à relire, et pour garder les actions irréversibles telles qu’un remboursement derrière une approbation explicite jusqu’à ce que vous ayez mesuré votre propre taux d’erreur en production.
Les agents inter-systèmes sont l’endroit où le travail sur mesure commence à se rembourser, parce que l’action réellement utile couvre en général le CRM, le système de facturation et la base produit d’un seul mouvement. L’essentiel de cet effort d’ingénierie part dans les définitions d’outils, le cadrage des permissions et un journal d’audit assez détaillé pour reconstituer six semaines plus tard pourquoi l’agent a fait ce qu’il a fait.
Coûts, données et réalité de l'intégration
Les discussions budgétaires déraillent quand on traite le modèle comme la partie coûteuse. Dans la plupart des projets CRM, le modèle représente une minorité du coût de développement de l’IA, et la majorité part dans la tuyauterie de données : réconcilier les comptes en double, reconstituer les labels de résultat, construire le pipeline qui maintient les variables à jour et écrire le monitoring qui vous prévient quand la performance a dérivé.
L’échelle explique pourquoi cela mord le plus fort chez les équipes du mid-market. Les travaux synthétisés par le National Bureau of Economic Research en mai 2026, qui s’appuient sur près de 6 000 PDG, directeurs financiers et cadres financiers seniors interrogés dans quatre pays par la Federal Reserve Bank of Atlanta, la Bank of England, la Deutsche Bundesbank et Macquarie University, ont relevé que 69 % des entreprises déclarent un usage actuel de l’IA, la génération de texte étant l’application la plus répandue, chez 41 % des entreprises. La génération de texte arrive en tête précisément parce qu’elle est la capacité la moins chère à adopter et la moins dépendante de données internes propres, soit exactement l’inverse de ce qu’exigent le scoring et la prévision dans un CRM.
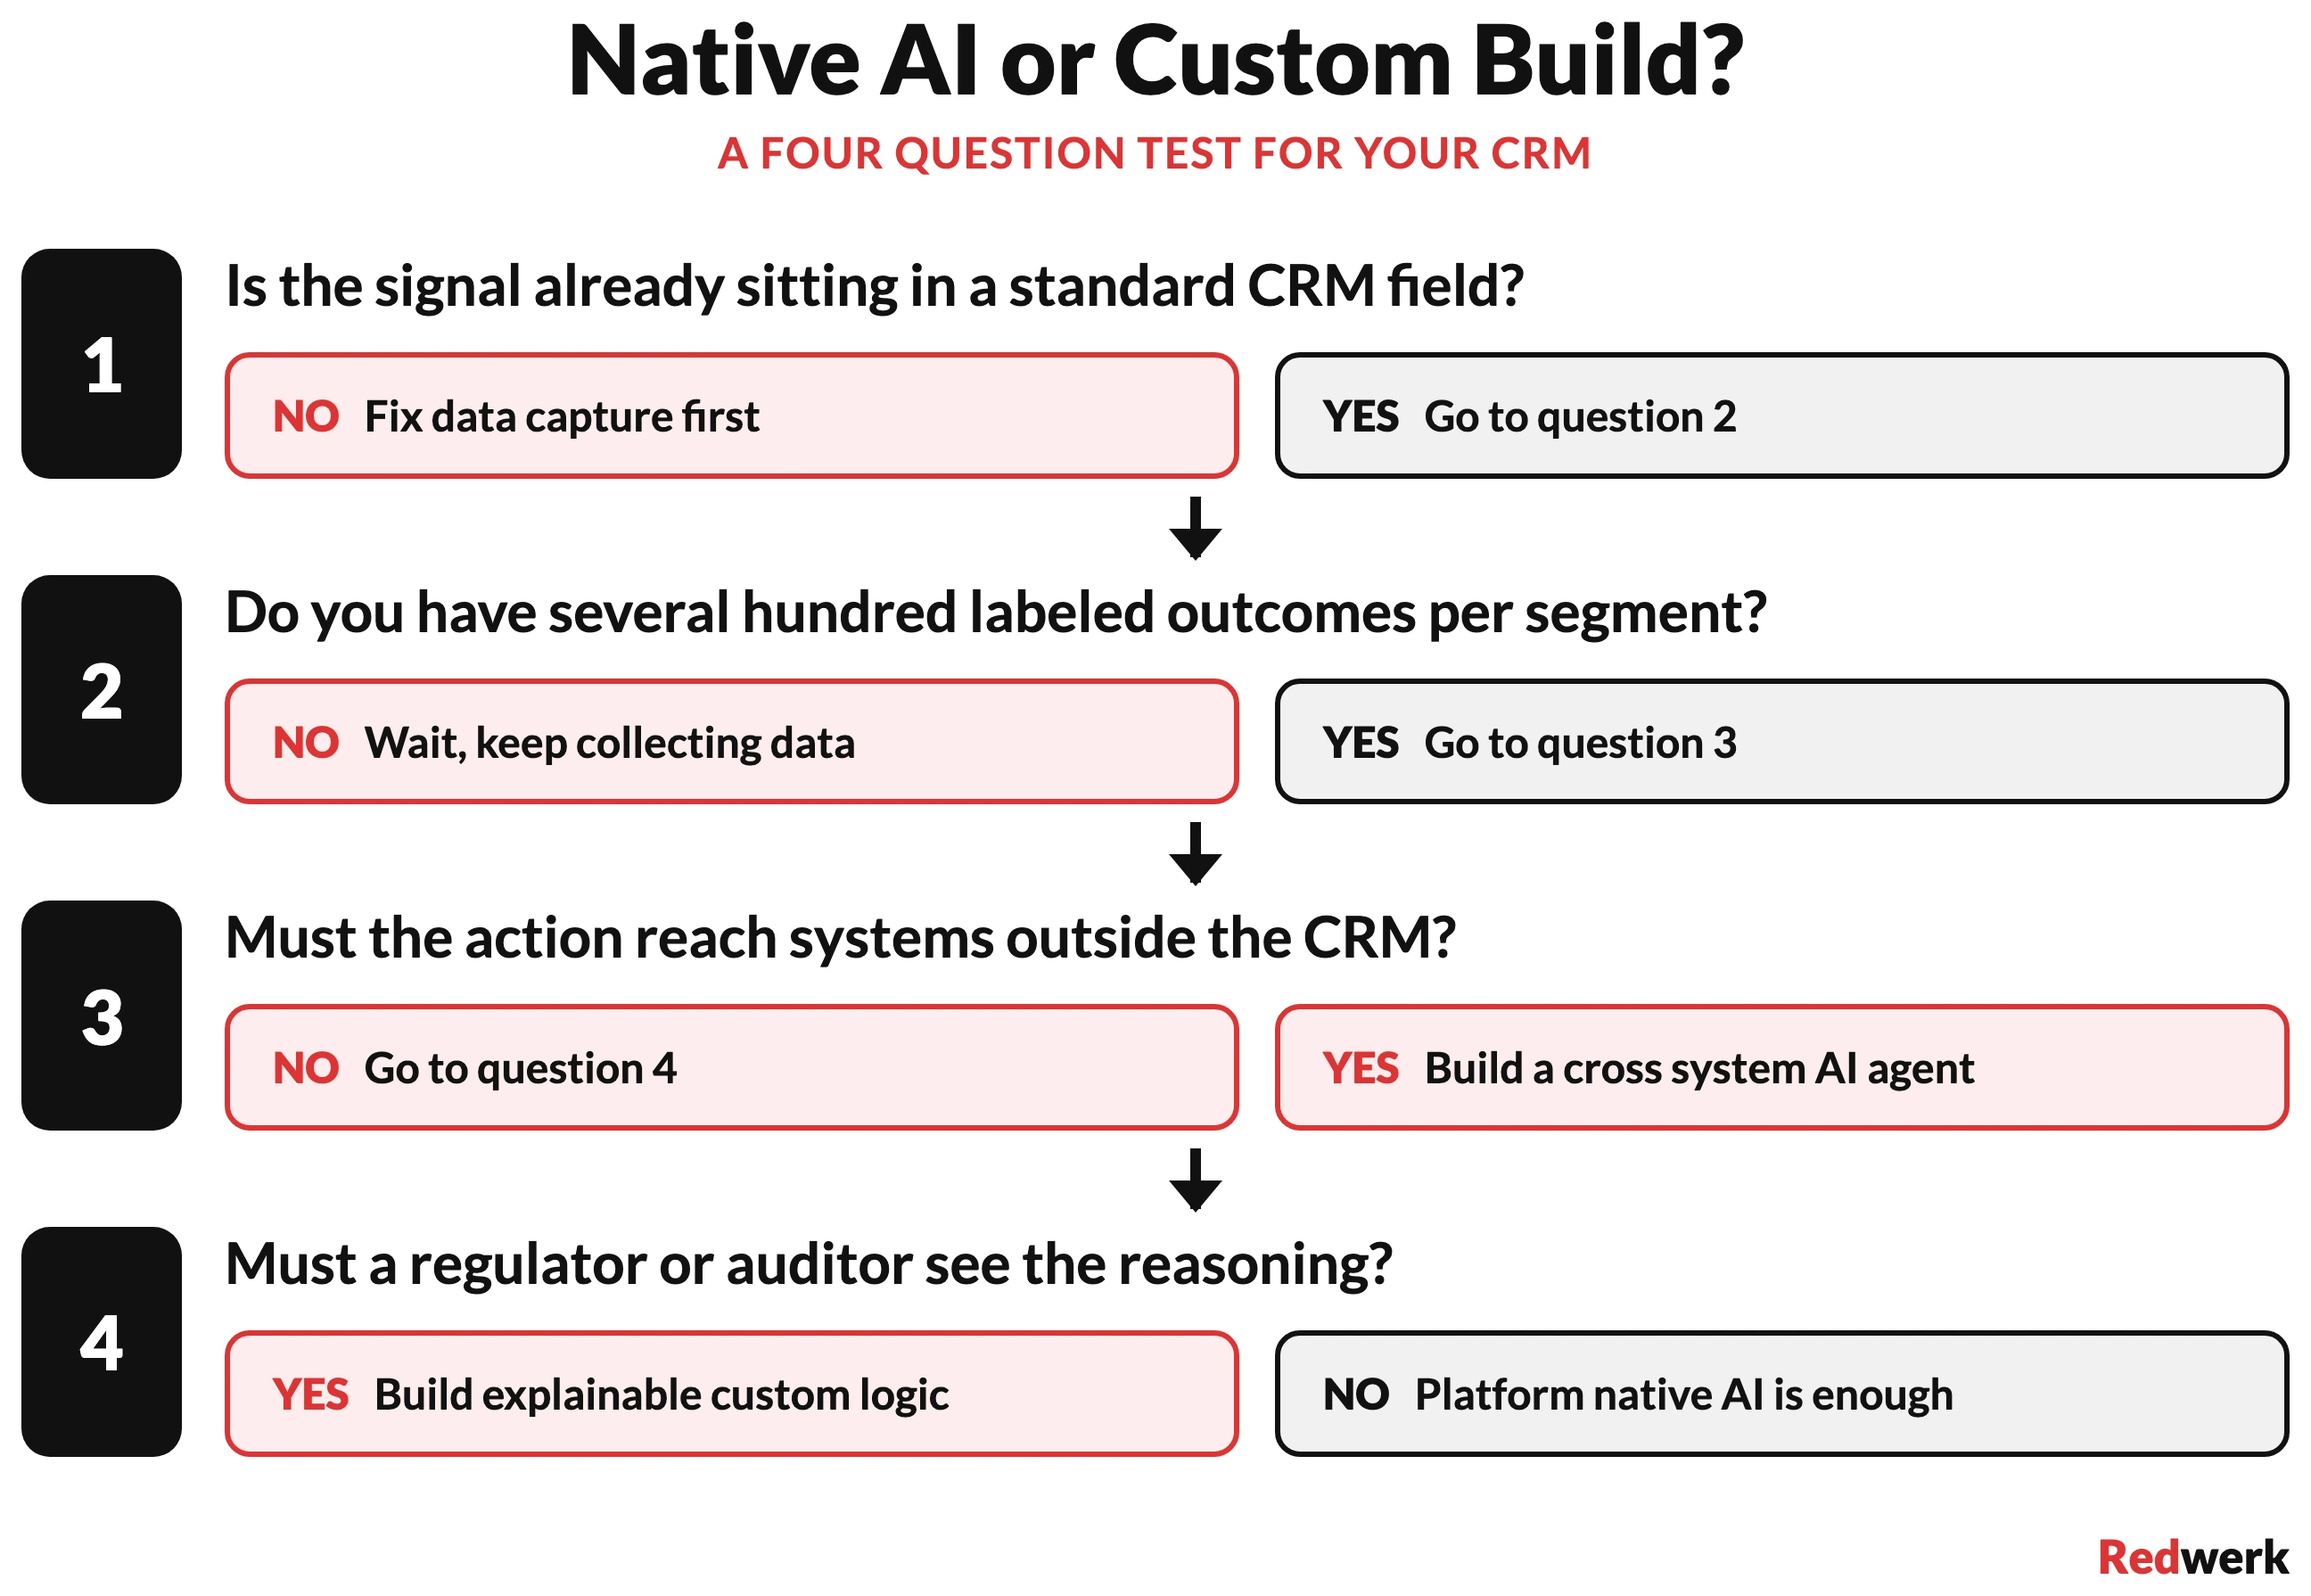
Trois faits sur les données décident de la viabilité d’un projet avant qu’un budget ne soit engagé : combien de résultats étiquetés vous détenez par segment, avec quelle constance les champs qui alimentent le modèle sont renseignés, et si les systèmes qui détiennent le reste du signal exposent une API. Une équipe incapable de répondre à ces trois questions passera de toute façon les six premières semaines de n’importe quelle mission à y répondre, donc y répondre tôt est la chose la moins chère de cette liste.
Là où une intégration IA-CRM sur mesure est vraiment rentable
Le travail sur mesure vaut d’être commandé sous trois conditions : la décision prise par l’IA fait partie de votre avantage commercial, les données dont elle a besoin sont réparties entre des systèmes pour lesquels votre éditeur de CRM n’a aucun connecteur, ou la décision doit être expliquée à un auditeur ou à un régulateur. Ces conditions couvrent la plupart des projets encore en service un an après leur lancement.
En pratique, le schéma ressemble à ceci :
- Un modèle de scoring qui lit la télémétrie produit et l’historique de facturation aux côtés des champs CRM, parce que l’usage prédit l’expansion plus sûrement que tout ce qu’un commercial saisit dans un formulaire.
- Un agent de routage qui ouvre un ticket dans l’outil de suivi de l’ingénierie et met à jour la demande dans le CRM en une seule action, sous un modèle de permissions que votre équipe sécurité a réellement examiné.
- Un modèle d’attrition dont vous pouvez montrer les variables et les seuils à un responsable customer success, et les ajuster sans ouvrir un ticket de support chez l’éditeur.
- Une prévision qui se réconcilie avec le système financier, pour que les ventes et la finance débattent des hypothèses au lieu de débattre de savoir quel chiffre est le bon.
Le risque de livraison dans ce travail se loge dans la surface d’intégration : un CRM qui porte dix ans de personnalisations accumulées, un ERP que personne n’a documenté entièrement, et une équipe qui connaît la logique métier sans l’avoir écrite nulle part. L’approche de Redwerk en matière de développement de logiciels CRM commence par cartographier cette surface avant qu’un seul modèle ne soit entraîné. Nous démarrons régulièrement des missions dont les exigences sont encore incomplètes, car la spécification de ce type de projet se découvre en général en lisant les données existantes plutôt qu’en rédigeant un document en amont.
La composition de l’équipe décide de la vitesse de cette cartographie. Les équipes qui font déjà tourner une plateforme en laquelle elles ont confiance veulent souvent recruter une équipe de développement dédiée capable de travailler aux côtés de leurs propres ingénieurs sur la couche d’intégration, tandis que les équipes qui partent de zéro côté modélisation doivent recruter des développeurs IA disposant d’une expérience en production sur la stack exacte où leurs données se trouvent déjà. Faire correspondre les spécialistes à cette stack, que cela signifie .NET et Azure ML côté Microsoft ou des services Python autour d’une org Salesforce, supprime l’essentiel du temps de montée en charge qui rend ces projets lents le premier mois.
Où vit réellement votre logique
La bonne façon de cadrer cette décision est de se demander où vit votre logique. Quand les signaux qui prédisent un bon client se trouvent dans des champs standard et que votre démarche commerciale ressemble à celle de tout le monde dans votre catégorie, les fonctionnalités intégrées sont le bon achat et la route la plus rapide vers la valeur. Quand ces signaux se trouvent dans trois autres systèmes, ou que la décision doit être défendue ligne par ligne, le travail d’intégration devient le produit et le modèle n’en est qu’un composant.
Dans les deux cas, la séquence est la même : corriger la saisie des données, définir le label, mesurer la référence qu’un humain atteint déjà, et seulement ensuite décider quoi construire. Si vous voulez un deuxième avis sur le côté de cette ligne où se situe votre propre configuration, vous pouvez en parler avec notre équipe.
FAQ
Qu'est-ce que l'IA dans le CRM ?
L’IA dans le CRM désigne les modèles de machine learning et de langage intégrés aux logiciels de gestion de la relation client pour traiter des tâches de jugement autrefois manuelles. Les quatre capacités prêtes pour la production aujourd’hui sont le scoring des leads, le traitement conversationnel avec routage des demandes, la prédiction de l’attrition et la prévision des ventes. Chacune apprend de vos propres enregistrements historiques, donc la qualité des résultats dépend directement de la constance avec laquelle votre équipe a renseigné la plateforme.
Que sont les agents IA dans un CRM ?
Un agent IA agit au lieu de se contenter de produire une recommandation. Il lit un enregistrement ou un message, décide d’une prochaine étape et l’exécute en appelant un outil, par exemple mettre à jour un champ, créer une tâche, rédiger un e-mail de relance ou ouvrir un ticket dans un autre système. La différence pratique avec l’automatisation d’ancienne génération, c’est que la séquence des étapes est choisie à l’exécution par le modèle au lieu d’être codée en dur dans un constructeur de workflows, ce qui rend les agents flexibles et rend indispensables le cadrage des permissions et la journalisation d’audit.
Comment l'IA améliore-t-elle le scoring des leads dans un CRM ?
Le scoring traditionnel attribue des points choisis par un humain, par exemple dix points pour une demande de démonstration. Un modèle, lui, apprend les poids à partir de votre historique d’affaires gagnées et perdues, ce qui lui permet de trouver des combinaisons que personne n’aurait pensé à coder à la main, comme l’interaction entre la vitesse de passage d’étape et le nombre de contacts engagés chez un compte. Le gain apparaît sous la forme d’un meilleur classement en haut de la liste, et cela compte parce que les commerciaux travaillent une liste du haut vers le bas et que leur temps est la ressource contrainte.
De quelles données avez-vous besoin avant d'ajouter de l'IA à votre CRM ?
Trois éléments décident de la viabilité. Il vous faut des résultats étiquetés, c’est-à-dire assez d’affaires closes ou d’annulations confirmées pour apprendre, avec plusieurs centaines par segment comme plancher de travail. Il vous faut des champs renseignés de façon constante, car un champ rempli une fois sur deux enseigne au modèle vos habitudes de saisie plutôt que vos clients. Il vous faut aussi un accès API aux autres systèmes qui détiennent le reste du signal, puisque l’usage du produit et l’historique de facturation portent en général plus de poids prédictif que tout ce qui est tapé à la main dans un formulaire.
Combien coûte un développement IA CRM sur mesure ?
Le coût est bien plus déterminé par la surface d’intégration et l’état des données que par la complexité du modèle. Un pilote cadré sur un seul cas d’usage, par exemple un modèle de scoring entraîné sur des données déjà propres, se situe en général dans les quelques dizaines de milliers et prend six à douze semaines. Un système de production qui lit plusieurs systèmes sources, fait tourner des agents qui agissent et embarque du monitoring plus un journal d’audit est un programme à six chiffres, et le pipeline de données en est d’ordinaire le poste le plus lourd. La façon fiable de budgéter consiste à chiffrer d’abord le travail de cadrage, parce que le reste de l’estimation change sensiblement selon ce que ce cadrage révèle.
Découvrez comment nous avons créé une application de recrutement basée sur l'IA acquise par un géant américain du recrutement