Un responsable produit agri-tech qui évalue une fonctionnalité d’IA doit défendre trois chiffres : ce que le modèle économise, combien de temps le matériel survit en plein champ, et ce qui se passe quand la connectivité tombe en pleine récolte. L’IA dans l’agriculture, c’est l’utilisation de modèles de machine learning entraînés sur des données de capteurs, de satellites et d’imagerie pour prendre des décisions zone par zone sur l’eau, les intrants chimiques et la date de récolte, en remplaçant les calendriers fixes et les moyennes à l’échelle de la parcelle entière par des prédictions liées au bloc de terrain précis que vous avez devant vous.
Des essais au champ de 2026 validés par les pairs, menés sur des systèmes d’irrigation dans le Midwest américain et au Tamil Nadu, en Inde, situent la fourchette mesurable autour de 12 à 35 pour cent d’eau d’irrigation en moins et de 3 à 4 pour cent de rendement en plus, un écart qui dépend presque entièrement de la ligne de base. Ce sont des résultats d’ingénierie, obtenus dans la plomberie des données bien plus que dans le modèle. Ce guide couvre les endroits où les gains sont documentés, la manière dont ces systèmes échouent, et ce qu’un engagement de services de développement en intelligence artificielle doit construire.
Irrigation de précision et gestion des ressources
L’irrigation est le domaine où l’IA en agriculture de précision offre le retour sur investissement le plus défendable, parce que l’intrant optimisé est déjà équipé d’un compteur. L’eau passe par une vanne pendant un nombre de minutes mesurable, si bien qu’une recommandation peut être auditée sur une facture d’eau plutôt que sur un tableau de bord. C’est ce qui en fait le cas d’IA agri-tech le plus simple à financer.
Comment l'IA décide quand et combien irriguer
Le modèle est un ordonnanceur, pas un oracle. Il lit l’humidité du sol à plusieurs profondeurs, la météo locale et un indice de végétation, puis prédit si la zone racinaire passera sous un seuil propre à la culture avant la prochaine pluie utile.
Une étude de 2026 parue dans Frontiers in Sustainable Food Systems a construit cela comme un classifieur XGBoost en deux étapes sur trois sondes capacitives d’humidité du sol, un capteur de température et d’humidité, et un pluviomètre échantillonnant toutes les 15 minutes. L’analyse SHAP a montré que l’humidité du sol et sa moyenne glissante sur six heures dominaient la décision, ce qui rejoint les principes standard de la FAO-56. Un ordonnanceur qu’un agronome ne peut pas défendre survit rarement à une saison.
Résultats documentés : ce que rapportent les essais au champ de 2026
Deux essais de 2026 ont mesuré la même intervention face à des lignes de base très différentes. L’écart entre leurs résultats est plus instructif que chacun des chiffres pris isolément.
Modèle d’irrigation AI-STGNN
Maïs et soja, Midwest américain (Nebraska, Iowa, Kansas)
12.3% à 15.7%
+3.5% à 4.2%
Irrigation IoT et IA explicable
Riz paddy et légumes, Tamil Nadu, Inde
35.1%
+4.2%
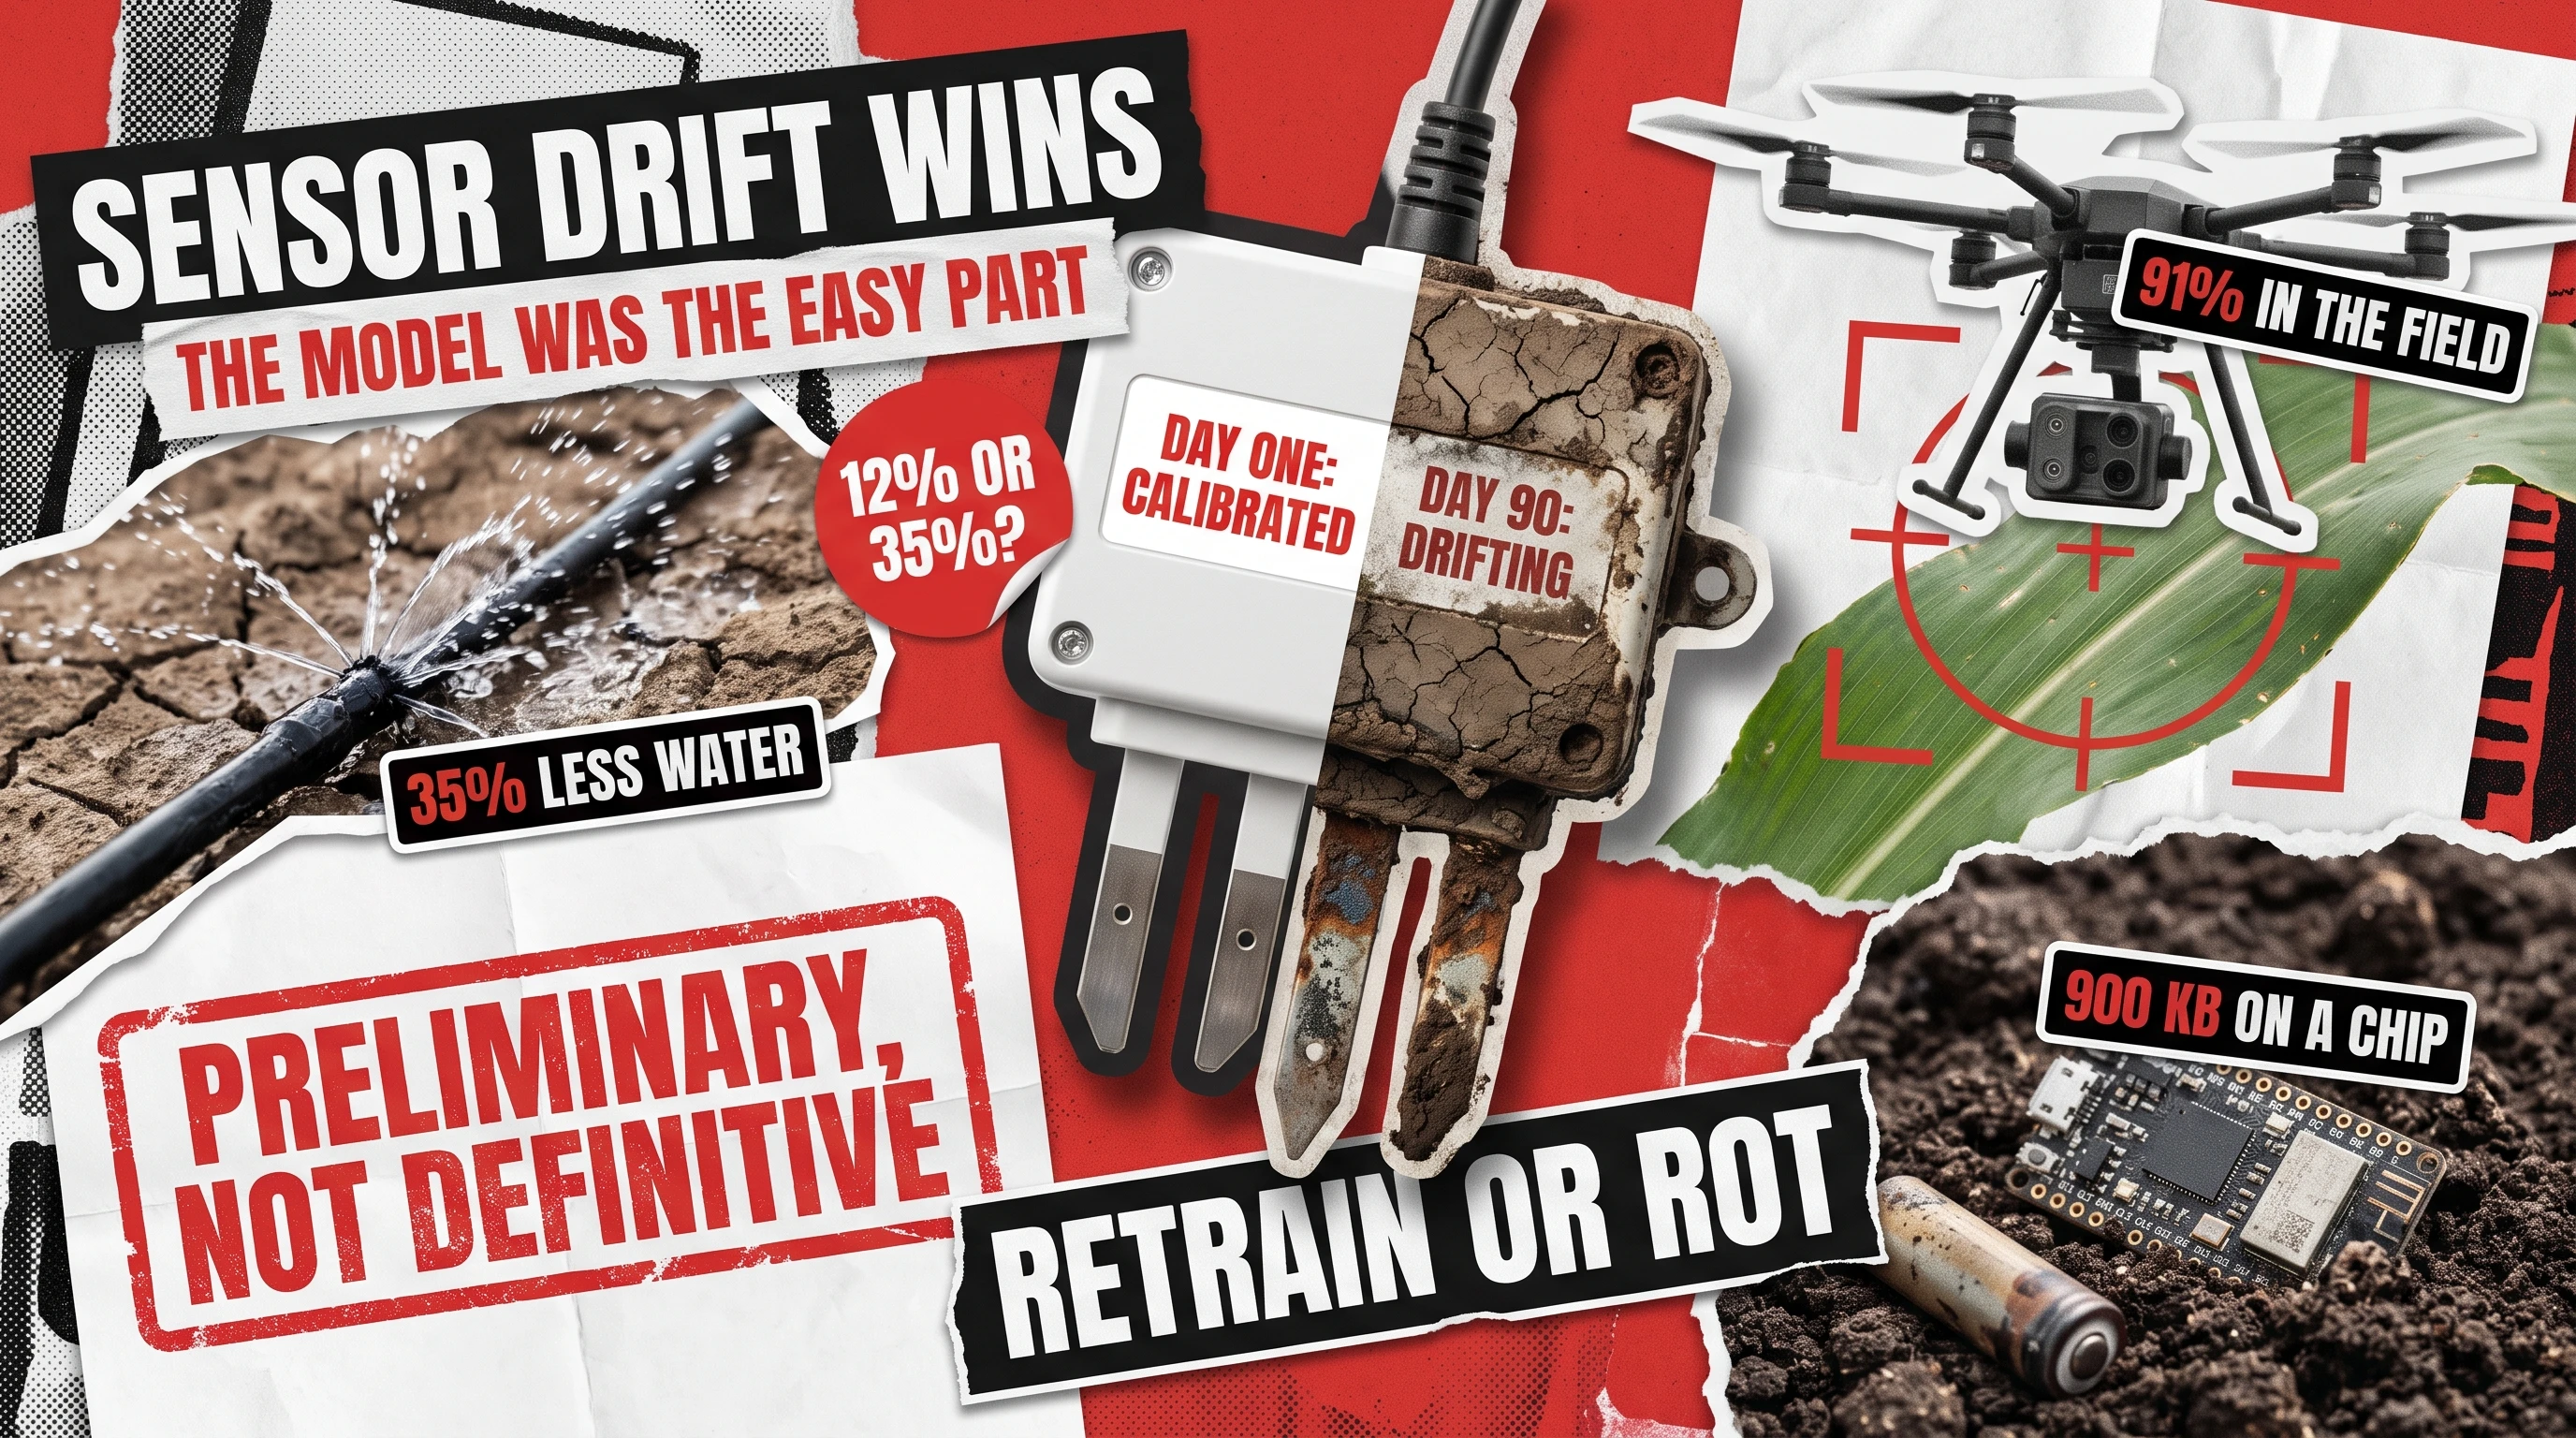
Une réduction de 30 pour cent est bien réelle, et elle se situe en haut de cette fourchette, face à la ligne de base la plus faible disponible. Sur une exploitation du Midwest déjà instrumentée, la même classe de modèle a rendu environ 13 pour cent, et ces auteurs qualifient leurs gains de « préliminaires plutôt que définitifs ». Un dossier économique bâti sur un seul pourcentage d’accroche cache sa ligne de base.
La stack ML derrière l'irrigation de précision
Rien ici n’est exotique, ce qui est une bonne nouvelle pour quiconque doit le budgéter. L’essai du Midwest a utilisé un réseau de neurones sur graphe spatiotemporel dynamique appliqué à l’humidité du sol à trois profondeurs, aux données de stations météo et aux indices de végétation MODIS capturés tous les 16 jours, interpolés en valeurs quotidiennes et rééchantillonnés de 250 mètres à 50 mètres.
L’ingénierie intéressante se trouve dans ce rééchantillonnage, pas dans la famille de modèles. Ses auteurs signalent que le suréchantillonnage introduit des effets de pixels mixtes, et que des valeurs quotidiennes interpolées approchent le développement de la culture au lieu de l’observer. Ces réserves atterrissent dans l’intervalle de confiance que voit un client.
Surveillance des cultures par vision par ordinateur
La surveillance par imagerie est le groupe de cas d’usage de l’IA en agriculture le plus visible, et celui où la précision en laboratoire s’écarte le plus fortement de la précision au champ. Un modèle qui atteint 99 pour cent sur un jeu de données de feuilles soigneusement sélectionné s’effondre souvent sur des images de canopée prises en plein midi, et comprendre pourquoi représente l’essentiel du travail.
Détection des maladies et des ravageurs à partir d'images de drone
Un essai de 2026 publié dans Scientific Reports a fait voler une caméra multispectrale à cinq bandes à 30 mètres au-dessus d’une ferme de maïs de 0.8 hectare dans le Limpopo, en Afrique du Sud, produisant une résolution au sol de 2 centimètres et 725 échantillons étiquetés. Trois classifieurs sur des entrées NDVI, GNDVI et NDRE se sont regroupés étroitement au lieu de se séparer nettement :
- Sain contre malade contre arrière-plan : SVM 91.73% (kappa 0.89), XGBoost 91.53%, Random Forest 91.28%
- Identification de la maladie précise : SVM 89.41% (kappa 0.87), Random Forest 88.96%, XGBoost 88.06%
Deux constats comptent plus que les chiffres de précision. La carence en phosphore a été la plus difficile à isoler, donc certains facteurs de stress sont invisibles dans les bandes multispectrales. Les auteurs de l’essai soulignent eux-mêmes qu’il s’agissait d’un seul champ à une seule date, et le même écart de généralisation apparaît dans les applications de vision par ordinateur dans l’industrie et le commerce de détail.
Identification des adventices et pulvérisation ciblée
La pulvérisation ciblée fait tourner un pipeline similaire sous un budget de latence bien plus serré. L’inférence doit se terminer entre le moment où la caméra voit une plante et celui où la buse passe au-dessus, soit quelques dizaines de millisecondes à vitesse de travail, donc le modèle tourne sur l’outil lui-même.
L’économie s’inverse également. Une adventice manquée coûte une adventice, alors qu’un plant de culture pulvérisé comme une adventice coûte le produit chimique plus un plant endommagé, si bien que c’est l’asymétrie des coûts qui fixe le seuil, et non ce qui maximise le F1. Réglez cela comme un benchmark et le résultat sera statistiquement excellent et agronomiquement inutilisable.
Modèles de maturité des fruits et de date de récolte
La maturité est un problème de régression, et la contrainte porte sur la vérité terrain plutôt que sur l’architecture. Chaque étiquette exige qu’un humain cueille le fruit, mesure la teneur en sucre ou la fermeté, et l’enregistre face à l’image correspondante.
Cette arithmétique décide de la faisabilité. Un modèle couvrant toute une fenêtre de récolte exige des vols répétés sur plusieurs semaines avec un échantillonnage destructif à chaque passage, donc budgétez la main-d’oeuvre au champ avant le temps GPU.
Prévision des rendements et surveillance du bétail
Ces produits semblent sans rapport, et ils se vendent généralement à des acheteurs différents au sein du même client. En dessous, il s’agit du même système avec des capteurs différents branchés dessus, et le reconnaître tôt change la façon dont une feuille de route est séquencée.
Prévision des rendements pour l'assurance, le trading et la logistique
L’acheteur n’est ici, le plus souvent, pas l’exploitation agricole. Les assureurs récolte, les traders de matières premières, les silos à grains et les industriels qui réservent de la capacité ont tous besoin d’une estimation de tonnage défendable des semaines avant la récolte, et ils paient pour un intervalle de confiance plus étroit plutôt que pour une meilleure estimation ponctuelle.
Les entrées sont les mêmes séries satellitaires, historiques météo et données de sol qui alimentent les modèles d’irrigation, agrégées à l’échelle d’une région au lieu d’être descendues jusqu’à la vanne. L’incertitude d’interpolation évoquée plus haut a sa place dans la prévision plutôt que d’être lissée par elle, parce qu’une prévision sans intervalle vend une fausse précision à un client dont le métier est de tarifer le risque.
Signaux de santé du bétail issus des capteurs portés et des caméras
Les capteurs portés produisent un flux continu de données d’activité, de rumination et de localisation, tandis que les caméras fixes produisent des images de démarche et de posture. Les deux alimentent de la détection d’anomalies plutôt que de la classification, parce que la maladie est un écart par rapport à la ligne de base propre à un animal plutôt qu’à une moyenne du troupeau.
Cette définition a de lourdes conséquences d’ingénierie. L’établissement d’une ligne de base par animal devient une exigence de modélisation des données, les premières semaines d’un déploiement ne produisent aucune alerte exploitable par construction, et chaque nouvel animal redémarre son propre compteur. Sautez la couche de ligne de base et les opérateurs couperont le flux d’alertes en moins de quinze jours.
Là où le signal est fort, la précision suit. Une revue du domaine parue en 2025 dans Animal Frontiers cite des classifieurs de boiterie atteignant 96.61 pour cent de précision à partir de données de courbure du dos, un dépistage de la dermatite digitale par vision fonctionnant en temps réel sur un Jetson Xavier NX à 40 images par seconde, et des pipelines de détection de la cétose combinant données portées et données cloud qui atteignent 93.2 pour cent pour l’identification individuelle des animaux. Ces chiffres supposent que la couche de ligne de base évoquée plus haut est déjà en place pour chaque animal.
Pourquoi ces deux cas d'usage partagent la même stack IA de base
Retirez le vocabulaire métier et les deux sont des séries temporelles multivariées irrégulières avec des valeurs manquantes, des lignes de base par entité, et une métrique fondée sur la détection précoce plutôt que sur la précision au moment de l’événement. Ils échouent aussi de manière identique : un capteur se tait, personne ne le remarque, et le modèle continue de prédire avec assurance à partir d’une entrée périmée.
Construisez une seule fois les couches d’ingestion, de gestion des trous, de feature store et de supervision et l’essentiel du deuxième produit existe déjà. C’est l’argument en faveur d’une plateforme unique à plusieurs têtes, et cela décide si un second cas d’usage prend un trimestre ou trois.
Ce que construire un système d'IA agri-tech implique vraiment
L’essentiel du coût de la technologie IA en agriculture n’est pas le modèle. Dans les essais de 2026, l’étape de modélisation est presque triviale : le classifieur pour petites exploitations s’est entraîné en 2.40 secondes sur un CPU standard et infère en 0.004 milliseconde par échantillon. C’est le maintien de ces chiffres à un niveau exploitable en plein champ pendant trois saisons qui absorbe un budget de développement logiciel sur mesure avec IA.

Réseaux de capteurs en environnement à faible connectivité
Le matériel lui-même se révèle être la partie bon marché d’un déploiement à faible connectivité, puisque l’installation du Tamil Nadu tournait sur un microcontrôleur de classe Arduino coûtant environ USD 45 à l’échelle de la parcelle et USD 40 à 50 par passerelle à l’échelle du champ, avec une cellule de 1,000 mAh censée tenir plus de 60 jours sous un protocole de veille profonde.
Le chiffre autour duquel concevoir est le taux de livraison des paquets. Ce déploiement a atteint 99.3 pour cent, soit 25,743 relevés sur 25,920, avec une latence de bout en bout de 4 à 6 secondes. Les 177 manquants sont la vraie spécification, parce que le pipeline a besoin d’un comportement défini pour les trous, les arrivées dans le désordre et les doublons.
Dérive des capteurs et cadence de réentraînement des modèles
Les sondes de sol dérivent assez lentement pour rester invisibles jusqu’à ce qu’elles aient corrompu une saison de décisions. Sur 90 jours, les sondes du Tamil Nadu ont montré un écart maximal de 2.8 pour cent de teneur en eau volumique, juste dans la spécification de 3 pour cent du fabricant, et des sols plus conducteurs peuvent dépasser 5 pour cent de dérive en moins de 60 jours.
Le réentraînement suit la même logique. Ce modèle provient d’un seul déploiement de 90 jours en saison sèche sur un site unique, et ses auteurs indiquent qu’une généralisation géographique ou saisonnière exige un réentraînement sur de nouvelles données étiquetées. Inscrivez dans le contrat à la fois l’intervalle de recalibration et le déclencheur de réentraînement, parce qu’un modèle non maintenu se dégrade silencieusement en passif.
Edge ou cloud : où l'inférence doit s'exécuter
Ce sont la latence et la connectivité qui tranchent, pas le coût. Le modèle du Tamil Nadu a été déployé en edge sous la forme d’un artefact ONNX Runtime quantifié d’environ 900 KB, tandis que l’inférence à l’échelle du district sur 10,000 hectares tournait dans le cloud. Une répartition praticable :
- Inférence en edge quand l’action est locale et contrainte dans le temps, comme ouvrir une vanne, ou quand la connectivité n’est pas fiable
- Inférence dans le cloud quand la décision agrège plusieurs champs ou plusieurs saisons, ou quand le modèle est trop gros pour être quantifié
- Les deux dans la plupart des déploiements réels, avec un petit modèle en edge qui gère l’action et un modèle cloud qui recalcule pendant la nuit et pousse de nouveaux seuils vers le bas
La moitié cloud convient aux charges de travail en rafales, pilotées par événements, et c’est pourquoi un guide de l’architecture serverless vaut la lecture avant d’acheter une infrastructure allumée en permanence pour un système qui calcule intensément deux heures par jour. La moitié edge porte sa propre taxe en mises à jour à distance et en gestion de flotte.
Intégration aux systèmes de gestion agricole et aux flux de marché
Une recommandation qui n’apparaît pas dans le logiciel qu’un opérateur utilise déjà est ignorée, aussi juste soit-elle. Cela implique d’intégrer les plateformes de gestion agricole, la télématique des équipements, les fournisseurs météo et les flux de prix des matières premières, chacun avec son propre modèle d’authentification, ses limites de débit et ses unités. C’est ici que les plannings dérapent, parce que les incohérences d’unités et les comportements d’API non documentés n’apparaissent que sous données réelles, et c’est pourquoi beaucoup d’équipes recrutent une équipe de développement dédiée pour la couche d’intégration.
L'IA convient-elle à votre produit agri-tech ?
Quatre conditions déterminent si une fonctionnalité d’IA agri-tech se rentabilise. Toutes les quatre portent sur les données que vous détenez déjà plutôt que sur l’ambition de l’idée :
- Une saison d’historique étiqueté. Des relevés de capteurs seuls ne sont pas des données d’entraînement. Il vous faut des résultats reliés à des horodatages, ce qui demande une saison que vous ne pouvez pas comprimer
- Une ligne de base mesurable. Les gains ont oscillé de 12 à 35 pour cent uniquement selon ce que le modèle remplaçait, donc une pratique actuelle non quantifiée ne laisse rien à démontrer
- Une action que le logiciel peut déclencher. La valeur apparaît quand une prédiction ouvre une vanne, guide un pulvérisateur ou déclenche une déclaration de sinistre, pas quand elle atterrit dans un PDF
- Un responsable du réentraînement. La recalibration et le réentraînement saisonnier sont des coûts d’exploitation, pas des tâches ponctuelles
Ce que nous construisons régulièrement pour les produits agri-tech, c’est la couche qui sous-tend chacun des cas d’usage ci-dessus : reconnaissance d’images, détection d’objets et analytique prédictive, avec la plomberie .NET et Azure qui les alimente. Sur une plateforme RH, cela a voulu dire entraîner un réseau de neurones sur plus de 1.5 million d’enregistrements dans Azure Machine Learning Studio, exactement la même forme de pipeline qu’une boucle d’ingestion de données de terrain jusqu’à l’inférence, et si vous hésitez à construire cette capacité en interne, notre guide pour recruter des développeurs IA détaille ce qu’il faut vérifier. Si votre produit a besoin de cette même couche de vision par ordinateur et d’analytique prédictive construite autour de vos propres données de capteurs et de terrain, parlons de votre projet agri-tech et nous le cadrerons à partir des données que vous collectez déjà.
Où l'IA dans l'agriculture rentabilise vraiment son investissement
Le schéma qui traverse les données probantes de 2026 est constant. Les gains sont les plus importants là où la pratique remplacée était la plus faible, les plus défendables là où l’intrant optimisé est compté par un compteur, et les plus fragiles là où personne n’est responsable de la recalibration. L’irrigation franchit ces trois barres, et c’est pourquoi elle continue de produire des chiffres publiables pendant que des cas plus tape-à-l’oeil produisent des démos.
La construction elle-même est surtout de l’ingénierie des données sous une étiquette de machine learning : une ingestion qui tolère les trous, des lignes de base par entité, une cadence de réentraînement avec un responsable, et une intégration qui dépose la recommandation là où l’opérateur travaille déjà. Réussissez cela et un modèle modeste battra un modèle excellent nourri de données périmées.
Parlons de votre projet IA et nous partirons des données que vous collectez déjà plutôt que d’un choix de modèle, et nous vous dirons honnêtement ce que vos données actuelles peuvent et ne peuvent pas soutenir avant que vous n’engagiez le moindre budget.
FAQ
Combien coûte la construction d'un système d'IA pour l'agriculture ?
Les coûts matériels fixent rarement le budget d’un système d’IA agri-tech, puisque le déploiement de 2026 au Tamil Nadu chiffrait les noeuds de capteurs à environ USD 45 à l’échelle de la parcelle et USD 40 à 50 par passerelle à l’échelle du champ. Ce qui pilote vraiment le budget logiciel, c’est le nombre de sites de terrain, les intégrations tierces nécessaires et la cadence de réentraînement, plutôt que la complexité du modèle.
De quelles données avez-vous besoin avant de lancer un projet d'IA en agriculture ?
Au minimum une saison complète d’observations avec des résultats reliés à des horodatages. Le volume brut est facile à atteindre et rarement le problème : l’étude d’irrigation de 2026 a collecté 25,920 relevés de capteurs et en a conservé environ 5,000 comme lignes exploitables par le modèle. Ce sont les lignes étiquetées, alignées dans le temps et fiables qui constituent le goulot d’étranglement.
L'IA peut-elle fonctionner dans des exploitations à faible connexion internet ?
Oui, en exécutant l’inférence sur l’appareil plutôt que dans le cloud. Le modèle d’irrigation de 2026 a été compressé à environ 900 KB sous forme ONNX quantifiée et tourne sur du matériel de classe microcontrôleur, avec une autonomie projetée de 60 jours ou plus. La contrepartie, c’est que vous exploitez désormais une flotte d’appareils.
Combien de temps faut-il pour voir le ROI d'un déploiement d'IA en agriculture ?
Comptez une saison de culture pour valider et une deuxième pour faire confiance au résultat. Les études de 2026 ont mesuré sur 90 jours et sur deux saisons, et les deux groupes d’auteurs préviennent que des résultats obtenus sur un seul site ne se généralisent pas sans réentraînement. La recalibration et le réentraînement saisonnier sont des coûts d’exploitation permanents.
Découvrez comment Redwerk a entraîné un réseau de neurones sur 1.5M+ enregistrements pour propulser une plateforme de matching IA, rachetée ensuite par un géant américain du recrutement