L’architecture serverless promet trois choses : aucun serveur à gérer, une montée en charge qui se fait sans vous, et une facture qui suit l’usage réel plutôt que la capacité inutilisée. Sur la bonne charge de travail, elle tient les trois promesses. Les difficultés commencent quand les équipes y voient l’autorisation de bâtir un système entier de cette manière.
L’architecture de calcul serverless est devenue courante pour une partie d’un stack, et rare pour sa totalité. L’enquête annuelle 2024 de la Cloud Native Computing Foundation montre que 44 % des organisations exploitent le serverless en production pour quelques applications, soit six points de plus que l’année précédente, tandis que 11 % seulement y recouraient pour la majorité ou l’ensemble de leurs applications, contre 14 % auparavant. Sur la même période, la part des organisations qui prévoient de ne pas adopter le serverless à court terme est montée à 23 %.
Le coût caché le plus élevé d’une décision serverless, c’est ce qu’il faut pour en sortir. Dès lors que la logique métier centrale repose sur les services propriétaires d’un seul fournisseur, la déplacer suppose de tout reconstruire autour d’API qui n’ont aucun équivalent direct ailleurs, et cela représente un budget de réécriture que personne n’avait prévu.
Redwerk construit les deux types de systèmes. Nos services de développement d’applications cloud couvrent les architectures multi-tenant, les moteurs d’analytique et les processeurs d’événements que le serverless gère bien, et nous savons quelles charges de travail tirent le meilleur parti de ce modèle et lesquelles gagnent à être traitées autrement. Dans cet article, nous verrons comment fonctionne le serverless, où il est rentable, où il coûte plus qu’il ne fait économiser, les cinq questions que nous posons avant de le recommander, et comment migrer une première charge de travail sans tout réécrire.
Qu’est-ce que l’architecture serverless, et ce qu’elle n’est pas
L’architecture serverless est un modèle cloud dans lequel le fournisseur exécute votre code dans des conteneurs sans état, déclenchés par des événements, et ne vous facture que le temps d’exécution. Elle convient aux traitements événementiels, aux trafics en pics et aux produits en phase de lancement. Elle est mal adaptée à une logique métier centrale qui exige une piste d’audit complète et immuable, et elle est rarement le bon choix pour un système entier.
Le mécanisme qui la rend possible s’appelle Function-as-a-Service, ou FaaS. Vous déployez une fonction, le fournisseur l’exécute dans un conteneur éphémère lorsqu’un événement la déclenche, puis le conteneur disparaît. Vous ne choisissez jamais une taille d’instance, vous ne patchez aucun système d’exploitation et vous ne configurez aucun groupe d’autoscaling. La plupart des architectures cloud serverless réelles associent le FaaS à du Backend-as-a-Service, ou BaaS : bases de données managées, authentification, stockage de fichiers et files de messages également exploitées par le fournisseur. Un stack typique se compose d’une fonction pour la logique, d’un store NoSQL managé pour les données, d’un service d’authentification hébergé pour l’identité et d’un bus d’événements qui relie le tout.
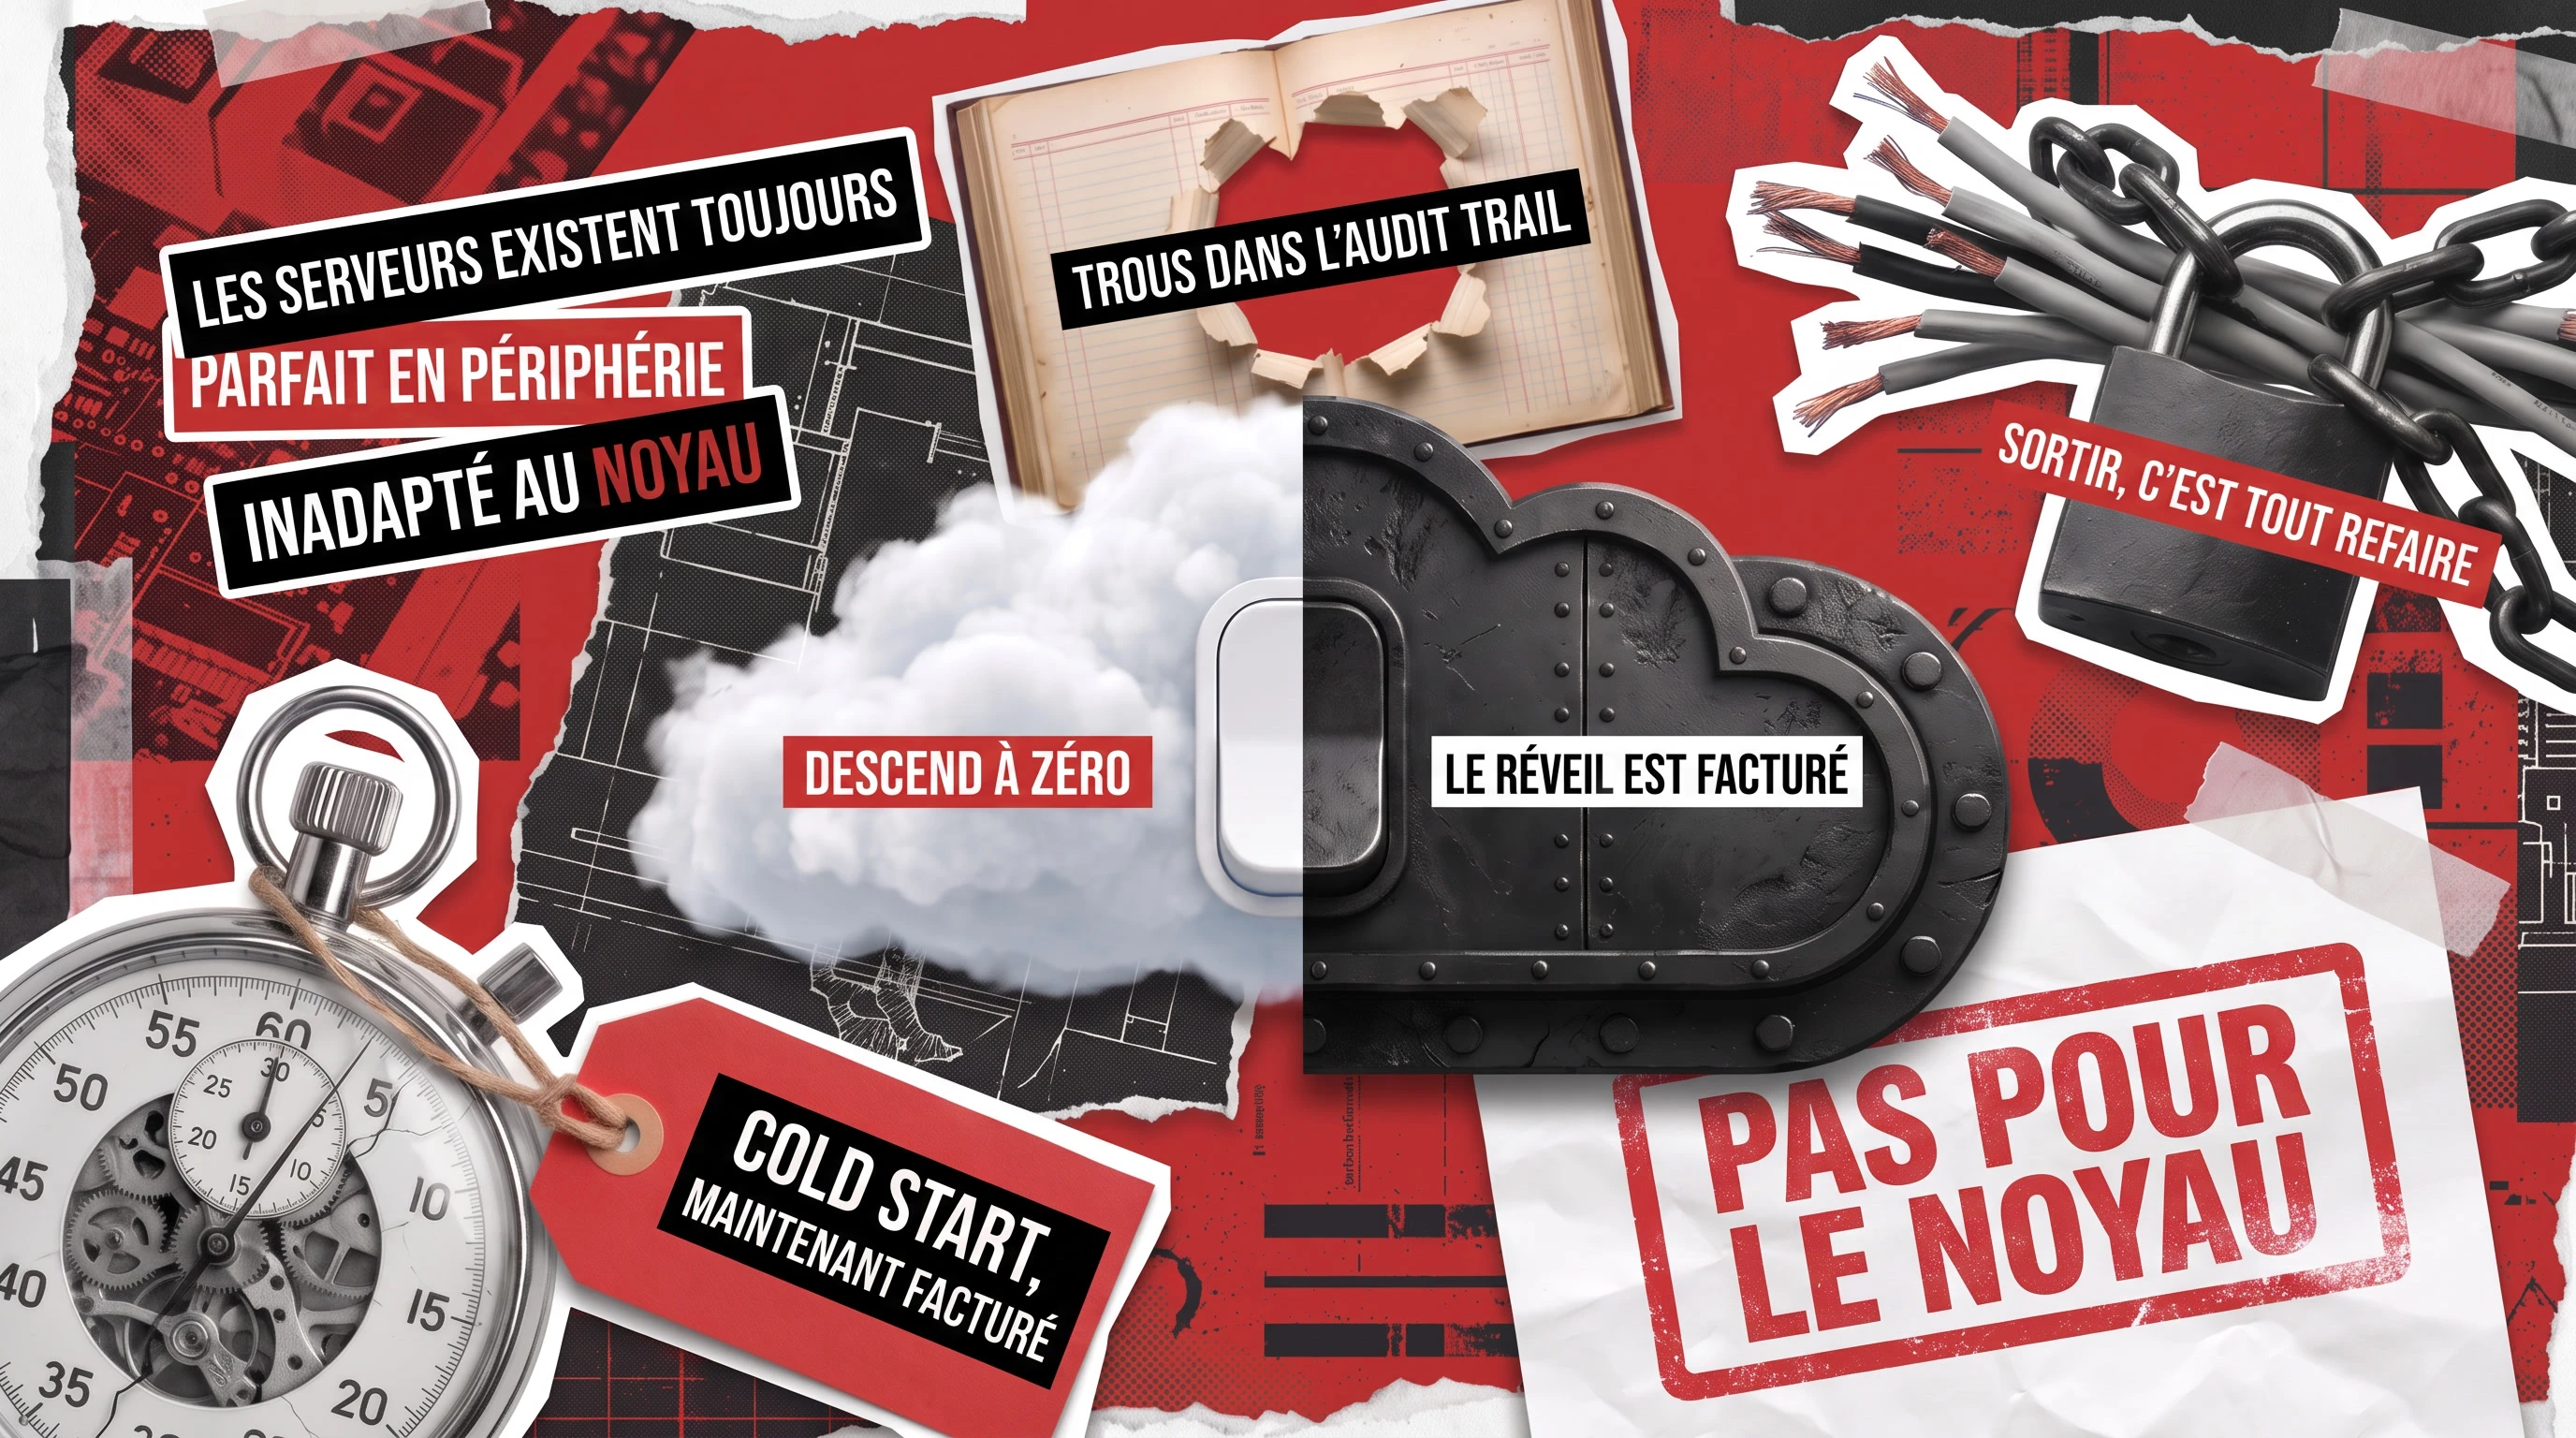
Le nom entretient la seule idée fausse qui mérite d’être corrigée. Les serveurs existent toujours. Quelqu’un continue de les patcher, de planifier leur capacité et d’alerter un ingénieur quand ils tombent. Ce quelqu’un est le fournisseur cloud plutôt que votre équipe, ce qui change la répartition de la charge opérationnelle, pas les lois de la physique. Tous les grands fournisseurs cloud commercialisent désormais une plateforme de ce type, dont Amazon Web Services avec Lambda, Microsoft Azure avec Azure Functions et IBM avec Cloud Code Engine : le modèle est donc disponible là où votre infrastructure se trouve déjà.
Les véritables avantages de l’architecture serverless
Les avantages de l’architecture serverless sont concrets, et ils profitent surtout aux équipes qui n’ont ni plateforme dédiée ni fonction DevOps. Chacun vous fait gagner soit de l’argent, soit des heures d’ingénierie. Les principaux bénéfices de l’architecture serverless :
- Aucune gestion d’infrastructure. Pas de provisioning, pas de patching de système d’exploitation, pas de planification de capacité pour le calcul sous-jacent. Le temps d’ingénierie passe du maintien en bonne santé des serveurs à l’écriture de la logique métier.
- Une montée en charge que vous ne configurez pas. Une fonction qui traite dix requêtes par minute en traite dix mille sans le moindre changement de configuration. Pour un trafic que vous ne pouvez sincèrement pas prévoir, cela supprime toute une catégorie d’incidents.
- Une facturation à l’usage. Vous payez le temps d’exécution, pas une capacité qui dort la nuit. Un batch qui tourne quatre minutes par jour coûte à peu près quatre minutes par jour.
- Un time to market plus court pour les charges qui s’y prêtent. Faire l’économie de la couche infrastructure retire de vraies semaines à un développement initial, ce qui vaut d’autant plus cher quand vous avez une date de lancement et aucune équipe plateforme.
Les données d’adoption chez les trois grands clouds montrent à quel point la pratique s’est banalisée. La télémétrie de Datadog auprès des clients cloud place Lambda chez 65 % des clients AWS, Cloud Run chez 70 % des clients Google Cloud et App Service chez 56 % des clients Azure.

Les compromis du serverless que personne ne met dans sa présentation
Chacun des avantages ci-dessus est réel. Tout ce qui suit l’est aussi, et les présentations des fournisseurs sont en général plus discrètes sur cette moitié. Ces quatre compromis sont ceux qui, sur des projets réels, créent de véritables problèmes de budget et de conformité.
Le vendor lock-in. Dès qu’un système s’appuie sur Lambda pour le calcul, DynamoDB pour les données, EventBridge pour les événements et Cognito pour l’identité, quitter AWS n’est plus une migration. Ces quatre services n’ont aucun équivalent immédiat sur Azure ou Google Cloud : le chantier consiste à reconstruire en même temps la couche d’intégration, le modèle de données et le parcours d’authentification. Faire ce choix en connaissance de cause est raisonnable, mais le découvrir deux ans plus tard, quand une acquisition ou une décision d’achat impose un déménagement, coûte cher.
Les cold starts, qui coûtent désormais de l’argent en plus des millisecondes. Si une fonction est restée inactive, le fournisseur doit construire un environnement neuf avant que votre code puisse s’exécuter, et la personne à l’origine de la requête attend. Cette pause représente d’ordinaire une fraction de seconde, que personne ne remarque dans un rapport nocturne et que tout le monde remarque sur un écran qu’il a sous les yeux.
Depuis le 1er août 2025, l’attente apparaît aussi sur la facture. AWS facture désormais la phase de démarrage d’une fonction, alignant la configuration la plus courante sur le mode de facturation déjà appliqué aux autres. AWS indique que la plupart des clients constateront un impact minime, car les démarrages ne concernent qu’une faible part du total des requêtes. Les équipes qui le ressentent vraiment exploitent de nombreuses fonctions peu sollicitées, où les démarrages représentent une part importante du total. Le même compromis apparaît dans l’infrastructure d’IA : AWS Bedrock AgentCore fait tourner des agents sur un modèle Lambda serverless qui descend à zéro à l’inactivité et paie ce choix par un délai de démarrage sur tout ce qu’une personne attend.
L’observabilité devient plus difficile. Déboguer une requête qui a traversé un seul service bien délimité revient à lire un seul flux de logs. Déboguer une requête qui s’est ramifiée sur neuf fonctions éphémères suppose de corréler neuf flux de logs pour des conteneurs qui n’existent plus, et c’est pourquoi le tracing distribué cesse d’être optionnel. Le problème se règle, mais c’est un travail qu’un monolithe ne génère tout simplement pas.
L’audit et la conformité sont le problème le plus dur. Lorsqu’une charge de travail exige un enregistrement complet et immuable de chaque opération touchant des données réglementées ou sensibles, la nature éphémère et distribuée des fonctions serverless rend cet enregistrement plus difficile à garantir de façon constante qu’un pipeline de journalisation unique et maîtrisé.
Quand l’architecture serverless est le bon choix
Savoir quand utiliser l’architecture serverless est surtout une question de position de la charge de travail par rapport à votre produit central. Le schéma qui fonctionne, c’est du serverless aux extrémités du système, sur des traitements naturellement événementiels et tolérants à un peu de latence. Trois cas s’y prêtent suffisamment bien pour que nous les recommandions sans hésiter.
Les tâches de fond événementielles et les fonctions auxiliaires sont le cas le plus adapté : traitement d’images après un upload, rapport nocturne, gestionnaire de webhook, diffusion de notifications. Aucun de ces traitements n’est le cœur de l’application, tous sont déclenchés plutôt que continus, et quelques centaines de millisecondes de délai de démarrage ne gênent personne.
Le trafic en pics ou imprévisible vient en deuxième. Si votre charge est une ligne plate, la capacité réservée est en général moins chère. Si votre charge ressemble à une vente de billets, à une échéance fiscale ou à un pic de campagne, payer le pic toute l’année est un gaspillage que le serverless supprime.
Les produits en phase de lancement viennent en troisième. Une équipe qui n’a pas encore recruté son premier ingénieur plateforme obtient une couche opérationnelle de niveau production sans avoir à la construire, ce qui lui rend les semaines qui seraient sinon passées en infrastructure avant la première release.
Quand nous écartons le serverless
Écartez le serverless pour la logique applicative centrale quand la charge de travail exige une piste d’audit complète et immuable. La nature éphémère et distribuée des fonctions serverless rend cette piste plus difficile à garantir qu’un pipeline de journalisation unique et maîtrisé, et une discussion de conformité est un mauvais endroit pour employer les mots « plus difficile à garantir ».
Cela se produit sur de vrais projets. Change & Innovation Agency est un SaaS d’e-gouvernement conforme à 100 % à l’Americans with Disabilities Act (ADA), utilisé par les services d’aide sociale à travers les États-Unis, avec des exigences de conformité comparables à celles de la santé. Chaque opération touchant des données de dossier doit pouvoir être reconstituée à la demande, des années plus tard, sans aucune lacune. Pour un cœur de ce type, nous avons choisi une architecture conventionnelle et maîtrisée, ce qui relève du même raisonnement que le stack technique SaaS que nous choisirions vraiment.
La même logique s’applique bien au-delà des secteurs réglementés. Dès lors que vous devez pouvoir prouver exactement ce qui est arrivé à un enregistrement donné, une architecture qui vous donne un unique chemin auditable vaut mieux qu’une architecture qui descend à zéro.
Architecture serverless vs microservices vs architecture traditionnelle
Architecture serverless vs microservices est la comparaison qui crée le plus de confusion, car les deux termes répondent à des questions différentes. Le serverless porte sur qui gère l’environnement d’exécution. Les microservices portent sur la façon dont vous découpez l’application en éléments déployables. Ce sont deux décisions indépendantes, et toutes les combinaisons sont possibles, y compris un monolithe serverless et une flotte de microservices conteneurisés.
La plupart des systèmes qui méritent d’être exploités finissent par combiner des éléments des trois colonnes ci-dessous, ce qui correspond aussi à notre façon d’aborder l’architecture scalable en général. Les mêmes données Datadog le confirment : 66 % des organisations qui utilisent des fonctions serverless exploitent aussi au moins un service d’orchestration de conteneurs. La vraie question est donc de savoir quelles parties vont où.
Qui gère l’environnement d’exécution
Le fournisseur cloud
Votre équipe, via un orchestrateur
Votre équipe, de bout en bout
Mode de montée en charge
Automatique, par requête
Règles configurées, par service
Manuelle ou verticale
Ce que vous payez
Uniquement le temps d’exécution
Capacité réservée ou allouée
Capacité provisionnée
Latence de cold start
Un facteur réel
Minimale une fois le service lancé
Aucune
Portabilité entre clouds
La plus faible
Élevée, surtout avec Kubernetes
La plus élevée
Effort pour la piste d’audit
Le plus élevé
Modéré
Le plus faible
Cas d’usage idéal
Traitements événementiels, en pics, auxiliaires
Services centraux à grande échelle
Cœurs stables, fortement couplés, régulés
Les bonnes pratiques de l’architecture serverless si vous choisissez cette voie
Les bonnes pratiques de l’architecture serverless qui comptent sont celles qui empêchent les compromis ci-dessus de se transformer en incidents. Toutes les quatre sont peu coûteuses à adopter au début d’un projet et chères à rattraper sur un projet déjà en production. Nous les appliquons à chaque composant serverless que nous livrons.
- Gardez des fonctions petites et à usage unique, et gardez avec elles un package de déploiement léger. Le temps de démarrage varie avec ce que vous chargez : un package allégé est donc désormais une optimisation à la fois de latence et de facturation.
- Concevez chaque fonction pour qu’elle soit idempotente. Les sources d’événements réessaient, et les livraisons en double sont normales plutôt qu’exceptionnelles : exécuter deux fois le même événement doit produire le même résultat qu’une seule exécution.
- Centralisez la journalisation et le tracing distribué dès le premier jour. Des identifiants de corrélation propagés dans chaque fonction et une destination unique pour les logs coûtent une après-midi au début d’un projet, et des semaines après un incident.
- Limitez le couplage propriétaire là où la portabilité a une valeur métier. Garder la logique métier en code standard, avec les services du fournisseur derrière une interface fine, préserve la possibilité de déménager sans renoncer au modèle.
Comment décider, un cadre pratique
Cinq questions tranchent la plupart des décisions serverless, et ce sont les cinq mêmes que nous passons en revue lors d’une discussion d’architecture avant de recommander quoi que ce soit. Répondez-y pour une charge de travail à la fois, car le cœur de votre produit et les traitements qui l’entourent aboutissent généralement à des réponses différentes.
- Quelle est la forme du trafic ? Stable et prévisible plaide pour de la capacité réservée. En pics, saisonnier ou inconnu plaide pour le serverless.
- Quelles sont les exigences d’audit et de conformité ? Si une piste complète et immuable est obligatoire pour cette charge de travail, laissez-la en dehors du serverless.
- Quelle échelle attendez-vous dans deux à trois ans ? Une tarification à la requête bon marché à un million d’invocations par mois mérite d’être modélisée à cinquante millions.
- De quelle capacité DevOps disposez-vous réellement en interne ? L’absence d’équipe plateforme est un argument fort en faveur du serverless. Une équipe plateforme mature réduit nettement l’écart.
- Dans quelle mesure cette charge de travail est-elle centrale pour le produit ? Les traitements auxiliaires et événementiels s’y prêtent naturellement. Le système de référence, en général non.
Si deux ou trois de ces réponses restent incertaines, cette incertitude mérite d’être levée avant le développement. Nos services de spécification fonctionnelle existent pour mettre d’abord sur le papier une revue d’architecture lucide.
Comment démarrer une migration serverless sans tout réécrire
Une fois la décision prise sur une charge de travail donnée, le risque change de nature. La question n’est plus s’il faut migrer, mais quelle part migrer d’un coup. La réponse est presque toujours plus modeste que ce que l’équipe imagine.
Choisissez un service bien délimité et ne migrez que celui-là. Un bon premier candidat a une entrée claire, une sortie claire et aucun état partagé. En pratique, il s’agit de quelque chose qui se trouve déjà hors du chemin transactionnel, comme un export de documents ou un seul endpoint d’API. Dirigez une partie du trafic réel vers lui, laissez l’original tourner et comparez les deux sur un cycle de facturation complet.
Quatre éléments déterminent si la deuxième migration sera plus simple que la première :
- Vitesse de rollback. Vous devez pouvoir renvoyer le trafic vers le chemin d’origine en quelques minutes, pas en quelques jours.
- Corrélation des traces. La nouvelle fonction doit émettre des traces que vous pouvez aligner sur l’ancien chemin.
- Propriété des données. Vérifiez si les données qu’elle touche lui appartiennent vraiment ou restent partagées avec le monolithe.
- Coût du double fonctionnement. Chiffrez ce que coûte le maintien des deux chemins pendant toute la durée du recouvrement.
C’est ce dernier point qui prend les équipes au dépourvu. Une migration partielle revient à payer deux fois la même capacité jusqu’à son terme. Ce recouvrement est la véritable ligne budgétaire, pas le prix à l’invocation.
On nous appelle souvent quand la démarche est déjà enlisée, et le tableau est presque toujours le même : deux ou trois fonctions en production, le monolithe encore maître des données, et personne de tout à fait sûr de savoir quel système fait référence. Les équipes qui l’évitent terminent une migration avant d’en commencer une autre.
Les architectures solides sont presque toujours hybrides
Le serverless n’est pas un engagement du tout ou rien, et le traiter comme tel est la raison pour laquelle des équipes finissent soit par payer une capacité inutilisée dont elles n’ont jamais eu besoin, soit par expliquer un trou dans un journal d’audit. Les architectures les plus solides que nous avons livrées sur plus de 250 plateformes depuis 2005 placent le serverless là où il apporte de la valeur, sur les traitements événementiels et auxiliaires, et gardent la logique centrale et sensible à la conformité sur des services traditionnels ou conteneurisés.
Si vous arbitrez cette question sur un système réel, contactez-nous pour discuter de votre architecture : nous vous dirons quelles charges de travail relèvent du serverless, lesquelles non, et ce que coûte chaque option, avant que vous n’engagiez du temps d’ingénierie dans la mauvaise direction.
FAQ
Quels sont les avantages et les inconvénients de l’architecture serverless ?
Les avantages sont l’absence de gestion d’infrastructure, la montée en charge automatique, la facturation à l’usage et une livraison plus rapide pour les charges de travail adaptées. Les inconvénients sont le vendor lock-in via les services propriétaires, la latence de cold start qu’AWS facture depuis août 2025, un debugging plus difficile à travers des fonctions distribuées, et la difficulté à garantir une piste d’audit complète et immuable.
Quand ne faut-il pas utiliser l’architecture serverless ?
Évitez-le pour une logique applicative centrale qui exige une piste d’audit complète et immuable, pour un trafic stable et prévisible où la capacité réservée coûte moins cher, et pour les parcours utilisateur critiques en latence où les cold starts sont inacceptables. Les exigences de portabilité sont une autre raison de rester prudent, puisque les services managés propriétaires sont la partie la plus difficile de toute sortie du cloud.
Le serverless coûte-t-il moins cher que des conteneurs ?
Cela dépend entièrement de la forme du trafic. Le serverless est généralement moins cher pour des charges en pics à faible taux d’utilisation, parce que vous ne payez rien pendant l’inactivité. Les conteneurs sont généralement moins chers à charge stable et à fort volume, où la tarification à la requête grimpe plus vite que la capacité réservée. Modélisez vos propres volumes d’invocations à l’échelle projetée plutôt que de présumer d’un sens ou de l’autre.
L’architecture serverless est-elle la même chose que les microservices ?
Non. Le serverless décrit qui gère l’environnement d’exécution, et les microservices décrivent la façon dont l’application est découpée en éléments déployables indépendamment. Vous pouvez faire tourner un monolithe sur des fonctions serverless ou des microservices sur vos propres serveurs, et la plupart des systèmes en production mélangent les deux modèles.
Serverless signifie-t-il qu’il n’y a plus de serveurs ?
Non. Des serveurs exécutent toujours votre code, mais c’est le fournisseur cloud qui les provisionne, les patche et les fait monter en charge, au lieu de votre équipe. Le changement porte sur qui supporte la charge opérationnelle, pas sur l’existence des serveurs.
Comment migrer vers le serverless sans tout réécrire ?
Déplacez une capacité à la fois et laissez le reste tranquille. Commencez par quelque chose d’autonome, sans écritures partagées et avec une frontière évidente, puis faites passer une fraction du trafic de production en miroir avant de vous engager. Gardez l’ancien chemin au chaud jusqu’à ce que le nouveau ait survécu à une facture entière. Prévoyez de financer les deux le temps qu’il faudra, ce qui est en général le coût que l’on oublie.
Découvrez comment nous avons aidé AWE Learning à migrer de l'infrastructure sur site vers le cloud, et à atteindre des utilisateurs au-delà des États-Unis en mettant en œuvre une solution SaaS évolutive