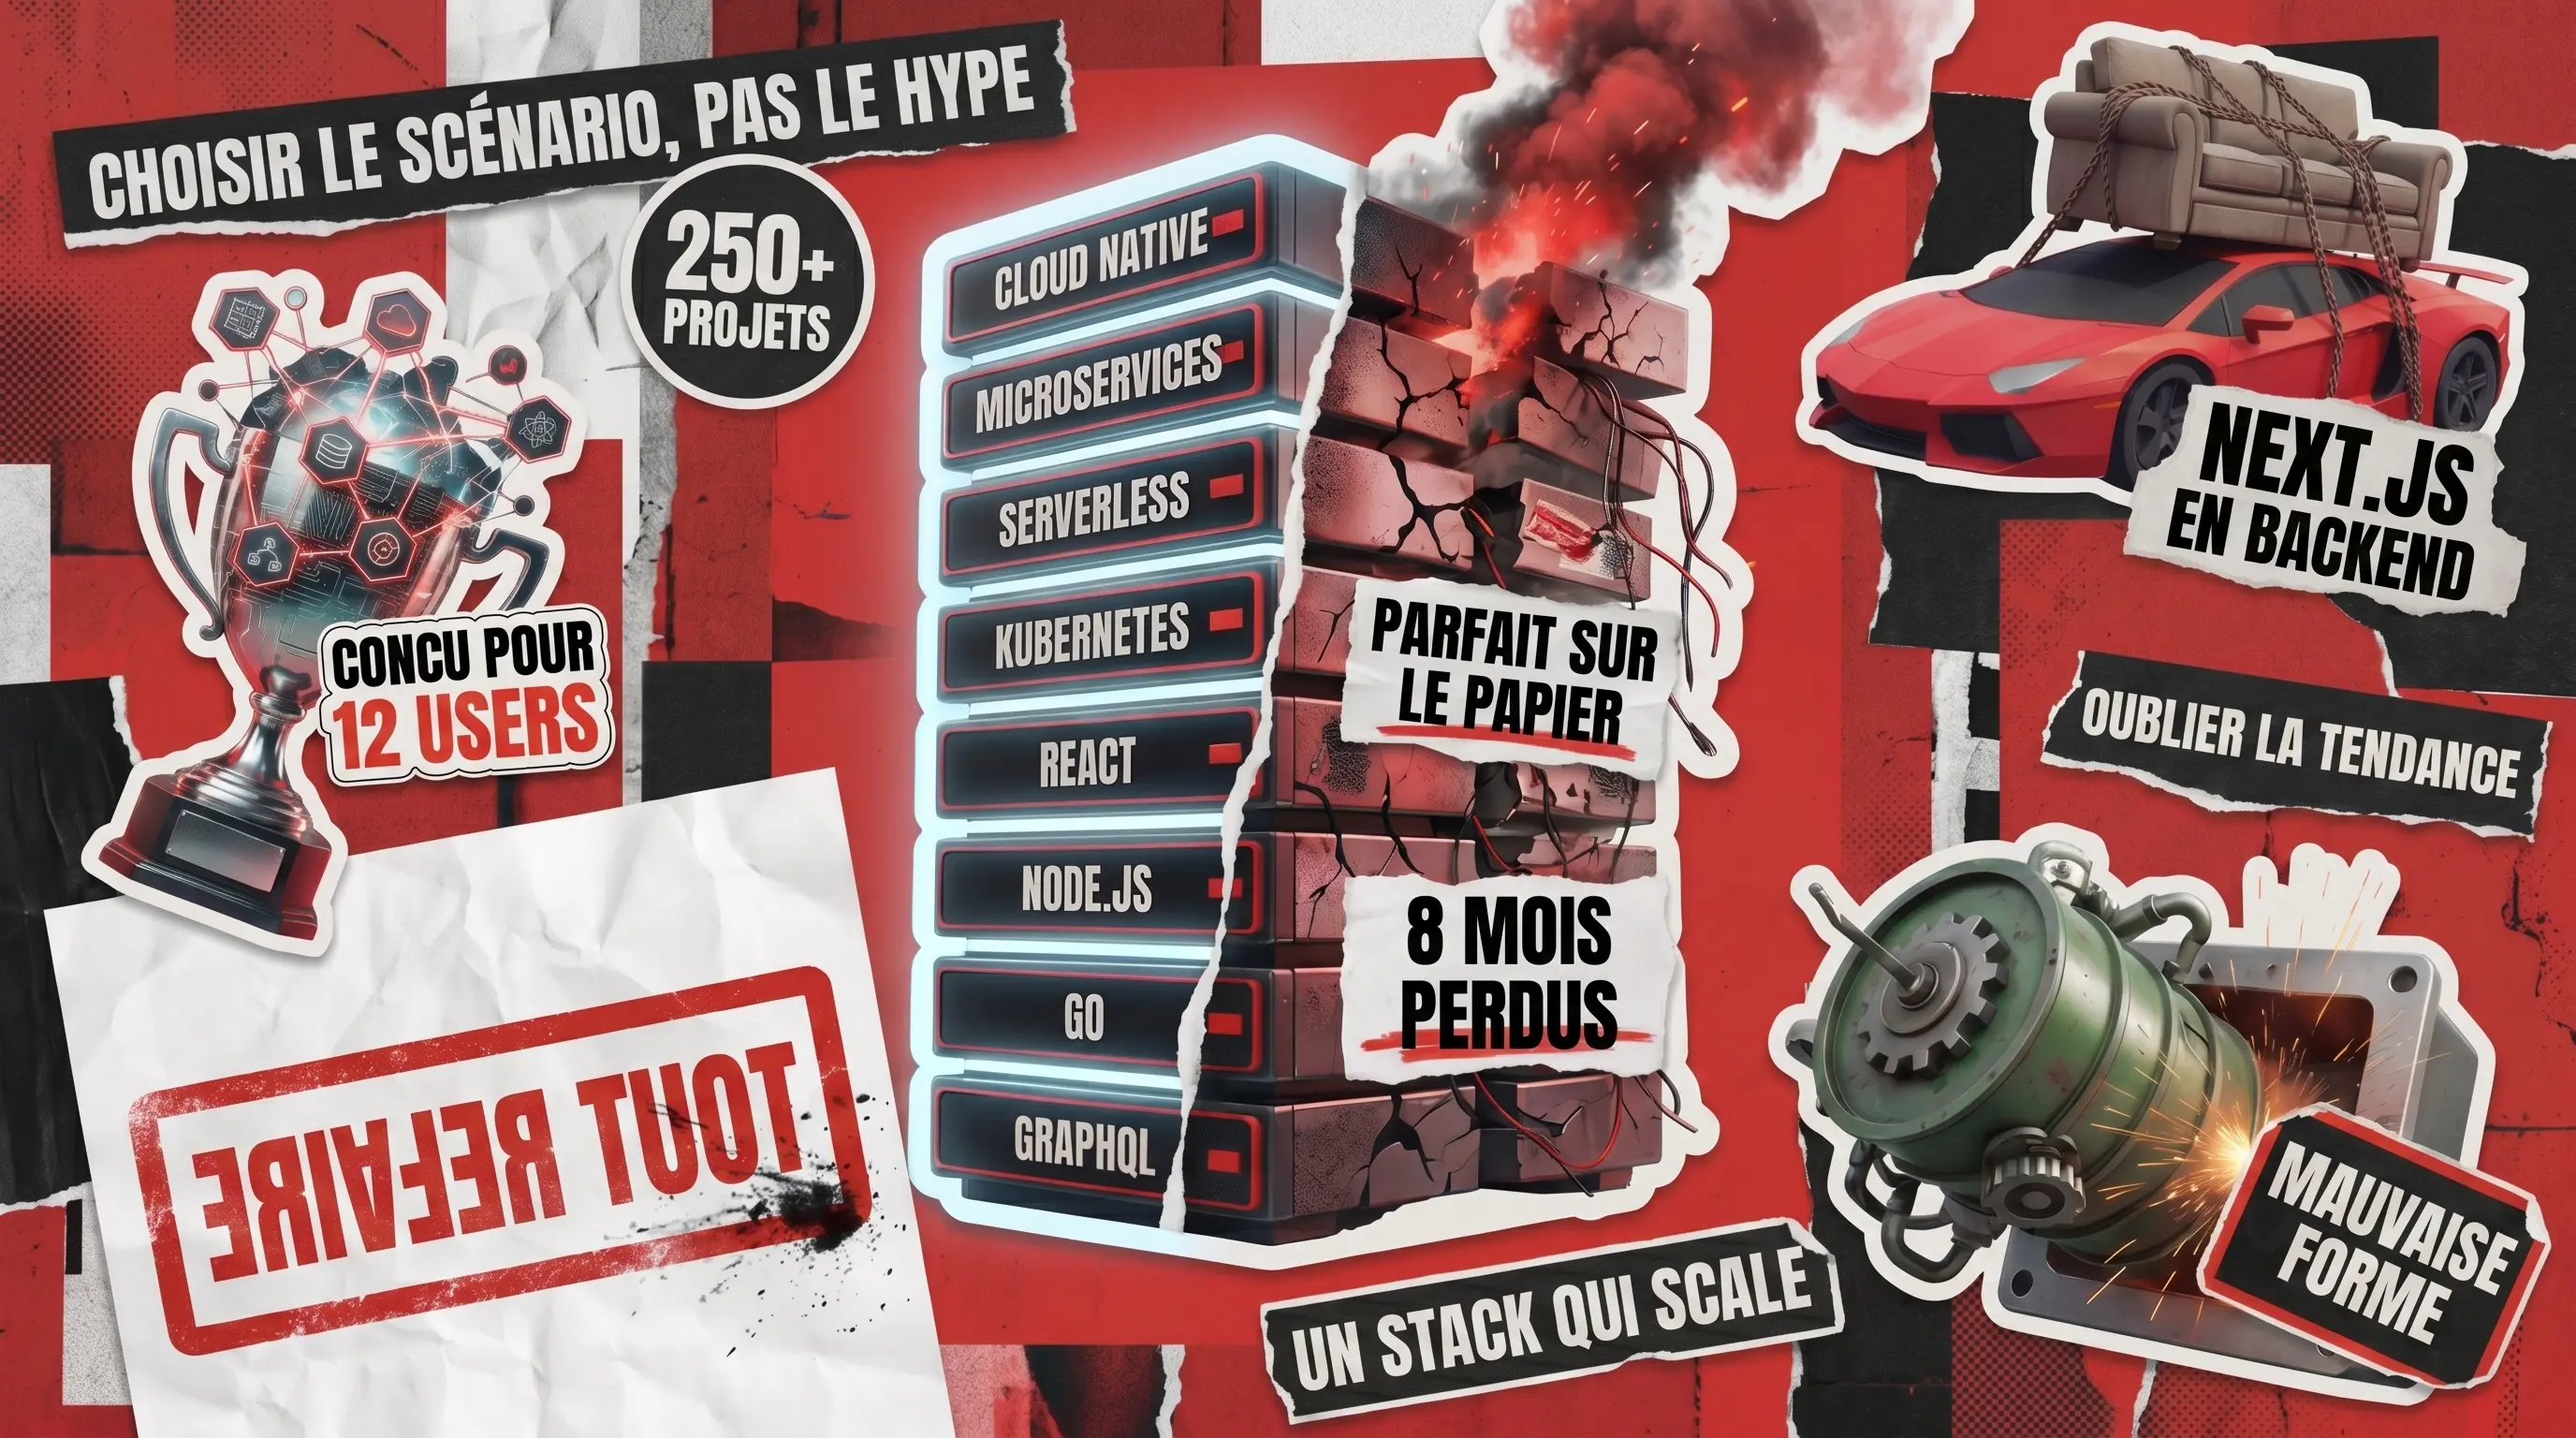
Une pile technologique tendance fait très bonne impression sur un CV, jusqu’à ce qu’elle vous coûte huit mois de développement et une réécriture complète. C’est pourquoi le choix de votre pile technologique SaaS doit être basé sur vos objectifs et votre portée, et non sur la technologie la plus en vogue du moment.
Il y a quelques années, un fondateur nous a contactés avec un produit qui commençait enfin à décoller. L’adéquation au marché était solide et la base d’utilisateurs explosait. Le problème ? Leur backend fonctionnait comme une bombe à retardement. L’équipe de développement initiale avait choisi sa pile technologique en se basant sur un article de blog très bien classé, plein de battage médiatique, qui ne pouvait pas supporter une mise à l’échelle réelle. Au lieu de créer des fonctionnalités, ils se battaient contre leur propre infrastructure, ce qui est la première chose à surveiller lors du développement SaaS.
Alors que le marché mondial des SaaS devrait passer de 375 milliards de dollars cette année à plus de 1 250 milliards de dollars d’ici 2034, vous ne pouvez pas vous permettre de gaspiller une seule heure d’ingénierie. Et nous sommes là pour vous aider.
Après 20 ans et plus de 250 projets livrés dans le monde, nous ne sommes pas là pour vous donner une liste passive de frameworks et vous souhaiter bonne chance. Nous vous donnons la pile technologique exacte à utiliser pour votre scénario spécifique, la technologie surcotée que vous devriez absolument éviter, et un regard brutal sur le coût réel des mauvaises décisions d’architecture pour une entreprise en croissance.
Pourquoi « La meilleure pile technologique SaaS » est la mauvaise question
Chaque semaine, quelqu’un publie un article classant les meilleures piles technologiques SaaS et aboutissant à la même réponse : React côté frontend, Node.js ou Python côté backend, PostgreSQL pour la base de données, et AWS ou Vercel pour l’hébergement. Cette réponse n’est pas fausse, mais elle est incomplète d’une manière qui coûte cher aux fondateurs.
La meilleure pile technologique pour le SaaS dans le domaine de la santé, comme une plateforme de conformité, ne ressemble en rien à la meilleure pile technologique pour une place de marché en phase initiale. Pendant ce temps, la meilleure pile pour un produit SaaS natif d’IA n’a presque aucun chevauchement avec la pile appropriée pour une plateforme horizontale multi-tenant servant des clients d’entreprise. Choisir la mauvaise ne crée pas seulement de la dette technique, mais crée le genre de problème structurel qui oblige une équipe à arrêter de construire de nouvelles fonctionnalités pendant six mois tout en réparant les fondations.
Comparaison des piles technologiques SaaS : Les cinq scénarios en un coup d'œil
Chaque scénario ci-dessous reflète une étape distincte de maturité du produit et un ensemble distinct de risques commerciaux. La pile technologique appropriée n’est pas toujours la plus populaire, c’est celle qui correspond à l’état actuel de votre produit et à ce qu’il doit accomplir au cours des douze prochains mois. Portez une attention particulière à la dernière colonne : savoir quoi laisser de côté est tout aussi précieux que de savoir quoi inclure.
MVP initial
Premier produit, délai serré, équipe de 2-5 personnes
React + Next.js
Node.js
PostgreSQL
AWS
Microservices, MongoDB pour les données relationnelles
SaaS B2B en phase de mise à l’échelle
Clients d’entreprise, exigences de conformité, SSO
React
Python (Django / FastAPI) ou .NET
PostgreSQL
AWS ou Azure
Next.js pour une logique backend lourde
SaaS natif IA
Charges de travail ML comme proposition de valeur principale
React
Python + FastAPI
PostgreSQL + pgvector
AWS
LangChain en production
SaaS réglementé / de santé
Conformité HIPAA, gouvernementale, financière
React
.NET (ou Python)
PostgreSQL (chiffré, géré)
Azure
Serverless pour la logique principale
SaaS horizontal multi-tenant
Nombreux clients, une plateforme, infrastructure partagée
React
Python ou Node.js
PostgreSQL (sécurité au niveau des lignes)
AWS ou Azure
Microservices prématurés
Meilleure pile technologique pour SaaS par scénario
Les cinq scénarios que nous couvrons dans cet article sont ceux que nous rencontrons le plus souvent chez Redwerk :
- MVP (produit minimum viable) en phase initiale avec peu de ressources et un délai encore plus court
- SaaS B2B en phase de mise à l’échelle avec des clients d’entreprise et des exigences de conformité
- SaaS natif d’IA avec des charges de travail d’apprentissage automatique au cœur du produit
- SaaS réglementé et de santé où la sécurité est non négociable
- SaaS horizontal multi-tenant servant de nombreux clients sur une seule plateforme
Pour chacun d’entre eux, nous vous dirons avec quoi nous construirions, ce que nous éviterions, et pourquoi.
Quelle est la meilleure pile technologique pour un MVP SaaS en phase initiale ?
Le rôle d’une pile technologique MVP est de vous permettre d’atteindre le marché rapidement, de maintenir une petite équipe et de laisser la porte ouverte au changement. Il ne s’agit pas d’impressionner les investisseurs par la sophistication architecturale. Nous avons vu trop de fondateurs en phase initiale passer trois mois à concevoir une architecture de microservices pour un produit qui avait douze utilisateurs.
Ce que nous choisirions :
React avec Next.js est le bon choix côté frontend ici : l’écosystème est énorme, le recrutement est simple, et il gère le rendu côté serveur et côté client sans vous forcer à prendre cette décision à l’avance. Côté backend, Node.js fonctionne bien lorsque l’équipe est petite et doit naviguer sur toute la pile sans changer de contexte entre les langages. PostgreSQL est la base de données que nous privilégions dans presque tous les scénarios. Elle gère correctement les données relationnelles, prend en charge le stockage flexible de documents grâce à son type de colonne JSONB, et évolue plus loin que ce que la plupart des produits en phase initiale auront jamais besoin.
Du côté de l’infrastructure, une plateforme gérée comme AWS (Amazon Web Services) avec un déploiement de conteneurs simple maintient la complexité opérationnelle à un niveau bas. Vous n’avez pas besoin de Kubernetes à ce stade.
Ce que nous éviterions :
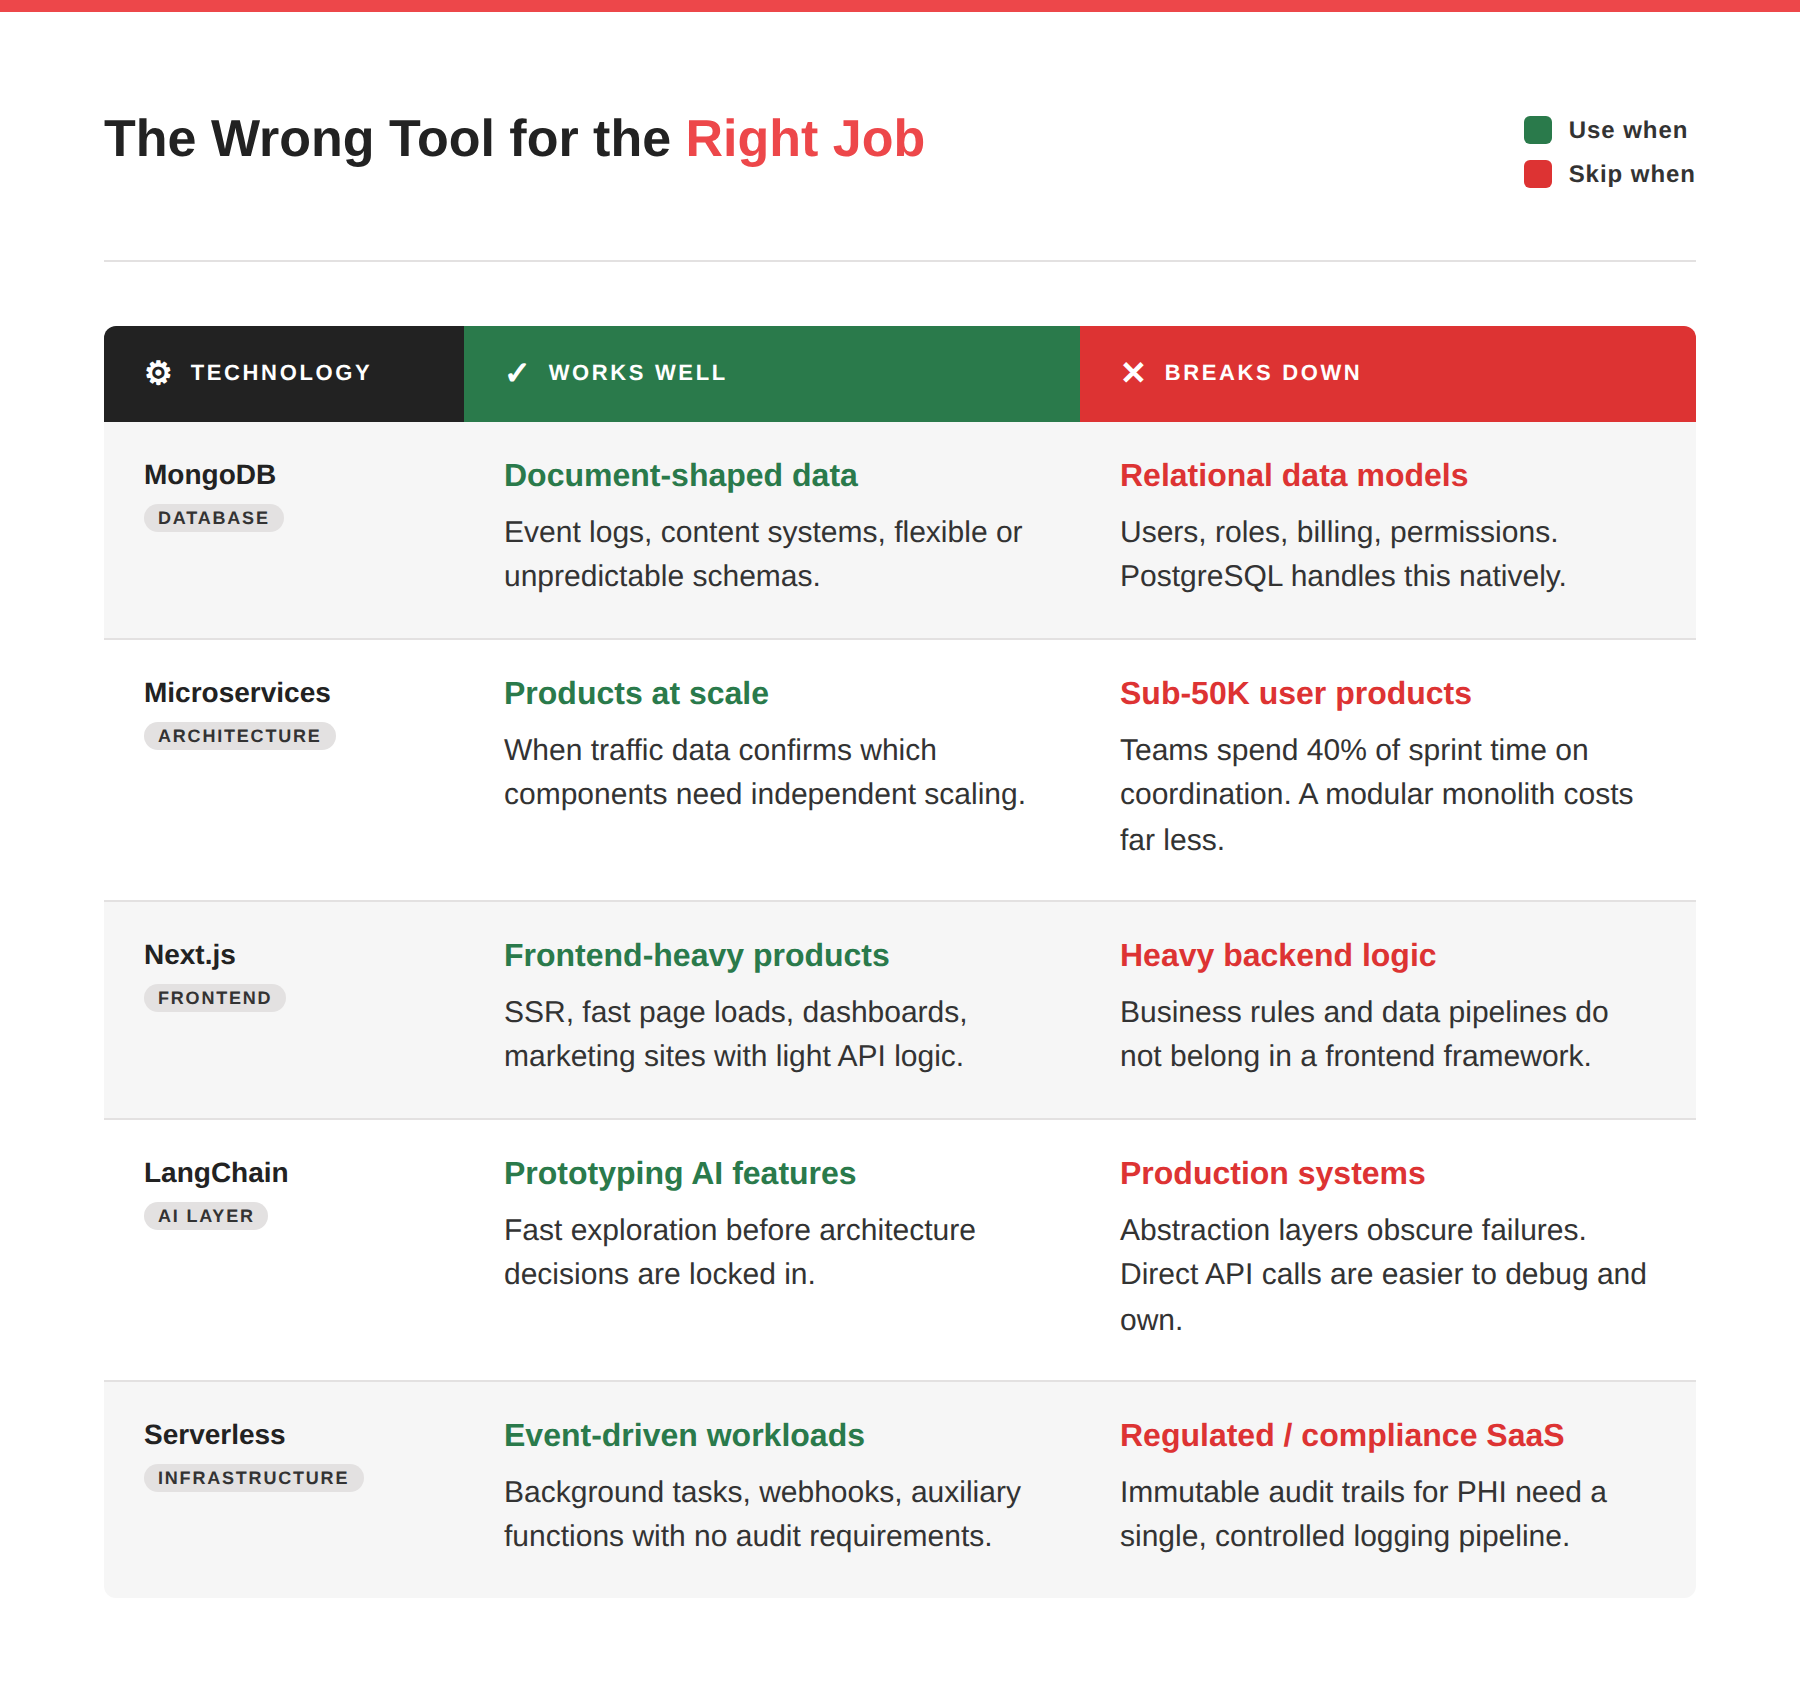
Une architecture de microservices est le surinvestissement le plus courant en phase initiale que nous constatons, car elle résout des problèmes que vous n’avez pas encore tout en créant des problèmes que vous n’aviez pas demandés. Un monolithe modulaire, où vous organisez proprement le code en préoccupations distinctes au sein d’une seule application déployable, vous donne 80 % des avantages architecturaux pour une fraction du coût de coordination. Vous pouvez extraire des services plus tard lorsque vous disposerez de données de trafic réelles indiquant où se situe réellement la charge.
Nous éviterions également MongoDB lorsque votre modèle de données est de forme relationnelle. MongoDB est vraiment excellent pour les bons cas d’utilisation : la journalisation d’événements à haut volume, les systèmes de contenu avec des schémas imprévisibles et les applications où les données sont naturellement structurées en documents. Mais si votre produit a des utilisateurs, des organisations, des abonnements, des rôles et des permissions, vous traitez des données relationnelles. Les forcer dans une base de données de documents crée des problèmes de jointure que PostgreSQL a résolus il y a des décennies. Nous avons examiné plus d’une base de code où une équipe a commencé avec MongoDB pour un MVP initial parce que c’était « flexible », puis y a passé un an à se débattre une fois que la logique de facturation et multi-tenant est arrivée.
À titre de preuve de nos dires, nous vous invitons à jeter un œil à Recruit Media, une plateforme SaaS RH full-stack pour le marché américain avec mise en correspondance de mots-clés assistée par IA et outils de communication vidéo que nous avons construite à partir de zéro. Le produit a été racheté plus tard par HireQuest. Ce résultat nécessitait une pile technologique capable de supporter une itération rapide dans les premières phases et de résister à la pression commerciale du monde réel dans les phases ultérieures. Obtenir les fondations correctes dès le départ n’était pas un accident.
De quoi les produits B2B SaaS en phase de mise à l'échelle ont-ils besoin dans leur pile technologique ?
Lorsque vos clients sont des entreprises plutôt que des particuliers, les exigences techniques changent considérablement. Les acheteurs d’entreprise se soucient de la disponibilité, de la sécurité, des pistes d’audit, de l’authentification unique (SSO) et du contrôle d’accès basé sur les rôles avant de se soucier de l’ingéniosité de votre architecture. Une belle conception de microservices qui tombe en panne un mardi après-midi est un contrat perdu.
Ce que nous choisirions :
Notre recommandation de backend la plus courante pour une plateforme SaaS B2B en phase de mise à l’échelle est Python avec Django ou FastAPI. Selon le sondage Stack Overflow Developer Survey 2025, Python a connu une augmentation de sept points de pourcentage de son adoption d’une année sur l’autre, et sa maturité dans la gestion de la logique métier complexe, des systèmes d’authentification et de la conception d’API le rend bien adapté aux produits où la fiabilité compte plus que la vitesse brute. .NET est une alternative solide, en particulier pour les équipes ayant une expérience orientée Microsoft ou pour les clients d’entreprise qui ont une infrastructure existante sur Azure.
PostgreSQL est également le bon choix de base de données ici. Dans un contexte B2B, vous avez besoin de la sécurité au niveau des lignes pour l’isolation multi-tenant, de contraintes de clés étrangères appropriées pour les données de facturation et d’autorisation, et de la capacité à exécuter des rapports significatifs. PostgreSQL fournit tout cela dans un seul système.
L’authentification à ce niveau devrait être gérée par un fournisseur d’identité dédié. Construire votre propre authentification pour les clients d’entreprise est un risque qui rapporte rarement.
Ce que nous éviterions :
Nous éviterions Next.js pour tout produit avec une logique backend lourde. Next.js est un excellent framework frontend et gère magnifiquement le rendu côté serveur, mais il lutte lorsque les équipes commencent à y charger des règles métier complexes, des tâches d’arrière-plan et des pipelines de transformation de données simplement parce que c’est le seul serveur qu’ils ont en cours d’exécution. Il a été conçu pour les préoccupations du frontend, et mélanger une logique backend lourde dans une application Next.js équivaut à utiliser une voiture de sport pour déplacer des meubles : techniquement possible, mais ce n’est pas le bon outil pour le travail.
Qu'est-ce qui alimente une pile technologique SaaS IA prête pour la production ?
Intégrer des fonctionnalités d’IA dans un produit existant est très différent de construire un produit où l’IA est la proposition de valeur principale. Dans ce second cas, votre infrastructure, votre couche de données et votre flux de développement doivent tous être conçus autour des charges de travail d’apprentissage automatique dès le premier jour.
Ce que nous choisirions :
Python est non négociable pour les SaaS natifs d’IA. L’écosystème pour l’apprentissage automatique, le traitement des données et l’intégration de modèles est tout simplement inégalé. Le sondage Stack Overflow Developer Survey 2025 attribue explicitement la croissance accélérée de Python à « sa capacité à être le langage de référence pour l’IA, la science des données et le développement backend ». FastAPI est devenu la norme pour la création d’API IA haute performance car il est rapide, gère bien les charges de travail asynchrones et s’intègre proprement avec la plupart des bibliothèques d’inférence de modèles.
En ce qui concerne spécifiquement la couche de données et d’IA, PostgreSQL avec l’extension pgvector gère la recherche sémantique et les charges de travail de génération augmentée par récupération (RAG) sans nécessiter de base de données vectorielle séparée pour la plupart des produits. À moins que vous n’opériez à une échelle où vous effectuez des milliards de comparaisons vectorielles par jour, l’ajout d’une base de données vectorielle dédiée introduit une complexité opérationnelle sans bénéfice proportionnel. Vous pouvez toujours migrer plus tard lorsque les données l’exigeront réellement.
En matière d’intégration de modèles, les appels API directs à des fournisseurs tels qu’Anthropic ou OpenAI sont le bon point de départ. Vous obtenez un comportement prévisible, un débogage simple et aucune couche d’abstraction entre votre code et la réponse.
Ce que nous éviterions :
Nous éviterions LangChain en production pour tout ce qui dépasse le prototypage. LangChain est un outil très utile pour explorer ce que l’IA peut faire dans votre produit, mais le problème est que lorsque vous passez de l’exploration à un système de production, vous voulez savoir exactement ce qui se passe à chaque étape. Les couches d’abstraction de LangChain rendent cela difficile. Le débogage d’une chaîne en production est une expérience considérablement différente du débogage d’un code que vous avez écrit vous-même. Plusieurs équipes avec lesquelles nous avons travaillé ont construit des prototypes avec LangChain, ont été impressionnées par la rapidité avec laquelle elles pouvaient progresser, ont livré en production, puis ont passé des semaines à traquer des erreurs qui auraient été évidentes avec un appel API direct. Pour tout ce dont vos utilisateurs dépendent, écrivez vous-même l’intégration : c’est plus de code au départ et beaucoup moins de mystère à 2 heures du matin.
Quelle pile technologique une solution SaaS réglementée ou de santé exige-t-elle réellement ?
Construire un produit SaaS dans le secteur de la santé, de la finance ou du gouvernement est un exercice entièrement différent. Le HIPAA à lui seul a des exigences spécifiques en matière de sauvegardes techniques couvrant le contrôle d’accès, la journalisation d’audit, le chiffrement au repos et en transit, et l’isolement des données entre les locataires. Une violation de données dans le secteur de la santé coûte maintenant en moyenne 7,42 millions de dollars aux organisations, selon les données récentes de suivi des mesures d’application par des spécialistes de la conformité HIPAA. Les choix de pile technologique que vous faites déterminent le poids de ce risque.
Ce que nous choisirions :
Azure est notre plateforme cloud de choix pour les SaaS réglementés, en particulier lorsque la clientèle a une infrastructure Microsoft existante. Azure détient les certifications de conformité HIPAA, HITECH et FedRAMP Modérée et, contrairement à certains concurrents, inclut un accord de partenariat commercial (BPA) automatiquement dans les conditions de licence d’entreprise. C’est une négociation juridique de moins à un stade déjà compliqué du développement du produit.
.NET sur Azure est un choix naturel pour le backend. Les outils s’intègrent proprement à la couche d’identité et de gestion des accès d’Azure, la journalisation d’audit est bien prise en charge par la plateforme, et le framework a fait ses preuves dans les environnements d’entreprise où les revues de sécurité sont une réalité commerciale. Python est une alternative viable, mais la profondeur de l’écosystème .NET dans le monde de la conformité Microsoft est un avantage réel.
PostgreSQL reste le choix de base de données par défaut, hébergé sur un service géré avec chiffrement au repos activé. L’exigence clé est que votre couche de base de données applique la sécurité au niveau des lignes afin qu’un locataire ne puisse pas accéder aux données d’un autre sous quelque chemin de code que ce soit, y compris un bug d’application. Ce n’est pas une option dans les environnements réglementés.
Ce que nous éviterions :
Nous éviterions l’architecture serverless pour la logique applicative principale. Le serverless fonctionne bien pour les tâches d’arrière-plan événementielles et les fonctions auxiliaires, mais lorsque vous avez besoin d’une piste d’audit complète et immuable de chaque opération touchant des informations de santé protégées (PHI), la nature éphémère et distribuée des fonctions serverless rend cela plus difficile à réaliser de manière cohérente. La journalisation d’audit doit être infaillible, et l’infaillibilité est plus facile à garantir dans une seule application où vous contrôlez le pipeline de journalisation à partir d’un seul endroit.
À titre d’exemple, considérez notre étude de cas pour Change & Innovation Agency, une solution SaaS de gouvernement électronique entièrement conforme à l’Americans with Disabilities Act (ADA) utilisée par les divisions de protection sociale aux États-Unis. Les clients gouvernementaux ont des attentes en matière de conformité qui rivalisent avec celles du secteur de la santé en termes de spécificité. Obtenir cela correctement a nécessité la même approche disciplinée de l’infrastructure que celle exigée par les SaaS réglementés.
Quelle pile technologique permet une mise à l'échelle sur de nombreux clients dans un SaaS multi-tenant ?
Un produit SaaS horizontal multi-tenant sert de nombreuses organisations sur une seule plateforme. Pensez aux outils de gestion de projet, aux systèmes CRM (Customer Relationship Management) et aux plateformes de communication. Le défi architectural n’est pas la performance brute mais l’isolation : chaque client doit avoir l’impression d’avoir son propre produit, même s’il partage l’infrastructure avec des centaines ou des milliers d’autres.
Ce que nous choisirions :
Le modèle de tenancy est la décision la plus importante dans ce scénario, et elle doit être prise avant d’écrire une seule ligne de code applicatif. Nous recommandons de commencer par une base de données partagée, une approche de schéma partagé avec la sécurité au niveau des lignes dans PostgreSQL. C’est opérationnellement plus simple, coûte moins cher à exécuter, et évolue plus loin que ce que la plupart des équipes attendent. Vous pouvez migrer vers un schéma par locataire plus tard si les clients d’entreprise exigent une isolation des données plus stricte pour leur processus d’approvisionnement.
Python ou Node.js fonctionnent tous deux bien au niveau applicatif. Le choix le plus important est le modèle architectural. Commencez par un monolithe bien structuré plutôt que par des microservices.
Les microservices sont une solution aux problèmes organisationnels et de mise à l’échelle qu’un produit de moins de 50 000 utilisateurs n’a tout simplement pas. Ils introduisent une surcharge de communication inter-services, des exigences de traçage distribué et une complexité de déploiement qui ralentissent considérablement une petite équipe. Construisez pour la clarté d’abord. Extrayez les services lorsque les données de trafic vous indiquent quelles parties du système doivent réellement évoluer indépendamment.
Ce que nous éviterions :
Les microservices prématurés méritent d’être mentionnés spécifiquement car c’est probablement l’erreur coûteuse la plus courante que nous voyons dans l’architecture SaaS. L’argument en faveur des microservices à un stade précoce est presque toujours basé sur « nous pourrions avoir besoin de faire évoluer ce composant séparément plus tard », ce qui est une préoccupation raisonnable gérée beaucoup plus économiquement par un monolithe modulaire avec des limites claires.
Si vous avez besoin de preuves, consultez AWE Learning, une plateforme d’e-learning SaaS que nous avons construite à partir de zéro, utilisée maintenant par 50 % de toutes les bibliothèques publiques américaines. Ce produit dessert un grand nombre de clients institutionnels indépendants, chacun avec son propre contenu et sa propre base d’utilisateurs, ce qui correspond exactement au scénario multi-tenant. Nous avons implémenté des microservices sur ce projet car le contexte de déploiement l’exigeait réellement : les bibliothèques clientes indépendantes avaient besoin de mises à jour isolées et l’échelle de la plateforme justifiait la complexité. La raison pour laquelle cela a fonctionné est que la décision a été prise délibérément, sur la base d’exigences réelles, et non par défaut.
Ce à quoi ressemblent réellement les mauvaises décisions de pile technologique : leçons de nos revues de code
La section que tous les autres articles sur la « pile technologique SaaS » omettent est celle qui vous explique concrètement à quoi ressemblent les mauvaises décisions. Pas comme un conte d’avertissement tiré du projet de quelqu’un d’autre, mais comme une image concrète de ce qui arrive dans une base de code lorsque les choix architecturaux initiaux n’ont pas été correctement réfléchis.
Nous effectuons un nombre important d’audits de code et des revues de backend pour les produits SaaS chez Redwerk. Voici une image condensée de ce que nous trouvons constamment lorsque les choses ont mal tourné.
Le backend qui est devenu son propre pire ennemi : Nous avons audité le backend Python/Django pour Project Science, un SaaS de gestion de devis construit pour l’industrie informatique. Le client est venu nous voir car il remodélait le frontend et a décidé de saisir l’opportunité de jeter un œil honnête au backend avant de le mettre à l’échelle. Ce que nous avons trouvé, c’est un backend qui avait accumulé plusieurs problèmes structurels qui seraient devenus graves à grande échelle : documentation manquante des variables d’environnement qui rendait le déploiement fragile, un flux de sauvegarde de base de données défectueux qui nécessitait une intervention manuelle pour fonctionner, absence de mise en cache à la fois pour l’application et les couches de requêtes de base de données, et un formateur de code inclus par défaut qui était conçu pour les projets JavaScript et ne faisait rien d’utile dans une base de code Python. Aucun de ces problèmes n’était catastrophique en soi. Ensemble, ils représentaient des mois de travail différé qui seraient arrivés tous en même temps pendant une période de trafic élevé ou un examen de sécurité.
Le schéma le plus constant que nous voyons dans les audits n’est pas une défaillance catastrophique mais une friction accumulée. Une équipe fait un choix raisonnable sous la pression du temps, puis en fait un autre, et encore un autre. Chacun est défendable isolément. Douze mois plus tard, la base de code a un plafond de performance que personne n’a conçu et que personne n’est sûr de pouvoir lever sans casser quelque chose.
Le problème de désajustement technologique : L’une des conclusions les plus fréquentes dans nos revues est une base de données qui ne correspond pas au modèle de données. Une équipe choisit MongoDB car elle est rapide à prendre en main, et la flexibilité du schéma semble attrayante. Puis le produit inclut la logique de facturation, les rôles utilisateurs, les hiérarchies organisationnelles et l’isolation des données multi-tenant. Tous ces problèmes sont des problèmes relationnels. MongoDB peut les gérer, mais bien les gérer nécessite le type de discipline manuelle qu’une base de données relationnelle impose automatiquement. Au moment où une équipe réalise le décalage, elle a six mois de données de production dans un format qui ne veut pas être migré.
L’architecture pré-ingénierée précoce : Nous avons examiné plusieurs bases de code où une équipe a construit une architecture complète de microservices pour un produit de moins de cinq mille utilisateurs actifs. L’intention était bonne : ils voulaient construire quelque chose qui évoluerait. Ce qu’ils ont construit à la place, c’est un système où le déploiement d’une petite fonctionnalité nécessitait la coordination de changements sur trois services, la rédaction de contrats inter-services et la gestion du traçage distribué pour déboguer quoi que ce soit de non trivial. L’équipe de quatre développeurs passait environ 40 % de son temps de sprint à coordonner l’infrastructure plutôt qu’au développement de produit. Ce n’est pas un problème de mise à l’échelle mais un problème d’optimisation prématurée, et cela a une solution simple : consolider.
Le schéma sous-jacent est le même dans tous les cas. La pile a été choisie en fonction de ce qui semblait correct plutôt que de ce que le produit exigeait réellement à son stade actuel. Obtenir ce diagnostic correct avant de commencer à construire, c’est à cela que sert la phase de découverte d’un projet.
La règle unique de la pile technologique SaaS qui prime sur tout le reste
Nous vous avons donné des recommandations spécifiques de piles technologiques pour cinq scénarios. Voici la règle qui s’applique à tous : la meilleure pile technologique SaaS est celle que votre équipe peut exécuter et maintenir.
Un choix architectural brillant fait par une équipe sans l’expérience nécessaire pour le mettre en œuvre est pire qu’une pile technologique banale exécutée avec discipline. Nous avons vu des produits construits sur des combinaisons technologiques tout à fait ordinaires qui ont atteint des millions d’utilisateurs parce que le code était propre, que l’équipe comprenait ce qu’elle construisait et que les décisions étaient prises délibérément. Nous avons également vu des produits construits sur des piles technologiques impressionnantes qui se sont effondrés sous leur propre complexité parce que l’équipe était composée de trois personnes et que l’architecture en supposait trente.
Lorsqu’un client nous contacte avec un nouveau produit SaaS, la première question n’est jamais « quel framework devrions-nous utiliser ». La première question est : « Que doit réellement faire ce produit au cours des douze prochains mois, et à quoi ressemble l’équipe ? » La pile technologique en découle.
Si vous en êtes à ce stade de votre parcours, parlons-en et choisissons la pile technologique la plus adaptée à vos projets.
FAQ
Quelle est la meilleure pile technologique pour le SaaS en 2026 ?
Il n’y a pas de meilleure pile technologique SaaS unique en 2026, mais il existe un ensemble clair de défauts raisonnables :
- React ou Next.js côté frontend
- Python ou Node.js côté backend
- PostgreSQL pour la base de données
- AWS ou Azure pour l’infrastructure
La bonne combinaison dépend du scénario spécifique de votre produit : un SaaS natif d’IA a des exigences différentes d’une plateforme de santé réglementée, et un MVP initial a besoin d’une architecture très différente d’un produit B2B en phase de mise à l’échelle. Le plus important est de faire correspondre la pile technologique à l’étape et au scénario, et non à ce qui semble impressionnant sur un blog technologique.
Quelles technologies sont utilisées pour construire une application SaaS ?
Une application SaaS comprend généralement cinq couches : un frontend avec lequel les utilisateurs interagissent, un backend qui gère la logique métier, une base de données qui stocke les données, une infrastructure cloud qui exécute le tout, et des outils DevOps qui automatisent le déploiement et la surveillance. Les choix courants incluent :
- React ou Next.js pour le frontend
- Python, Node.js ou .NET pour le backend
- PostgreSQL pour les données relationnelles
- AWS, Azure ou Google Cloud pour l’infrastructure
- GitHub Actions ou des outils similaires pour l’intégration et le déploiement continus.
Pour les produits natifs d’IA, une couche d’inférence et de données supplémentaire est requise.
Quel est le meilleur backend pour un produit SaaS ?
Pour la plupart des produits SaaS en 2026, Python avec FastAPI ou Django est le choix backend le plus solide. Il possède le plus large écosystème, gère à la fois le travail standard des API web et les charges de travail IA/apprentissage automatique dans le même langage, et a connu une augmentation de sept points de pourcentage de l’adoption par les développeurs professionnels entre 2024 et 2025, selon l’enquête annuelle de Stack Overflow. Node.js est une excellente alternative pour les équipes qui souhaitent un langage unique sur toute la pile. .NET est le bon choix pour les industries réglementées ou les environnements d’entreprise centrés sur Microsoft. Le choix du backend doit suivre le scénario du produit, et non l’inverse.
Découvrez comment nous avons aidé AWE Learning à créer un SaaS d'e-learning utilisé par 50 % des bibliothèques publiques américaines