Le passage à un LLM privé commence généralement par un moment de panique soudaine et discrète. Imaginez : votre équipe juridique réalise soudainement qu’elle a collé sans y penser des contrats clients confidentiels dans des fenêtres ChatGPT publiques, ou votre directeur technique ouvre la facture trimestrielle de l’API et a l’impression que son âme quitte son corps en réalisant que l’utilisation a triplé.
Et voilà ! On en est arrivé à la question : « Devrions-nous simplement construire notre propre modèle d’IA privé ? »
Si vous êtes actuellement en réunion, respirez profondément. Inutile d’être un expert en science des données, et encore moins d’avoir un compte en banque illimité pour y arriver. Chez Redwerk, notre équipe a créé notre service de distillation de modèles d’IA précisément pour aider les entreprises à traverser cette période charnière sans y perdre la tête (ni leur budget).
La plupart des guides en ligne vous proposent une liste impersonnelle et générique qui ne fait qu’ajouter à la confusion. Nous, non. Cet article est un guide honnête et objectif, sans promesses exagérées. Nous allons détailler vos options, leur coût réel, comment choisir la solution idéale pour votre situation et où se cachent les pièges potentiels. Trouvez les réponses dont vous avez vraiment besoin.
Qu'est-ce qu'un LLM privé ? (Et ce qu'il n'est absolument pas)
Un LLM privé est un modèle de langage de grande taille déployé intégralement dans votre environnement contrôlé, qu’il s’agisse de serveurs physiques vous appartenant, d’un cloud privé que vous gérez ou d’une solution hybride. Sa principale caractéristique est la suivante : vos données, vos invites, les poids de votre modèle et vos journaux d’inférence restent confinés à votre périmètre de sécurité, et aucune tierce partie ne traite vos informations.
Une petite précision : la recherche « LLM privé » renvoie beaucoup de contenu destiné aux développeurs souhaitant exécuter un modèle open source sur leur ordinateur portable. Des outils comme Ollama et LM Studio sont excellents pour des expérimentations personnelles, mais ce n’est pas ce dont nous parlons ici. Un LLM privé de niveau entreprise est un choix d’infrastructure, et non un simple téléchargement de logiciel. Si l’objectif est de gérer des flux de travail métiers réels au sein d’une équipe, de servir des milliers d’utilisateurs et de respecter les réglementations HIPAA et RGPD, la catégorie « exécuter sur un MacBook » n’est pas pertinente. Ce dont vous avez besoin, c’est d’un modèle qui s’exécute à grande échelle au sein de votre environnement, produit des résultats précis pour votre domaine et génère un historique d’audit de conformité.
Pourquoi les entreprises réglementées déploient-elles rapidement des LLM privés ?
Trois pressions convergent en 2026, avec l’impact le plus fort sur les entreprises de la santé, de la finance, des services juridiques et du secteur public.
- Le mur de la conformité est réel et spécifique
Les API LLM publiques standard opèrent en dehors de votre périmètre de conformité par défaut. En vertu de la loi HIPAA, tout fournisseur qui reçoit, traite ou stocke des informations de santé protégées (PHI) en votre nom doit signer un accord d’associé commercial (BAA) avant que des données ne touchent leur infrastructure, et la plupart des niveaux d’API standard n’en incluent pas. Les règles de résidence des données du RGPD peuvent aller plus loin : une organisation européenne peut être légalement interdite de router des données personnelles via une infrastructure basée aux États-Unis sans mécanismes de transfert documentés. Comme l’indique le guide de conformité de TrueFoundry pour les secteurs réglementés puts it, l’éligibilité à un déploiement cloud couvert par un BAA n’est pas synonyme de conformité. - Les coûts d’API ne restent pas stables
Selon le rapport State of AI Costs de CloudZero, le budget mensuel moyen consacré à l’IA au sein des organisations a bondi de 62 964 € en 2024 à 85 521 € en 2025, soit une augmentation de 36 %, et la part des entreprises prévoyant de dépenser plus de 100 000 € par mois a plus que doublé, passant de 20 % à 45 %. Un schéma d’entreprise fréquemment cité explique pourquoi : une équipe commence avec une facture API mensuelle de 15 000 € à l’échelle pilote, et au troisième mois elle est à 60 000 €, une trajectoire qui porte les dépenses annuelles au-delà de 700 000 € avant les coûts cachés. La tarification à l’usage est rationnelle à l’échelle d’une preuve de concept, et un passif une fois l’IA intégrée en production. - Les modèles génériques produisent des réponses génériques
Les LLM publics sont entraînés sur des données internet étendues, donc ils paraissent confiants mais deviennent peu fiables lorsqu’on leur pose des questions sur vos contrats spécifiques, vos protocoles cliniques internes ou la terminologie précise de votre domaine. La précision métier n’est pas optionnelle pour les entreprises qui prennent des décisions basées sur des résultats d’IA, surtout compte tenu des risques associés à l’IA fantôme.
Les quatre options d'architecture pour un LLM d'entreprise privée : un cadre de décision
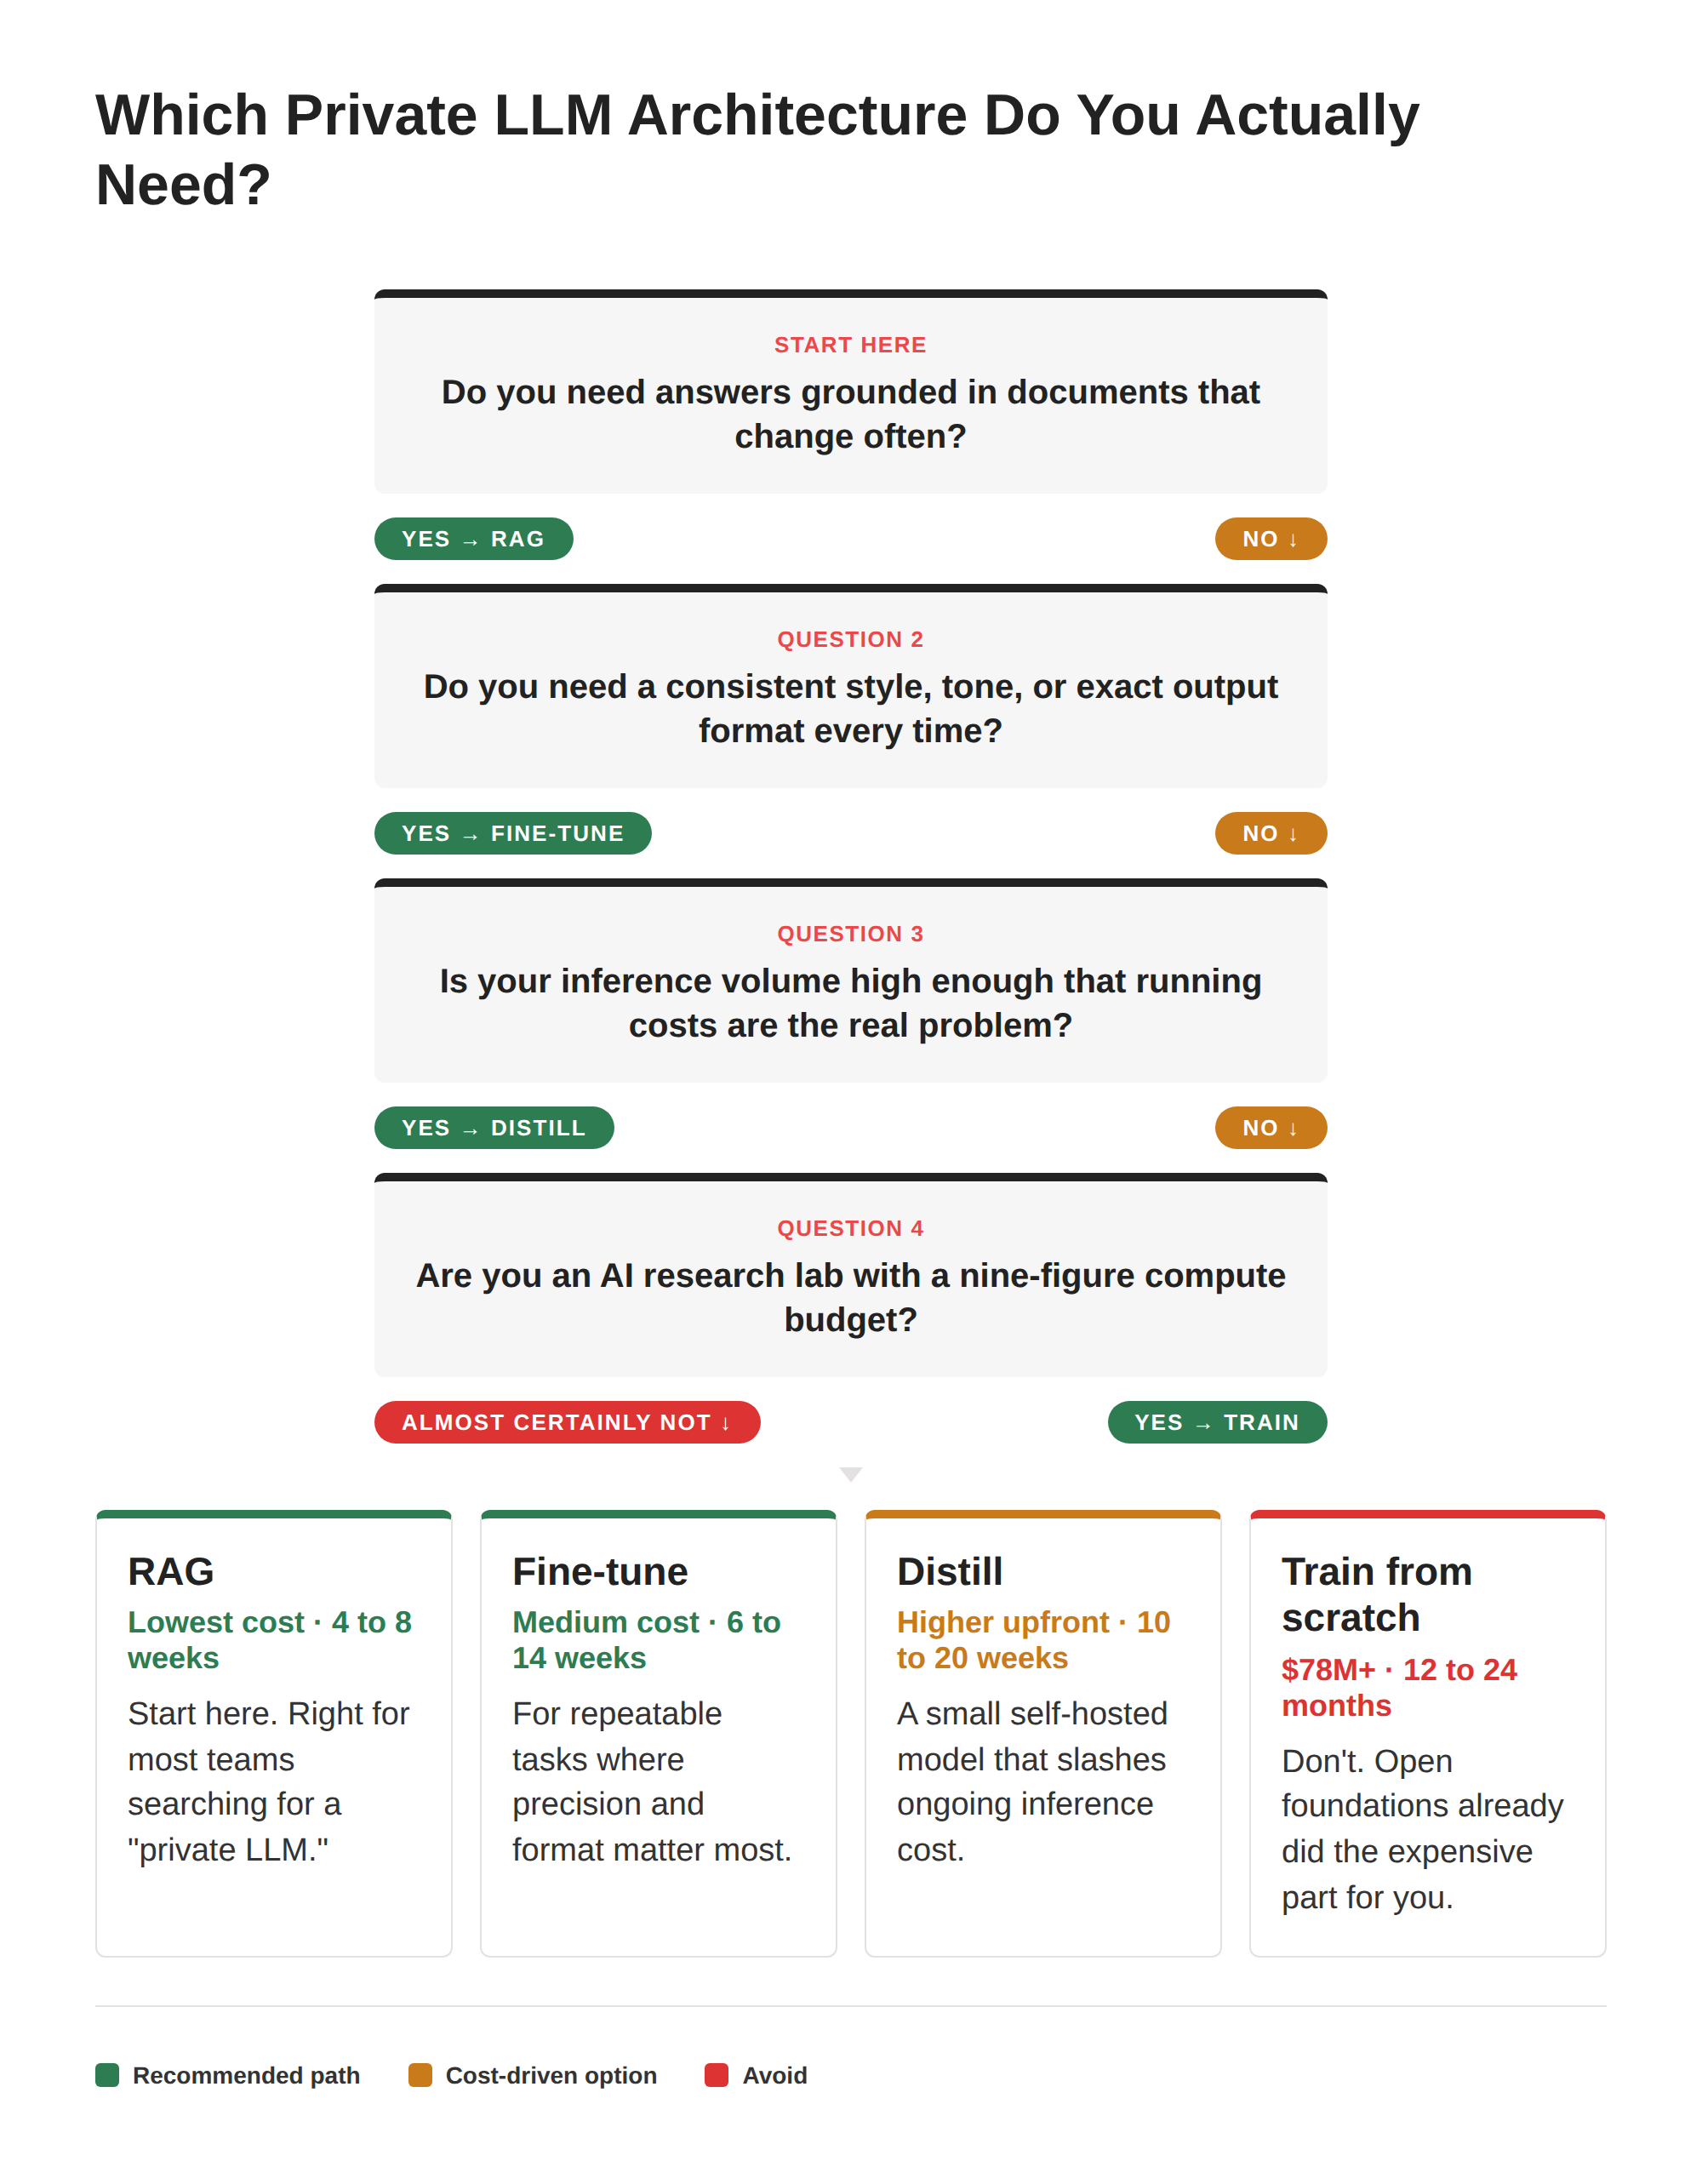
Voici la partie que la plupart des guides omettent : quand quelqu’un dit vouloir ‘construire un LLM privé’, il peut vouloir dire l’une des quatre choses fondamentalement différentes, chacune avec un profil de coût, un calendrier et une adéquation distincts. Comprendre les différences, c’est ce qui vous évite de passer six mois sur la mauvaise approche.
RAG sur un modèle open-source
Récupère depuis vos documents au moment de l’inférence
Faible
4 à 8 semaines
Q&R documentaire, recherche de documents, la plupart des cas d’usage en entreprise
Modèle open-source fine-tuné
Intègre les connaissances métier directement dans les poids du modèle
Moyen
6 à 14 semaines
Tâches structurées répétables, terminologie spécialisée, ton cohérent
Distillation et auto-hébergement
Entraîne un modèle plus petit en utilisant un plus grand comme enseignant
Moyen-élevé
10 à 20 semaines
Charges de travail à haut volume où le coût d’inférence continu est le problème
Entraînement depuis zéro
Construit un modèle sans poids préexistants
Extrême
12 à 24 mois
Laboratoires de recherche en IA. Presque certainement pas votre situation.
Option 1 : RAG (génération augmentée par la récupération) sur un modèle open source
Choisir le RAG plutôt que le fine-tuning est le bon point de départ pour la plupart des entreprises. Plutôt que de modifier le modèle lui-même, il connecte un modèle open-source pré-entraîné (Llama, Mistral et Falcon sont des choix courants) à une base de connaissances privée lors de l’exécution. Quand un utilisateur pose une question, le système récupère les documents internes les plus pertinents et les fournit au modèle comme contexte, de sorte que la réponse soit ancrée dans votre contenu réel plutôt que dans les connaissances génériques d’internet.
Les avantages pratiques sont significatifs :
- Le RAG est le chemin le plus rapide de l’idée au pilote
- La base de connaissances peut être mise à jour sans ré-entraîner le modèle
- Il peut s’exécuter dans un VPC (Virtual Private Cloud) privé ou un environnement sur site pour satisfaire les exigences de résidence des données
Pour les Q&R documentaires internes, le support à la révision de contrats, les assistants de connaissances RH ou la consultation de documentation clinique, le RAG sur une base open-source est généralement la réponse — et la réponse dont la plupart des entreprises cherchant un ‘LLM privé’ ont réellement besoin, même si elles ne le savent pas encore.
Ce que le RAG ne résout pas : si votre tâche nécessite que le modèle raisonne dans un style fondamentalement différent ou produise des sorties structurées dans un format précis à chaque fois, vous devrez probablement le combiner avec du fine-tuning.
Option 2 : Optimisation d’un modèle open source
Le fine-tuning consiste à réentraîner un modèle pré-entraîné sur un ensemble de données plus restreint et sélectionné, issu de votre domaine. Les connaissances ainsi acquises sont intégrées aux poids du modèle, qui intègre votre terminologie, vos flux de travail et vos formats de sortie. Il en résulte des réponses plus précises pour les tâches répétitives et structurées qu’avec une approche basée uniquement sur RAG (Relative Access, Graduation, Indexation), sans étape de récupération lors de l’inférence, ce qui réduit la latence.
Le compromis réside dans le coût et le temps. L’ajustement fin exige des ressources de calcul et des données d’entraînement étiquetées de qualité, ce qui représente souvent la contrainte la plus difficile à respecter. Si vos données internes sont propres, étiquetées et représentatives, l’ajustement fin est un outil puissant. En revanche, si elles sont dispersées entre différents formats et systèmes, vous consacrerez plus de temps à la préparation des données qu’à l’entraînement du modèle. De nombreux déploiements en production combinent les deux approches : RAG (Real Age, Agility) pour une large couverture des connaissances et l’ajustement fin pour les tâches où la précision est primordiale.
Option 3 : Distillation des connaissances et auto-hébergement
La distillation est le levier de maîtrise des coûts que presque tous les guides « comment créer un LLM privé » ignorent, et c’est précisément pourquoi il est important de la comprendre.
Le principe est simple : vous utilisez un modèle puissant et volumineux (le « professeur ») pour générer des données d’entraînement, puis vous entraînez un modèle plus petit et plus rapide (l’« élève ») pour reproduire le comportement du professeur sur vos tâches spécifiques. Vous hébergez ensuite ce modèle élève compact sur votre propre infrastructure, où il est beaucoup moins gourmand en ressources que le professeur, car plus petit et conçu spécifiquement pour votre charge de travail plutôt que pour un usage général.
Pour les entreprises gérant des charges de travail d’IA importantes, la distillation offre souvent le meilleur retour sur investissement. Son coût initial est plus élevé que celui de RAG ou du simple réglage fin, mais les coûts d’inférence continus diminuent considérablement et le modèle s’exécute entièrement au sein de votre infrastructure. Cette architecture est particulièrement pertinente une fois votre cas d’usage validé et le volume de travail justifiant l’investissement.
Option 4 : Formation à partir de zéro
Cette option mérite une réponse directe plutôt que diplomatique. Pour presque toutes les entreprises qui lisent ceci, entraîner un modèle frontière depuis zéro n’est ni réaliste ni nécessaire.
Le coût de calcul pour l’entraînement à l’échelle GPT-4 était d’environ 78 millions de dollars, selon l’AI Index 2025 de Stanford, qui a collaboré avec Epoch AI pour ces estimations, et Gemini Ultra de Google a coûté environ 191 millions de dollars. Ce ne sont que les factures de calcul pour une seule exécution d’entraînement, avant l’infrastructure, le personnel, l’acquisition de données ou les itérations. La recherche d’Epoch AI montre que les coûts d’entraînement frontière ont augmenté d’environ 2,4× par an, donc ces chiffres paraîtront bientôt conservateurs.
Les modèles fondateurs open-source comme Llama et Mistral encodent déjà des années d’entraînement à grande échelle sur de vastes ensembles de données, donc votre entreprise n’a pas besoin de reproduire cela. Ce dont vous avez besoin, c’est d’adapter un fondement existant à votre contexte spécifique, ce que font exactement le fine-tuning et le RAG, à une fraction du coût et du temps. À moins que vous ne dirigiez un laboratoire de recherche en IA avec des budgets de calcul à neuf chiffres et une équipe de recherche dédiée, l’arbre de décision s’arrête ici : choisissez l’une des trois premières options.
Modes de déploiement LLM privés : sur site, VPC privé ou hybride
Une fois votre architecture choisie, il vous faut déterminer son environnement d’exécution. Trois modèles de déploiement correspondent à différentes exigences de conformité, charges d’infrastructure et coûts.
- Déploiement sur site
Cela signifie que le modèle s’exécute sur le matériel que votre organisation possède et exploite. C’est l’option de conformité la plus élevée car les données ne quittent jamais votre réseau, ce qui en fait le choix standard pour les environnements air-gap comme les sous-traitants de défense, certaines agences gouvernementales et les paramètres de santé les plus sensibles. La contrepartie est la charge d’infrastructure : vous possédez le matériel, gérez la maintenance, et votre équipe d’exploitation supporte la charge de faire fonctionner le système. - Déploiement en VPC privé
Cela déplace l’infrastructure vers un environnement cloud isolé hébergé par AWS, Azure ou Google Cloud, cloisonné de l’infrastructure partagée. Vos données sont traitées uniquement dans votre environnement désigné, et des configurations éligibles BAA sont disponibles sur les trois grandes plateformes. Cette option atteint la production plus rapidement que sur site, répond à HIPAA et la plupart des exigences RGPD lorsqu’elle est correctement configurée, et supprime la charge de gestion matérielle. Pour la plupart des entreprises réglementées, un VPC privé correctement configuré est suffisant et pratique. - Déploiement hybride
Cette option conserve vos données et inférences les plus sensibles sur site ou dans un VPC privé, tout en routant les tâches moins sensibles via une infrastructure cloud évolutive. C’est le choix pragmatique pour les organisations de taille moyenne équilibrant conformité, coût et flexibilité. Quelle que soit votre décision, cartographiez vos exigences de conformité avant de prendre des décisions d’infrastructure, pas après.
Ce qu'il faut réellement pour créer un LLM privé : des ressources fiables
Le déploiement d’un LLM privé couvre plusieurs disciplines que la plupart des entreprises n’ont pas en permanence dans leurs équipes : l’ingénierie du machine learning pour la sélection et le fine-tuning des modèles, l’ingénierie des données pour préparer les données d’entraînement et de récupération, le MLOps pour gérer le déploiement et la surveillance, et l’expertise métier pour confirmer que les sorties du modèle sont précises pour votre contexte.
Pour le chemin le plus courant, RAG plus un modèle open-source fine-tuné, un calendrier réaliste du lancement à un pilote fonctionnel est de 6 à 14 semaines, en supposant des données propres, des critères de succès définis et l’accès aux compétences adéquates. L’absence de l’un de ces éléments prolonge considérablement le calendrier.
La plupart des entreprises des secteurs réglementés ne gèrent pas d’équipes d’infrastructure ML dédiées, et c’est une décision rationnelle pour les organisations dont la compétence principale est la santé, la finance ou le droit. Collaborer avec une équipe ayant livré des systèmes IA en production est généralement plus rapide et plus rentable que d’assembler cette capacité en interne depuis zéro. Les services de développement IA et machine learning de Redwerk couvrent la pile de livraison complète, de la conception de l’architecture et la mise en place du pipeline de données jusqu’au déploiement du modèle et la surveillance continue, y compris l’automatisation des flux de travail pour les opérations riches en documents, avec l’objectif d’éliminer les goulots d’étranglement manuels sans exposer les données de processus sensibles à des fournisseurs externes.
Quand un LLM privé est-il rentable ?
Le calcul des coûts comporte deux aspects. Premièrement, l’investissement initial : mise en place de l’infrastructure, préparation des données, entraînement ou optimisation du modèle, et déploiement. Pour un déploiement RAG bien conçu ou un modèle optimisé sur un VPC privé, ce coût se situe généralement entre 40 000 et 100 000 $ selon la complexité, la maturité des données et la composition de l’équipe. Deuxièmement, la comparaison continue. Si votre équipe exécute d’importantes charges de travail d’IA via une API publique, la question n’est plus de savoir si posséder le modèle est plus économique, mais plutôt quand. Sachant que les dépenses d’IA en entreprise ont augmenté de 36 % par an en 2025, le point de bascule pour la plupart des déploiements à l’échelle de la production se situe entre 12 et 18 mois.
Il y a aussi un coût qui n’apparaît jamais sur la facture : un incident de conformité. La violation de données moyenne coûte désormais 4,88 millions de dollars, selon le rapport IBM 2024 sur le coût d’une violation de données, et ce chiffre exclut les amendes réglementaires, qui atteignent 4 % du chiffre d’affaires annuel mondial sous RGPD et escaladent jusqu’aux millions sous HIPAA. La décision d’architecture est également une décision de gestion des risques.
Cependant, si nous changeons la question en ‘Un LLM privé vaut-il la peine pour une petite entreprise ?’, nous devons reconnaître que cela dépend de votre profil de risque des données, pas de la taille de votre entreprise. Une société healthtech de 50 personnes traitant des données patients chaque jour a un argument plus fort pour un déploiement privé qu’une entreprise SaaS de 500 personnes dont les cas d’usage IA impliquent uniquement du contenu public.
La question n’est donc pas ‘sommes-nous assez grands ?’ mais ‘pouvons-nous nous permettre un incident de données, et que révélerait un audit de conformité de notre configuration IA actuelle ?’ Pour les équipes plus petites, un déploiement VPC privé avec RAG sur un modèle open-source est souvent le bon point d’entrée.
Votre décision concernant le déploiement de votre LLM privé ne doit pas être prise seule
La plupart des organisations qui nous contactent avec une demande de « LLM privé » ont en réalité trois questions regroupées en une seule :
- Quelle architecture correspond à notre cas d’usage ?
- Comment satisfaire les exigences de conformité ?
- Comment échapper à la spirale des coûts API dans laquelle nous sommes déjà ?
Les réponses sont spécifiques à vos données, vos flux de travail et votre environnement réglementaire.
Si vous êtes dans cette position, la prochaine étape la plus utile n’est pas un autre article mais une conversation avec une équipe qui a résolu ce problème en production. Contactez Redwerk et cartographions l’architecture adaptée à votre situation.
FAQ
Qu’est-ce qu’un LLM privé ?
Un LLM privé est un modèle de langage de grande taille déployé entièrement au sein de l’environnement contrôlé d’une organisation, sur site ou dans un cloud privé, de sorte que toutes les données, invites et sorties restent à l’intérieur du périmètre de sécurité sans traitement par un tiers.
Comment exécuter un LLM sur ma propre infrastructure ?
Pour la plupart des entreprises, la solution la plus pratique consiste à utiliser un modèle de base open source (comme Llama ou Mistral), à le déployer dans un VPC privé ou sur site, et à le connecter à leurs données internes via RAG. Des réglages plus précis peuvent être ajoutés pour des tâches spécifiques.
Comment utiliser l’IA sans envoyer de données à OpenAI ou d’autres fournisseurs publics ?
Déployez un LLM open-source sur votre propre infrastructure, soit sur site soit dans un environnement cloud privé que vous contrôlez. Cela garantit que vos données ne quittent jamais votre périmètre de sécurité.
Quelle est la différence entre RAG et fine-tuning pour un LLM privé ?
Le RAG connecte un modèle à vos documents au moment de l’inférence, de sorte que les réponses soient ancrées dans votre contenu sans modifier le modèle lui-même. Le fine-tuning modifie les poids du modèle en utilisant vos données, intégrant les connaissances métier directement dans le modèle. Le RAG est plus rapide et plus flexible, tandis que le fine-tuning produit une précision plus élevée pour les tâches structurées et répétables. De nombreux systèmes en production utilisent les deux.
Combien de temps faut-il pour construire un LLM privé ?
Un déploiement basé sur le RAG peut atteindre un pilote fonctionnel en 4 à 8 semaines. L’ajout du fine-tuning prolonge généralement cela à 6-14 semaines. Le calendrier dépend fortement de la qualité et de la préparation de vos données internes.
Découvrez comment nous avons livré un IMS personnalisé qui a transformé les flux de travail de Mass Movement, aboutissant à leur acquisition réussie par J.B. Hunt