Les développeurs subissent aujourd’hui une pression immense pour livrer plus rapidement, ce qui les amène fréquemment à contourner les canaux officiels et à utiliser des modèles génératifs non autorisés pour écrire leur code. La demande de vélocité rapide rend incroyablement tentant pour les ingénieurs d’adopter la tendance moderne du « vibe coding », privilégiant des résultats rapides à des revues de sécurité rigoureuses.
Les politiques des ressources humaines et les mémos d’entreprise ne fonctionnent tout simplement pas lorsqu’une extension de navigateur rapide peut résoudre un bug complexe en quelques secondes. En fait, près de 50% des développeurs utilisent désormais des assistants de codage comme Cursor et GitHub Copilot, l’utilisation dans les entreprises pionnières atteignant un stupéfiant 90%. Si vous souhaitez protéger votre propriété intellectuelle et maintenir une conformité stricte, vous devez accepter que l’IA fantôme vit déjà discrètement dans votre dépôt.
Dans cet article, nous allons explorer les profondeurs de la sécurité de l’IA fantôme, révéler comment les auditeurs indépendants trouvent du code non autorisé et mettre en évidence les outils exacts dont vous avez besoin pour reprendre le contrôle de votre cycle de vie de développement logiciel (SDLC). Si tout cela vous semble urgent, nos services d’audit de développement logiciel existent précisément pour ce moment.
Qu'est-ce que l'IA fantôme ?
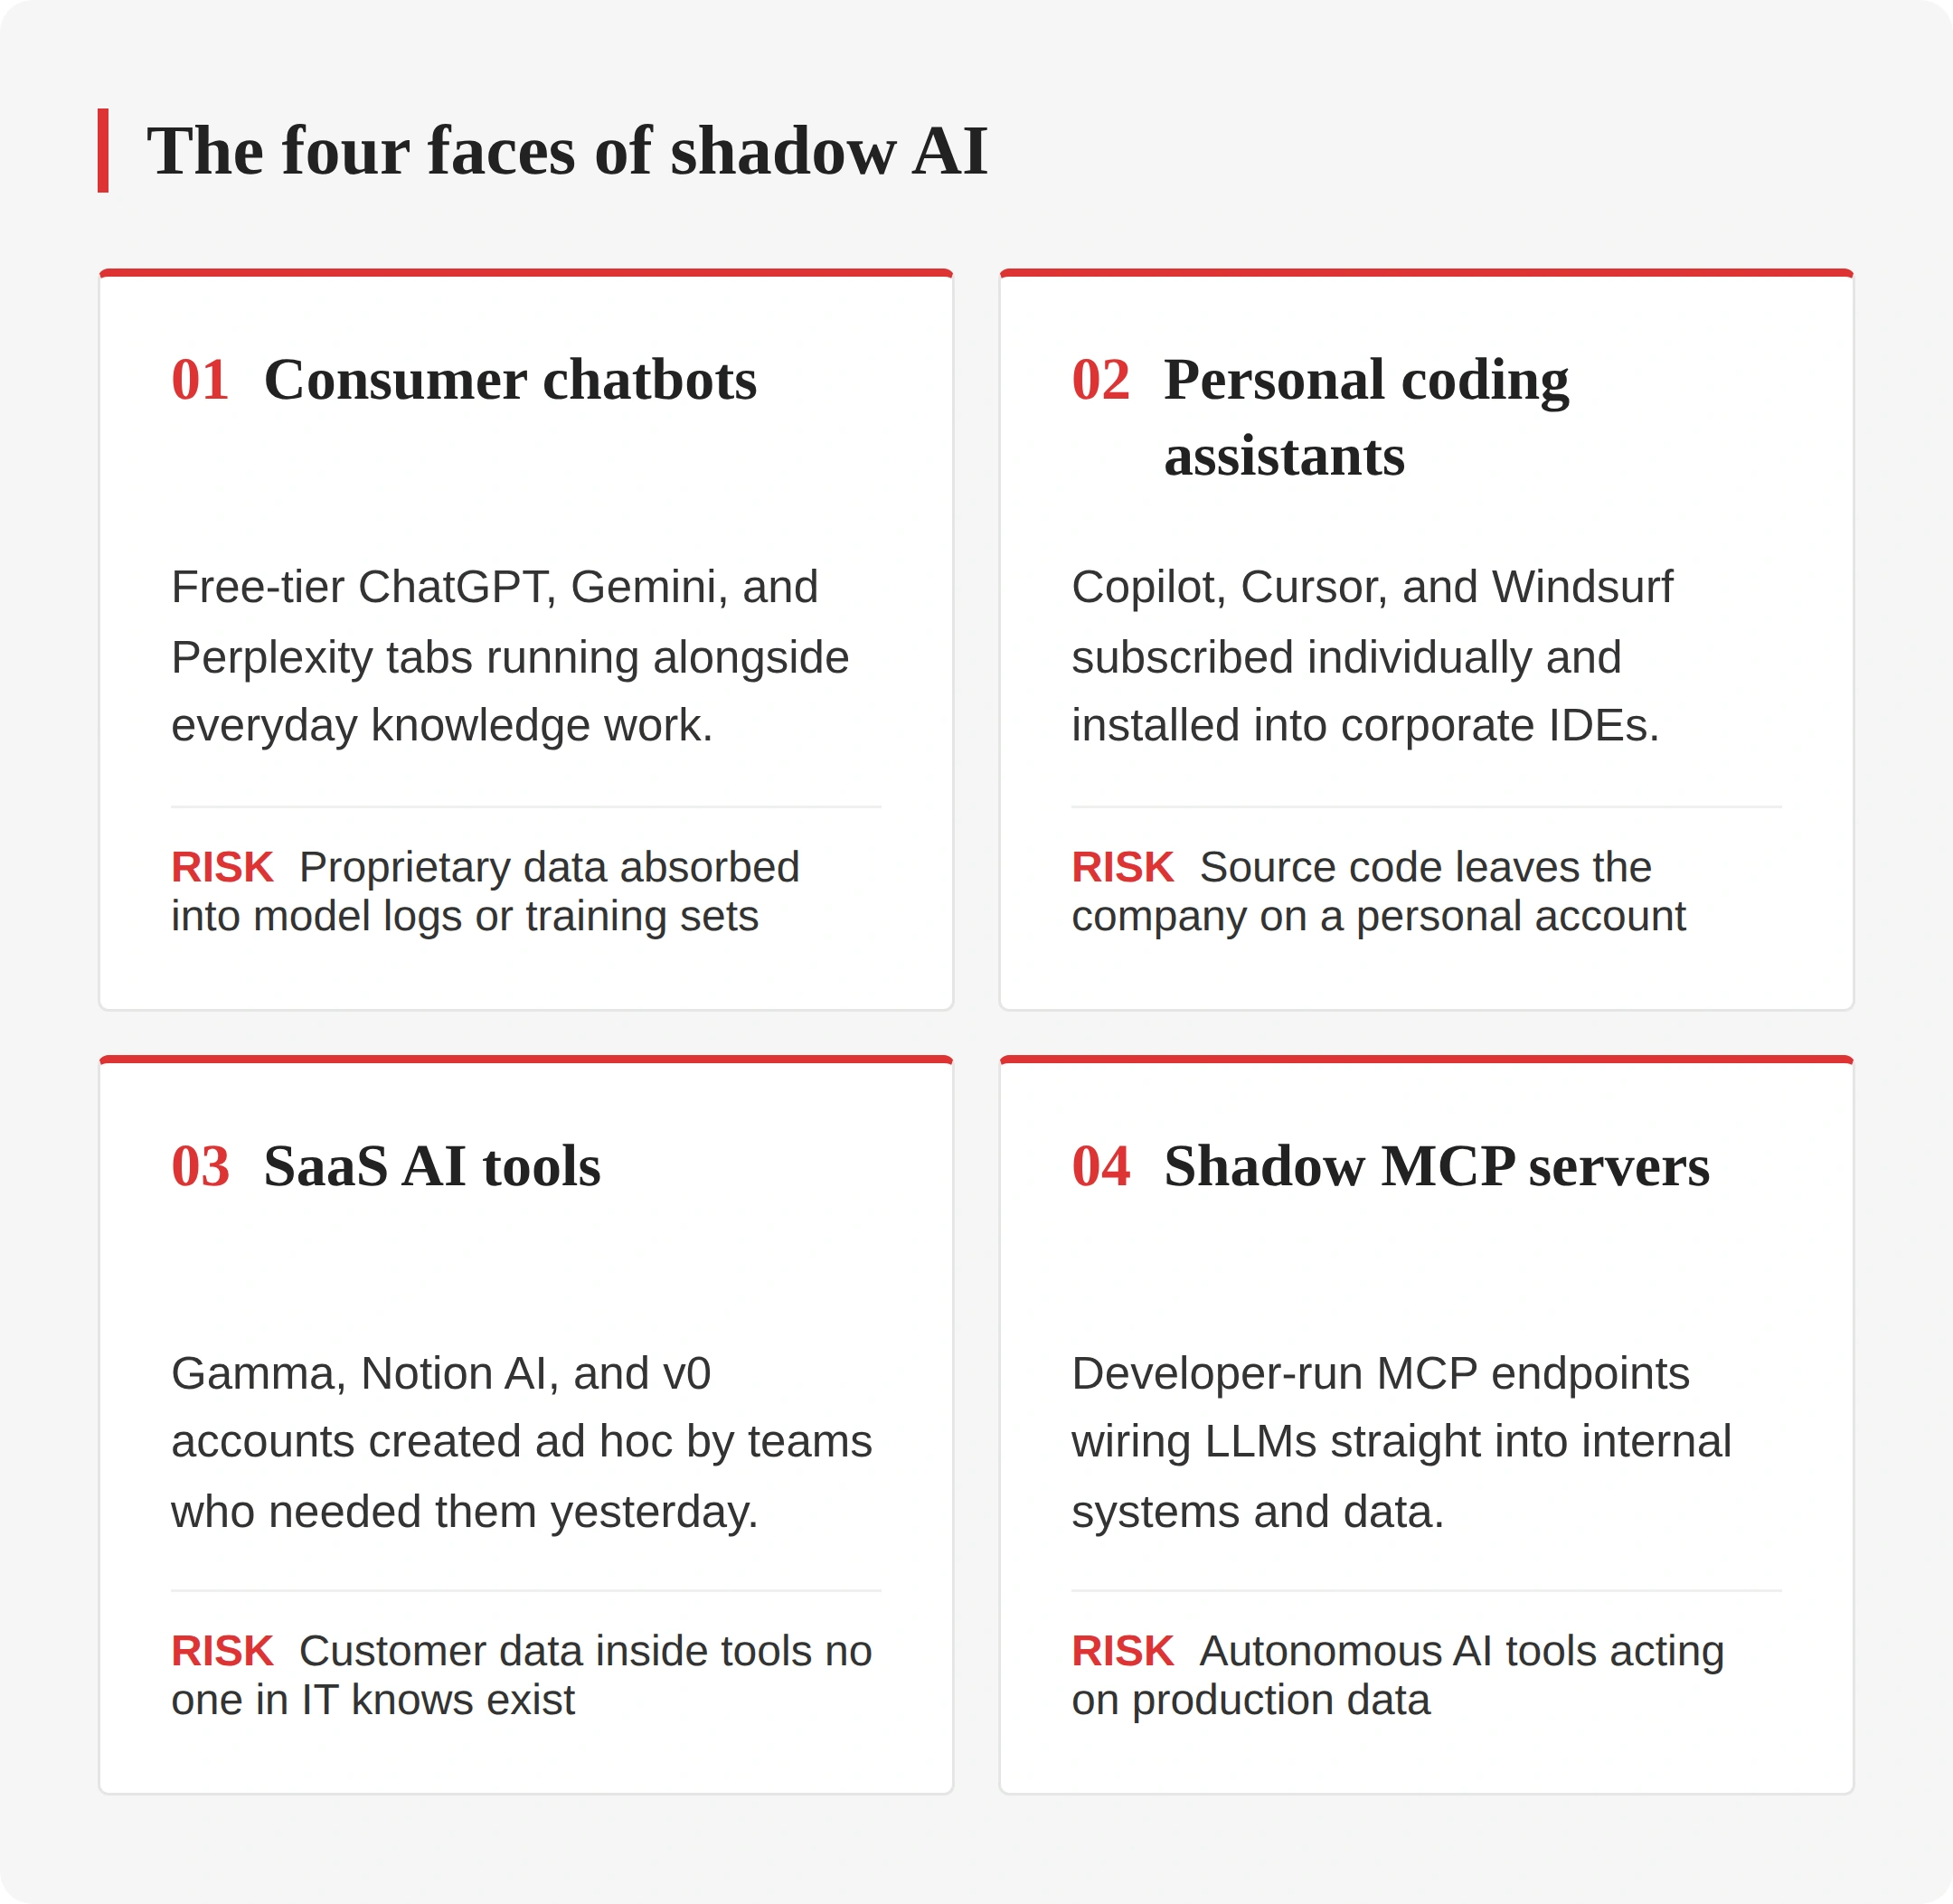
L’IA fantôme est l’utilisation d’outils d’intelligence artificielle non autorisés, tels que les grands modèles de langage, les assistants de codage, les systèmes agentiques et les fonctionnalités d’IA SaaS, au sein d’une organisation sans approbation, surveillance ou supervision de politique de la part de l’informatique ou de la sécurité. C’est une cousine du Shadow IT, mais beaucoup plus ambitieuse.
Les formes courantes d’utilisation de l’IA fantôme incluent :
- ChatGPT grand public, Claude.ai, Gemini et Perplexity ouverts dans un onglet de navigateur lors de la rédaction d’un e-mail client
- GitHub Copilot en version personnelle, Cursor, Windsurf, Cline et Aider payés par la carte de crédit d’un développeur
- Outils SaaS à l’apparence approuvée comme Notion AI, Gamma, v0, Lovable et Bolt inscrits avec un e-mail d’entreprise mais facturés à un compte personnel
- Serveurs Shadow Model Context Protocol (MCP) qui donnent à un LLM local un accès direct en lecture/écriture aux bases de données internes, aux systèmes de fichiers et à Slack
Le rapport 2025 sur le coût d’une violation de données d’IBM a révélé qu’une organisation sur cinq interrogée avait déjà subi une violation liée à l’IA fantôme, ajoutant jusqu’à 670 000 USD au coût moyen des incidents. Les outils de codage agentiques comme Claude Code, Cursor Composer et Devin peuvent valider du code, ouvrir des pull requests et invoquer des API de manière autonome. Ils agissent davantage comme des contractuels non gérés que comme de simples applications logicielles. Pour protéger réellement vos flux de travail, l’établissement de protocoles de sécurité de développement assisté par IA robustes est absolument essentiel.
Pourquoi l'IA fantôme est-elle plus dangereuse que le Shadow IT ?
Trois différences structurelles font de la sécurité de l’IA fantôme un problème plus difficile que le Shadow IT traditionnel. Chacune remodèle une couche de contrôle qui fonctionnait auparavant. Ensemble, elles expliquent pourquoi une interdiction de l’IA échoue généralement là où une interdiction des SaaS a parfois réussi.
Zéro friction à adopter
L’installation de logiciels non autorisés nécessitait auparavant des droits d’administrateur, un téléchargement et occasionnellement un redémarrage. L’utilisation d’une IA non autorisée aujourd’hui nécessite un onglet de navigateur et une action de copier-coller. Ce simple changement fait passer l’adoption du radar de l’informatique à celui de personne, car tous les outils de découverte existants ont été conçus autour de l’événement d’installation.
Exposition permanente et unidirectionnelle des données
Les invites envoyées aux modèles grand public peuvent être conservées dans les journaux, divulguées au personnel de support ou absorbées dans les futurs ensembles d’entraînement. Une analyse de Cyberpress a révélé que 77% des employés partagent des informations d’entreprise via ChatGPT d’une manière qui enfreint la politique interne. Vous ne pouvez pas défaire un algorithme propriétaire une fois copié, et vous ne pouvez pas retirer un enregistrement client des poids d’un modèle.
Comportement autonome et agentique
Les outils d’IA modernes agissent par eux-mêmes. Les assistants agentiques tels que Claude Code, Cursor Composer, Cline et Devin ne se contentent pas de suggérer des extraits de code. Ils valident du code, ouvrent des pull requests, invoquent des API internes et touchent la production. Ce sont moins des « applications non approuvées » que des « contractuels non gérés » avec accès au commit, ce qui re cadre complètement ce que la prévention de l’IA fantôme doit couvrir.
Pourquoi l'IA fantôme est-elle si difficile à détecter ?
La découverte de l’IA fantôme est difficile car la surface d’attaque est énorme et changeante. De nouveaux assistants de codage sont lancés chaque semaine. Les extensions de navigateur injectent des fonctionnalités LLM dans des outils approuvés comme Jira, Confluence et Gmail. Les frameworks agentiques s’exécutent localement et communiquent avec des modèles cloud via HTTPS standard, de sorte que le trafic ressemble à un appel API de routine.
Et la couche humaine est complice. Les développeurs savent qu’une interdiction pure et simple tue leur productivité, alors ils la contournent. Nous pensons que les interdictions générales de l’IA échouent systématiquement, poussant l’adoption dans la clandestinité plutôt que de l’éliminer. Il en résulte un angle mort de gouvernance qui s’agrandit à chaque sprint, et une politique RH de « utilisation acceptable de l’IA » qui, d’après notre expérience d’audit, manque environ 80% de l’exposition réelle car elle traite de l’intention plutôt que de la surface d’attaque technique.
Risques de l'IA fantôme dans le développement logiciel
La livraison de logiciels concentre les risques d’IA cachée. Les preuves sont publiques et récentes. La fuite de Claude Code d’Anthropic a exposé environ 512 000 lignes de code source interne, que nous avons analysées dans notre analyse de la fuite de Claude Code. L’agent de Replit en 2025 a effacé des bases de données sur plus de 1 200 comptes professionnels après avoir produit du code qui « semblait correct » et avait passé la revue. Et deux pannes AWS ont été publiquement liées à des échecs d’outils pilotés par l’IA, un rappel que les risques de sécurité liés à l’IA cachée se situent désormais sur le chemin critique de la disponibilité.
Lorsque la plupart de ces outils sont des abonnements personnels, l’organisation d’ingénierie hérite de six expositions spécifiques qui s’accumulent silencieusement jusqu’à ce que quelque chose casse bruyamment :
- Contamination de licence. Les assistants de codage peuvent émettre des extraits entraînés sur des licences General Public License (GPL), Affero General Public License (AGPL) ou des licences personnalisées et les insérer dans des dépôts propriétaires sans attribution. Une fois fusionnés, leur suppression nécessite souvent une réécriture complète du module affecté.
- Dérive architecturale silencieuse. Un ingénieur junior demande à un LLM de « faire en sorte que cela fonctionne », reçoit une réponse plausible et introduit un modèle qui entre en conflit avec les conventions de l’équipe. Multiplié par 50 ingénieurs et 18 mois, le code base se divise en dialectes que personne ne comprend entièrement.
- Empoisonnement de la chaîne d’approvisionnement (Slopsquatting). Les attaquants enregistrent des noms de packages que les LLM hallucinent, et ces packages malveillants sont silencieusement livrés dans les importations suggérées par l’IA.
- Fuite de secrets via les prompts. Clés API, chaînes de connexion et données clients collées dans des fenêtres de chat pour une « aide rapide », puis conservées sur les serveurs de quelqu’un d’autre.
- Violations de conformité. Des sorties d’IA qui enfreignent le RGPD, la HIPAA, le SOC 2 ou l’AI Act de l’UE — et des chatbots qui inventent des politiques auxquelles l’entreprise est ensuite tenue.
- Défaillance opérationnelle. Des outils agentiels qui livrent du code défectueux, effacent des données ou dégénèrent en incidents de production complets.
Nos services de revue de code incluent des vérifications de provenance de licence conçues pour cette exposition exacte.
Comment détecter l'IA fantôme dans votre organisation
La détection pratique de l’IA fantôme (shadow AI) nécessite une visibilité en couches : aucun outil unique ne donne une image complète. Les cinq étapes ci-dessous vont du trafic réseau à la périphérie vers vos dépôts de code. Exécutez-les en parallèle ; les signaux se renforcent mutuellement.
Étape 1 : Surveiller le trafic réseau quittant votre organisation
Le trafic sortant est le premier endroit où l’utilisation de l’IA apparaît. Auditez vos journaux DNS (Domain Name System) et TLS (le protocole derrière HTTPS) à la sortie de l’entreprise pour détecter les connexions aux points d’inférence — les adresses API où les modèles d’IA s’exécutent. Surveillez OpenAI, Anthropic, Google, Mistral, Perplexity, Groq, DeepSeek, Replicate, Together AI, et les passerelles d’inférence qui les relaient.
Étape 2 : Cartographier l’utilisation des applications Cloud et SaaS
Associez la visibilité réseau à la découverte d’applications SaaS (Software-as-a-Service) via votre plateforme CASB (Cloud Access Security Broker) ou SSE (Security Service Edge). Filtrez les domaines des IDE de codage IA — cursor.sh, codeium.com, windsurf.com, continue.dev — et les outils de productivité IA comme otter.ai, fireflies.ai, notion.so/ai, et gamma.app.
Étape 3 : Croiser les données financières et de dépenses
La finance est l’une des sources les moins exploitées pour la découverte d’IA fantôme. Extrayez les enregistrements de remboursement et signalez les frais répétés inférieurs à 30 USD marqués comme “outils de productivité” ou “abonnements”. Trois mois de Cursor, OpenAI Plus et Notion AI sur les dépenses d’un même ingénieur l’emportent sur n’importe quel journal réseau.
Étape 4 : Inventorier les points de terminaison et l’accès aux identités
Inventoriez chaque extension de navigateur et plugin IDE (Integrated Development Environment) installé dans l’entreprise : les assistants IA arrivent souvent sous forme d’extensions silencieusement installées. Ensuite, extrayez les autorisations OAuth (la norme qui permet à une application d’accéder aux données d’une autre) accordées aux applications IA tierces sur Google Workspace, Microsoft 365, GitHub et Slack. La liste surprend généralement.
Étape 5 : Auditer vos dépôts de code
Scannez les métadonnées des commits à la recherche de clés API divulguées, de noms de paquets suspects qui ont pu être suggérés par un outil IA, et de modèles d’auteurs de pull requests qui ne correspondent pas à la façon dont votre équipe travaille habituellement. Notre liste de contrôle d’audit SDLC détaille chaque couche.
Comment détecter le code généré par l'IA dans un dépôt
C’est là que les outils internes atteignent souvent leurs limites et que les auditeurs de logiciels indépendants justifient leurs honoraires. Les auditeurs recherchent des modèles statistiques et stylistiques que les bases de code purement humaines produisent rarement. Quatre signaux font la majeure partie du travail.
**Les anomalies de vélocité des commits arrivent en premier.** Les développeurs assistés par l’IA livrent nettement plus de code par unité de temps, et la distribution est irrégulière. Une augmentation soudaine de 200 à 900 lignes de code entièrement nouveau un vendredi après-midi, surtout sur des modules inconnus, est un indicateur avancé. Les auditeurs examinent les graphiques de commits des 12 derniers mois et recherchent des changements de phase qui ne correspondent pas aux embauches ou aux réorganisations d’équipe.
**L’homogénéisation stylistique est le deuxième signal.** Les développeurs humains ont des empreintes digitales : cadence des commentaires, bizarreries de nommage des variables, structure des tests, préférence pour les retours anticipés plutôt que pour les conditions imbriquées. Les assistants IA aplatissent cela. Lorsque 40 ingénieurs commencent à écrire dans la même voix, à produire le même format de docstring, et à graviter autour des mêmes trois patrons de conception, le dépôt a discrètement acquis un nouvel co-auteur.
**Les fragments de code contaminés par des licences sont le troisième et le plus lourd de conséquences juridiques.** Les auditeurs exécutent des analyses SCA ajustées pour les constantes suspectes, les chaînes de commentaires distinctives et les fragments copyleft connus. Les correspondances avec les parcours de données d’entraînement publics suggèrent une régurgitation de l’IA plutôt qu’un travail original.
**Les marqueurs de slopsquatting de dépendances** — des paquets qui existent sur npm mais n’ont aucun signal de confiance réputé — complètent les vérifications principales.
Enfin, les auditeurs examinent la forme de la couverture de tests. Les tests générés par l’IA couvrent souvent le chemin heureux à merveille et ignorent les cas limites. Un rapport de couverture qui semble parfait dans l’ensemble mais qui se concentre sur des conditions triviales est une autre indication.
Nous appliquons ce cadre de signalisation à l’ensemble de notre travail d’audit SDLC. Lors de l’audit de la plateforme immobilière Adoorabelle et de la revue de la base de code Site Compass, nous avons examiné les modèles de commits, la cohérence architecturale, l’hygiène des dépendances et la qualité de la couverture de tests. Ces indicateurs font maintenant ressortir de manière fiable le travail assisté par l’IA aux côtés des problèmes traditionnels de qualité du code.
Outils avancés pour détecter les risques liés à l'IA fantôme
Aucune plateforme unique ne domine encore la catégorie, la plupart des entreprises assemblent donc une pile technologique. Traitez le tableau ci-dessous comme un menu plutôt qu’une liste d’achats. Nous pensons que la superposition de trois à cinq produits ciblés est préférable à l’achat d’une seule « plateforme » qui prétend tout faire. Chaque outil de cet ensemble couvre une couche distincte du problème de détection de l’IA fantôme.
Netskope
Périmètre réseau / Découverte GenAI
Découverte d’applications GenAI en temps réel et application des politiques de sortie
Visibilité de première ligne sur tous les outils d’IA que les employés utilisent
Obsidian Security
Sécurité SaaS
Mappage OAuth SaaS-à-SaaS et inventaire des applications d’IA tierces
Mise en évidence des autorisations OAuth silencieuses pour les outils d’IA sur Google, Microsoft et GitHub
Cyberhaven
Sécurité des données et risque lié à l’IA
Lignage des données comportementales de la source à l’invite IA
Traçage des données qui entrent dans quel modèle, au-delà des modifications
Harmonic Security
DLP GenAI
Protection des données dédiée aux interactions GenAI et aux agents
Blocage des données sensibles avant qu’elles n’atteignent le modèle
Proofpoint
Email & DLP
Inspection de contenu consciente de l’IA et isolation du navigateur
Arrêter le copier-coller et les téléchargements de données sensibles vers des onglets LLM non autorisés
Exabeam
SIEM & UEBA
Analyse comportementale des sessions liées à l’identité
Détection d’anomalies dans les modèles d’invites et de téléchargement
Zenity
Sécurité des agents IA
Découverte et gouvernance en temps réel pour les agents IA, les copilotes et les serveurs MCP
Sécuriser l’IA agentielle dans les environnements SaaS, cloud et appareils
Knostic
Sécurité des assistants de codage IA
Garde-fous d’exécution pour Copilot, Cursor, Claude Code et Windsurf
Blocage des serveurs MCP, plugins et extensions IDE non sécurisés dans les environnements de développement
Snyk
Sécurité développeur
Analyse des commits et des dépendances influencés par l’IA, axée sur les développeurs
Équipes SDLC souhaitant que la sécurité soit intégrée à l’IDE
Checkmarx
AppSec (SAST/SCA)
Modules de risque IA et analyse de vulnérabilités générées par IA
Sécurité du code pré-fusion dans les pipelines matures
Veracode
AppSec (SAST/DAST/SCA)
Analyse des vulnérabilités et licences générées par IA
Programmes AppSec d’entreprise avec obligations de conformité
Sonatype
Chaîne d’approvisionnement
Gouvernance de l’open-source et détection de slopsquatting
Intégrité des dépendances dans les pipelines basés sur Nexus
JFrog
DevSecOps / gestion des artefacts
Catalogue et curation IA, validation des modèles au niveau du registre
Contrôle des artefacts binaires et des modèles au niveau du registre
Bonnes pratiques pour éliminer l'IA fantôme
Essayer d’éliminer complètement l’IA fantôme n’est ni réaliste ni souhaitable. Les employés se sont tournés vers ces outils car ils accéléraient le travail. L’objectif réel est de faire passer l’utilisation de l’ombre vers une pile homologuée, observable et protégée contractuellement. Utilisez la liste de contrôle ci-dessous comme programme de base :
- Créez un catalogue d’outils IA homologués avec des contrats de rétention zéro donnée et un flux de journaux d’audit vers votre SIEM.
- Proposez des licences professionnelles pour Copilot, Cursor et un niveau ChatGPT ou Claude gouverné afin que les développeurs n’aient plus de raison économique d’utiliser des comptes personnels.
- Rédigez une politique d’utilisation acceptable conjointement avec l’ingénierie et la sécurité, et non pas seulement avec les RH — les politiques qui abordent la surface technique survivent aux cycles de sprint.
- Exigez une révision CODEOWNERS sur chaque pull request influencé par l’IA, et étiquetez les commits par provenance pour le triage des réponses aux incidents.
- Imposez des listes blanches de dépendances pour bloquer les paquets malveillants avant qu’ils n’atteignent la compilation.
- Exécutez l’analyse des licences avant fusion et l’analyse des secrets avant commit comme des points de contrôle non négociables dans le pipeline.
- Rendez la découverte continue, pas annuelle — le paysage des outils IA change chaque mois, et les vérifications ponctuelles deviennent vite obsolètes.
Notre guide des bonnes pratiques SDLC couvre l’intégration complète du pipeline pour chacun de ces contrôles.
L'audit que vous ne pouvez plus ignorer
L’IA fantôme n’est plus à côté de votre SDLC. C’est votre SDLC en 2026. La question honnête au niveau du conseil d’administration n’est pas de savoir si l’IA est dans le code source, mais quelle quantité, produite par quels outils, sous quelles licences, et traçable à qui.
Les organisations qui gèrent bien cela partagent trois pratiques. Elles disposent d’une pile d’outils IA inventoriée et homologuée avec un flux de journaux d’audit vers le SIEM et des contrats de rétention zéro donnée. Elles traitent le code généré par IA comme si c’était du code provenant d’un contributeur non vérifié. Et elles ont une fonction d’examen externe — qu’il s’agisse d’une équipe rouge interne AppSec ou d’un audit SDLC tiers — qui examine non seulement le code, mais aussi le processus par lequel le code entre dans le dépôt.
Si vous souhaitez obtenir une lecture claire de ce qui se trouve réellement dans votre base de code — qui l’a écrit, quels outils IA l’ont touché, et où se situent les lacunes en matière de licences et de sécurité — parlez à notre équipe d’audit SDLC. Une conversation est gratuite. Apprendre d’un régulateur ne l’est pas.
Questions fréquemment posées
Qu'est-ce que l'IA fantôme ?
Il s’agit de l’utilisation non autorisée d’outils d’intelligence artificielle, de modèles ou d’assistants de codage par les employés, sans l’approbation explicite ou la supervision des services informatiques et de sécurité. Cet accès non autorisé contourne directement les protocoles de sécurité de l’entreprise.
Quels sont les meilleurs outils pour traiter l'IA fantôme (shadow AI) ?
L’approche la plus efficace utilise une stratégie de défense multicouche. Nous recommandons de combiner une plateforme SIEM comme Exabeam pour l’analyse comportementale, le suivi de la lignée des données via Cyberhaven et une analyse rigoureuse du code source à l’aide de Checkmarx ou Veracode.
Comment détecter l'utilisation d'un modèle d'IA non autorisé ?
Une détection efficace de l’IA fantôme nécessite de surveiller le trafic réseau pour détecter les pics inattendus d’appels API vers les points d’accès des modèles grand public. Vous devriez également configurer vos outils de prévention des pertes de données pour vous alerter lorsque de larges blocs de code propriétaire sont collés dans des navigateurs web.
Quels sont les risques de l'IA fantôme dans le développement logiciel ?
Les principaux dangers incluent le vol grave de propriété intellectuelle, la violation involontaire du droit d’auteur due à des extraits de code contaminés et l’encodage en dur de secrets sensibles dans des modèles publics.
Comment détecter un code généré par IA dans un dépôt ?
Il faut rechercher des signaux auditeurs spécifiques. Surveillez les vitesses de validation impossibles, les changements soudains et drastiques dans le style de codage unique d’un développeur, et l’apparition soudaine de dépendances de bibliothèques anormales.
Découvrez comment nous avons audité la base de code d'Adoorabelle, identifié 80 problèmes cachés et réduit les coûts d'infrastructure de 3 600 $/an