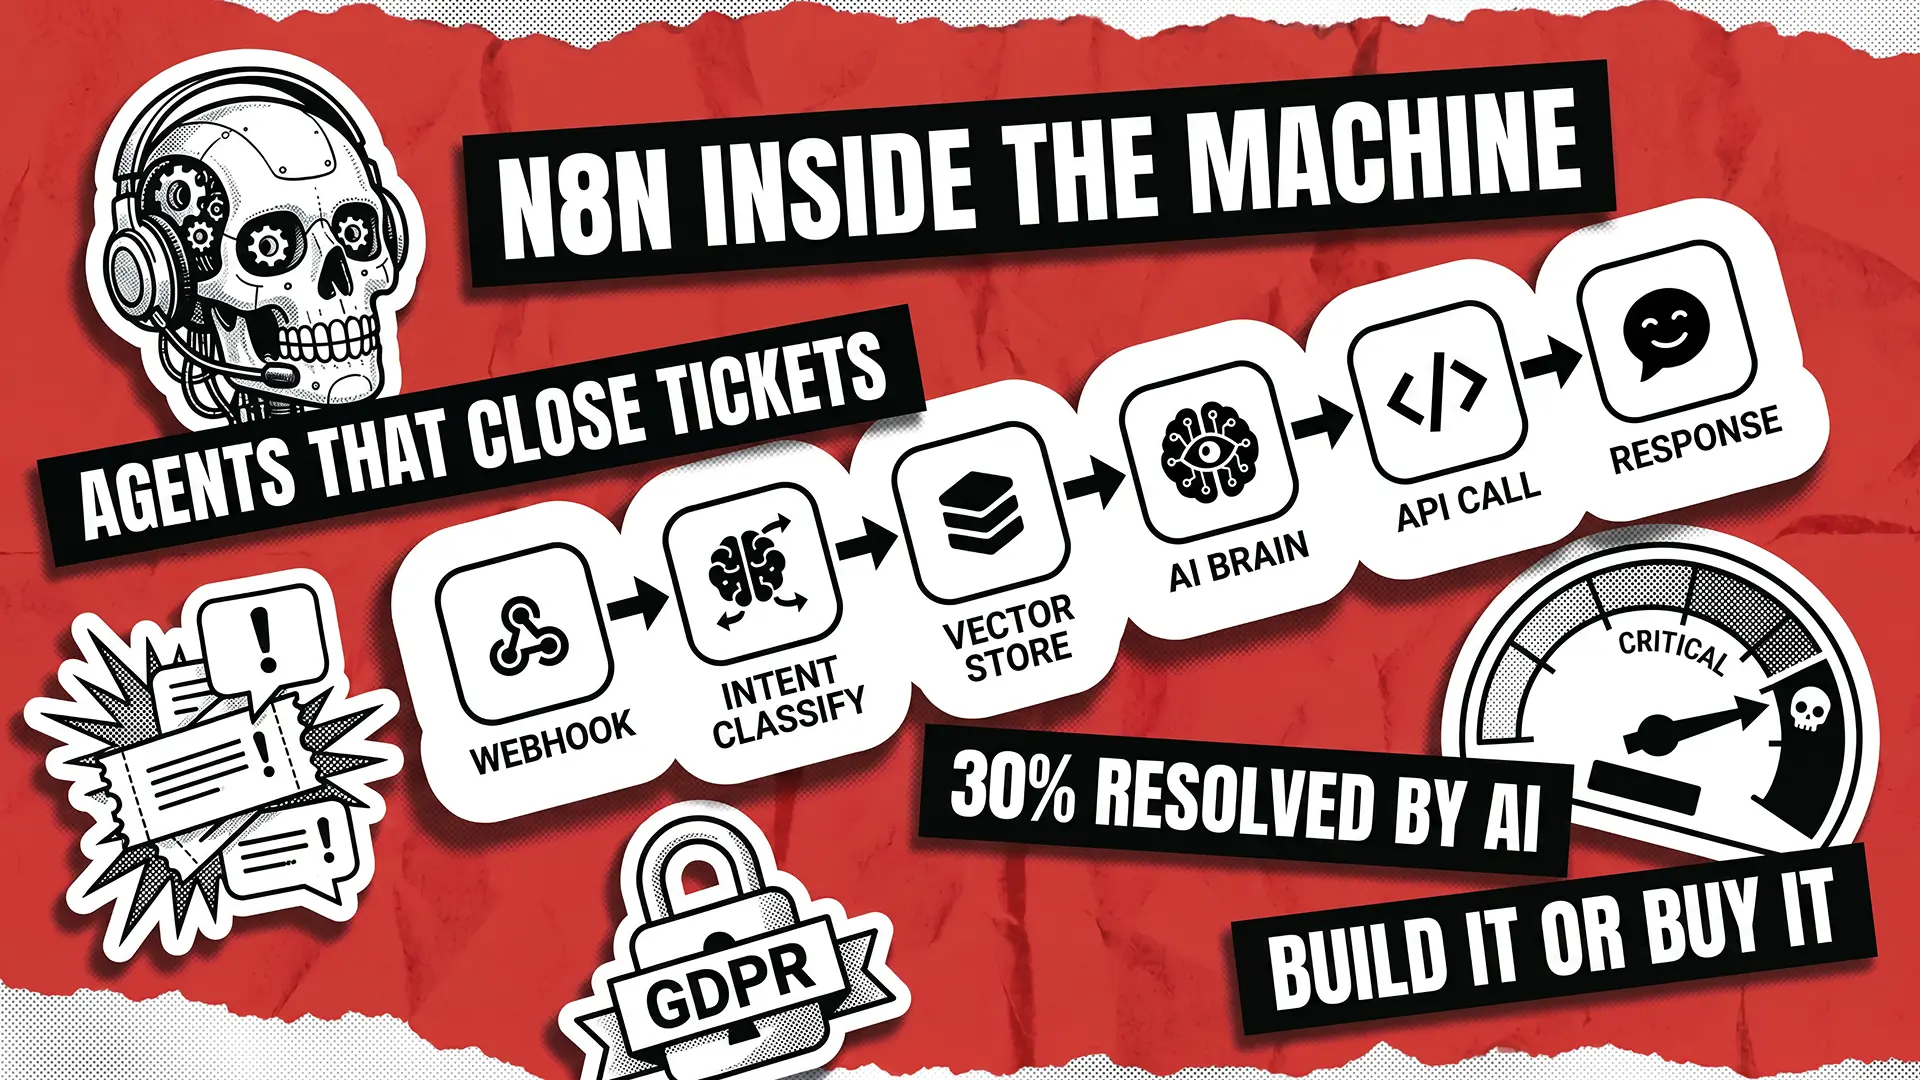
La plupart des tutoriels sur les agents de support IA vous montrent le chemin idéal. Ils s’arrêtent juste là où le vrai travail commence, c’est-à-dire au moment où un client réel intercepte votre flux de travail avec une question à laquelle personne n’avait pensé. Selon le 7e rapport State of Service de Salesforce, basé sur 6 500 professionnels du service client dans le monde, 30 % des cas de service client sont déjà résolus par l’IA en 2025, et ce chiffre devrait atteindre 50 % d’ici 2027. L’adoption n’est plus la partie difficile. L’architecture, elle, l’est.
Cet article vous guide à travers ce qui se cache réellement derrière un agent de support client IA fonctionnel construit sur n8n. Nous abordons les compromis que vous faites dès le premier jour, les trois décisions qui déterminent si votre agent est évolutif, les modes d’échec que nous avons observés en production, et les métriques qui vous indiquent que le système porte ses fruits.
Pourquoi créer un agent de support avec n8n au lieu d'en acheter un
L’achat d’un outil IA de helpdesk prêt à l’emploi est la bonne décision lorsque vous avez besoin d’analyses précises dès le premier jour, que vous n’avez pas d’ingénieur pour maintenir quoi que ce soit, ou que vous traitez moins de 500 tickets par mois. Pour tous les autres, la création sur n8n devient rapidement pertinente.
Trois raisons reviennent dans chaque conversation que nous avons avec des fondateurs et des CTO qui pèsent cette décision :
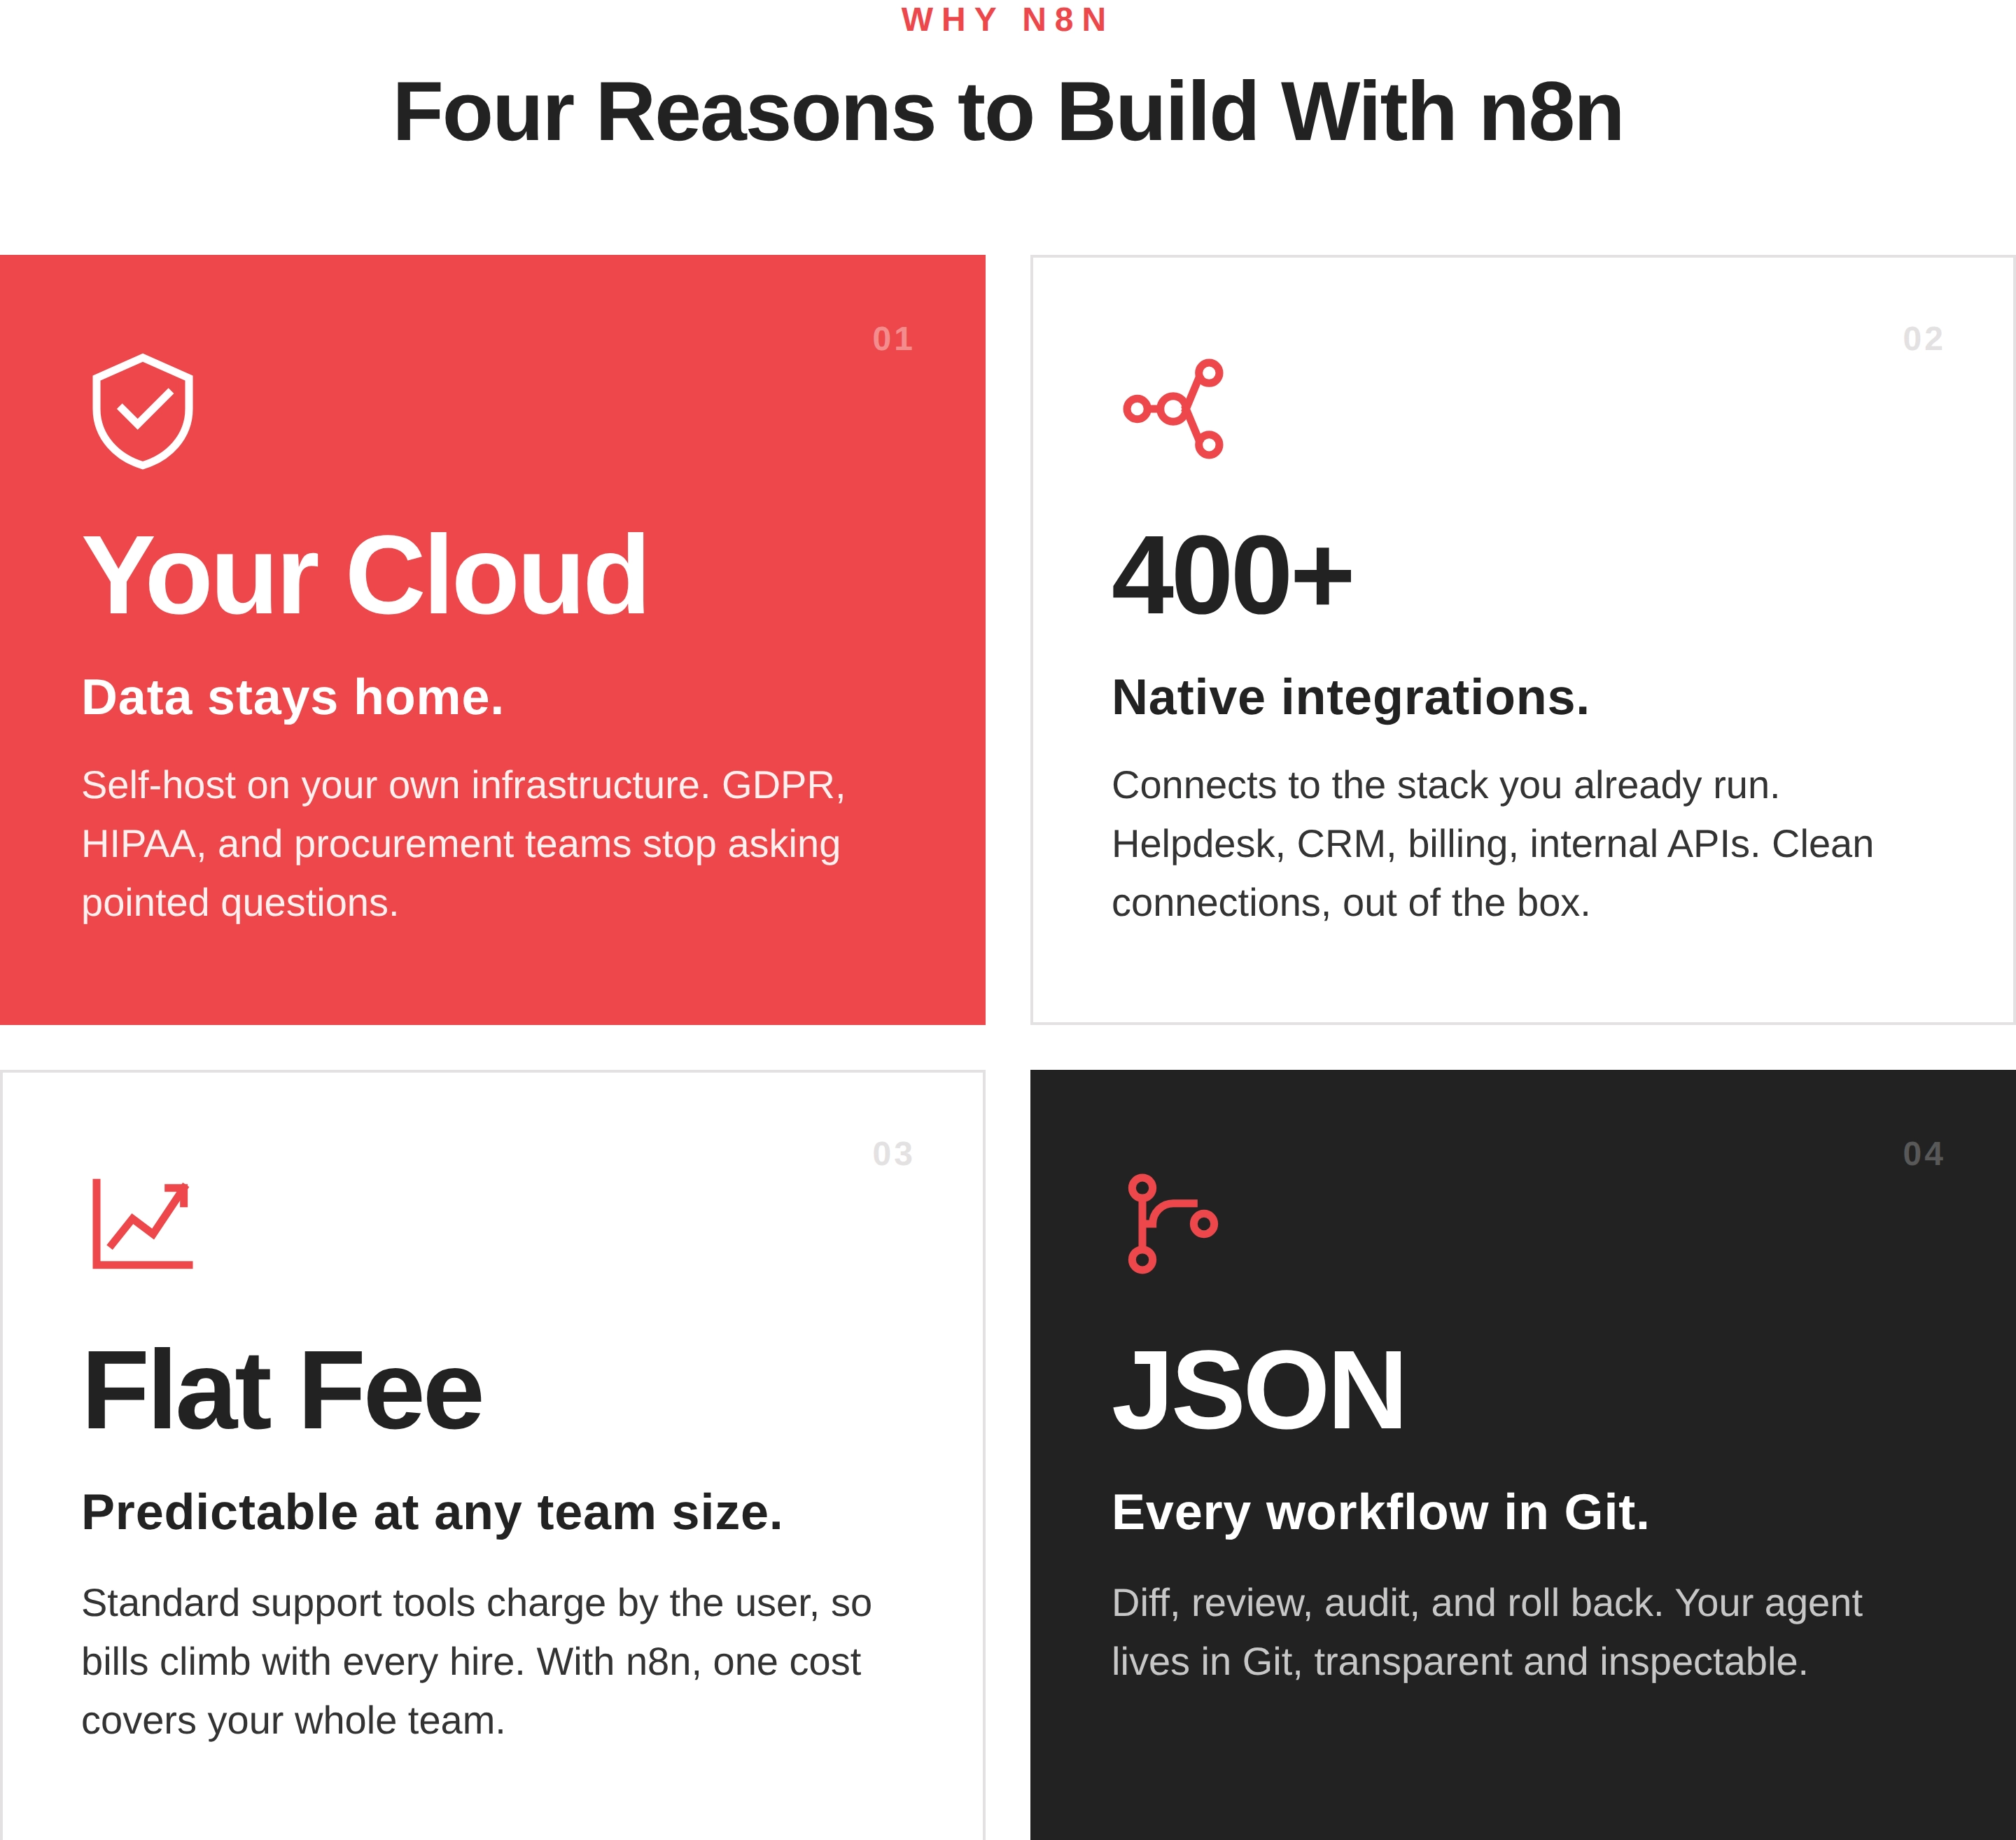
- Les données restent où vous le souhaitez. Hébergez vous-même n8n sur votre propre cloud et les conversations des clients ne quittent jamais votre périmètre. C’est important pour quiconque est soumis au RGPD, au HIPAA, ou à une équipe d’approvisionnement qui pose des questions pointues.
- Vos systèmes s’intègrent nativement. Votre facturation, votre CRM, votre système de billetterie et vos outils internes communiquent déjà entre eux. n8n communique avec eux aussi, via plus de 400 connecteurs et un nœud HTTP propre pour le reste.
- Le coût évolue linéairement avec le volume, pas avec le nombre de postes. Pas de licence par agent en plus de votre facture LLM.
Les fonctionnalités d’automatisation des flux de travail de n8n qui sont réellement importantes ici sont spécifiques : le nœud AI Agent encapsule LangChain sans le code répétitif, les nœuds de sous-mémoire gèrent l’état de la conversation, le mode file d’attente avec Redis permet de mettre à l’échelle les travailleurs sur plusieurs instances, et chaque flux de travail est versionnable en tant que JSON. Ce dernier point à lui seul amortit l’effort de création lorsque vous devez vérifier ce qui a changé et quand.
L'architecture d'un agent de support client IA dans n8n
Un agent de support fonctionnel n’est pas un seul flux de travail. C’est un pipeline composé de huit couches, chacune ayant une tâche spécifique et pouvant être remplacée. Si vous établissez correctement les couches, vous pouvez remplacer le LLM, la base de données vectorielle ou le système de ticketing sans avoir à tout réécrire.
Voici la pile technologique, de haut en bas :
- Ingestion. Webhook, déclencheur d’e-mail, widget de chat ou API de helpdesk. Cette couche reçoit les entrées brutes du client provenant de n’importe quel canal.
- Normalisation. Mappez chaque charge utile entrante vers un schéma unique : ID client, canal, langue, message, priorité. Les nœuds en aval ne devraient jamais se soucier de l’origine du message.
- Classification des intentions. Un modèle petit et rapide (gpt-4o-mini fonctionne bien) dirige le message vers le sous-flux de travail approprié. Les questions de facturation vont d’un côté, les problèmes techniques d’un autre, les signaux d’attrition d’un troisième.
- Récupération de contexte. RAG par rapport à votre base de connaissances. Récupérez les trois à cinq passages les plus pertinents avec des citations de source.
- Raisonnement. Le nœud AI Agent combine le prompt système, la mémoire, le contexte récupéré et les outils. C’est le cerveau.
- Exécution des actions. Appels d’outils autorisés et audités : mise à jour d’un ticket, remboursement d’une commande, planification d’un rappel. Chaque action est son propre sous-flux de travail, pas un appel d’API en forme libre depuis un prompt.
- Composition de la réponse. Passage de la voix de marque, évaluation de la confiance, garde-fous.
- Observabilité. Enregistrez les entrées, les tokens, les appels d’outils, le contexte récupéré et les résultats. Si ce n’est pas enregistré, vous ne pouvez pas le déboguer.
La règle de conception est simple. Chaque couche a une seule responsabilité, et chaque couche peut être testée isolément. Ignorer cette structure est la raison pour laquelle les coûts cachés d’une intégration d’IA médiocre s’accumulent silencieusement avant de surgir en production, et c’est la raison la plus fréquente pour laquelle les équipes finissent par payer pour le développement d’IA deux fois.
Trois décisions architecturales qui font ou défont votre agent de support
La plupart des agents de support client échouent en production en raison de trois décisions prises trop rapidement pendant la phase de prototypage. Voici comment bien les prendre chacune.
Mémoire : Quel type et pourquoi
n8n vous offre trois options de mémoire, et elles ne sont pas interchangeables. La mémoire simple réside dans le contexte d’exécution du flux de travail, ce qui signifie qu’elle disparaît lorsque le flux de travail redémarre. C’est bien pour une démo. C’est une catastrophe lors d’une conversation avec un client frustré, sept minutes après le début d’un problème de paiement.
Vos vrais choix sont deux. La mémoire de chat PostgreSQL persiste après les redémarrages, ajoute environ 40 ms de latence par appel, et gère environ 50 sessions simultanées sans problème. C’est la bonne option par défaut pour la plupart des charges de travail de support B2B. La mémoire de chat Redis est celle que vous utilisez une fois que vous dépassez 50 sessions simultanées ou que vous passez à n8n multi-instance en mode file d’attente, avec une récupération inférieure à 10 ms et pas de blocage.
Une petite règle qui évite bien des soucis plus tard : l’ID de session doit toujours être l’ID du client, jamais l’ID d’exécution. Liez la mémoire à qui parle, pas à quelle exécution est déclenchée. C’est ainsi que vous conservez le contexte entre les canaux lorsque le même client passe du chat à l’e-mail.
Récupération : Ancrer les réponses
La récupération est ce qui permet à un système de service client intelligent de rester honnête. Sans ancrage, votre agent invente des choses avec une totale confiance. Avec l’ancrage, il cite vos documents.
Ce qui fonctionne en production repose sur quatre pratiques :
- Découpez les documents de la base de connaissances en fragments de 500 caractères avec un chevauchement de 50 caractères, plus court pour les FAQ et plus long pour les documents de politique.
- Stockez les embeddings dans Pinecone, Qdrant ou Supabase pgvector, qui s’intègrent tous proprement à n8n.
- Retournez les citations sources avec chaque réponse, car sans citation, pas de réponse.
- Mettez en cache vos questions les plus fréquentes, car les tickets de niveau 1 se concentrent autour des requêtes récurrentes et vous ne devriez pas payer pour un appel LLM deux fois sur le même contenu.
Chaque détail compte ici, c’est pourquoi les bonnes pratiques RAG constituent leur propre sous-discipline au sein de l’ingénierie IA.
Outils : Ce que l'agent peut réellement faire
Un agent de support sans outils est un chatbot. Un agent de support avec des outils est un système capable de résoudre des tickets. C’est le cœur de l’automatisation du service client et ce qui distingue les agents IA de n8n qui résolvent réellement les demandes des bots qui font juste du bruit.
Construisez des outils sous forme de sous-flux de travail explicites, un par action :
- Rechercher le statut d’une commande
- Créer une étiquette de retour
- Émettre un remboursement sous un certain seuil
- Planifier un rappel
Deux règles permettent de sécuriser cela. Premièrement, validez les entrées à l’intérieur de l’outil, pas dans le prompt. Les LLM essaieront de passer des absurdités si vous les laissez faire. Deuxièmement, soumettez chaque action à fort impact à une étape d’approbation humaine : remboursements supérieurs à 100 $, suppression de compte, exceptions de politique. Enregistrez chaque appel d’outil avec l’ID client, l’entrée, la sortie et l’horodatage, afin d’avoir une piste lorsque quelqu’un demande ce qui s’est passé.
Ce qui échoue : Modes d'échec des déploiements réels
Tous les articles sur ce sujet s’arrêtent à la situation idéale. C’est là que commence la partie utile. Une enquête Gartner menée auprès de 321 responsables du service client en octobre 2025 a révélé que 91 % d’entre eux subissent la pression de la direction pour mettre en œuvre l’IA. La pression pour livrer produit rarement une architecture propre, c’est pourquoi les mêmes schémas d’échec se manifestent dans les déploiements. Voici les façons spécifiques dont cela se brise en pratique.
- Boucles d’appel d’outils. L’agent continue d’appeler la même recherche car la réponse indique “non trouvé”. Corrigez avec une limite de boucle, un délai d’attente et une gestion humaine élégante.
- Épuisement de la fenêtre de contexte. Une longue conversation dépasse le budget de jetons et l’agent oublie ce qui a été convenu cinq tours auparavant. Utilisez une mémoire à fenêtre glissante et résumez les tours plus anciens en un seul bloc de contexte.
- Dérive de récupération. Votre politique a changé en janvier, mais la base de données vectorielle a été réindexée pour la dernière fois en octobre. L’agent cite avec assurance l’ancienne politique. Corrigez avec une ingestion programmée, des balises de version sur les morceaux et une vérification hebdomadaire des différences.
- Cascades de limites de débit. Les pics de trafic, votre fournisseur de LLM limite, les clients attendent, la file d’attente s’agrandit, plus de clients réessayent, la file d’attente s’agrandit encore. Définissez des tentatives aléatoires et un repli vers un modèle plus petit.
- Données personnelles identifiables dans les journaux. Votre historique d’exécution contient désormais des numéros de carte de crédit et des adresses personnelles pour toujours. Masquez à l’entrée, pas à la sortie. La valeur brute ne doit jamais toucher le journal.
- Dérive des invites. Quelqu’un modifie l’invite système un vendredi, et la qualité baisse tout le week-end avant que quelqu’un ne s’en aperçoive. Versionnez les invites dans Git et exécutez une suite de régression de dix cas à chaque modification.
Chaque élément de cette liste peut être détecté plus tôt que les équipes ne le pensent, à condition qu’une assurance qualité rigoureuse soit intégrée au flux de travail dès le premier jour plutôt que d’être ajoutée au lancement. La même rigueur s’applique tout au long de la durée de vie du système, c’est pourquoi la maintenance logicielle durable à l’ère de l’IA ressemble beaucoup moins à la gestion d’urgence d’un monolithe hérité.
Les métriques qui indiquent que cela fonctionne
Les métriques sont importantes car votre directeur financier va vous les demander. Voici ce qu’il faut surveiller et ce qui est considéré comme une bonne performance en 2026 :
- Taux de déviation. Pourcentage de tickets résolus sans intervention humaine. Les données de Salesforce de 2025 situent la référence actuelle de l’industrie à 30 % des cas résolus par l’IA, les responsables du service s’attendant à 50 % d’ici 2027 et une réduction moyenne de 20 % des coûts de service et des temps de résolution.
- Temps de première réponse. C’est là que l’IA surpasse le plus visiblement les humains, passant souvent de plusieurs heures à quelques secondes une fois les couches d’entrée et d’intention réglées.
- Distance d’édition. Lorsqu’un agent humain reprend une réponse rédigée, combien la modifie-t-il ? Moins c’est mieux, et c’est votre indicateur de qualité silencieux.
- Coût par résolution. Les tickets de niveau 1 traités par l’IA coûtent une fraction de ceux traités par des humains, c’est pourquoi le cas du ROI tient généralement la route, même avant de compter les gains de déviation.
- CSAT sur les tickets traités par l’IA. Selon le rapport Zendesk CX Trends 2026, 85 % des responsables CX déclarent que les clients abandonneront une marque après un seul problème non résolu, votre base ne peut donc pas baisser. Les entreprises qui implémentent la déviation IA de niveau 1 avec des données propres constatent généralement une amélioration du CSAT, et non une baisse, dans les 90 jours.
Mettez en place une boucle d’examen hebdomadaire sur ces cinq points : examen des logs, réglage des prompts, rafraîchissement de la base de connaissances. Cette boucle fait la différence entre un pilote qui stagne et un système qui s’améliore mois après mois.
Du prototype à la production
La conformité n’est pas une réflexion après coup en 2026. Les directives officielles de Google sur le contenu généré par IA définissent la norme pour tout ce que votre agent produit : le contenu qui atteint les clients, se classe dans les moteurs de recherche ou influence les décisions doit être utile, fiable et centré sur l’humain, pas un remplissage généré automatiquement. La même exigence s’applique à ce que votre agent de support dit à un client payant à 2h du matin.
Avant de déployer, vérifiez ces trois points :
- L’agent refuse ce qu’il devrait refuser
- Il escalade vers un humain lorsque la confiance tombe en dessous de votre seuil
- Il ne répond jamais sans citer sa source pour les questions factuelles
C’est ce qui sépare un chatbot qui vous met dans l’embarras d’un agent de support client IA qui gagne réellement la confiance. Associez cela à une approche de transformation numérique appropriée et vous obtenez un système qui fait avancer l’entreprise au lieu de la décorer.
En résumé
Un agent de support IA dans n8n est un système réel, pas un projet de week-end. Construisez-le par couches, prenez les trois décisions difficiles sur la mémoire, la récupération et les outils avec les yeux ouverts, prévoyez les six modes d’échec avant qu’ils ne vous anticipent, et mesurez les cinq indicateurs chaque semaine.
Nous construisons et auditons des systèmes de production depuis 2005, en Amérique du Nord, en Europe, en Australie et en Nouvelle-Zélande. Si vous souhaitez qu’un ingénieur soumette votre agent à un stress test avant qu’il ne rencontre de vrais clients, contactez-nous et nous organiserons une revue d’architecture de trente minutes. Pas de diapositives, juste des retours honnêtes.
Découvrez comment nous avons créé MyJiraBot — un bot d'automatisation Telegram gérant désormais les flux de travail pour plus de 50 entreprises dans le monde.