Si vous jouez avec le RAG juste pour impressionner votre conseil d’administration, passez votre chemin. Si vous voulez que la génération augmentée par récupération alimente des produits auxquels vos utilisateurs font confiance à 2h du matin, parlons-en.
Plus de 70 % des nouvelles fonctionnalités LLM échouent silencieusement en production car l’architecture RAG est ajoutée à la hâte plutôt que conçue dès le départ dans les pipelines d’IA. Les équipes indexent quelques PDF dans des bases de données vectorielles, connectent une interface utilisateur de chat et espèrent que la recherche sémantique corrigera par magie les hallucinations. Spoiler : ce n’est pas le cas. Lorsque nous concevons la génération augmentée par récupération dans le cadre de travaux plus larges de développement de LLM, nous traitons la récupération, l’orchestration et l’observabilité comme des éléments centraux du produit, et non comme « une intégration de plus ».
Ci-dessous, un guide pratique et de niveau fondateur sur les meilleures pratiques RAG – les choses qui améliorent réellement les métriques de précision, de latence et de confiance, étayées par des recherches récentes, pas par du battage médiatique.
Ce que le RAG corrige réellement (et ce qu'il ne corrige pas)
La génération augmentée par récupération connecte vos grands modèles de langage à une base de connaissances organisée afin que le modèle réponde à partir de vos données plutôt que d’improviser. C’est la théorie.
En pratique, vous obtenez trois avantages principaux si votre implémentation RAG est correctement réalisée :
- Des réponses ancrées au lieu d’hallucinations. Le modèle cite les segments récupérés de votre base de connaissances et les utilise comme contexte d’ancrage pour le prompt.
- Des connaissances à jour et spécifiques au domaine. Vous pouvez mélanger des documents statiques, des données quasi temps réel et des systèmes internes sensibles sans avoir à réentraîner le modèle chaque semaine.
- Une surface de risque contrôlée. Vous décidez quelles sources peuvent être indexées, ce qui est filtré et quels modèles d’architecture RAG sont autorisés à répondre à quelles requêtes.
Le RAG ne corrigera pas :
- Une mauvaise UX produit
- Une gouvernance inexistante
- Une documentation complètement désordonnée et contradictoire
Si vos documents sont chaotiques, le RAG ne fait que devenir un amplificateur de chaos très confiant.
Principe n°1 : Traitez la récupération comme un système de première classe, pas un assistant
La plupart des flux de travail RAG défaillants ont une chose en commun : la récupération a été une réflexion après coup ajoutée à un preuve de concept (POC) de LLM. Des études récentes montrent que l’optimisation de la récupération seule peut améliorer la précision des tâches de plus de 50 %, même avec le même modèle de base.
Donc, première étape : concevez la récupération comme un composant produit avec ses propres métriques d’évaluation, ses SLO et son budget.
Checklist de récupération d'abord
Avant de plonger dans des techniques RAG spécifiques, alignez-vous sur trois questions. Elles paraissent simples. Elles ne le sont pas.
- Que signifie une « bonne » réponse pour ce cas d’utilisation — rapidité, précision, couverture ou explicabilité ?
- Quel est le coût d’une réponse erronée par rapport à une « absence de réponse » ?
- À quelle fréquence votre base de connaissances change-t-elle, et qui est responsable de sa qualité ?
Une fois que cela est clair, vous pouvez concevoir des flux de travail RAG au lieu de démonstrations aléatoires.
- Séparez les métriques de récupération et de génération. Suivez la précision de la récupération (par exemple, rappel@k, précision@k) indépendamment de la qualité de la réponse (par exemple, ancrage, complétude).
- Concevez des SLO de récupération. Par exemple, « latence de récupération p95 inférieure à 300 ms, rappel@5 p95 supérieur à 0,8 pour les intentions client principales ».
- Prévoyez un budget pour les expériences de récupération. Réservez du temps pour itérer sur les paramètres de recherche sémantique, les modèles d’embedding et le classement, pas seulement sur les modèles de prompt.
Principe n°2 : Le découpage et l'indexation déterminent si le RAG aide ou nuit
Les gens aiment parler de modèles. Aujourd’hui, la plupart des gains de performance en RAG proviennent toujours d’un travail fastidieux sur le découpage, l’indexation et les modèles d’embedding. Pensez-y comme à la modélisation de données pour votre architecture RAG.
Un mauvais découpage entraîne deux modes d’échec : un contexte trop limité pour répondre à quoi que ce soit, ou de longs blocs qui diluent la pertinence et gonflent les fenêtres de contexte.
Stratégies de découpage qui ne sont pas nulles
Voici où les stratégies de découpage de documents passent de la théorie à la pratique.
Documentation API & références de configuration
Segments sensibles à la structure par titre/point de terminaison/clé de configuration.
Portails développeurs, documentation d’intégration.
Documents juridiques & politiques
Segments de paragraphes avec chevauchement au niveau des phrases pour le contexte.
Contrats, conditions d’utilisation, politiques de conformité.
Rapports longs/guides stratégiques
Fragments hiérarchiques : sections → paragraphes, plus un embedding de « résumé » par section.
Manuels, rapports d’incidents.
FAQ et historique des tickets
Fragments courts Q&R par intention, avec des résumés synthétiques si nécessaire.
Assistants de support, helpdesk interne.
Vous pouvez utiliser le tableau ci-dessous pour esquisser votre implémentation RAG avec votre équipe.Trois règles pratiques lors de la conception de l’indexation pour RAG :
- Alignez la taille des fragments sur la granularité des requêtes. Si les utilisateurs demandent « l’étape 3 de la liste de contrôle d’intégration », vous avez besoin de fragments RAG au niveau des éléments de la liste de contrôle, pas de PDF de 4 pages.
- Utilisez le chevauchement délibérément, pas par défaut. Commencez avec un chevauchement de 10 à 20 % de jetons pour le contenu narratif ; désactivez le chevauchement pour les structures rigides comme les schémas de points de terminaison d’API.
- Créez plusieurs index si nécessaire. Des index distincts (ou des collections dans vos bases de données vectorielles) pour les politiques, les FAQ, la documentation technique et les journaux sont souvent plus performants qu’un seul index géant.
Principe n°3 : Choisissez vos bases de données vectorielles comme vous choisissez un cofondateur
Votre pile de récupération LLM vit ou meurt à cause de la base de données derrière votre recherche sémantique. Aujourd’hui, les bases de données vectorielles ne sont pas juste des « recherches sophistiquées » ; ce sont des infrastructures qui définissent les courbes de latence, de rappel et de coût pour votre implémentation RAG.
Les équipes qui traitent ce choix comme une réflexion après coup se retrouvent avec des factures cloud surprises et des pics de latence mystérieux au moment où le trafic augmente.
Ce qui compte dans les bases de données vectorielles pour RAG
Il existe des dizaines de benchmarks. Pour des pratiques RAG concrètes, concentrez-vous sur ce qui affecte réellement votre produit.
- Stratégie d’indexation, pas de nom de marque. HNSW, IVF, PQ — ceux-ci décident comment votre recherche sémantique négocie la précision par rapport à la vitesse.
- Support du filtrage et des métadonnées. Des filtres de métadonnées fiables (locataire, langue, version) sont non négociables pour les flux RAG multi-locataires.
- Recherche hybride. Combiner la recherche lexicale (BM25) avec des vecteurs denses peut améliorer considérablement la précision de la récupération pour les requêtes courtes ou ambiguës.
Un guide sur les bases de données vectorielles de 2025 montre que les équipes qui mélangent recherche par mots-clés et recherche vectorielle constatent souvent des gains à deux chiffres en pertinence sans sacrifier la latence. C’est un fruit facile à cueillir que la plupart des équipes ignorent encore.
Principe n°4 : L'ingénierie des requêtes surpasse la manipulation des prompts
Chacun a son modèle de prompt préféré. Moins d’équipes conçoivent des pipelines de requêtes robustes. Pourtant, les articles récents sur RAG continuent de montrer qu’un traitement intelligent des requêtes peut surpasser les grands modèles sur les mêmes données.
Considérez ceci comme la « porte d’entrée » de votre architecture RAG : vous ne pouvez pas corriger une question mal formulée plus tard dans le pipeline.
Mouvements de traitement des requêtes qui fonctionnent vraiment
Avant de montrer une liste, voici l’état d’esprit : traitez chaque requête utilisateur comme une matière première. Vous la normalisez, l’étendez et la rejetez parfois avant de toucher la base de connaissances.
- Réécriture et expansion des requêtes. Utilisez le LLM pour reformuler les questions vagues en requêtes de recherche structurées avec des entités et des contraintes explicites.
- Classification des intentions. Dirigez les « problèmes de facturation » vers un index et les « analyses techniques approfondies » vers un autre pour réduire le bruit de récupération.
- Tours de clarification. Pour les cas d’utilisation à haut risque (finance, santé), posez une question de suivi si la requête est ambiguë au lieu de deviner avec confiance.
En plus de cela, l’ancrage des prompts est important : précédez les extraits récupérés d’instructions explicites comme « Répondez uniquement en utilisant le contexte ci-dessous. Si la réponse n’est pas présente, dites que vous ne savez pas. » pour que les grands modèles linguistiques restent honnêtes.
Principe n°5 : Évaluez comme un chef de produit, pas comme un chercheur
Si votre implémentation RAG est livrée sans une vision claire des métriques d’évaluation, vous naviguez à l’aveugle. En 2026, il n’y a plus d’excuse — l’écosystème autour de l’évaluation RAG a beaucoup mûri.
Une méta-analyse des cadres d’évaluation RAG met en évidence un schéma : les équipes qui évaluent la récupération et la génération ensemble, avec des métriques au niveau de la tâche, détectent les échecs plus tôt et itèrent plus rapidement.
Pile d'évaluation minimale mais sérieuse
Cette partie est facile à compliquer. Gardez-la légère et liée aux résultats commerciaux.
- Métrique de niveau de récupération
- rappel@k et précision@k sur un ensemble de requêtes étiquetées.
- couverture du corpus (quelle fraction des politiques/flux clés est accessible via la recherche).
- Métrique de niveau de génération
- ancrage (chaque affirmation est-elle étayée par le contexte récupéré).
- complétude (la réponse couvre-t-elle toutes les contraintes de l’utilisateur).
- Métrique de niveau de tâche
- taux de déviation des tickets, temps de traitement moyen, ou temps jusqu’à la première ébauche pour les outils internes.
Les évaluateurs RAG de Microsoft en 2025, par exemple, séparent la récupération, l’ancrage et la qualité de la réponse, et s’appuient sur des juges basés sur LLM lorsque la vérité terrain est coûteuse. Ce schéma s’adapte bien à la plupart des configurations de production.
Principe n°6 : Concevoir pour les données en temps réel sans tout casser
Vous voulez probablement RAG parce que votre domaine change rapidement — prix, politiques, notes de version, réglementations. La tentation est de connecter RAG directement aux API en direct et de considérer que c’est terminé. C’est ainsi que vous obtenez des systèmes fragiles et des incidents nocturnes.
La recherche et les études de cas en 2025 poussent une approche différente : conception de base de connaissances en couches avec des politiques de fraîcheur claires. Au lieu de tout déverser dans un seul index, vous architecturez les flux RAG autour de la manière dont votre domaine évolue, des équipes qui possèdent les données et des risques associés aux réponses erronées. Pour de nombreuses équipes, cette réflexion commence plus tôt, au stade de la découverte : cartographie des cas d’utilisation, faisabilité et retour sur investissement de l’implémentation RAG dans le cadre d’un développement d’IA plus large plutôt que d’expérimenter dans des POC isolés.
Une base de connaissances en couches simple
Avant les puces, imaginez ceci : au lieu d’un seul index géant, vous maintenez une couche de connaissances « de base » plus une ou plusieurs couches de données en temps réel avec différents SLA.
- Couche statique de base. Documents versionnés, manuels, SLA et textes juridiques. Mis à jour par des mises en production contrôlées, fortement testés.
- Couche de mises à jour fréquentes. Journaux de modifications, notes de version, règles de tarification dynamiques ; mis à jour selon un calendrier, surveillés pour la dérive de l’index.
- Couche en direct à la demande. Pour les données très volatiles (par exemple, solde actuel, statut de l’expédition), RAG récupère le contexte structurel, puis appelle les API au moment de la réponse.
Cette structure maintient votre architecture RAG évolutive tout en donnant aux parties prenantes des réponses claires à « d’où vient cette réponse ? » et « quelle est sa fraîcheur ? ».
Principe n°7 : Les garde-fous font partie de RAG, pas une réflexion après coup
Lorsque RAG échoue, cela échoue généralement de manière spectaculaire. Mauvaises indications médicales, réponses financières non conformes, fuites de données internes dans les discussions publiques — les horreurs habituelles.
Les pratiques RAG modernes traitent la gouvernance et la sécurité comme intégrées dans le pipeline, pas comme quelques vérifications regex après la génération.
Garde-fous qui fonctionnent réellement en production
Pensez moins à la « sécurité de l’IA » générique et davantage à des contrôles concrets et exécutoires à chaque étape de votre flux de travail RAG.
- Filtrage des entrées. Détectez et bloquez les requêtes demandant des données hors périmètre (par ex., informations d’autres locataires) avant la récupération.
- Liste blanche des sources. Indexez uniquement les collections de documents validées ; refusez l’indexation directe à partir d’URL aléatoires ou de réponses par e-mail.
- Validation post-génération. Utilisez des moteurs de règles ou des vérifications LLM secondaires pour détecter les affirmations non fondées, les avertissements manquants ou les sujets restreints.
Une enquête de l’année dernière sur les cadres d’évaluation de la génération augmentée par récupération note que de nombreux échecs se manifestent comme des violations de politique plutôt que comme de purs problèmes d’exactitude. Les garde-fous sont votre seul moyen réaliste de les détecter à grande échelle.
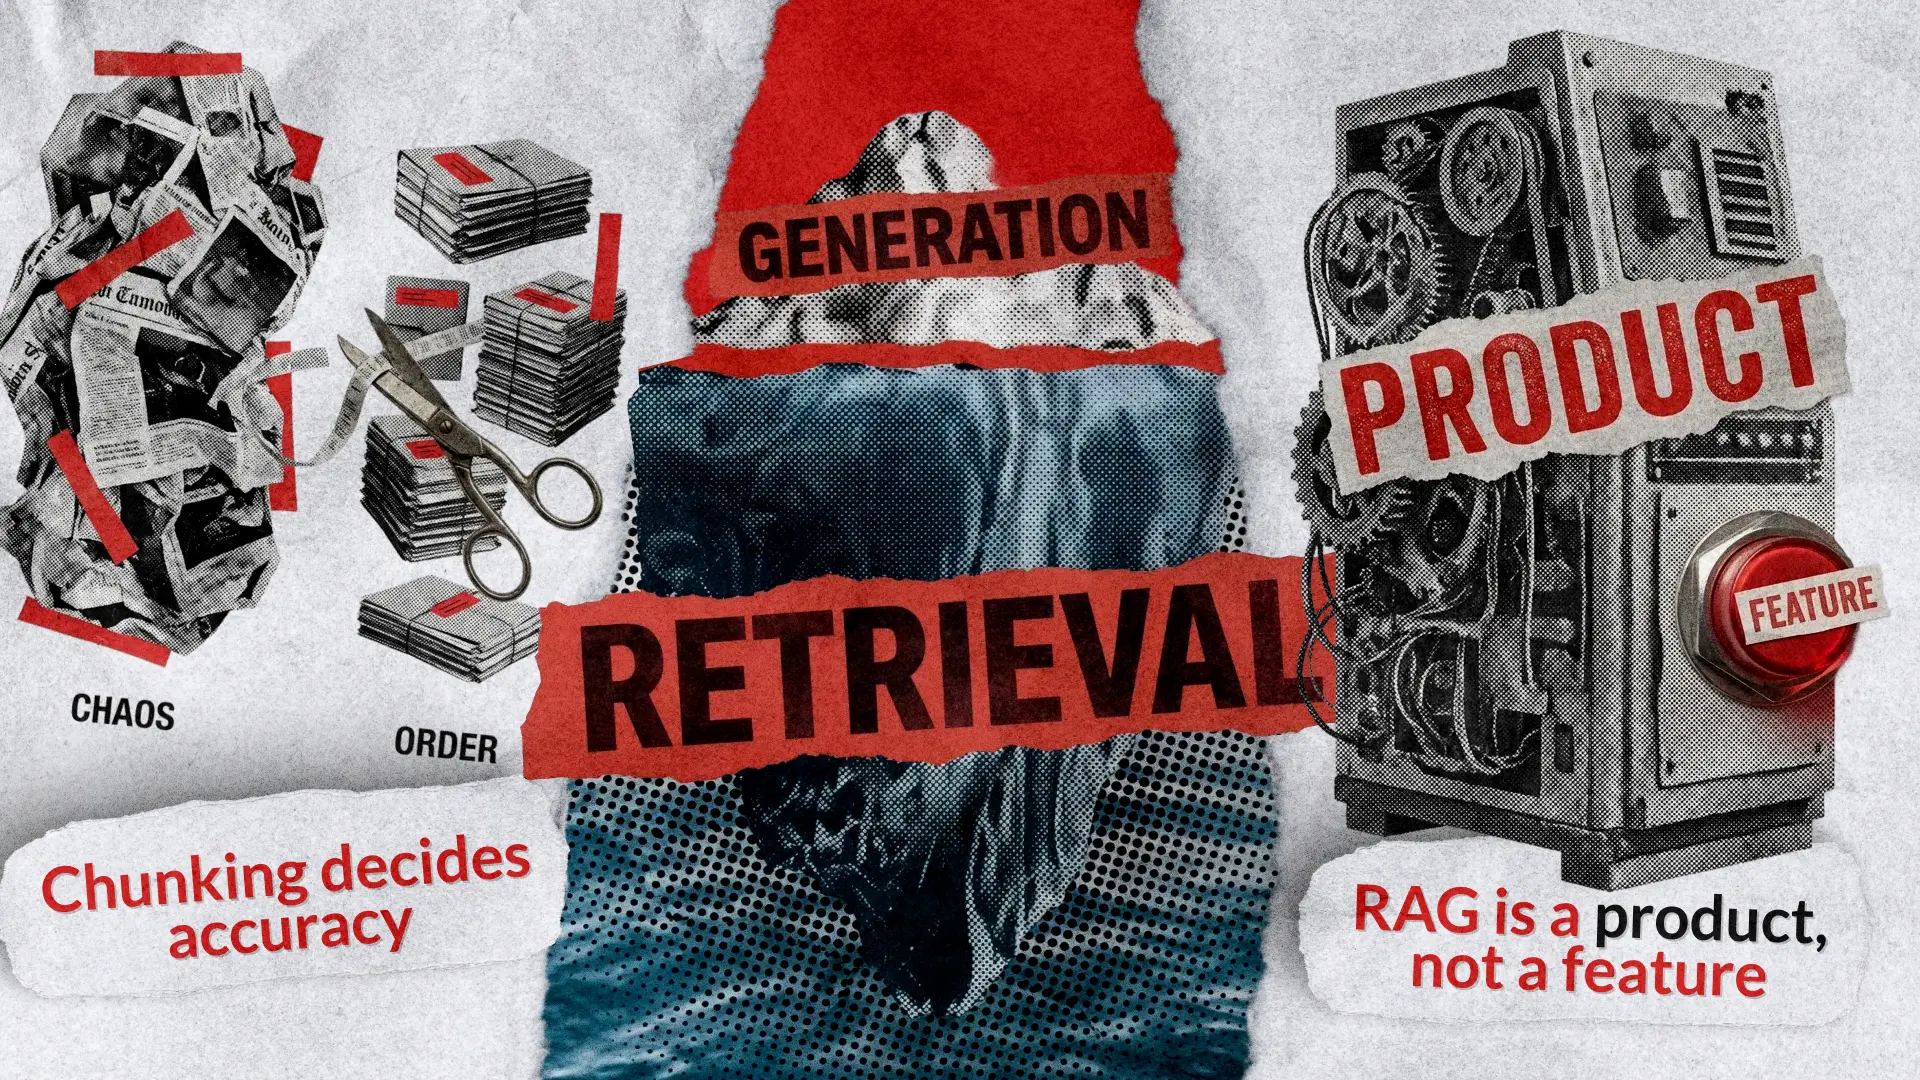
Principe n°8 : Construire le RAG comme un produit, pas comme une fonctionnalité
À ce stade, vous avez probablement compris le schéma : le RAG ne consiste pas simplement à « ajouter la récupération », mais à « repenser la manière dont votre produit utilise le texte et les connaissances ». Ce changement de mentalité distingue les entreprises qui ont une démo intéressante de celles qui mettent à l’échelle des modèles d’IA pour en faire des actifs commerciaux durables et à fort effet de levier.
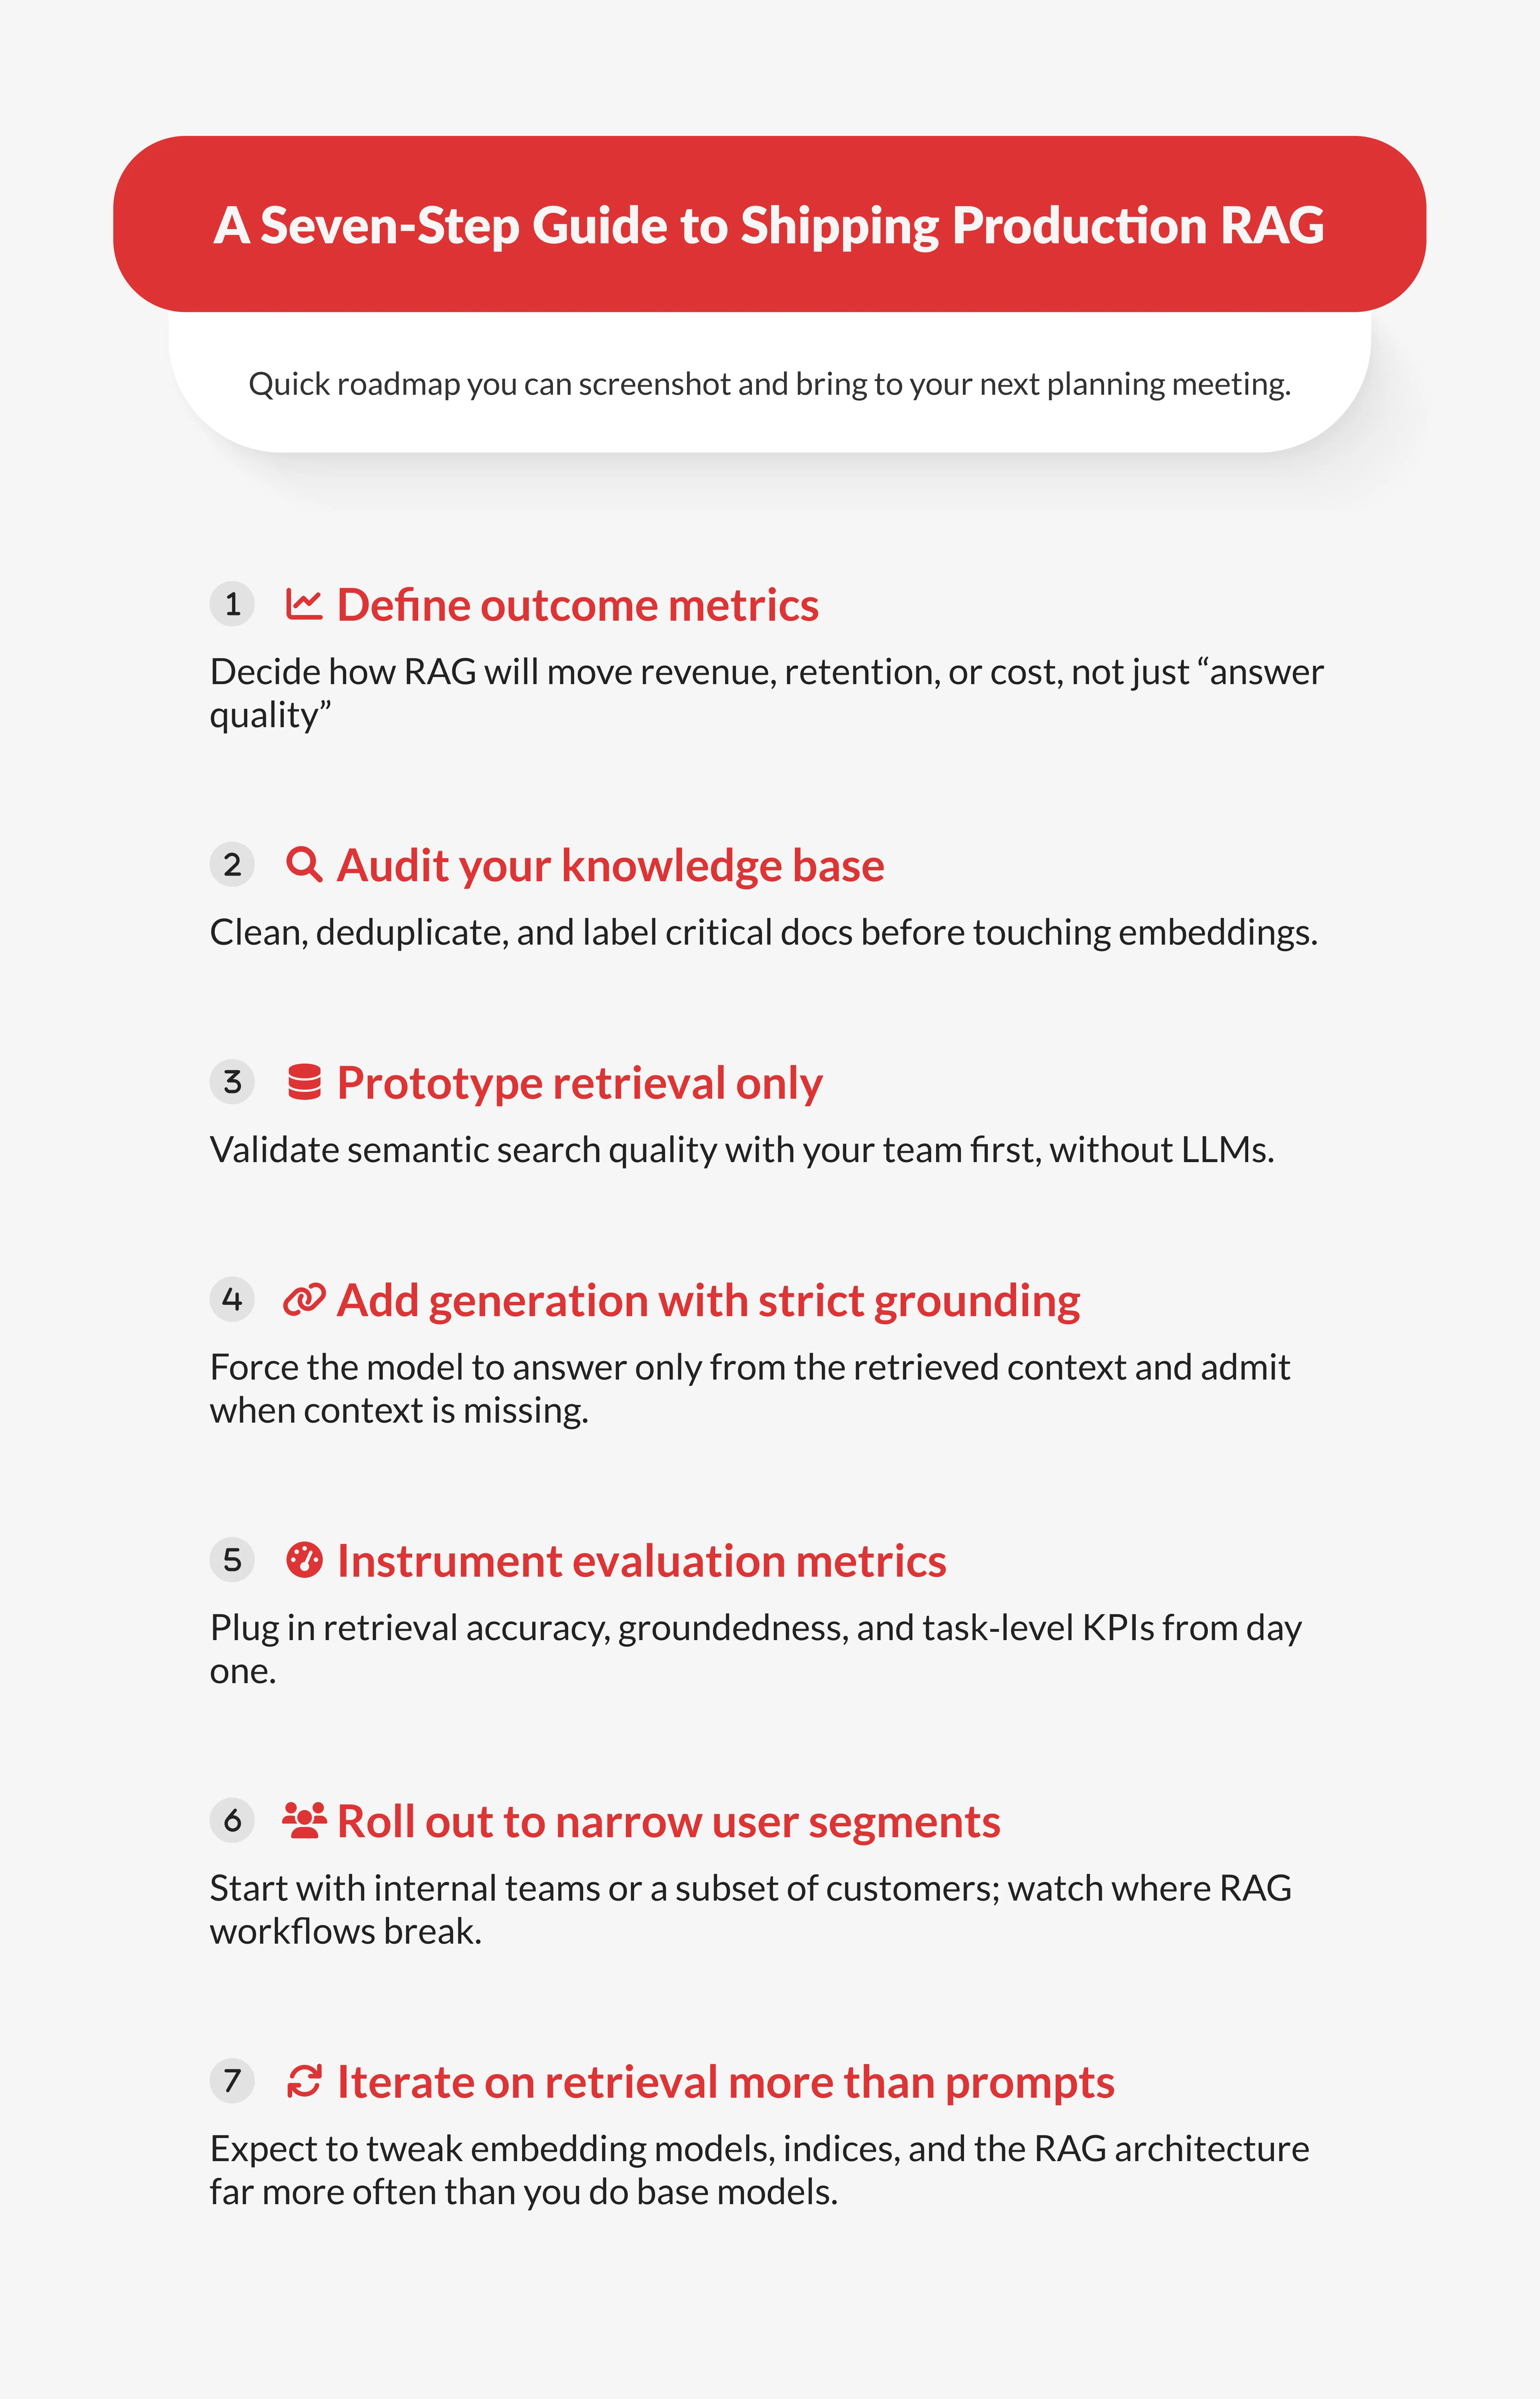
Une façon pratique de maintenir l’intégrité de votre implémentation RAG est de la traiter comme toute autre initiative produit : feuilles de route, propriétaires, KPI et déploiement progressif.
Conclusion sur les meilleures pratiques RAG sans le superflu
S’il y a une chose à retenir de toutes les meilleures pratiques de génération augmentée par récupération ci-dessus, c’est celle-ci : la plupart des équipes n’échouent pas parce que le RAG est trop complexe. Elles peuvent échouer parce qu’elles le traitent comme un raccourci. Les équipes qui réussissent traitent l’architecture RAG, la récupération LLM, les métriques d’évaluation et la gouvernance des données comme des décisions produit, et non comme des paramètres de bac à sable.
Ainsi, lorsque vous planifiez votre prochaine implémentation RAG, ne commencez pas par « Quel modèle devrions-nous utiliser ? ». Il est préférable de commencer par « Pour quelles décisions le système doit-il aider, et quelle base de connaissances et quel flux de travail lui faut-il pour y parvenir ? ». Un découpage serré, des bases de données vectorielles bien choisies, une recherche sémantique solide et une mesure honnête ne seront peut-être pas très « sexy » dans une présentation, mais ce sont exactement ces éléments qui donnent à vos grands modèles de langage l’impression d’un avantage déloyal plutôt que d’une expérience coûteuse. Vous n’avez pas à résoudre les obstacles techniques par vous-même : contactez-nous et contactez-nous si vous souhaitez des conseils avisés pour votre projet RAG.
Découvrez comment nous avons aidé Evolv à lancer sa plateforme d'optimisation basée sur l'IA, à accélérer l'expérimentation UX et à déployer de nouvelles fonctionnalités plus rapidement.