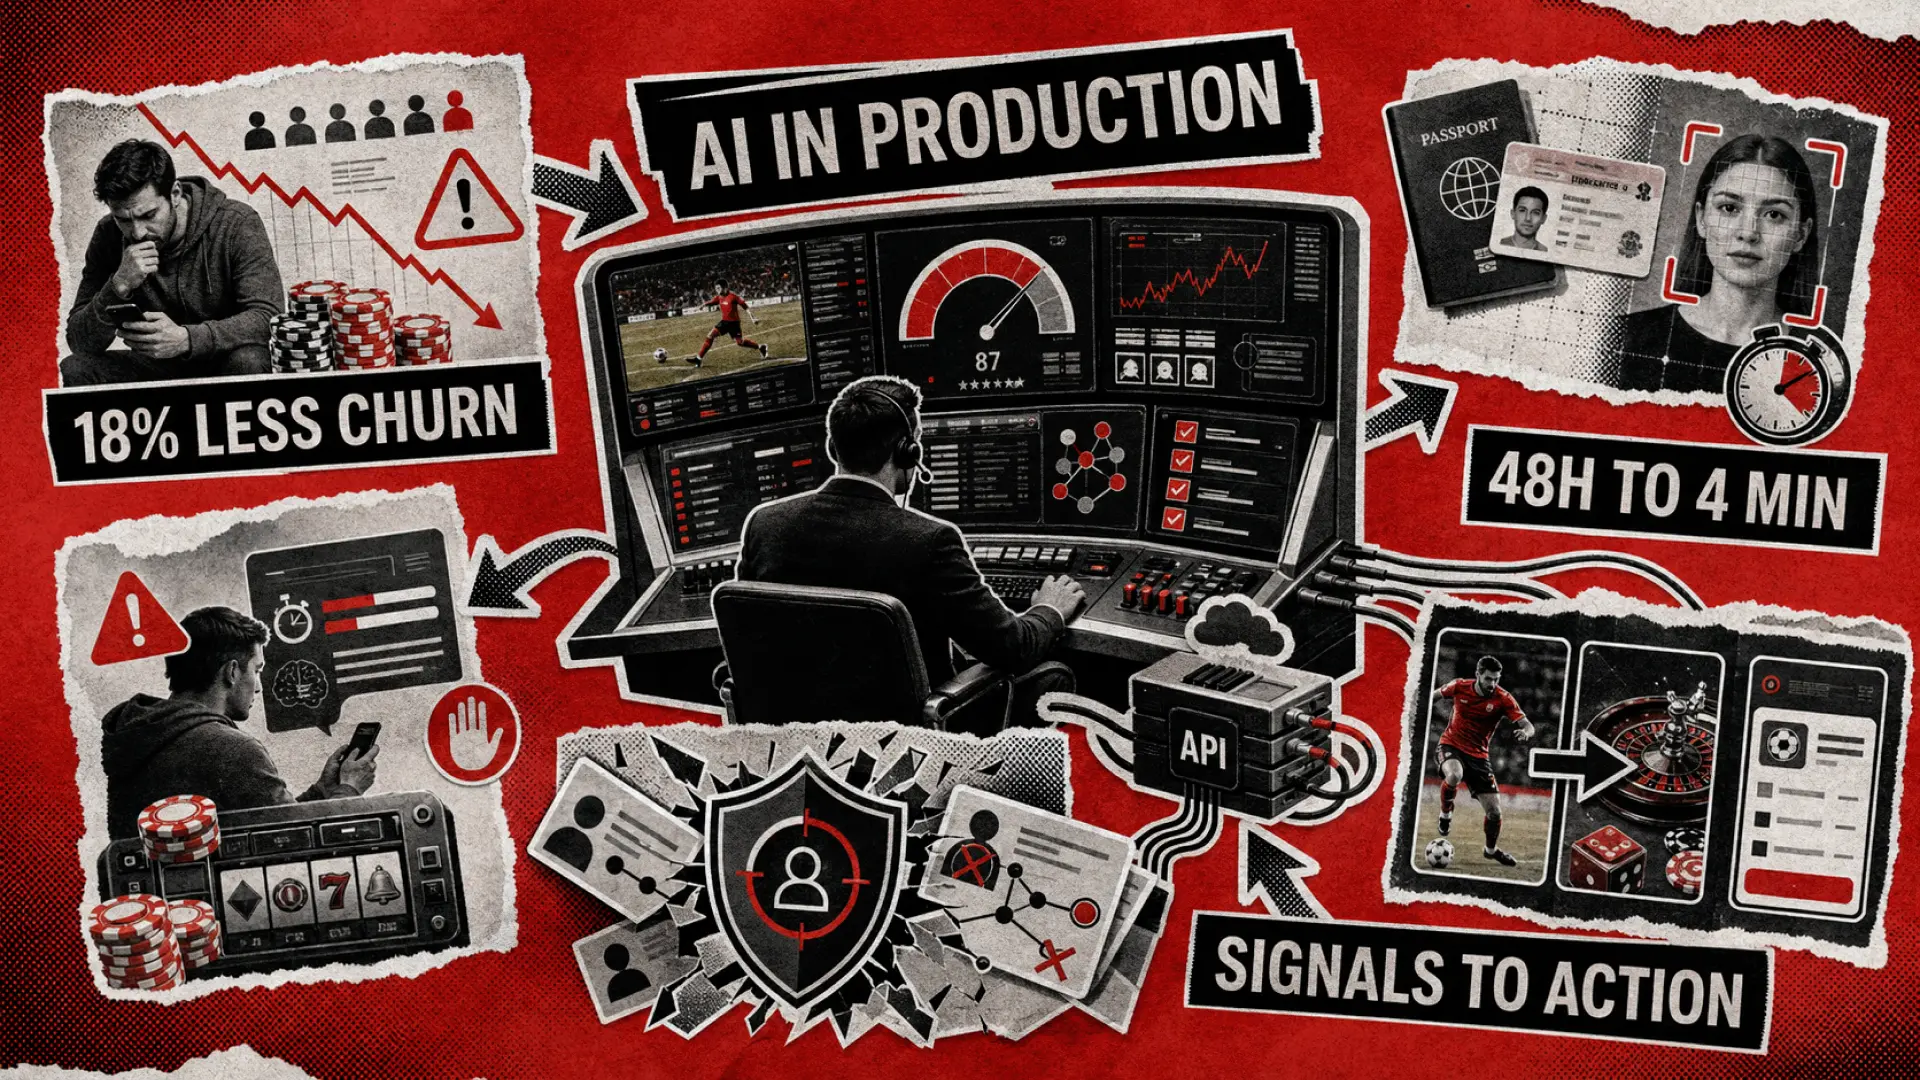
Vous avez vu les présentations des fournisseurs, vous savez donc ce que l’IA pourrait faire dans l’iGaming. La vraie question est : qu’est-ce qui est réellement en production et comment le mettre en œuvre avec une efficacité maximale dans la vie réelle ? Dans ces cinq cas d’utilisation, nous laissons de côté le potentiel pour aller directement à la production, montrant que les opérateurs qui ont construit le système ont les chiffres pour le prouver.
Le développement de l’IA est un vaste domaine, mais toutes les formes d’automatisation ne sont pas également efficaces ou précieuses à long terme. Pour construire une stratégie qui apporte des avantages immédiats, tels que l’attraction de plus de joueurs, vous devez non seulement comprendre les avantages et les utilisations générales de l’IA, mais aussi voir exactement comment elle peut être appliquée au bénéfice des pratiques de l’iGaming. De l’utilisation de modèles d’apprentissage automatique à la construction de pipelines de données spécialisés et au développement de systèmes dynamiques anti-fraude, l’IA a un immense potentiel. Continuez à lire pour voir comment vous pouvez l’utiliser au mieux pour contrer les défis quotidiens de l’iGaming.
L'IA dans l'iGaming : 5 cas d'utilisation en production à la loupe
Aujourd’hui, nous ne parlerons pas d’abstractions et de banalités générales sur ce que l’IA peut faire pour les entreprises. Nous nous concentrerons sur des cas d’utilisation déjà mis en œuvre par les principaux opérateurs d’iGaming et analyserons la valeur qu’ils apportent sur la base de données existantes, y compris des recherches spécialisées en IA et ML. Comprendre comment la technologie résout les problèmes auxquels cette industrie est confrontée quotidiennement devrait vous aider à guider votre stratégie de mise en œuvre de l’IA, qui transformera progressivement votre entreprise et la rendra plus compétitive.
Prédiction du taux d’attrition en temps réel
Les joueurs partent avant que vous ne puissiez réagir
Micro-modèles comportementaux
Réduction de 15 à 20 % de l’attrition sur 30 jours
API CRM + magasin de fonctionnalités ML
KYC assisté par IA
La friction de vérification nuit à la conversion des retraits
Données de document + d’identité
Vérification de 48h → moins de 4 min
Intergiciel de conformité
Déclencheurs de jeu responsable
Jeu problématique détecté après le dommage
Signaux d’anomalie de session
Intervention avant l’auto-exclusion
Flux d’événements + couche de scoring
Détection de fraude par IA
Les systèmes basés sur des règles sont prévisibles et exploitables
Graphique transactionnel + comportemental
Réduction significative de l’attrition par rapport aux règles statiques
Moteur de décision hybride règles + ML
Recommandations personnalisées
Les joueurs voient du contenu non pertinent, se désengagent
Données comportementales en session
Profondeur de session plus élevée, conversion plus rapide du bulletin de paris
API de recommandation au niveau du lobby
1. Prédiction d'attrition en temps réel : 18 % d'attrition en moins en 30 jours
Les métriques standard d’attrition, telles que l’absence de connexion pendant 7 jours et une fréquence de dépôt plus faible, sont des indicateurs retardés. Au moment où elles se déclenchent, le joueur a déjà décidé de partir. L’approche basée sur l’apprentissage automatique (ML) surveille les signaux qui précèdent cette décision :
- Sessions de plus en plus courtes sur 5 visites consécutives ou plus
- Les heures de connexion se décalent des heures de pointe vers la fin de la nuit
- Aucune réponse à deux notifications push ou plus d’affilée
- Les paris diminuent même lorsque le joueur est toujours actif
Ces schémas apparaissent 7 à 14 jours avant que toute métrique traditionnelle ne signale le compte. Une société de paris sportifs a entraîné un modèle sur 18 mois de données comportementales, l’a connecté à son système de gestion de la relation client (CRM) et a constaté une réduction de 18 % de l’attrition sur 30 jours. Ceci est réalisé en contactant les joueurs plus tôt avec le bon message avant qu’ils ne se désengagent mentalement.
L’argument en faveur d’une action précoce est solide : acquérir un nouveau joueur coûte 6 à 7 fois plus cher que de fidéliser un joueur existant. Une étude évaluée par des pairs dans Applied Sciences (MDPI) a confirmé que les classificateurs ML construits sur des données d’événements de joueurs atteignaient une précision de prédiction avec une AUC (aire sous la courbe) supérieure à 0,92 sur de véritables ensembles de données de jeux, suffisamment fiable pour agir.
En termes simples, vous avez besoin de :
- Un flux d’événements de joueurs provenant de votre plateforme (chaque connexion, pari, session et dépôt)
- Un système qui traite ces événements en temps réel, pas du jour au lendemain
- Un modèle qui évalue le risque d’attrition de chaque joueur et se met à jour en continu
- Une connexion à votre système CRM afin que la bonne intervention se déclenche au bon moment
Le modèle lui-même n’est pas la partie difficile, l’astuce consiste à construire un pipeline de données qui le maintient alimenté en signaux frais et précis.
2. KYC assisté par l'IA : De files d'attente de 48 heures à une vérification en 4 minutes
Un joueur dépose de l’argent, joue, puis tente un retrait pour la première fois. Il se retrouve bloqué dans une file d’attente de vérification de documents de 48 heures. C’est là que la friction cause le plus de tort, et le joueur ne revient pas.
Les opérateurs qui ont résolu ce problème ne considèrent pas le KYC (vérification « Know Your Customer ») comme un coût de conformité. Ils le traitent comme une couche de conversion. Avec un pipeline assisté par IA, les vérifications standard sont terminées en moins de 4 minutes. Voici à quoi ressemble le flux automatisé :
- Le joueur télécharge son document d’identité (ID)
- La vision par ordinateur recherche toute falsification ou contrefaçon
- Un contrôle de vivacité faciale compare son visage à la photo du document
- Le système vérifie le nom par rapport aux listes de surveillance mondiales de lutte contre le blanchiment d’argent (AML)
- Un score de risque est généré et une décision est prise automatiquement
Les cas clairs n’atteignent jamais un examinateur humain. Les cas limites, tels que les formats de noms non concordants ou les documents provenant de régions à risque plus élevé, sont escaladés avec un résumé des risques pré-rempli, et non un tas de fichiers bruts.
La pression pour une mise à niveau est réelle, car les sanctions réglementaires mondiales liées au KYC ont atteint 1,23 milliard de dollars au premier semestre 2025, soit une augmentation de 417 % d’une année sur l’autre. Selon le rapport 2025–2026 sur la fraude à l’identité de Sumsub, une fraude sur cinq commise par le titulaire du compte implique désormais une identité synthétique, une personne fictive constituée d’un mélange de données réelles et fabriquées qui trompe facilement les vérifications de documents statiques.
La vérification augmentée par IA détecte ce que les documents seuls ne peuvent pas. Pendant ce temps, les recherches de Sumsub sur l’iGaming montrent un schéma cohérent : les fraudeurs s’inscrivent entre 4h et 8h du matin, tandis que les joueurs légitimes s’inscrivent entre 16h et 18h. Ce signal comportemental est invisible pour une file d’attente de documents, mais immédiatement détectable lorsque vous implémentez l’IA dans la gestion des pipelines d’iGaming.
3. IA pour le jeu responsable : Détecter le jeu problématique avant l'auto-exclusion
Les limites de dépôt et les liens d’auto-exclusion sont la norme, mais ils sont aussi réactifs et s’activent après qu’un joueur sait déjà qu’il a un problème. Les opérateurs qui prennent de l’avance utilisent des modèles qui signalent les signes avant-coureurs avant ce point.
L’utilisation de l’IA dans l’iGaming vous permet d’entraîner un modèle qui ne repose pas sur un déclencheur unique. Il recherche un schéma de changements qui, ensemble, produisent un score de risque :
- Sessions plus longues que la base de référence habituelle du joueur, surtout tard dans la nuit
- Redépôts effectués quelques minutes après une grosse perte
- Les tailles de paris augmentent de manière erratique au-delà de la plage normale du joueur
- Atteinte constante d’une limite hebdomadaire auto-définie pendant trois semaines ou plus d’affilée
- Passage d’un jeu varié à la répétition d’un seul produit à haute intensité
Lorsque suffisamment de signaux s’alignent, le système déclenche une intervention précoce, par exemple, l’envoi d’un message d’assistance, une incitation à limiter les dépôts ou une invite de pause, avant que le joueur n’atteigne une crise.
Une étude d’apprentissage automatique sur les données comportementales de l’iGaming, citée par la communauté de recherche sur le jeu responsable, a révélé que les modèles ML atteignaient une précision moyenne de 84,2 % dans l’identification des schémas de jeu nuisibles. La même recherche a révélé qu’un modèle AML (lutte contre le blanchiment d’argent) en apprentissage actif a amélioré la détection de 50 %, réduit les coûts de moitié et a continué à s’améliorer, doublant sa précision en environ 10 jours en apprenant de nouvelles données.
La UK Gambling Commission (UKGC), la Malta Gaming Authority (MGA) et les marchés réglementés émergents évoluent vers l’exigence d’une prévention démontrable des préjudices, et pas seulement de la disponibilité de l’auto-exclusion. Les opérateurs qui construisent cela maintenant ne se contentent pas de maintenir la conformité, mais prennent de l’avance sur la prochaine vague d’exigences. Et l’infrastructure qu’ils construisent ici est la même que celle qui alimente la prédiction d’attrition et la détection de fraude : une fondation, de multiples cas d’utilisation.
4. Détection de fraude par IA dans l'iGaming : Pourquoi les règles statiques perdent du terrain
Les systèmes de fraude basés sur des règles fonctionnent comme suit : définir à quoi ressemble la fraude, écrire des règles pour la détecter et signaler les correspondances. Cependant, il y a un problème majeur, car les réseaux de fraude comprennent les règles et les contournent. Les réseaux d’abus de bonus, les schémas de comptes multiples et les opérations de blanchiment d’argent s’adaptent tous aux seuils connus. Par conséquent, un système anti-fraude statique est intrinsèquement exploitable.
La solution de l’IA dans l’iGaming est la détection de fraude basée sur le ML. Au lieu de faire correspondre une liste fixe de modèles suspects, les modèles apprennent à quoi ressemble le comportement légitime d’un joueur, puis signalent tout ce qui s’en écarte. Les nouvelles tactiques de fraude sont détectées non pas parce que quelqu’un a écrit une règle pour elles, mais parce qu’elles semblent erronées.
Les implémentations les plus solides ne confient pas tout au modèle, mais utilisent les approches suivantes pour assurer une défense maximale :
- Règles pour les schémas connus et certains
- Modèles ML pour détecter les comportements nouveaux et évolutifs
- Évaluateurs humains pour les cas véritablement ambigus
- Une boucle de rétroaction où les décisions de l’évaluateur alimentent le réentraînement du modèle
Le résultat est que les systèmes de fraude IA ont empêché des pertes mondiales estimées à 25,5 milliards de dollars en 2025, atteignant une précision de détection de 90 à 98 %. Les évaluateurs humains, en comparaison, identifient correctement les deepfakes de haute qualité seulement 24,5 % du temps.
5. Personnalisation par IA dans l'iGaming : Le moteur de recommandation qui amène plus rapidement les joueurs de la page d'accueil au bulletin de paris
Lorsqu’il s’agit d’utiliser l’IA dans l’iGaming pour la personnalisation, considérez-la moins comme Netflix et plus comme un hall d’entrée qui connaît le joueur. Lorsqu’une personne se connecte, les jeux, les événements et les types de paris qu’elle voit ne sont plus les mêmes que pour les autres. La plateforme met en avant ce qui est le plus pertinent pour cette personne, en fonction de son historique et de son comportement lors de la session en cours.
Pour les paris sportifs, cela signifie afficher les bons événements, marchés et tailles de mises en premier. Pour les plateformes de jeux, cela signifie organiser le hall d’entrée autour de ce qu’un joueur joue réellement, et non de ce qui génère la marge agrégée la plus élevée.
Deux modèles gèrent cela en pratique :
- Pour les joueurs récurrents : un modèle personnalisé entraîné sur leur historique de paris, leurs sports ou types de jeux préférés, et leur réponse passée aux offres. Il s’adapte au comportement récent, et pas seulement aux moyennes historiques.
- Pour les nouveaux joueurs : une approche de filtrage collaboratif qui regroupe les joueurs par modèles de session précoces et met en avant ce avec quoi des joueurs similaires se sont engagés, afin qu’il n’y ait pas de problème de « démarrage à froid » (cold-start problem).
Une recherche issue d’un déploiement en production chez NetEase Games a montré des améliorations significatives de l’engagement et de la précision marketing lorsque des modèles comportementaux individuels ont remplacé un ciblage par segments larges. DraftKings a publiquement adopté la personnalisation des messages basée sur l’IA générative (GenAI) pour la même raison : cela convertit mieux.
La couche de recommandation n’est pas une refonte de la plateforme, mais une interface de programmation d’applications (API) qui se situe entre votre magasin de données et votre système de gestion de contenu (CMS) de hall d’entrée, réorganisant le contenu au début de la session. Nos services de développement d’API couvrent ce domaine de bout en bout, y compris les éléments d’IA dans la formation des modèles, l’intégration et l’optimisation continue.
Ce que tous les 5 cas d'utilisation de l'IA dans l'iGaming ont en commun
En dépouillant chacun de ces cas d’utilisation, vous trouvez la même chose : le comportement du joueur génère des signaux, un modèle transforme ces signaux en un score, et ce score déclenche une action de l’opérateur, telle que l’envoi d’un message de rétention, la prise d’une décision de vérification ou l’initiation d’un blocage pour fraude.
Le modèle est rarement la partie difficile. Ce qui sépare les opérateurs qui implémentent cela de ceux qui ne le font pas, c’est l’infrastructure qui l’entoure :
- Un pipeline d’événements fiable et en temps réel
- Un magasin de caractéristiques (feature store) qui maintient les entrées du modèle à jour
- Des politiques claires mappant la sortie du modèle à l’action de la plateforme
- Des boucles de rétroaction pour que le modèle continue de s’améliorer au fil du temps
La bonne question en 2025 n’est pas « devrions-nous utiliser l’IA ? », mais : Avons-nous la base de données nécessaire pour la faire fonctionner correctement ? C’est là que la plupart des développements réussissent ou échouent.
Redwerk développe des logiciels pour les produits numériques dans les industries réglementées depuis 2005, y compris des services d’IA et d’apprentissage automatique, des pipelines de données de qualité production, et les couches qui connectent la sortie du modèle à l’action de l’opérateur. Vous avez l’un de ces éléments dans votre feuille de route ? Contactez-nous et donnons-leur vie !
Découvrez l'application de recrutement alimentée par l'IA que nous avons construite et qui a été rachetée par un géant américain du recrutement