Vous avez piloté GPT-5 sur une tâche interne étroite. La démo s’est bien passée. Puis les chiffres sont arrivés. La tarification par appel évolue contre vous, la conformité refuse d’approuver les données quittant le VPC, et la précision sur votre jargon plafonne quelque part entre « prometteur » et « prêt pour la production ».
Vous n’êtes pas seul. Le rapport de Gartner sur les tendances technologiques stratégiques de 2026 désigne les modèles de langage spécifiques au domaine comme une priorité absolue pour les entreprises, précisément parce que les grands modèles de langage génériques sont souvent insuffisants pour les tâches spécialisées, tandis que les modèles de langage spécifiques au domaine offrent une précision, une fiabilité et une conformité supérieures pour les besoins métiers ciblés.
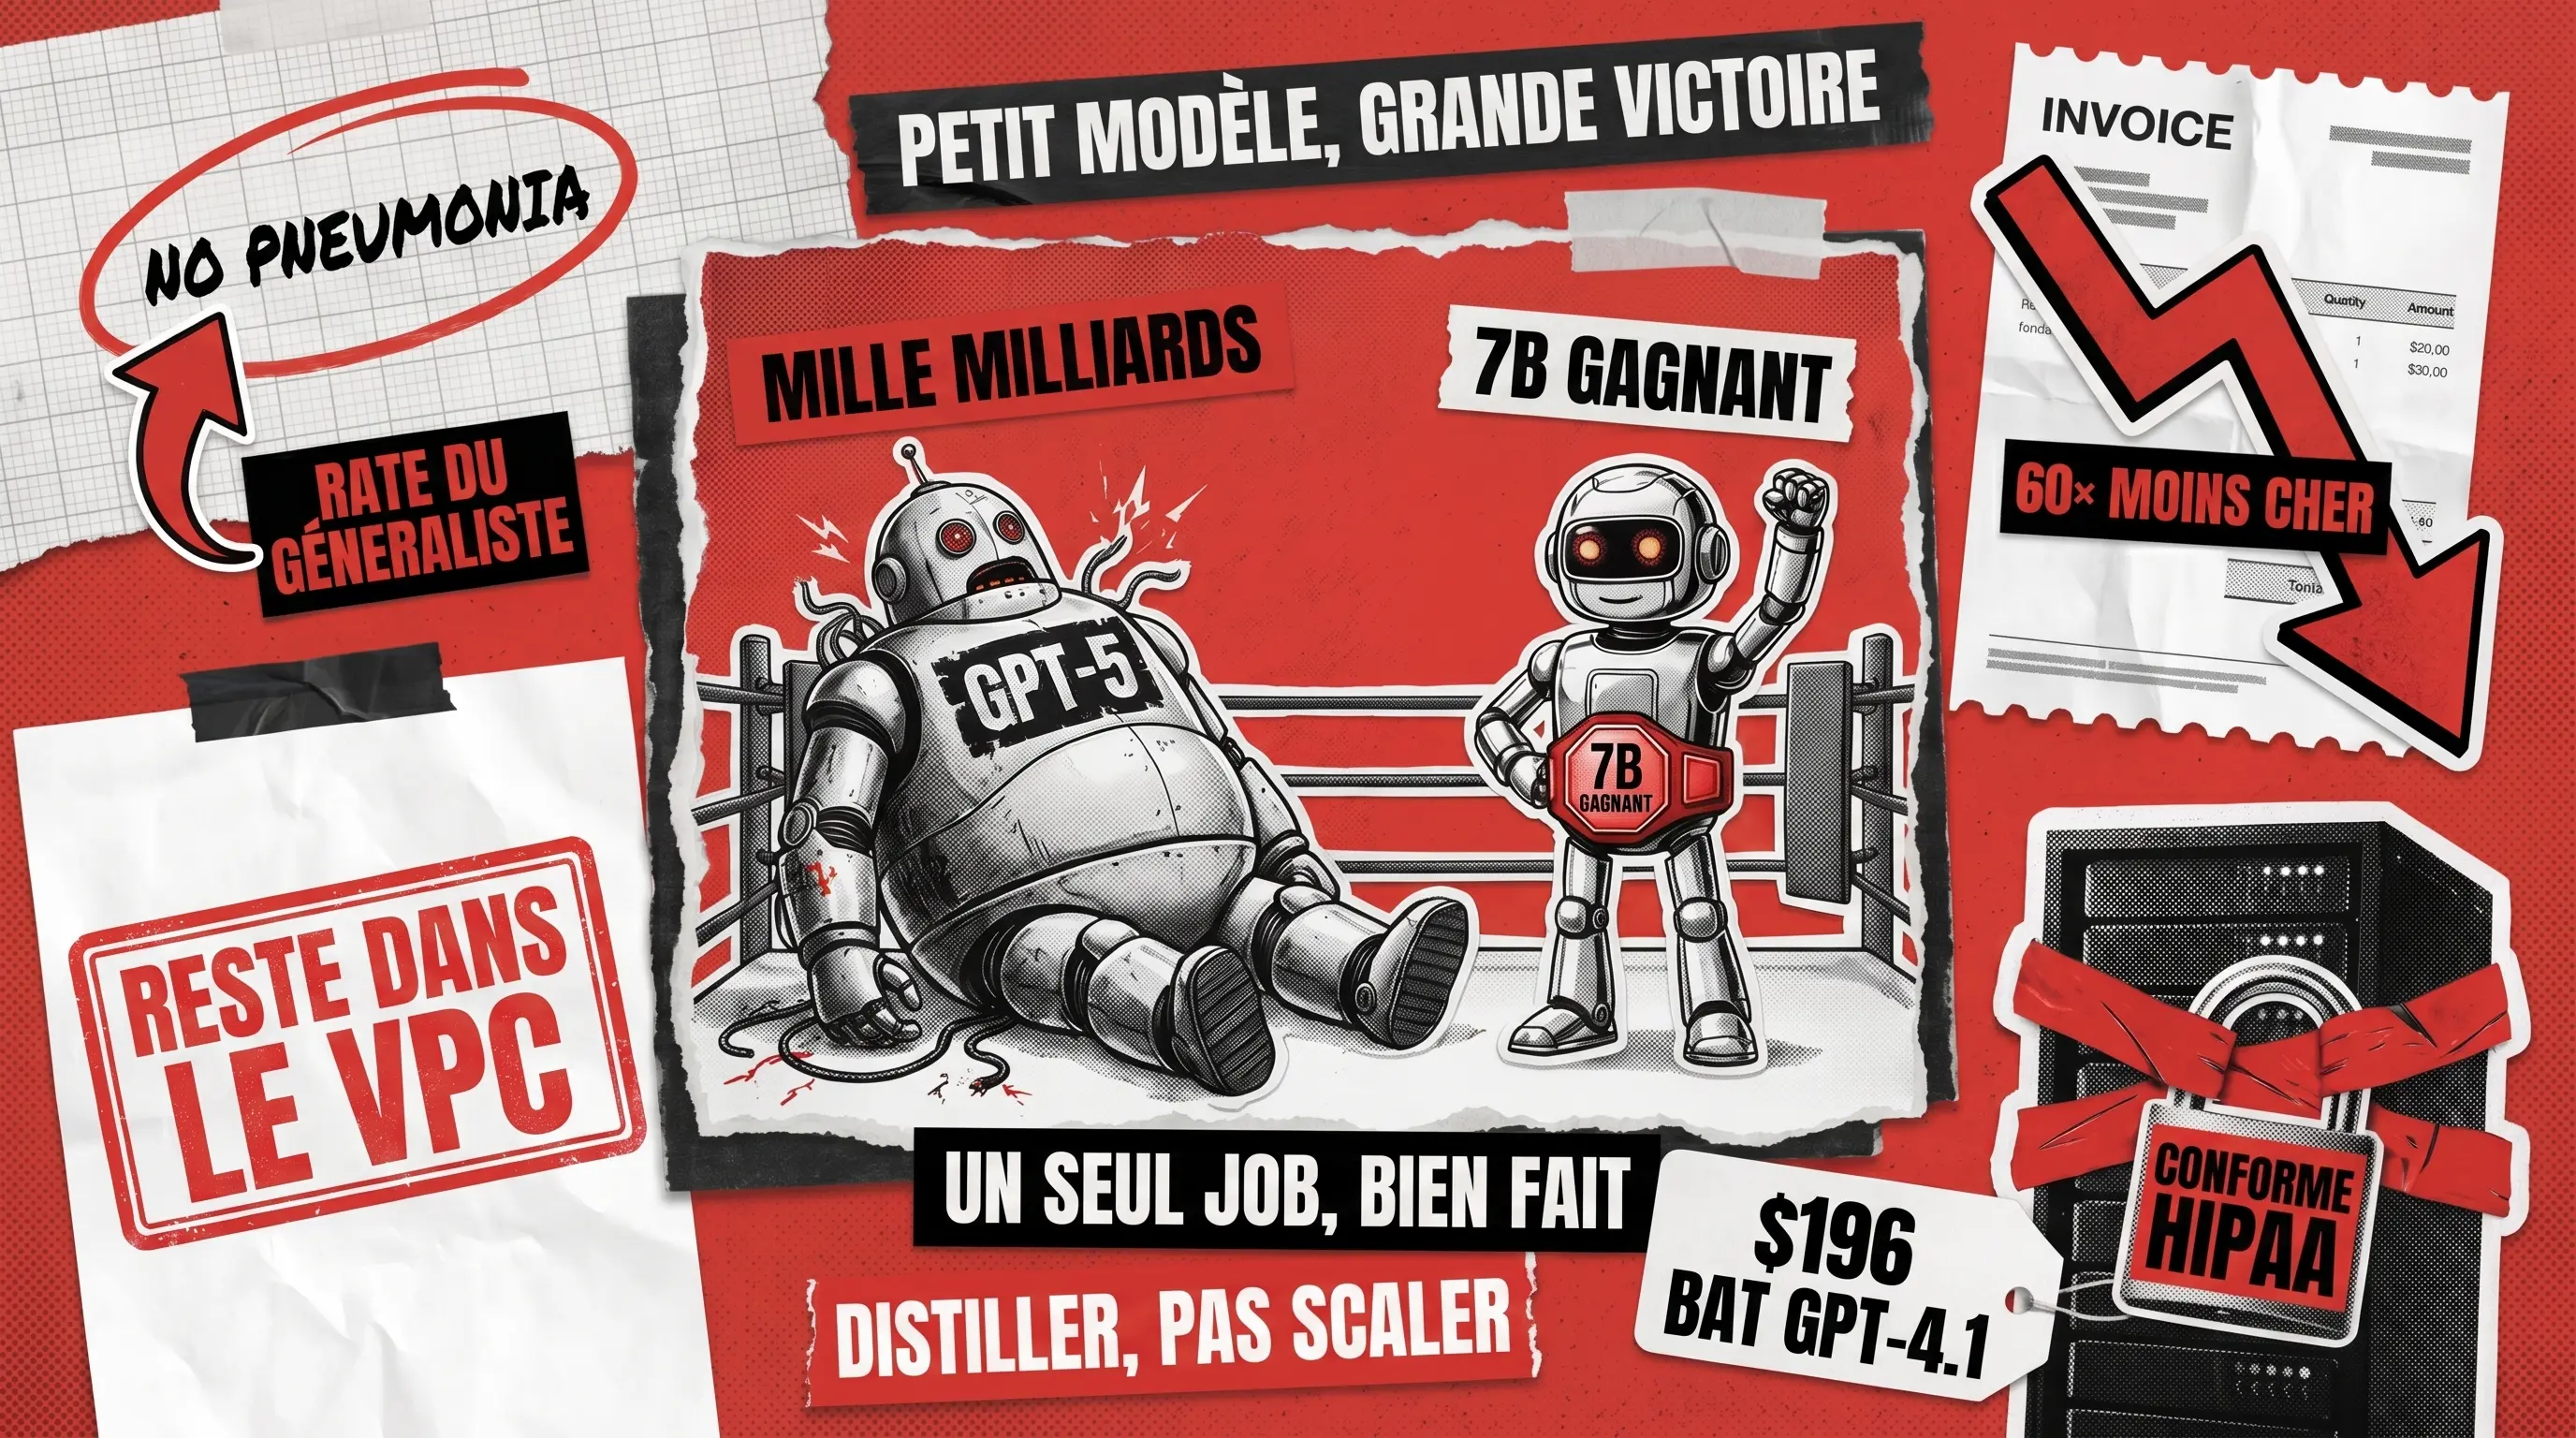
La solution contre-intuitive : aller plus petit, pas plus grand. Sur une tâche étroite et bien définie, un LLM distillé peut égaler ou surpasser un généraliste géant tout en fonctionnant moins cher, plus vite et entièrement sur votre propre infrastructure. C’est exactement la prémisse de la distillation de modèles IA as a delivery approach: take a large teacher model, train a smaller specialist on it, and ship something production-ready that fits inside your cost, latency, and compliance envelope. One published example sets the tone: Extract-0, a 7B-parameter specialist, outscored GPT-4.1 on document extraction with a training bill of $196. Let’s jump into why this works, three vertical wins that prove the pattern, and what it takes to build one.
Pourquoi les LLM spécialisés en domaines de pointe perdent du terrain sur des tâches pointues
Les modèles frontières sont construits pour être bons en tout. C’est exactement le problème quand votre tâche est une seule chose. Un généraliste entraîné sur l’intégrité d’internet apporte trop de bagages à une tâche étroite. Il connaît cinquante sujets adjacents et remet en question la convention que votre équipe utilise réellement chaque jour.
Quelques chiffres qui montrent l’ampleur de l’écart. Extract-0, un petit modèle à 7 milliards de paramètres entraîné spécifiquement pour l’extraction documentaire, a obtenu 0,573 sur la tâche tandis que GPT-4.1 atteignait 0,457. BioBERT, spécialiste biomédical, surpasse GPT-3 sur les tâches de texte médical tout en étant environ 500 fois plus petit. LEGAL-BERT atteint 92 % de précision sur la classification juridique où les modèles généraux plafonnent dans les 60 %.
Le mécanisme est sans éclat. Un spécialiste apprend profondément le vocabulaire, les abréviations, les schémas de négation et les raccourcis de raisonnement d’un seul monde. Un généraliste les moyenne. Gartner met désormais un chiffre sur ce changement, prédisant qu’en 2027, les organisations utiliseront des petits modèles IA spécifiques aux tâches trois fois plus que les LLM généralistes. La décision petit modèle de langage vs LLM avait pour habitude de pencher vers l’option plus grande. En 2026, sur une tâche étroite, cette option par défaut est le chemin coûteux vers un résultat moins bon. Tel est l’argument pour un LLM spécifique à un domaine.

Precisión, coste y soberanía de los datos: cómo un modelo de lenguaje grande especializado cambia las reglas del juego
Trois compromis changent de forme dès que votre tâche devient suffisamment étroite. Sur une charge de travail large et exploratoire, les API frontières l’emportent sur la commodité et l’ampleur. Sur un travail unique, répétitif et chargé de jargon effectué des milliers de fois par jour, les mêmes trois facteurs qui rendaient le modèle frontière attrayant dans la démo commencent à jouer contre vous en production.
La précision plafonne là où votre travail devient spécifique. Les coûts évoluent linéairement avec l’utilisation au lieu de se stabiliser. Et les données sensibles doivent voyager vers un point de terminaison tiers à chaque fois, ce qui est exactement la conversation que votre équipe de conformité ne veut pas continuer d’avoir. Voici à quoi ressemble chacun de près.
Le jargon des autres modèles est raté
Les généralistes hallucinent sur les bords qui comptent le plus. Les modificateurs ICD-10. GAAP versus IFRS. Les taxonomies de clauses. Les formulations spécifiques à la juridiction. La négation dans « aucune preuve de pneumonie » que les modèles frontières retournent parfois à son opposé.
Un spécialiste entraîné sur votre corpus arrête de rater ceux-là. En volume de production, un écart de précision de 2 points est la différence entre un outil que les gens utilisent quotidiennement et un qui se retrouve silencieusement contournié. La recherche confirme cela clairement : une étude de 2024 couvrant BioBERT et LEGAL-BERT a constaté que les modèles affinés au domaine obtenaient 92–94 % sur les tâches spécialisées tandis qu’un généraliste à 175 milliards de paramètres atteignait environ 89 % sur les mêmes références, malgré une taille sans commune mesure.
Un coût qui ne pénalise pas votre feuille de route
La tarification API évolue linéairement avec le volume. Un modèle 7B auto-hébergé sur un seul GPU est un coût mensuel fixe. Le seuil de rentabilité se situe généralement entre 100 000 et 500 000 appels par mois, et une fois passé ce cap, les courbes divergent rapidement.
Il y a un effet de second ordre qui reçoit moins d’attention. Quand chaque appel a un prix, chaque décision produit devient une question de marge. « Devrions-nous ajouter cela au flux de travail ? » se transforme en exercice sur tableur. Les modèles détenus suppriment ce frein. L’inférence est aussi là où les pertes se produisent à grande échelle : les analystes de l’industrie estiment maintenant que l’inférence représente environ 85 % des budgets IA d’entreprise en 2026, les flux de travail agentiques toujours actifs multipliant cette exposition.
Des données qui ne quittent jamais le périmètre
C’est le compromis qui fait financer le projet. HIPAA, RGPD, la loi IA de l’UE, SOC 2, les règles de résidence financière, le privilège avocat-client. Tous partagent une contrainte : le contenu sensible ne peut pas toucher un point de terminaison tiers. Un LLM vertical exécuté dans votre VPC supprime la négociation du BAA, raccourcit la piste d’audit à une seule frontière et transforme « que se passe-t-il en cas de fuite de données » en non-question.
La Commission européenne a adopté son règlement relatif au cloud et au développement de l’IA le 3 juin 2026, instaurant ainsi le premier cadre européen de garantie de souveraineté à quatre niveaux pour les services de cloud et d’IA. Les entreprises exposées au secteur public européen ou soumises à des obligations au titre de la DORA, de la NIS2 ou du règlement européen sur l’IA ne peuvent plus considérer la question du traitement des données comme une simple note de bas de page dans leurs contrats d’achat. Un modèle exécuté au sein de leur propre infrastructure apporte une réponse définitive à cette question, valable pour chaque audit, chaque contrat et chaque autorité de régulation.
Pour une tâche précise dans un secteur vertical réglementé, les trois compromis convergent dans la même direction.
Modelos de lenguaje grande (LLM) especializados en salud, finanzas y derecho: tres casos de éxito que confirman la tendencia
L’argument prend forme quand on le met en face de vrais secteurs. La santé, la finance et le secteur juridique partagent les mêmes contraintes opérationnelles : travail étroit et répétable, jargon qui ne pardonne pas les approximations d’un généraliste, et données qui ne peuvent pas quitter le bâtiment facilement. Ce sont aussi les trois secteurs où le coût d’une sortie IA incorrecte n’est pas un simple regénérer-et-réessayer, mais un constat réglementaire, une réclamation mal classée ou un document privilégié dans de mauvaises mains. Trois cas courts, même structure : la tâche, là où le généraliste échoue, l’approche spécialiste, le résultat.
Soins de santé : Codage médical et résumé clinique
La tâche est lourde, complexe et dépendante des données de santé protégées. Les généralistes confondent les modificateurs de la CIM-10, oublient la négation (« absence de pneumonie » interprété comme « pneumonie ») et imposent une discussion sur la loi HIPAA que personne dans votre équipe ne souhaite avoir.
Des experts en droit médical, formés à partir de notes cliniques et de données de dossiers médicaux électroniques, sont exécutés sur un seul GPU au sein du réseau hospitalier. Leurs performances surpassent celles des modèles de type GPT-5 sur des tests de TALN clinique tels que la reconnaissance d’entités nommées (NER), le raisonnement médical et la détection d’hallucinations. Le gain de précision est mesurable. Le coût par patient n’est plus proportionnel au volume d’activité de l’hôpital. Les données de santé protégées (DSP) restent dans l’établissement. Les échanges relatifs à la loi HIPAA sont simplifiés.
Finance : Extraction de documents et analyse réglementaire
BloombergGPT a confirmé cette tendance pour les volumes importants. Le processus de production est désormais plus court. Un spécialiste, familiarisé avec vos documents, les analyse comme un analyste, sans falsifier les lignes budgétaires, et conserve vos données confidentielles au sein de votre infrastructure. C’est plus rapide que de réexécuter un modèle de pointe sur chaque page, et le coût par document est suffisamment prévisible pour être présenté au conseil d’administration. Pour les entreprises comparant les services d’analyse de données (SLM) et d’analyse de données (LLM) pour ce type de travail, le calcul est rarement en faveur du généraliste dès que le volume dépasse les six chiffres par mois.
Juridique : Examen des clauses et analyse des contrats
Les équipes juridiques passent un temps énorme sur une poignée de tâches répétitives : la négociation des contrats, la mise en évidence des clauses non standard enfouies dans de longs accords et le signalement de l’exposition réglementaire dans des portefeuilles de milliers de documents. Ce sont exactement le genre de tâches étroites et commandées par des schémas où un modèle affiné au domaine prend de l’avance, et la recherche le confirme. LEGAL-BERT a atteint 92 % sur les références de classification juridique où les modèles généraux obtenaient les 60 %. Les spécialistes juridiques modernes gèrent ce travail à grande échelle sans jamais envoyer de documents privilégiés via une API tierce, ce qui préserve le privilège et raccourcit la piste d’audit.
L’histoire de la précision est solide. L’histoire du privilège est ce qui fait signer le contrat. Aucun associé ne veut expliquer à un client pourquoi son accord de confidentialité a été vectorisé dans le centre de données de quelqu’un d’autre.
Les éléments nécessaires à la mise en production d'un modèle d'IA spécifique à un secteur d'activité
Si vous en êtes là dans l’article, vous avez cessé de demander si l’approche fonctionne et avez commencé à demander ce que ça coûte. Voici la version honnête.
Trois voies réelles, choisies par contrainte :
- Le fine-tuning d’un modèle de base ouvert (Llama, Mistral, Qwen) sur 10 000 à 30 000 exemples de domaine étiquetés. LoRa ou QLoRa sur un seul GPU. Le point de départ par défaut pour la plupart des équipes et la base la plus flexible pour les développements futurs.
- La distillation à partir d’un modèle frontière. Utilisez GPT-5 ou Claude pour générer des données d’entraînement, puis entraînez votre petit modèle dessus. Il hérite du raisonnement du modèle enseignant et son coût d’exécution est considérablement réduit. Vous gardez ainsi le contrôle du modèle de production. D’après les benchmarks de prix publics de 2026, l’inférence sur un modèle ouvert 8B affiné peut coûter environ 60 fois moins cher que l’équivalent sur GPT-4o affiné, pour 10 000 requêtes par jour.
- Combinaison RAG plus réglage fin. Cette approche combinée utilise un paramétrage fin pour enseigner au modèle les spécificités de votre domaine, puis intègre une fonction de recherche pour les informations trop fréquemment mises à jour pour être intégrées aux pondérations. La plupart des architectures de production aboutissent à cette solution, car elle résout les deux problèmes simultanément. Lorsque l’accès conversationnel est essentiel, cette même architecture s’étend naturellement à une couche de chatbot optimisée pour le domaine, qui hérite de la précision du spécialiste.
Les chiffres pratiques :
- Calendrier : 6 à 12 semaines pour une première version prête pour la production, selon la disponibilité des données.
- Équipe : un ingénieur ML, un expert du domaine pour la revue des annotations, une personne DevOps pour le déploiement. Pas un laboratoire de recherche.
- Données : la qualité bat la quantité. 10 000 exemples bien annotés surpassent systématiquement 100 000 exemples bruités.
- Infrastructure : un seul A100 ou équivalent exécute la plupart des spécialistes 7B–13B en production. La facture matérielle est plus petite que ce que la plupart des équipes anticipent au premier coup d’œil.
Pour les équipes déjà engagées dans des projets de développement LLM plus vastes, un modèle de langage étendu et spécifique à un domaine est généralement une extension de l’infrastructure existante plutôt qu’un projet parallèle. Il en va de même lorsque l’étape suivante consiste à intégrer le spécialiste dans des flux de travail autonomes : un agent d’IA dédié hérite alors de la précision du spécialiste et l’exécute dans le même environnement contrôlé.
Le modèle de compilation est crucial, car les benchmarks 2026 d’IBM Research démontrent l’efficacité d’un réglage fin spécialisé : son modèle Granite 4.1 à 8 milliards d’instructions égale ou surpasse systématiquement un modèle Mixture-of-Experts à 32 milliards d’instructions pour les tâches d’entreprise, avec un nombre de paramètres quatre fois inférieur, une fois optimisé pour le traitement en aval. Conclusion : le nombre de paramètres n’est pas le levier. C’est l’orientation vers la tâche qui compte.
Un modèle d’IA spécifique à un secteur d’activité n’est pas un artefact de recherche. C’est un actif qui vous appartient, déployé pour une tâche précise et qui s’autofinance.
Quand une API de pointe reste supérieure à un LLM personnalisé
Section honnêtete. La voie du spécialiste est mauvaise pour certaines équipes.
La tâche est véritablement large ou créative
API frontière avec ingénierie de prompt
Le volume est inférieur à 10 000 appels par mois
L’économie API l’emporte encore
Les exigences changent chaque semaine
RAG sur un modèle frontière
Il n’existe pas de données propriétaires sur lesquelles affiner
API frontière ; à reconsidérer quand vous avez des données
Pour les travaux étroits, à haut volume, réglementés et chargés de jargon, ce qui représente la plupart des cas en santé, finance et droit, une approche personnalisée est le choix rationnel. Nommer les exceptions rend la règle plus nette.
Narrow Wins
Sur un travail étroit, bien défini et à haut volume dans un secteur réglementé, un spécialiste distillé égale ou surpasse GPT-5 tout en fonctionnant moins cher, plus vite et dans le pare-feu. Le réflexe « plus grand modèle = meilleur » était vrai en 2023. En 2026, sur votre tâche, ce n’est plus le cas.
Si vous avez un travail étroit que vous confieriez demain à l’IA si le coût et la conformité ne l’empêchaient pas, c’est le brief que nous aimons. Dites-nous la tâche, le volume et les règles sur les données, et nous vous dirons si un spécialiste a du sens et ce qu’il faudrait pour le construire.Contactez-nous quand vous êtes prêt.
Découvrez comment des décennies d’expertise dans un domaine de niche sont devenues la solution de tarification automatisée n° 1 utilisée dans le monde entier.