Un directeur d’usine qui évalue un projet de ML se pose généralement d’abord une question : quel cas d’usage est rentabilisé en moins d’un an, et que faut-il pour y parvenir ? En bref, le machine learning dans l’industrie manufacturière est aujourd’hui rentable à trois endroits : la maintenance prédictive, l’inspection qualité par vision, et l’optimisation de la demande et des procédés. Chacun repose sur un pipeline de données, un modèle et une intégration au MES, à l’ERP ou au CMMS que l’usine exploite déjà, et chacun dépend de données que la plupart des usines ne possèdent qu’en partie.
La plupart des usines disposent déjà d’une partie de ces fondations : des capteurs sur les équipements critiques, un historian et un ERP qui conserve des années d’historique de commandes. Ce qui détermine le retour sur investissement, c’est la qualité de la connexion entre ces éléments et l’honnêteté avec laquelle le premier projet est cadré en fonction d’eux. Ce guide est rédigé du point de vue de la mise en œuvre, à partir des travaux de Redwerk en développement de logiciels de fabrication et en livraison de projets d’IA. Il passe en revue chaque cas d’usage, sa stack technique et ses prérequis en matière de données.
Maintenance prédictive
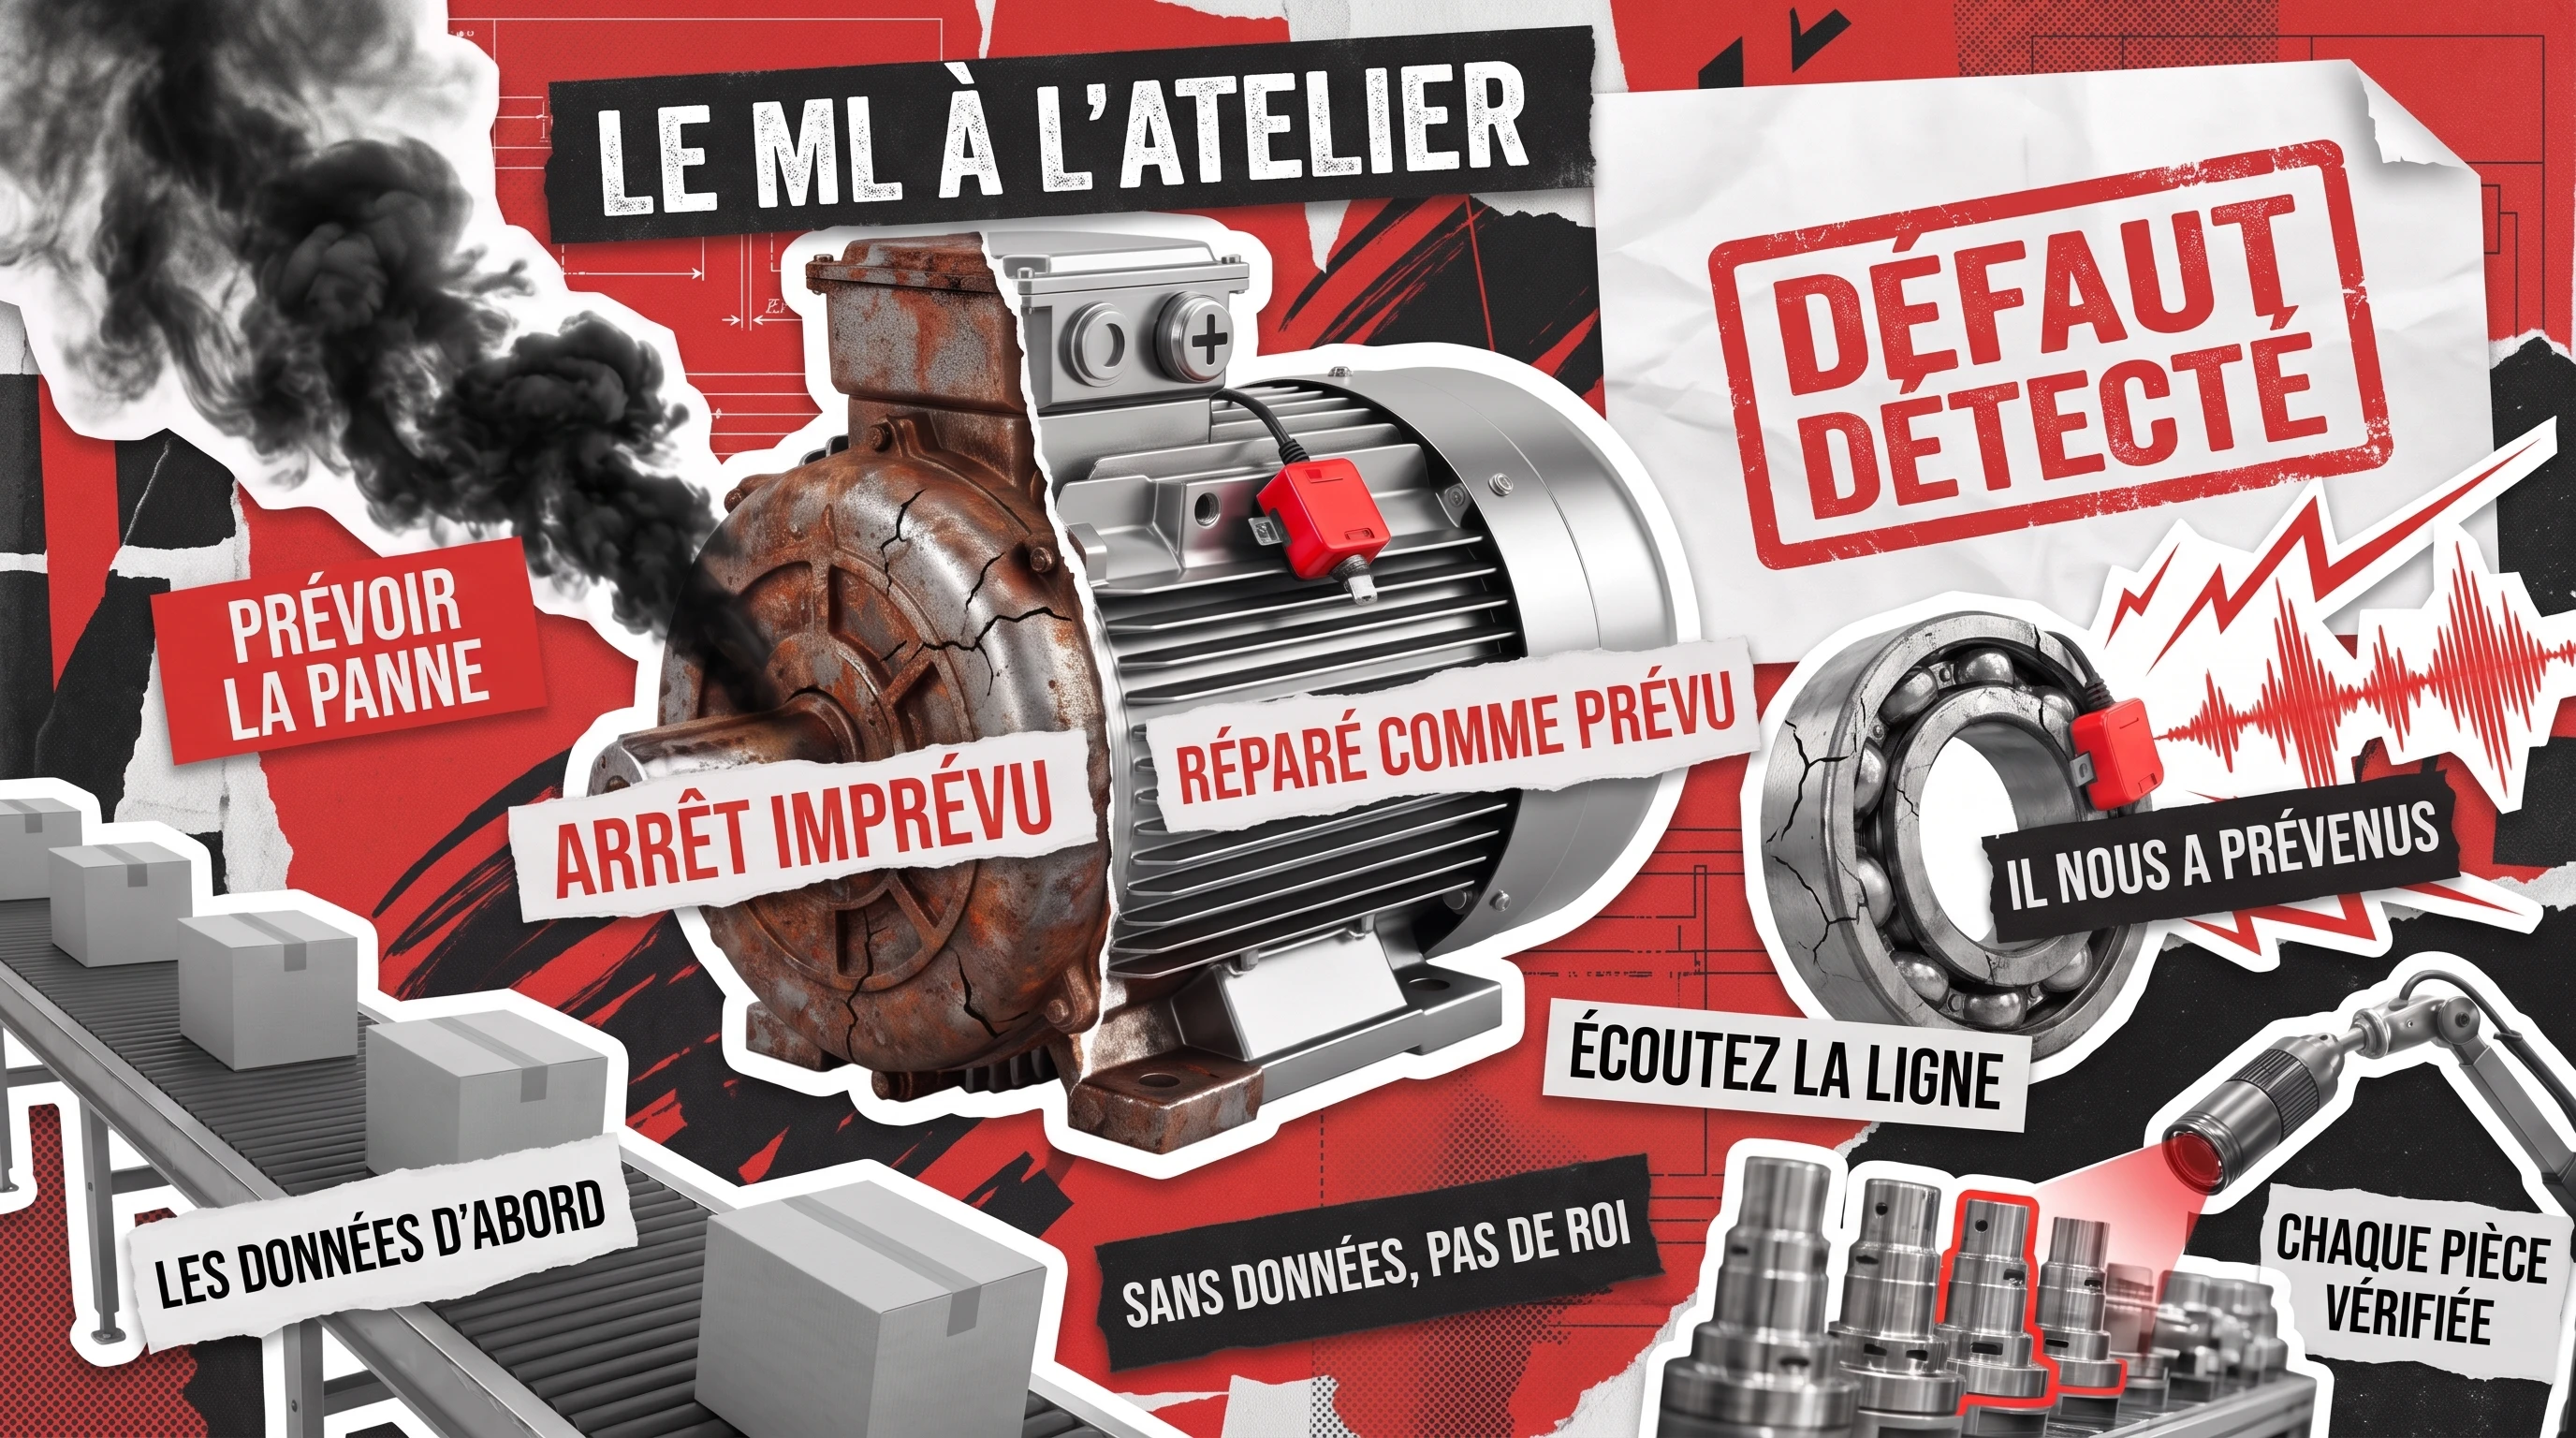
La maintenance prédictive par machine learning est le cas d’usage le plus mature en atelier, et généralement celui dont le retour sur investissement est le plus rapide. Les données transmises en continu par les moteurs, roulements, pompes, broches CNC et unités CVC alimentent une couche de détection d’anomalies qui signale les composants susceptibles de tomber en panne avant qu’ils ne le fassent. Les alertes arrivent dans le CMMS sous forme d’ordres de travail, avec un score de confiance et un délai d’intervention suggéré, afin que les planificateurs puissent caler la réparation sur un arrêt programmé.
Ce qu'il y a sous le capot
Un pipeline type commence au niveau de l’automate. Des passerelles OPC UA et des brokers MQTT collectent les mesures des automates programmables et des capteurs en périphérie, puis Apache Kafka achemine le flux vers un feature store qui calcule des fenêtres glissantes, comme le niveau de vibration sur les dix dernières minutes ou la dérive de température au cours d’un poste. Au-dessus se trouve une combinaison de modèles, chacun choisi pour une tâche précise. Isolation Forest détecte les valeurs aberrantes à moindre coût avant même que des pannes annotées n’existent, les arbres à gradient boosting classent le risque de panne une fois qu’un historique annoté s’est constitué, et les autoencodeurs LSTM apprennent la forme normale d’un signal et signalent les écarts.
L’entraînement se fait généralement dans le cloud, où la puissance de calcul est bon marché et l’historique complet disponible. L’inférence est déplacée vers un équipement edge ou s’exécute sur l’automate lui-même lorsque la contrainte de latence est forte, pour les équipements dont l’alerte doit arriver en quelques secondes.
Où le ROI apparaît en premier
Les gains apparaissent d’abord sur les équipements rotatifs de grande valeur, les lignes énergivores et tout équipement dont un arrêt imprévu se répercute sur le poste suivant. Sur ces équipements, les temps d’arrêt et le temps moyen entre pannes commencent généralement à évoluer dans les un à deux trimestres suivant la mise en service, car chaque panne évitée sur un équipement critique représente un coût important. Chez les pionniers, les chiffres sont considérables : sur le site Hawiyah NGL de Saudi Aramco, la gestion des actifs assistée par IA et les jumeaux numériques ont augmenté le taux de rendement synthétique de 44 %, selon la mise à jour Lighthouse de juin 2026 du Forum économique mondial. Il s’agit de résultats déclarés par des sites phares : considérez-les comme un plafond et établissez votre propre référence à partir de vos journaux actuels de MTBF et de temps d’arrêt.
Contrôle qualité et détection des défauts
Pour le contrôle qualité par machine learning, les lignes de production s’appuient sur la vision par ordinateur, qui inspecte chaque unité à la recherche de défauts de surface, d’écarts dimensionnels, d’erreurs d’assemblage et de défauts d’étiquetage ou d’emballage. Le modèle attribue une classe de défaut, enregistre l’image et retire l’unité de la ligne ou l’oriente vers un contrôleur humain pour une validation rapide. L’inspection manuelle ne contrôle qu’une fraction de la production et perd en vigilance au fil du poste, tandis qu’une caméra vérifie chaque unité à la cadence de la ligne, avec le même seuil à 3 h du matin qu’à 9 h. La reconnaissance d’images et la détection d’objets sont au cœur des travaux de Redwerk en développement de logiciels personnalisés IA, ce qui en fait le cas d’usage où nos compétences s’appliquent le plus directement à l’atelier.
Les quatre composants d'un système d'inspection par vision
- Caméra et dispositif d’éclairage. Dimensionnés en fonction de la plus petite classe de défaut à détecter. Un éclairage constant compte autant que la résolution, car un reflet que le modèle n’a jamais vu peut être interprété comme un défaut.
- Jeu de données de défauts annotés. L’élément que la plupart des projets sous-estiment, traité dans la section sur la préparation des données ci-dessous.
- Modèle. Un réseau convolutif ou un vision transformer entraîné sur ce jeu de données, généralement avec PyTorch, puis exporté pour une inférence rapide.
- Inférence en périphérie et intégration. Le modèle s’exécute sur un PC industriel ou un boîtier edge à côté de la ligne, et les résultats remontent dans le QMS et le MES, de sorte que chaque unité rejetée est associée à son image, à sa classe de défaut et à son horodatage.
Où le contrôle qualité par vision est rentable en premier
La rentabilité est la plus rapide lorsque le contrôleur humain constitue le goulot d’étranglement actuel, ou lorsqu’un défaut qui parvient jusqu’au client entraîne des rappels, des retours ou la perte d’un contrat. Cela désigne l’assemblage électronique à forte variété, l’emballage agroalimentaire et le remplissage-finition pharmaceutique. Les sites distingués par le Forum économique mondial en janvier 2026 illustrent le potentiel : Haier Strauss à Qingdao a réduit son taux de défauts de 40 % et ses coûts de qualité de 72 %, et EVE Energy à Jingmen a réduit son taux de défauts de 52 % en associant diagnostic qualité en temps réel et maintenance prédictive. La précision se maintient sur les classes de défauts sur lesquelles le modèle a été entraîné : une nouvelle variante de produit ou un changement d’emballage exige donc de nouvelles images annotées avant que le modèle ne prenne en charge cette inspection.
Optimisation de la production et chaîne d'approvisionnement
Côté planification, le ML remplace les règles statiques par des prévisions qui se mettent à jour à mesure que les conditions évoluent, en s’appuyant sur les mêmes données connectées qui portent la transformation numérique dans l’industrie manufacturière. Les modèles de prévision de la demande apprennent à partir de l’historique des commandes, de la saisonnalité et de signaux en temps réel, et leurs résultats alimentent le plan de production. Les modèles d’optimisation des procédés ajustent les vitesses de ligne, les températures de four, les recettes de mélange et les séquences de changement de série en fonction du rendement et de la consommation d’énergie. Côté approvisionnement, le ML détecte tôt la dérive des délais fournisseurs et fixe les points de commande à partir d’une vision probabiliste du risque de rupture de stock, ce qui s’adapte bien mieux qu’un stock de sécurité défini une fois par an.
Comment les modèles s'intègrent à l'ERP et au MES
Les arbres de décision à gradient boosting, souvent construits avec XGBoost, sont l’outil de référence pour la prévision de la demande sur des données de commandes tabulaires. L’ajustement des procédés utilise l’optimisation bayésienne ou des boucles d’apprentissage par renforcement qui proposent une consigne, observent le résultat et ajustent. Les deux nécessitent une intégration bidirectionnelle : des lectures depuis l’ERP et le MES (carnet de commandes, en-cours, stocks) et des écritures dans ces systèmes (plan de production, points de commande). Une prévision écrite directement dans le plan de production modifie ce que la ligne fabriquera demain, et c’est là que la valeur se concrétise.
Où les premiers résultats apparaissent
Deux profils d’usine obtiennent des résultats en premier. Les usines d’assemblage de volume moyen disposant d’un ERP opérationnel et de données de référence stables peuvent passer des prévisions sur tableur aux prévisions par ML en un à deux trimestres. Les usines de procédés continus tirent le plus de bénéfices de l’ajustement des procédés, où un gain de 1 % en rendement ou en énergie représente un poste significatif, car il se cumule sur chaque heure de fonctionnement. Dans les deux cas, le premier succès vient généralement d’un périmètre restreint, par exemple une famille de produits pour la prévision ou une ligne pour l’ajustement des consignes, mesuré par rapport au plan que les planificateurs auraient établi sans le modèle.

Premiers pas : préparer les données pour le machine learning dans l'industrie manufacturière
Avant de cadrer l’un des cas d’usage ci-dessus, un exploitant d’usine se pose une question : à quoi nos données doivent-elles ressembler pour qu’un projet de ML soit rentable ? C’est là que la plupart des projets se gagnent ou se perdent, et là que des services de développement en intelligence artificielle justifient leur coût bien avant l’entraînement d’un modèle. Une revue systématique de 2026 portant sur 89 études de maintenance prédictive, publiée dans la revue Information, a constaté que 65,6 % d’entre elles utilisaient une validation faible ou peu claire, et qu’aucune n’avait atteint une validation opérationnelle sur le terrain. L’écart entre un article prometteur et un système qui fonctionne en usine tient surtout aux données et à l’intégration : nous évaluons donc trois éléments en priorité.
Maintenance prédictive
1 à 2 trimestres
Télémétrie des capteurs, historian avec 6 à 12 mois d’événements de panne
Équipements rotatifs de grande valeur, lignes énergivores
Contrôle qualité par vision
2 à 3 trimestres
Jeu d’images de défauts annotées, éclairage maîtrisé
Électronique à forte variété, emballage, remplissage-finition pharmaceutique
Prévision de la demande
1 à 2 trimestres
Historique propre des commandes et expéditions dans l’ERP, données de référence fiables
Assemblage de volume moyen, références saisonnières
Optimisation des procédés
2 à 4 trimestres
Données de procédé en temps réel, labels de rendement et d’énergie
Usines de procédés continus
Conception générative
Programme pluriannuel
Bibliothèques CAO, de simulation et de matériaux
Équipes R&D à l’échelle des OEM
Couverture des capteurs et qualité de la télémétrie
Le ML en atelier dépend entièrement des données des capteurs. Avant de cadrer un projet de maintenance prédictive, vous devez savoir quels équipements sont déjà instrumentés, à quelle fréquence d’échantillonnage, et si l’historian conserve suffisamment d’historique pour l’entraînement, généralement six à douze mois incluant des événements de panne annotés. Lorsque la couverture est insuffisante, la première phase du projet est l’instrumentation, et la modélisation commence une fois les premiers mois de données propres collectés.
Données annotées pour les modèles de vision
Un modèle de détection de défauts ne vaut que par le jeu de données annotées sur lequel il repose. Cela représente généralement quelques milliers d’images par classe de défaut, capturées avec l’éclairage et la géométrie de caméra réels de la ligne, et vérifiées par un responsable qualité. Chiffrer ce coût dès le départ permet d’éviter le constat « nous avons essayé le ML et cela n’a pas fonctionné » au bout de six mois.
Intégration MES, ERP et CMMS
Le modèle est rarement la partie à construire de zéro. La ligne fait déjà tourner un MES, l’ERP contient le carnet de commandes, le CMMS conserve l’historique de maintenance, et un historian stocke souvent les séries temporelles. L’essentiel de l’ingénierie porte sur la surface d’intégration : lectures depuis ces systèmes, écritures dans ces systèmes, interfaces avec gestion des droits, pistes d’audit et circuit d’escalade avec intervention humaine pour toute prédiction inférieure au seuil de confiance.
L’expérience de Redwerk en livraison de ML à grande échelle vient d’un secteur voisin : pour une plateforme de recrutement, nous avons entraîné un réseau de neurones dans Azure Machine Learning Studio qui a traité 1,5 million de textes pour suggérer des mots-clés pertinents. La même rigueur s’applique à une usine : nettoyer les données, s’intégrer aux systèmes que les équipes utilisent déjà et garder l’humain dans la boucle. Cela signifie aussi que vous pouvez démarrer sans cahier des charges complet, car l’audit des données définit lui-même le périmètre du premier projet.
Une démarche ciblée vers le ROI du ML industriel
Les systèmes qui passent du pilote à la production en 2026 sont la maintenance prédictive, le contrôle qualité par vision, et l’optimisation de la demande et des procédés. La conception générative et les usines entièrement automatisées restent un horizon plus lointain, à surveiller, mais rarement le bon premier investissement pour une usine de taille moyenne. Ces trois systèmes à court terme partagent un même schéma : un pipeline de données, une couche de modèles et une intégration au MES, à l’ERP, au CMMS ou au QMS que l’usine exploite déjà. Les usines qui obtiennent des résultats choisissent un équipement ou une ligne à forte valeur, y prouvent les chiffres, puis étendent la démarche à partir d’une base qui fonctionne. Si vous envisagez encore le ML au-delà de l’atelier, notre guide des cas d’usage du machine learning pour les entreprises compare les options selon les secteurs.
Redwerk apporte à ce premier projet la vision par ordinateur, l’analytique prédictive et la livraison de ML à grande échelle, avec une équipe capable de partir d’un audit des données plutôt que d’un cahier des charges finalisé. Si vous avez un équipement qui s’arrête sans cesse ou une ligne où l’inspection est le goulot d’étranglement, parlez-nous de votre projet industriel : contactez-nous, et nous vous aiderons à cadrer une première étape à partir des données dont vous disposez déjà.
FAQ
Comment le machine learning est-il utilisé dans l'industrie manufacturière aujourd'hui ?
Les industriels appliquent le ML de quatre manières principales. La maintenance prédictive signale les équipements susceptibles de tomber en panne, à partir des données des capteurs. Le contrôle qualité par vision inspecte chaque unité à la recherche de défauts à la cadence de la ligne. La prévision de la demande alimente les plans de production et les points de commande. L’optimisation des procédés ajuste des consignes comme la vitesse de ligne et la température en fonction du rendement et de la consommation d’énergie.
Qu'est-ce que la maintenance prédictive en machine learning ?
Il s’agit d’utiliser des modèles de ML sur des données de capteurs transmises en continu, comme les vibrations, la température et le courant moteur, pour prédire quels composants vont tomber en panne et quand. Le modèle génère un ordre de travail dans le CMMS avec un score de confiance et un délai d’intervention suggéré, afin que les réparations aient lieu lors d’arrêts planifiés plutôt qu’après une panne.
Comment le ML améliore-t-il le contrôle qualité sur une ligne de production ?
Des caméras et un modèle de vision entraîné inspectent chaque unité plutôt qu’un échantillon, classent les défauts tels que les rayures, les désalignements ou les erreurs d’étiquetage, et enregistrent chaque image. Les résultats remontent dans le QMS et le MES pour une traçabilité complète. La précision est élevée sur les classes de défauts sur lesquelles le modèle a été entraîné, et les nouvelles variantes nécessitent de nouvelles images annotées.
De quelles données un industriel a-t-il besoin avant de lancer un projet de ML ?
Trois éléments. Pour la maintenance prédictive, une télémétrie des capteurs avec un historique suffisant, généralement six à douze mois incluant des événements de panne annotés. Pour la vision, un jeu d’images annotées capturées dans les conditions réelles de la ligne. Enfin, un accès au MES, à l’ERP et au CMMS, car les prédictions ne créent de la valeur qu’une fois réinjectées dans les systèmes utilisés par l’usine.
Le ML vaut-il l'investissement pour une usine de taille moyenne ?
Oui, lorsque le premier projet correspond aux données dont l’usine dispose déjà. La maintenance prédictive sur les équipements rotatifs critiques et l’inspection par vision sur une ligne goulot sont les paris les plus solides, avec des résultats souvent visibles en quelques trimestres. La conception générative et l’autonomie à l’échelle de l’usine relèvent de programmes plus longs, mieux adaptés aux budgets et aux calendriers de R&D des grands OEM.
Découvrez comment Redwerk a entraîné un réseau neuronal sur plus de 1,5 million d'enregistrements pour alimenter une plateforme de mise en relation IA, plus tard acquise par un géant américain du recrutement