L’IA dans le développement logiciel touche désormais chaque étape de la livraison. Elle rédige les exigences pendant la phase de découverte, écrit et refactorise le code, présélectionne les pull requests, génère des tests et signale les vulnérabilités en maintenance. Les gains sont réels mais inégaux : la vitesse progresse surtout sur le code et le prototypage, tandis que la revue, la sécurité et la gouvernance déterminent si cette vitesse tient en production.
Pour un fondateur ou un responsable d’ingénierie, la décision de construire devient ainsi une décision de gouvernance. Quelles étapes confier à l’IA, quels outils autoriser, qui relit les résultats, et quel budget prévoir pour le nettoyage un an plus tard ? Redwerk livre des logiciels depuis 2005 et pratique le développement logiciel assisté par IA au sein des équipes de ses clients. Ce guide parcourt donc chaque étape telle que nous la gérons sur de vrais projets, compromis compris.
L'IA dans le développement logiciel : planification et découverte
La découverte est l’étape où l’IA fait économiser le plus d’argent par heure investie, car chaque hypothèse corrigée à ce stade ne coûte rien à réécrire dans le code. Le travail est passé de longs cahiers des charges à des exigences structurées et à des démos cliquables produites en quelques jours. Le jugement reste humain : quelle fonctionnalité génère du chiffre d’affaires, quelle partie prenante a le dernier mot, et quel risque aucun jeu de données ne peut prévoir.
Exigences et estimation
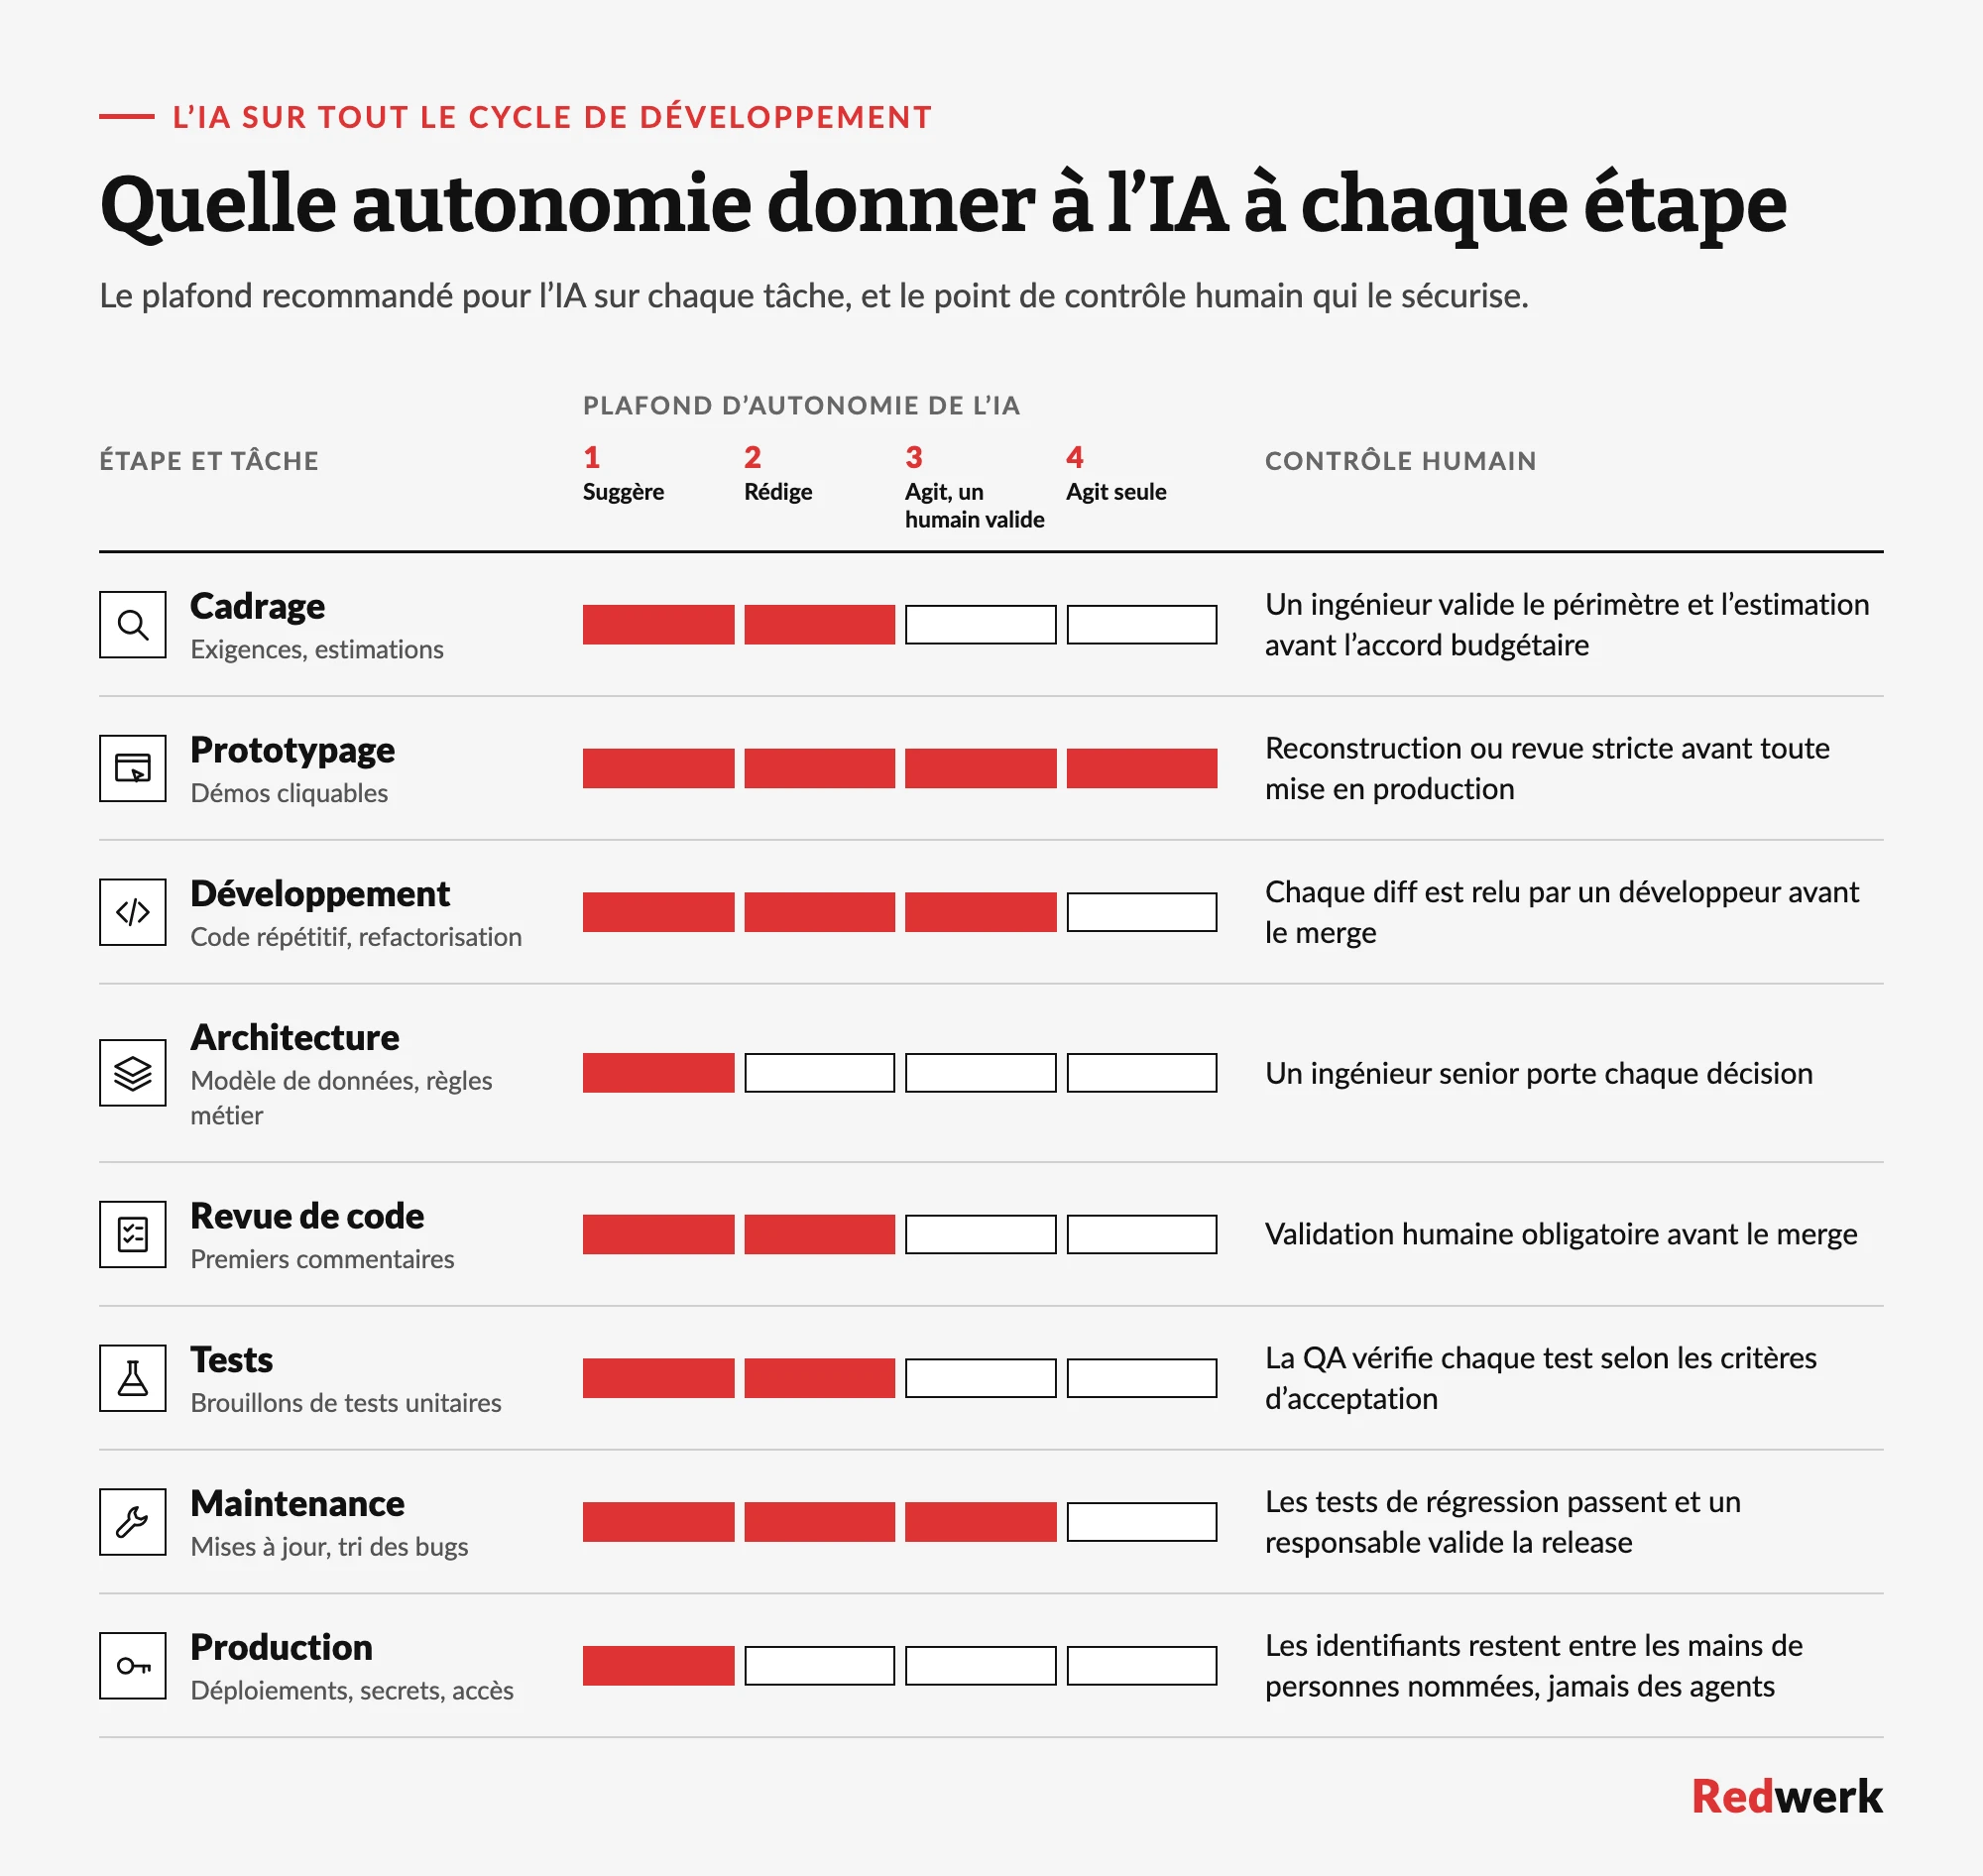
Transcriptions de réunions, documentation existante et tickets de support peuvent désormais alimenter un modèle de langage qui renvoie des user stories préliminaires, une liste de fonctionnalités priorisée et les contradictions repérées entre parties prenantes. L’estimation suit la même logique. Le modèle compare le périmètre à des schémas issus de projets comparables et produit une première fourchette que l’équipe peut remettre en question. C’est tout l’enjeu de la façon dont l’IA transforme la phase de découverte : des premières versions plus rapides, avec une validation humaine comme passage obligé avant la signature de tout budget.
Un prototypage plus rapide
Le plus grand changement en planification est le passage des wireframes statiques à des prototypes fonctionnels dès la phase de découverte. Une version cliquable dans les premières semaines donne aux parties prenantes de quoi réagir, et ces réactions font émerger les exigences manquantes plus tôt que n’importe quel document. Les prototypes ainsi conçus remplissent trois rôles :
- Validation. Utilisateurs et investisseurs testent un parcours avant d’engager le budget de production.
- Maîtrise du périmètre. Les fonctionnalités contestées se tranchent en les montrant, ce qui accélère la validation.
- Vérifications d’architecture. Le prototype met au jour les questions d’intégration et de données tant qu’elles restent peu coûteuses à résoudre.
Le revers de la médaille : le code d’un prototype est écrit pour la vitesse. Il doit être reconstruit ou soumis à une revue rigoureuse avant de devenir le socle du produit.
Cette approche convient aussi aux équipes qui démarrent sans spécifications complètes, un cas fréquent chez les clients qui font appel à Redwerk. L’IA transforme les premiers échanges en exigences structurées et en démo fonctionnelle, puis les ingénieurs valident l’estimation ligne par ligne avant l’approbation du budget.
Le code assisté par IA
Le code est l’étape où l’adoption a été la plus rapide et où l’écart entre une démo et la production est le plus grand. Les outils sont passés de l’autocomplétion dans l’éditeur à des agents qui lisent un dépôt, planifient une modification sur plusieurs fichiers, lancent les tests et ouvrent une pull request. La journée d’un ingénieur senior se recentre ainsi sur la spécification, la revue et la correction, et les questions qu’un client doit poser à un prestataire sur ses processus changent elles aussi.
Capacités des assistants de code
Les assistants de code IA actuels se répartissent en deux groupes. Les assistants intégrés à l’éditeur complètent et modifient le code au fil de la frappe, tandis que les agents prennent une description de tâche et travaillent seuls sur l’ensemble du dépôt. Les deux excellent sur les tâches répétitives et perdent en efficacité à mesure qu’une tâche dépend d’un contexte extérieur au code.
Code standard, endpoints CRUD, configuration
Bonne, avec de petites retouches
Nommage, structure, conventions d’équipe
Refactoring et montées de version de frameworks
Bonne sur des modules circonscrits
Choix du périmètre, tests de non-régression
Fonctionnalités multi-fichiers via des agents
Variable, selon la qualité du dépôt et de la spec
Découpage des tâches, revue de chaque diff
Architecture et logique métier
Faible
Arbitrages, modèle de données, règles métier
Assistants de code par cas d'usage
Le bon assistant dépend du dépôt, de l’IDE et des règles de sécurité en vigueur : une configuration indépendante des outils fonctionne donc mieux qu’un standard unique pour toute l’entreprise. Ces options couvrent la plupart des scénarios de livraison :
- Claude Code et OpenAI Codex pour les tâches pilotées par des agents, y compris les configurations connectées à GitHub, Jira et aux pipelines de CI.
- Cursor pour les équipes aux profils variés et les projets à forte composante frontend, où il a offert la prise en main la plus simple lors des déploiements de Redwerk.
- GitHub Copilot, Amazon Q Developer (le successeur de CodeWhisperer) et Gemini Code Assist dans VS Code et IntelliJ, choisis en fonction du fournisseur cloud et de l’hébergeur du dépôt.
Les bases de code propriétaires exigent des assistants qui s’appuient sur des modèles en cloud privé ou sur site, afin que le code du client reste dans son propre environnement. Les tableaux de bord d’utilisation doivent être en place dès la première semaine, car les coûts par licence et par crédit augmentent discrètement dès qu’une équipe entière adopte ces outils.
Gains et compromis
Le gain de productivité est mesurable à grande échelle. Une étude de 2026 portant sur des dizaines de milliers d’ingénieurs de Microsoft a montré que les utilisateurs d’agents de code en ligne de commande ont fusionné environ 24 % de pull requests en plus que ce qu’ils auraient fait autrement. Les clients de nos prestations de développement assisté par IA constatent une livraison jusqu’à 2 fois plus rapide lors des premiers sprints.
Le compromis arrive plus tard. Plus de code fusionné signifie plus de code à relire, et les assistants ont tendance à répéter la logique plutôt qu’à la réutiliser : la duplication est donc le premier problème que nos ingénieurs s’attendent à trouver lorsqu’ils auditent une base de code largement générée par IA. Les équipes qui négligent la revue transforment leur vitesse en dette technique, et c’est pourquoi le nettoyage de bases de code écrites par IA est devenu une mission courante chez Redwerk.
Revue de code et tests
La revue et les tests sont les étapes où la production de l’IA se heurte aux contrôles qualité, et elles absorbent l’essentiel du volume supplémentaire généré par les agents de code. Les deux bénéficient aujourd’hui d’une automatisation utile, avec des limites visibles dans les taux de merge, les tests fragiles et les bugs qui passent tous les contrôles. L’objectif concret : un pipeline où les machines assurent le premier passage et où les ingénieurs ont le dernier mot.
L'IA dans la revue de code
Des outils de revue par IA comme SonarQube et DeepCode AI commentent une pull request en quelques minutes et repèrent les problèmes de style, les schémas de bugs courants, les contrôles de nullité manquants et les signatures de vulnérabilités connues. Ce premier passage libère les relecteurs seniors pour la conception, les flux de données et les règles métier. La revue entièrement automatisée est une autre histoire. Une étude de 2026 portant sur 3 109 pull requests a montré que les PR relues uniquement par des agents de revue de code atteignaient un taux de merge de 45,20 %, contre 68,37 % pour les PR relues par des humains, avec un taux d’abandon nettement plus élevé.
La configuration la plus solide associe des revues de code assistées par IA pour le premier passage à un ingénieur senior pour l’approbation. Avec cette organisation, les clients de nos prestations de développement assisté par IA constatent jusqu’à 60 % de temps en moins consacré à la revue de code.
Les limites de la génération de tests
La génération de tests par IA excelle sur le volume. Elle rédige des tests unitaires pour les fonctions existantes, comble les lacunes de couverture et produit des cas limites plus vite que n’importe quel ingénieur. Elle peine sur quatre points :
- Des tests calqués sur le code. Générés à partir de l’implémentation, ils confirment ce que fait le code, bugs compris.
- Une couverture en trompe-l’oeil. Le pourcentage de couverture grimpe alors que les parcours métier critiques restent non testés.
- Des suites end-to-end fragiles. Les tests d’interface générés cassent au moindre changement de mise en page et alourdissent la maintenance.
- L’intention absente. Le modèle ne connaît que les critères d’acceptation que quelqu’un a mis par écrit.
Nous traitons les tests générés comme des brouillons. Un ingénieur QA vérifie chacun d’eux au regard des exigences avant de l’intégrer à la suite.
Maintenance et sécurité
L’essentiel du coût d’un produit survient après le lancement : c’est donc en maintenance que les économies liées à l’IA se cumulent. Les outils qui accélèrent la livraison élargissent aussi la surface d’attaque, car chaque assistant, plugin et agent fait désormais partie de la chaîne d’approvisionnement logicielle. C’est pourquoi les deux sujets doivent être traités ensemble : chaque gain d’un côté crée une nouvelle obligation de l’autre.
Une maintenance allégée
L’IA prend désormais en charge une grande partie de l’entretien courant : mises à jour des dépendances, analyse des logs, tri des bugs et documentation de code que personne ne se souvient d’avoir écrit. L’indexation de la base de code est le gain sous-estimé. Les nouveaux ingénieurs peuvent interroger directement un dépôt au lieu d’attendre un collègue senior, ce qui explique en partie pourquoi nous pouvons prendre en main un produit hérité en quelques jours. Voilà comment la maintenance logicielle par IA transforme les entreprises qui exploitent des produits pendant des années : l’entretien courant coûte moins cher, et le temps des seniors se reporte sur les causes profondes des incidents, les décisions de mise en production et les données réglementées.
Nouveaux risques de sécurité
Les attaquants utilisent les mêmes outils. L’étude Cost of a Data Breach 2026 d’IBM a révélé qu’une violation malveillante sur quatre était facilitée par l’IA, soit une hausse de 56 % par rapport à l’année précédente, et plus de 20 % des organisations ont signalé une violation ciblant des modèles ou des applications d’IA. Dans la base de code, voici les risques que nous vérifions le plus souvent :
- Suggestions non sécurisées : failles d’injection, validation des entrées insuffisante et secrets codés en dur qui semblent corrects lors de la revue.
- Paquets hallucinés : imports de dépendances inventées que des attaquants enregistrent ensuite sous le même nom.
- Fuites via les prompts : clés d’API et données clients collées dans des outils de chat.
- Agents aux privilèges excessifs : accès en écriture aux dépôts, à la CI ou à la production accordé par commodité.
Sur nos projets, chaque modification générée par IA passe par les mêmes contrôles alignés sur l’OWASP que le code écrit par des humains. La réponse honnête à la question le développement augmenté par l’IA est-il sécurisé dépend précisément de la mise en place de ces contrôles avant que les agents ne se généralisent dans une équipe.
IA fantôme (shadow AI) et gouvernance
La gouvernance est l’étape que la plupart des équipes ajoutent en dernier alors qu’elles en ont besoin en premier. Les développeurs adoptent de nouveaux outils chaque semaine, et chaque assistant non autorisé est un point par lequel du code, des identifiants ou des données clients peuvent quitter l’entreprise. La supervision doit couvrir tout le cycle de vie du développement logiciel avec l’IA, du prompt saisi par un product manager pendant la découverte jusqu’à l’agent qui ouvre une pull request pendant la nuit.
Les formes courantes d'IA fantôme
L’IA fantôme désigne l’utilisation d’outils d’IA sans approbation ni supervision de la direction technique ou de la sécurité. Dans les équipes logicielles, elle prend des formes banales : un assistant en offre individuelle payé avec la carte personnelle d’un développeur, un chatbot dans le navigateur utilisé pour déboguer une stack trace de production, un agent local connecté à une base de données interne, ou une fonctionnalité SaaS qui a activé un traitement par IA lors d’une mise à jour. Chacune crée une exposition que personne ne suit, du code sous licence copié dans un dépôt propriétaire aux secrets stockés sur les serveurs d’un tiers. La détection de l’IA fantôme dans le SDLC commence par le trafic réseau, les logs SaaS et les signaux du dépôt, car les politiques écrites passent à côté de l’essentiel de l’activité réelle.
Un dispositif de supervision concret
La gouvernance fonctionne quand la voie autorisée est la plus simple. Voici les six contrôles que nous mettons en place dans les premières semaines d’une mission :
- Une liste d’outils approuvés avec des comptes entreprise, pour que l’option autorisée soit aussi simple à utiliser qu’un compte personnel.
- Des endpoints de modèles privés ou sans conservation des données pour tout dépôt contenant du code propriétaire ou réglementé.
- Des labels de pull request ou des trailers de commit qui signalent les modifications générées par IA, pour que les revues et les audits restent traçables.
- Une revue humaine et une analyse de sécurité automatisée sur chaque modification produite par IA, petits diffs compris.
- Des permissions d’agents limitées : lecture par défaut, écriture accordée tâche par tâche, et identifiants de production hors de portée.
- Des tableaux de bord d’utilisation et de coûts revus chaque mois, ainsi qu’une politique d’une page précisant quelles données peuvent aller dans quel outil.
Chaque contrôle se met en place en quelques jours. Ensemble, ils rendent l’usage de l’IA visible et auditable pour l’équipe du client elle-même.
La gouvernance, un avantage concurrentiel
Les deux dernières années ont tranché la question de l’adoption pour la plupart des équipes d’ingénierie, si bien que disposer des outils est désormais le minimum. Reste la question du contrôle : quelles étapes sont automatisées, lesquelles sont soumises à validation, et à quelle vitesse les problèmes dans les résultats de l’IA sont détectés. Un an plus tard, deux équipes dotées des mêmes assistants peuvent se retrouver avec une base de code propre et évolutive, ou avec une base freinée par la dette de revue et les reprises. C’est le processus qui fait la différence.
Redwerk livre des logiciels depuis 2005 et a mené plus de 30 projets assistés par IA, avec Claude Code, Codex, Cursor et Copilot déployés au sein des équipes clientes. Nous apportons l’outillage, la rigueur de revue et la gouvernance en un seul ensemble, et nous tenons nos clients informés à chaque étape. Cette combinaison convient aux équipes sans spécifications complètes, à celles qui manquent de compétences en interne et à celles qui héritent d’une base de code écrite par IA à remettre sur pied. Si vous voulez la vitesse de l’IA avec un contrôle digne de la production, contactez-nous et nous identifierons où elle s’intègre dans votre produit.
FAQ
Quelles étapes du SDLC en profitent le plus ?
Le code et la découverte affichent les gains les plus rapides, car l’IA produit du code, des exigences et des prototypes en une fraction du temps habituel. La revue de code et la maintenance suivent, l’IA prenant en charge le premier passage et l’entretien courant. L’architecture, la validation de la sécurité et les décisions de mise en production en profitent le moins et restent entre les mains des ingénieurs seniors.
Le code généré par IA est-il sûr en production ?
Il peut l’être, dès lors qu’il passe les mêmes contrôles que le code écrit par des humains : revue par les pairs, analyse de sécurité automatisée et tests écrits à partir des exigences réelles. Les résultats d’IA non relus contiennent souvent de la logique dupliquée, une validation des entrées insuffisante ou des dépendances inventées. La sécurité vient donc du processus qui entoure l’outil.
Comment un partenaire de développement doit-il utiliser l'IA ?
Un partenaire fiable utilise l’IA pour la découverte, le code, la revue de code, les tests et la maintenance, et conserve un point de contrôle humain à chaque étape. Chez Redwerk, cela passe par des outils comme Claude Code, OpenAI Codex, Cursor et GitHub Copilot, chaque modification produite par IA faisant l’objet d’une revue humaine et de contrôles de sécurité. Le code propriétaire s’exécute sur des modèles privés ou sur site lorsque le client l’exige.
Découvrez comment nous avons transformé un produit legacy en plateforme de croissance pilotée par l'IA : le projet Evolv, plus de 20 mises en production avec une équipe de 9 personnes