
Sports Events Crawler
 Sports Events Crawler
Le client est une entreprise fournissant des solutions logicielles professionnelles pour le sport.
Tous les clientsDéveloppement de produit
Redwerk a créé cette solution automatisée de crawling de tournois sportifs à partir de zéro. Notre équipe professionnelle a œuvré à chaque étape du processus : analyse, conception, développement, test, déploiement, maintenance et support.
En savoir plusExploitation de données
Nous effectuons le scraping de sites Web et d'API de réseaux sociaux comme Big Data après leur traitement automatique pour restituer les sites Web archivés aux utilisateurs.
En savoir plusDéfi
L’entreprise cliente fournit le savoir-faire nécessaire pour aider les opérateurs sportifs à attirer des événements tels que des tournois locaux, régionaux et nationaux. Bien que ses solutions logicielles personnalisées utilisent une technologie de pointe, toutes les étapes du processus n’étaient pas optimisées. La recherche et l’acquisition de données, par exemple, reposaient sur un processus entièrement manuel et nécessitaient donc une refonte radicale. Toute la recherche, le stockage et le traitement des données devaient être effectués manuellement, ce qui n’était efficace que jusqu’à un certain volume de données atteint. Il était donc nécessaire d’automatiser ce flux de travail, et c’est là que les experts en logiciels flexibles de Redwerk sont entrés en scène.
Notre tâche consistait à automatiser l’algorithme manuel d’origine utilisé par le client, qui était structuré plus ou moins comme suit :
- Recherche de mots-clés.
- Compilation des spécifications et des résultats de recherche : terme de recherche, date de recherche, page de recherche, titre, URL, type, extrait, image du cache, détails du cache.
- Extraction des informations les plus importantes des extraits, titres, URL, etc. Attribution de celles-ci au résultat de recherche associé.
- Reconnaissance et tri des données extraites en catégories.
En bref : Redwerk a été chargé de développer une solution combinant des recherches Web automatisées et du web crawling. De plus, nous devions construire une solution de stockage de données afin de pouvoir trier les informations et exécuter des requêtes.
Pour l’utilisateur final, cela signifie que le logiciel permet désormais de trouver plus facilement des tournois et des événements, et d’obtenir toutes les informations pertinentes sur les tournois et les coordonnées.
Notre recherche
Redwerk a été confronté à une tâche difficile, car toutes les informations devaient être trouvées, analysées et structurées automatiquement. Cela a rendu difficile l’application d’approches déterministes pour la récupération rapide d’informations. Les méthodes d’analyse requises auraient été très complexes à mettre en œuvre, et il est vite apparu que les algorithmes déterministes n’étaient pas adaptés au traitement de pages aux structures aléatoires.
Ce n’est qu’en modifiant le point de départ initial, en supposant qu’il existe un nombre fini de sources à partir desquelles les informations doivent être extraites, qu’une telle approche devient justifiée en raison de sa simplicité et de sa détermination relatives. Bien que l’exploration de données (data-mining) d’informations aléatoires soit une tâche très intéressante et puisse apporter certains avantages, elle ne semblait pas adaptée à cette solution technique particulière. Si l’application n’était pas en mesure de garantir qu’une certaine quantité de données soit trouvée avec une grande précision, elle serait inutile.
L’équipe de Redwerk a évalué diverses approches pour relever ce défi logiciel.
Exploration de données (Data-Mining)
Cette méthode aurait constitué une automatisation directe du flux de travail existant du client. Pour extraire des données, cette méthode nécessitait l’analyse, la compréhension et l’interconnexion de parties du langage naturel. Alors que les humains voient des noms, des verbes, des noms propres, des adresses, etc. sur une page Web, les machines ne voient que des chaînes de caractères et des nombres. Construire un système auto-apprenant capable de comprendre le langage naturel de manière approfondie est l’une des tâches les plus difficiles en informatique.
Même en considérant un système beaucoup plus simple pour cette solution particulière, qui serait progressivement « enseigné » pour collecter des données à partir de différents types de sites Web via une interface simple, cette approche n’a tout simplement pas semblé fonctionner pour notre client.
Avantages :
- Solution la plus avancée et prospective, grandes quantités de données collectées au fil du temps
Inconvénients :
- Mise en œuvre longue
- Algorithmes complexes
- Consommation intensive de ressources
- Solution la plus coûteuse
Réseaux sociaux
Les réseaux sociaux sont extrêmement populaires et disposent d’une audience massive, c’est pourquoi ils deviennent de plus en plus populaires auprès des annonceurs souhaitant attirer l’attention sur des événements spécifiques. En tant que réseau social le plus populaire au monde, Facebook a été choisi comme objet de notre recherche. Nous avons évalué la manière dont ce type d’événement était largement annoncé sur les réseaux sociaux, la quantité de données utiles qui pouvait être récupérée, et à quel point ces données seraient fragmentées/fiables.
Les résultats de notre étude sur Facebook ont été majoritairement positifs. De nombreux tournois sportifs sont publiés sur Facebook, et de nouveaux événements sont constamment ajoutés. Grâce à l’API de Facebook, il est facile de collecter et de traiter les données du réseau social.
Avantages :
- Base de données d’événements en croissance rapide
- Collecte et traitement des données faciles via l’API
- Solution la plus simple et la plus rapide à mettre en œuvre
Inconvénients :
- Aucune catégorisation des événements
- Pas particulièrement spécifique au sport
- Informations saisies incorrectement (ville spécifiée comme lieu de l’événement, par exemple)
Agrégation de données
Une autre approche pour collecter des informations sur les événements sportifs à venir consiste à récupérer des informations auprès de sites Web spécialisés dans le sport. Ceux-ci sont conçus pour fournir des informations sur les événements liés au sujet sous une forme pratique, ce qui rend les données obtenues de ces sites très précieuses pour les objectifs de notre client. Certains disposent de systèmes d’abonnement et fournissent des API pour un accès facile aux données, ce qui permet une mise en œuvre rapide de la collecte et du traitement des données.
Cependant, notre recherche s’est concentrée sur un scénario où aucune source de données commerciale n’est utilisée et où autant de données que possible doivent être collectées « gratuitement ». Dans cette optique, nous aurions dû développer des web crawlers pour télécharger, analyser et extraire des données du code source des pages HTML.
Avantages :
- Plus grande quantité de données précises et pertinentes
Inconvénients :
- Approche individuelle requise pour chaque site Web
- L’extraction des données est souvent rendue difficile par les webmasters
- Les coûts et les temps de développement augmentent avec le nombre de sites Web, sauf si des API sont utilisées
Notre solution
Compte tenu des divers avantages et inconvénients des approches susmentionnées, il a été décidé de ne pas utiliser l’une d’elles, mais une combinaison des deux dernières approches : analyse des données Facebook et agrégation de données. L’utilisation d’agrégateurs existants comme source de données principale pour les informations sur les événements à venir semblait être la méthode la plus bénéfique en termes de volume de données précieuses récupérées, si elle était abordée avec soin. Des informations supplémentaires sont également extraites de Facebook par notre solution personnalisée.
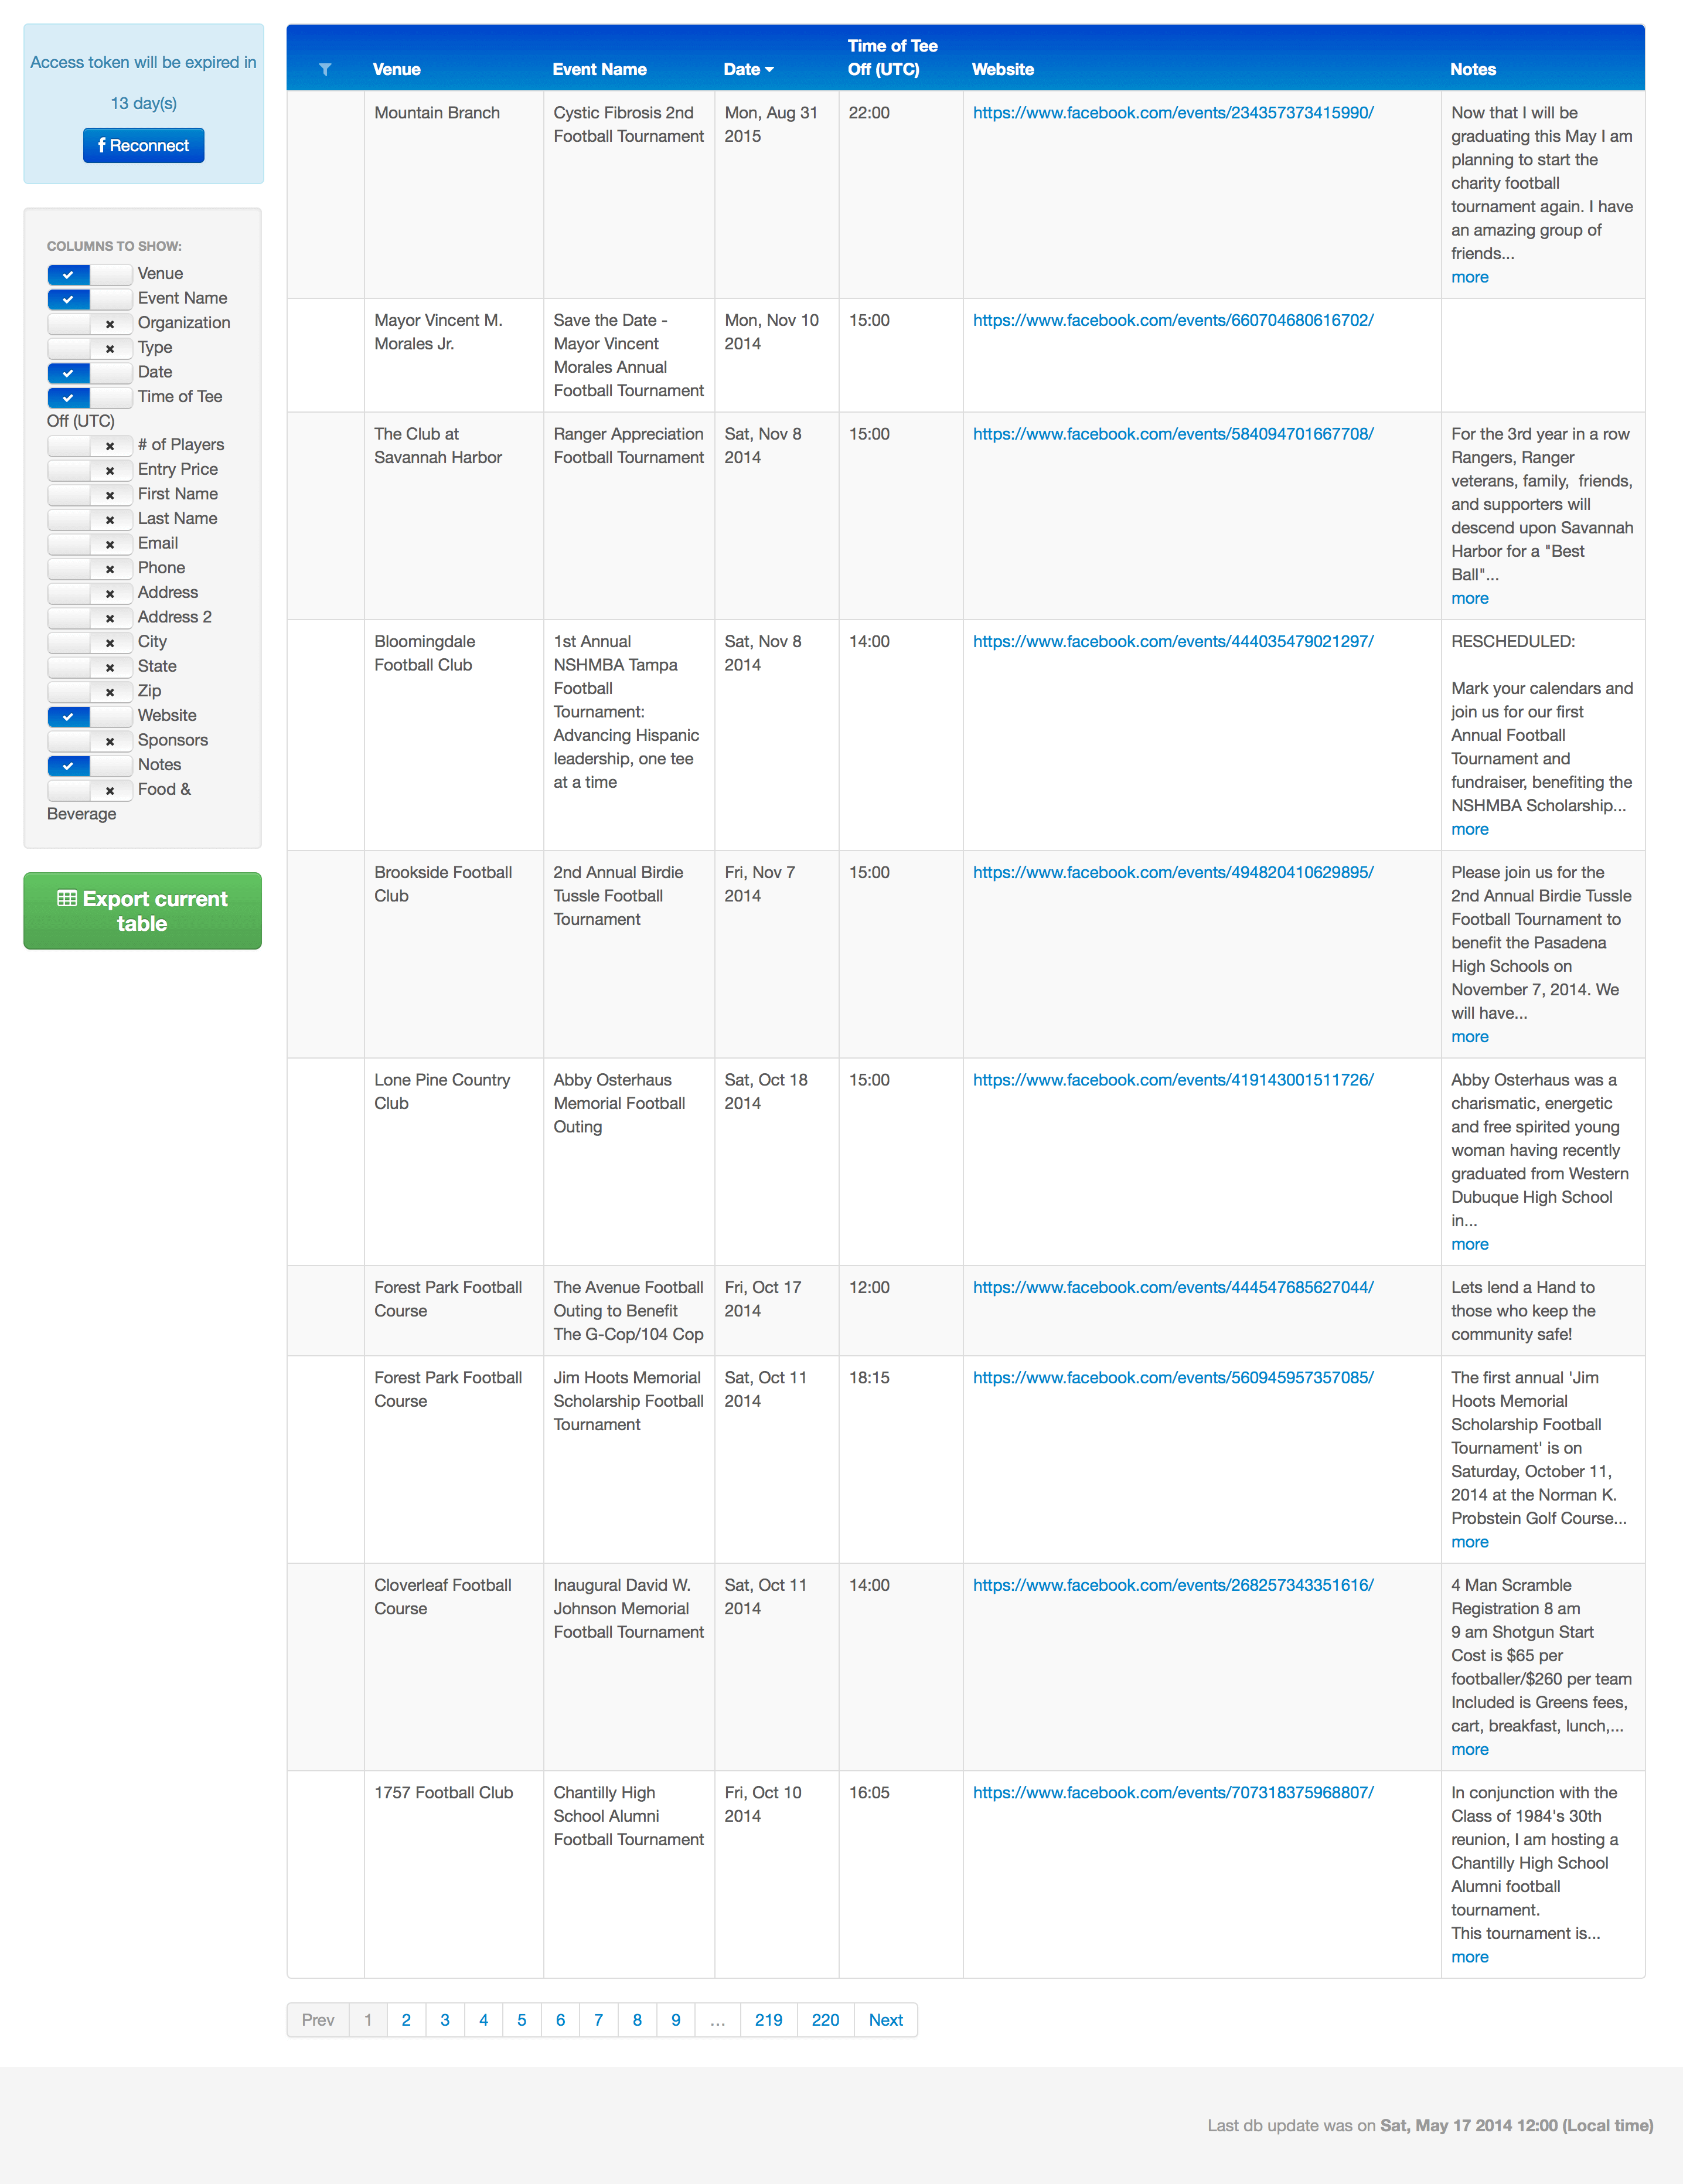
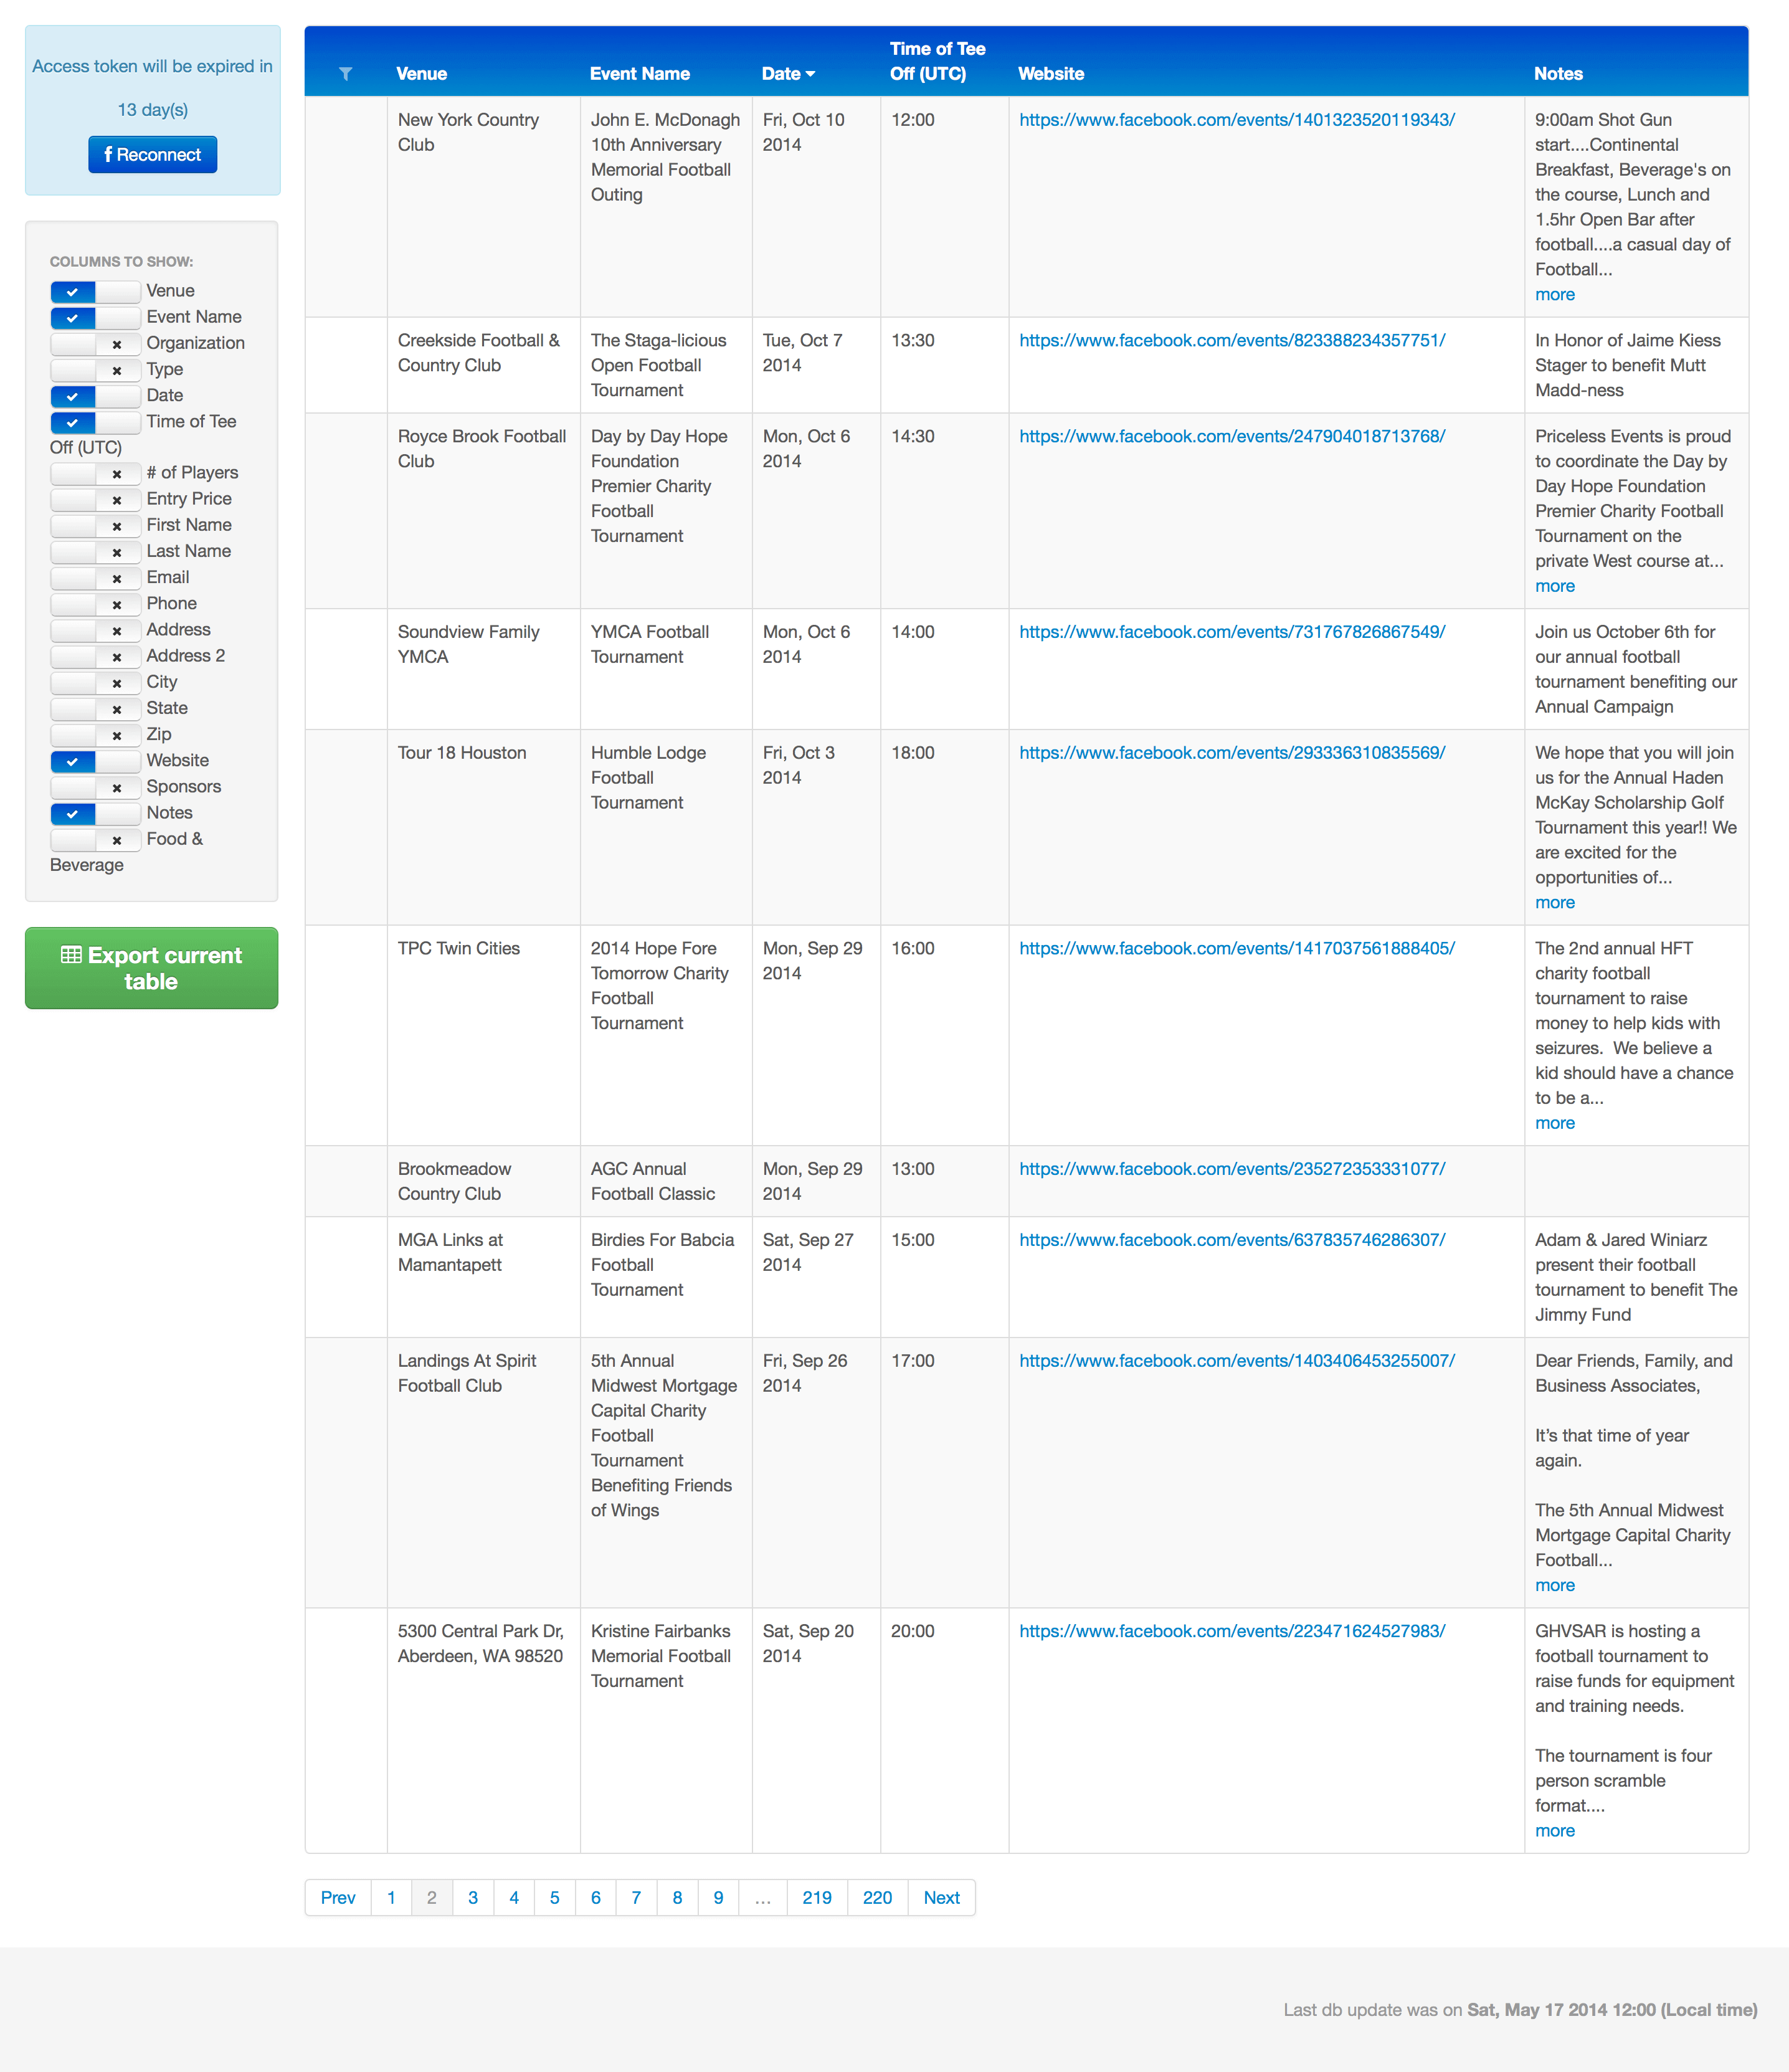
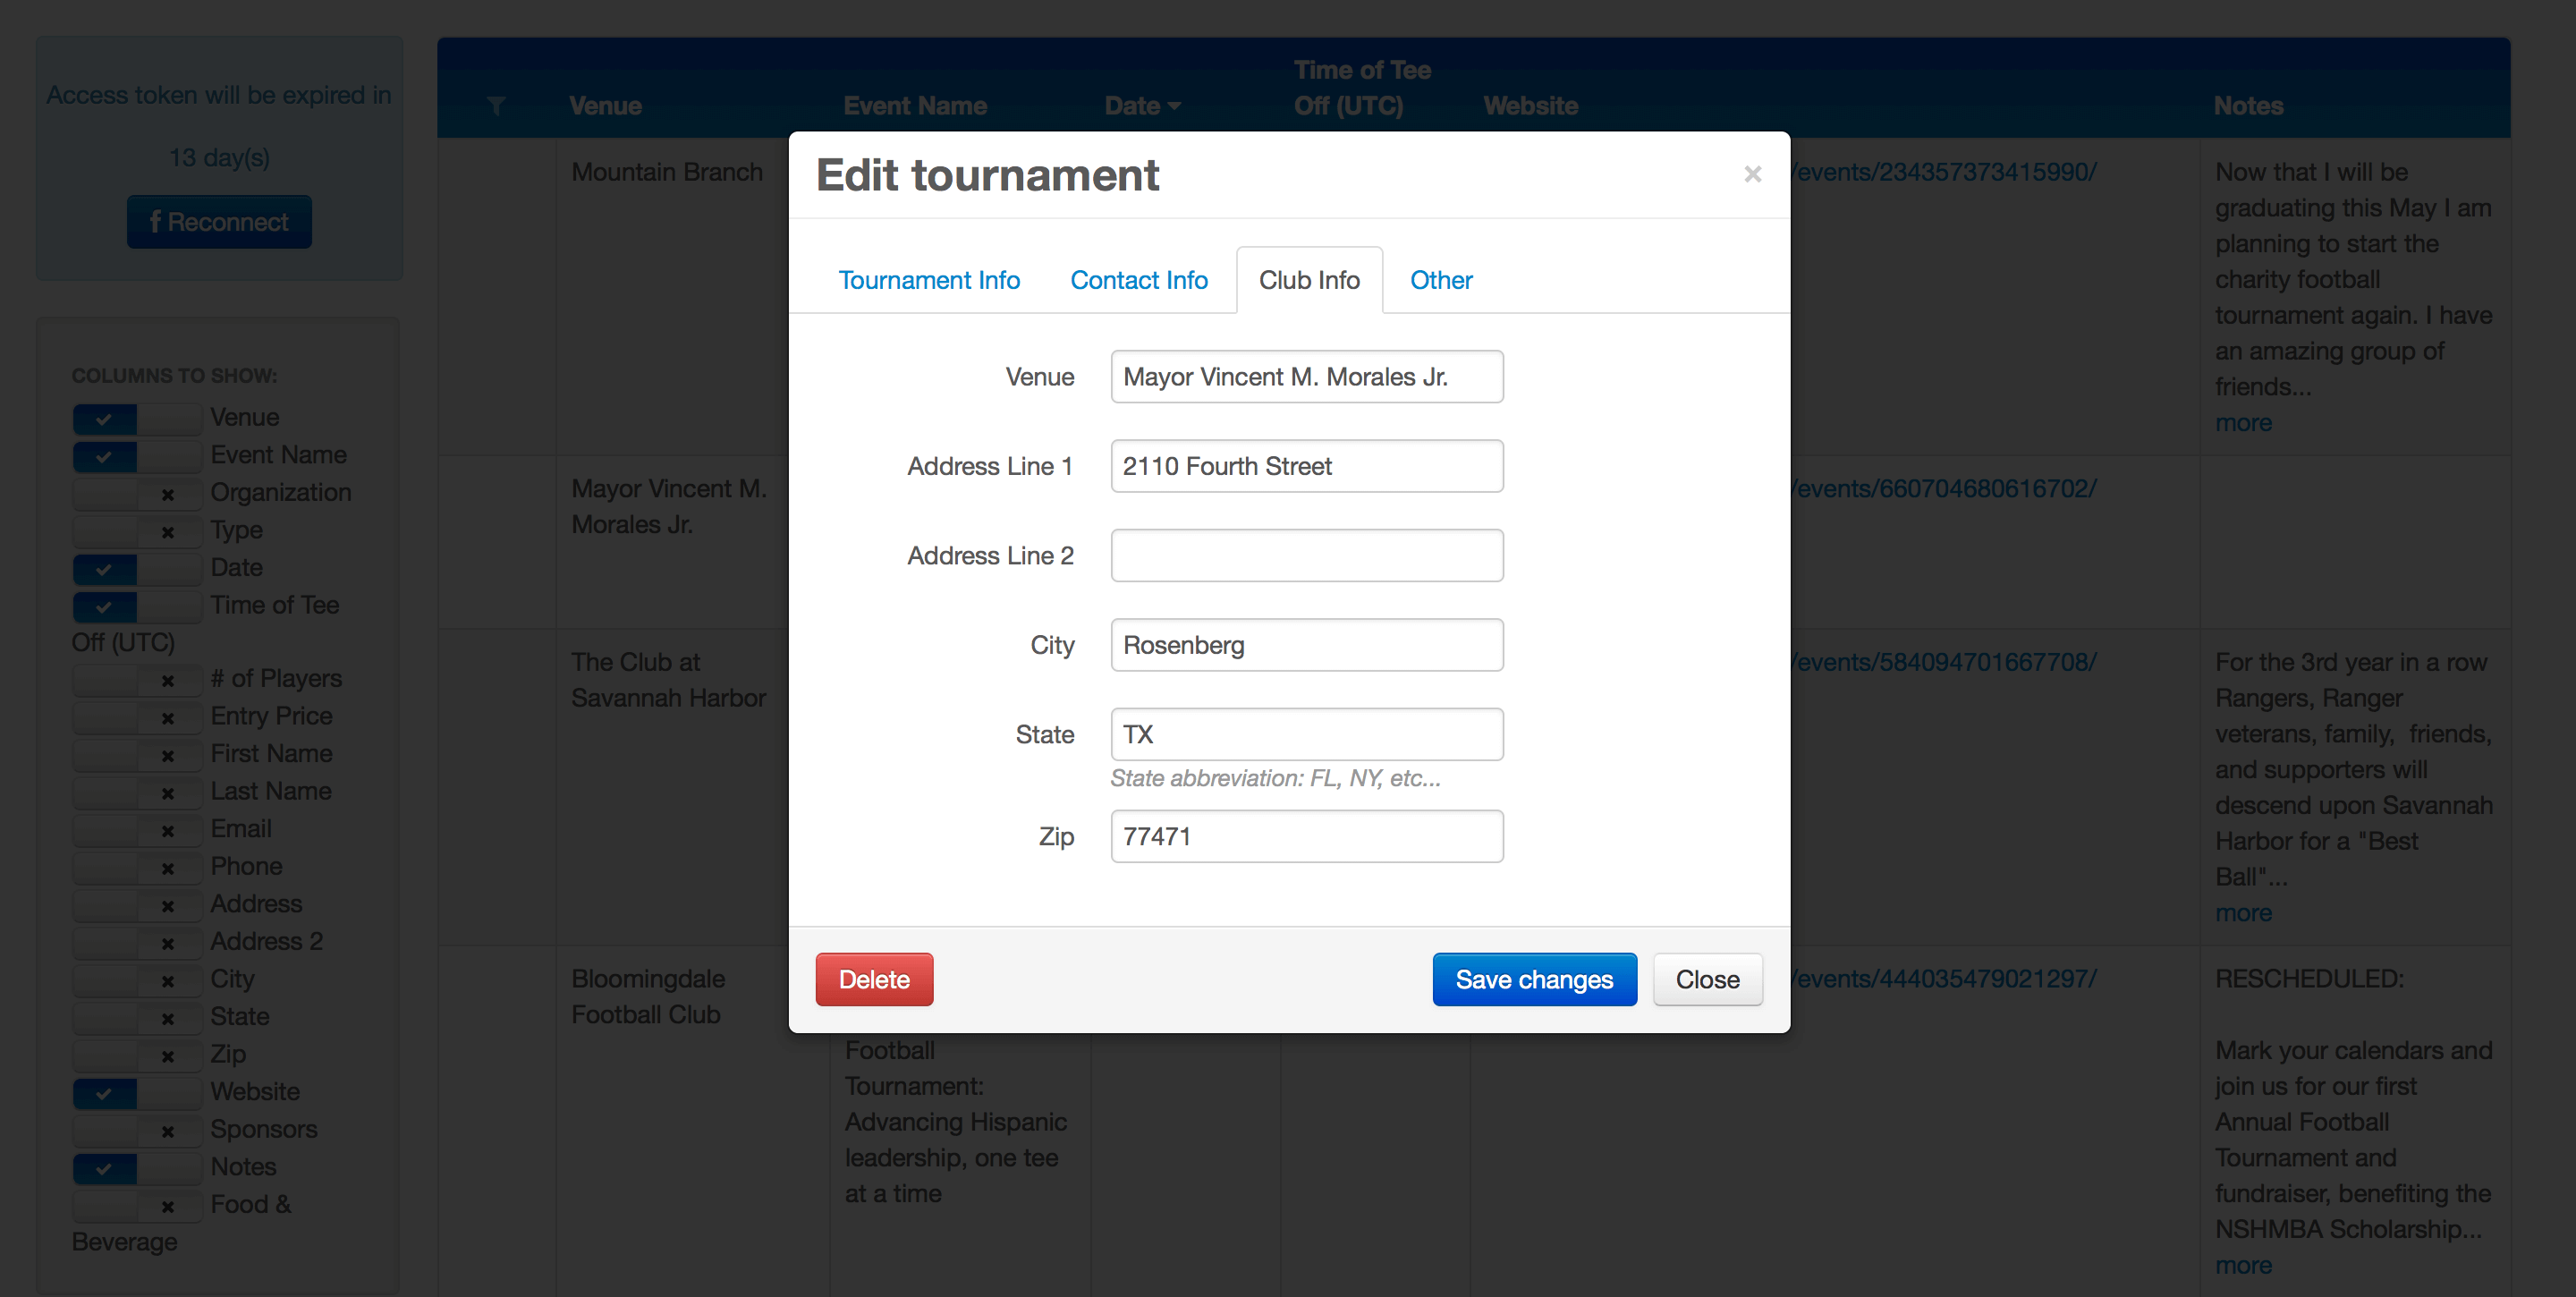
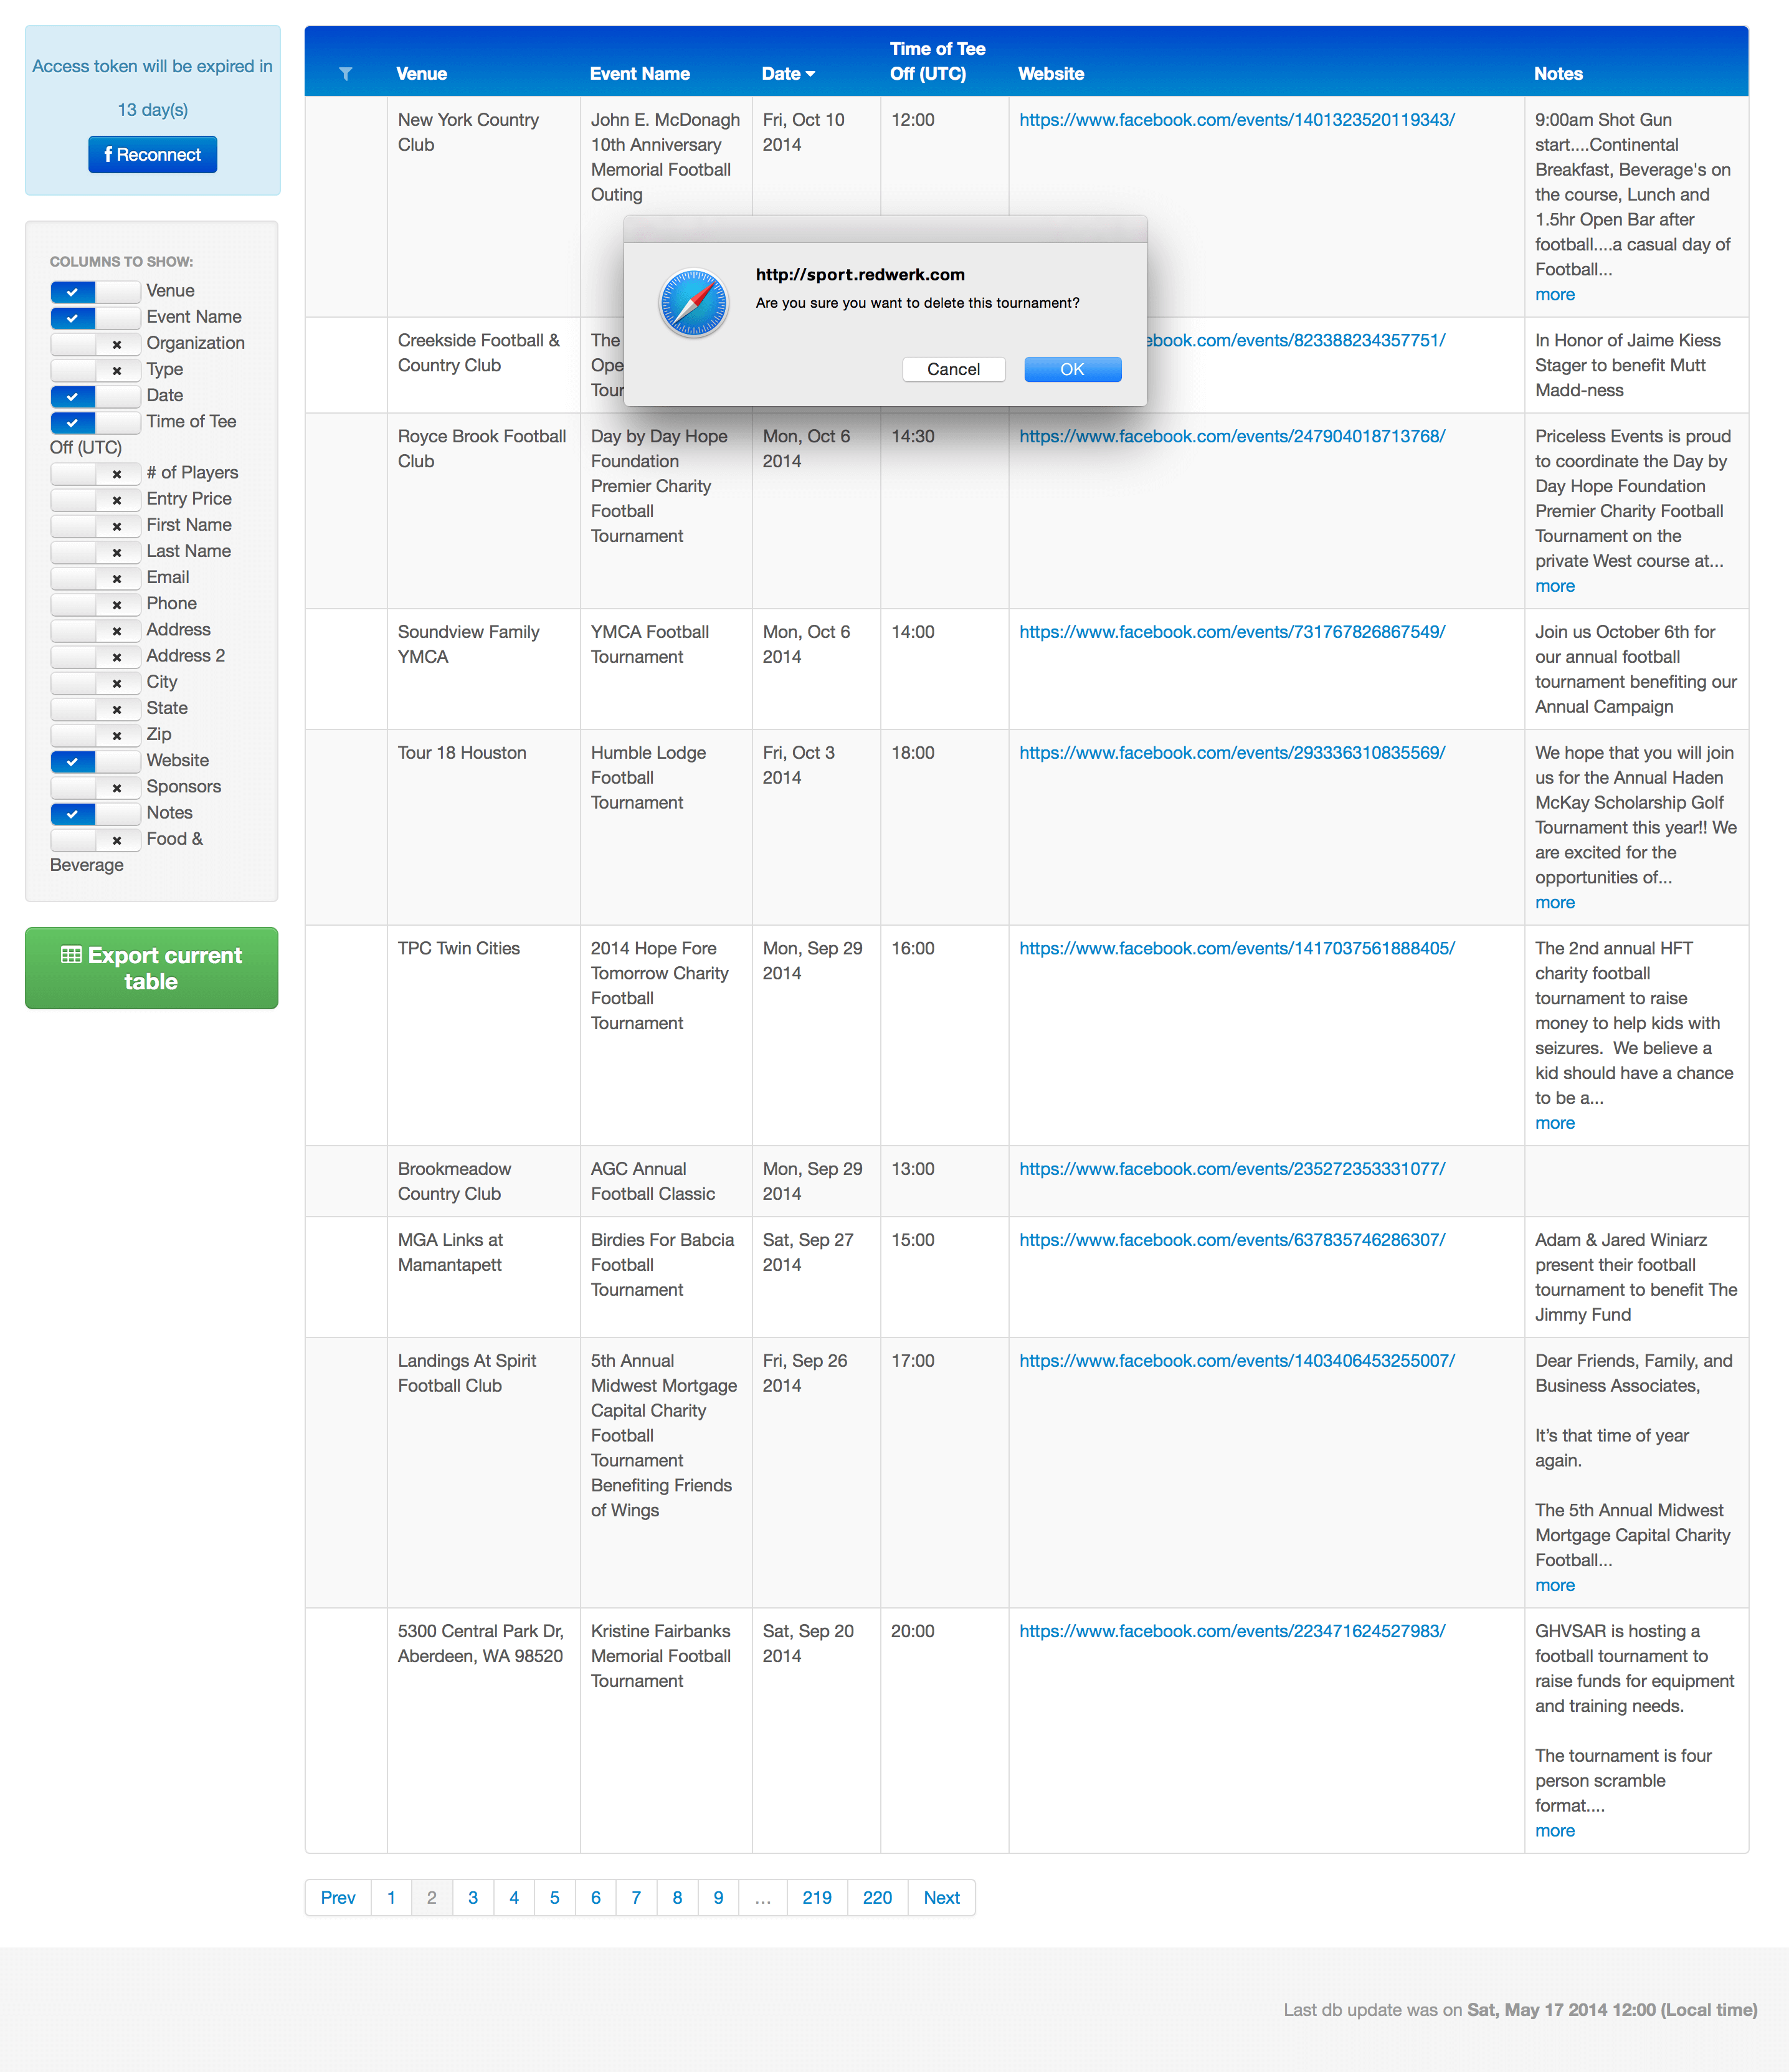
Grâce aux processus automatisés de web crawling mis en œuvre par les ingénieurs de Redwerk, cette solution permet de filtrer et de rechercher des événements sportifs selon divers critères. Elle affiche des liens vers les pages pertinentes d’où l’information a été obtenue (pages d’événements Facebook) et d’autres types d’informations, et elle permet de modifier ou de supprimer facilement des événements spécifiques.
Résultat
L’équipe de Redwerk a rapidement réalisé qu’il était très difficile, coûteux et chronophage de simplement reproduire l’algorithme manuel de notre client avec des processus automatisés. Au lieu de cela, nous nous sommes concentrés sur la mise en œuvre d’une structure de recherche avec un ensemble fixe de sources de données, dont Facebook a été utilisé dans le prototype. Ce type de système était beaucoup plus facile à mettre en œuvre et à maintenir et répondait parfaitement aux exigences initiales.
Avec cette solution, Redwerk a réussi à faire économiser temps et argent à son client, et nos ingénieurs ont trouvé une solution élégante à un problème complexe, dont de nombreux opérateurs sportifs professionnels devraient pouvoir bénéficier à l’avenir.
Vous avez des besoins en web crawling ?
Parlons-enTechnologies
Articles similaires dans le blog
Scala Play vs ASP.NET Web API – Comparaison de frameworks web
Notre entreprise développe des logiciels depuis plus de 12 ans. Et environ la moitié de nos projets sont des systèmes distribués multithread à forte charge. Par conséquent, nos développeurs utilisent des technologies de pointe et les derniers frameworks dans ce processus. Dans c...
En savoir plus
Comment parcourir un site web protégé : analyse approfondie
Les web crawlers sont des programmes destinés au téléchargement et au traitement en masse de contenu Internet. Ils sont aussi souvent appelés « robots d’indexation », « spiders » ou simplement « bots ». Dans leur essence, un crawler effectue les mêmes actions qu’un navigateur web...
En savoir plus
Scala vs Java 8 : 10 différences importantes
De nombreux développeurs Java adorent Scala et le préfèrent à Java, que ce soit pour de nouveaux projets, des composants de projets Java existants ou même des parties critiques en termes de performances de modules Java existants. Grâce à cela, Scala s'est fait une place dans le ...
En savoir plusImpressionné ?
Engagez-nousAutres études de cas
Animatron
La fonctionnalité étendue du créateur d'animations pour startups reconnue par des médias d'affaires tels qu'Entrepreneur, MonsterPost et Freelancer
Linktiger
Outil de vérification des liens brisés créé, capable d'analyser plus de 3 millions de liens et utilisé par de grands noms tels que Hosting.com, Microsoft et le Département des Transports des États-Unis
PageFreezer
Développement d'une solution SaaS de marketing de sites web et de médias sociaux, sélectionnée comme finaliste du Red Herring Top 100 Global