Votre modèle affiné n’est aussi performant que les décisions qui le sous-tendent.
La personnalisation d’un modèle présente des défis cachés :
- savoir s’il faut affiner plutôt qu’améliorer vos prompts ou ajouter de la récupération
- construire un jeu de données suffisamment propre et équilibré pour en tirer des leçons
- et empêcher le modèle de perdre ses capacités générales pendant qu’il acquiert votre compétence spécifique.
Les services professionnels de fine-tuning LLM doivent aller au-delà d’un simple entraînement de base. Redwerk vous aide à choisir la meilleure approche, à préparer un jeu de données équilibré et à protéger les capacités fondamentales du modèle. Nous testons également ses performances sur de nouvelles données, vérifions les licences et déployons un modèle conçu pour le trafic réel.
En tant que votre entreprise de fine-tuning LLM, nous nous occupons de l’essentiel. Vous obtenez un modèle fiable qui conserve ses forces générales, maîtrise vos tâches spécifiques et produit des résultats avérés.
Fine-Tuning vs RAG vs Distillation de modèle : lequel vous faut-il ?
Services de fine-tuning LLM conçus autour de vos objectifs
Audit de préparation au fine-tuning
Nous vérifions si le fine-tuning est la bonne approche. Dans le domaine du développement LLM, une meilleure formulation des prompts ou une meilleure récupération d’informations résolvent souvent le problème à une fraction du coût. Vous obtenez une recommandation claire avant de dépenser pour l’entraînement.
Fine-Tuning supervisé et par instructions
Nous entraînons votre modèle sur des exemples entrée-sortie afin qu’il suive les instructions et produise le format exact dont vous avez besoin, qu’il s’agisse de JSON structuré, d’une réponse de support ou d’une étiquette de classification.
Alignement des préférences
Lorsque la qualité d’une sortie est subjective, nous affinons le modèle sur la base des préférences humaines. Cela façonne l’utilité, le ton et la conformité aux politiques dans des cas difficiles à capturer uniquement avec des étiquettes fixes.
Adaptation au domaine
Nous entraînons davantage le modèle sur votre corpus spécialisé afin qu’il comprenne la terminologie et les concepts de votre domaine, réduisant ainsi l’effort de prompt requis pour chaque requête.
Fine-Tuning économe en paramètres
Nous utilisons des méthodes basées sur des adaptateurs qui ne mettent à jour qu’une fraction des paramètres du modèle. Vous obtenez la plupart de la qualité d’un fine-tuning complet à un coût beaucoup plus bas en calcul, mémoire et temps.
Distillation de modèle
Nous utilisons la distillation de modèle pour réduire un modèle grand ou affiné en un modèle moins coûteux qui sert des prédictions plus rapidement, afin que vous conserviez la plupart de la qualité tout en réduisant votre facture d’inférence.
Cas sélectionnés
Recruit Media
Evolv
Vous cherchez à transformer l'IA générique en votre avantage concurrentiel ?
Parlons-enNotre flux de travail de fine-tuning LLM
1. Phase de découverte
Nous commençons par définir votre cas d’utilisation exact, établir les prompts de référence et évaluer si le fine-tuning, le RAG ou la distillation est la meilleure solution technique et financière.
2. Ingénierie et curation des données
De mauvaises données corrompent les modèles. Nous extrayons, nettoyons, étiquetons et formatons vos données d’entreprise en ensembles d’entraînement, de validation et de test de haute qualité, en garantissant une séparation stricte entre l’entraînement et le test.
3. Sélection de la méthode et de l’infrastructure
Nous associons la bonne technique (SFT, LoRA, DPO) au bon framework et à l’environnement de calcul sécurisé, en équilibrant habilement le coût, la confidentialité des données et la vitesse d’entraînement.
4. Entraînement et itération du modèle
Nos ingénieurs IA exécutent les tâches d’entraînement, surveillent activement les courbes de perte, optimisent les hyperparamètres et créent des points de contrôle d’époque pour prévenir le surapprentissage et l’oubli catastrophique.
5. Évaluation rigoureuse
Nous évaluons le modèle affiné par rapport à des jeux de données réservés et effectuons des tests de régression approfondis, ainsi qu’une évaluation de la précision factuelle, de la sécurité et de la conformité stricte du format.
6. Déploiement et surveillance
Nous déployons en toute sécurité votre modèle affiné en production via des points de terminaison optimisés, en mettant en place une observabilité continue pour le coût, la latence et la dérive de la qualité afin d’assurer la stabilité à long terme.
Pourquoi les équipes font confiance à Redwerk
 Stratégie IA adaptée
Nous commençons par tester des alternatives plus simples. De meilleurs prompts, des exemples en contexte, le RAG, des changements de flux de travail ou un modèle conventionnel plus petit peuvent résoudre le problème sans fine-tuning. Vous recevez une recommandation liée à des preuves, aux coûts et à la valeur commerciale.
 Expertise IA de bout en bout
Le fine-tuning n’est pas seulement une tâche d’ingénierie IA. Notre équipe de livraison rassemble des ingénieurs IA, des spécialistes des données, des développeurs de logiciels, des ingénieurs QA, des professionnels DevOps, des concepteurs et des chefs de projet axés sur le produit.
 Talents d’ingénierie seniors
Redwerk travaille avec des ingénieurs expérimentés capables de raisonner sur l’architecture, la qualité des données, l’évaluation, la sécurité et les contraintes de production, et pas seulement d’exécuter un script d’entraînement. Nous employons plus de 90 membres d’équipe permanents.
 Évaluation avant déploiement
Nous définissons le benchmark avant le début de l’entraînement. Le modèle affiné doit surpasser la référence sur des exemples réservés et pertinents pour la tâche, sans introduire de régressions inacceptables en matière de sécurité, de capacité générale, de latence ou de coût.
 Contrôle des coûts de production
Un modèle n’est pas réussi s’il fonctionne bien dans un notebook mais est trop lent ou trop cher pour les utilisateurs réels. Nous évaluons les ressources d’entraînement, l’architecture des points de terminaison, le traitement par lots, la mise à l’échelle automatique, la quantification, la taille du modèle et le volume d’inférence attendu.
 Confiance des entreprises mondiales
La qualité de nos logiciels est reconnue internationalement, ce qui nous a valu une place sur la liste Global Outsourcing 100 de l’IAOP. Des géants du Fortune 500 aux startups agiles qui sont acquises par des leaders du marché, des entreprises du monde entier font confiance à notre expertise en ingénierie.
Nous avons fait appel à Redwerk car nous ne disposions ni des ressources ni de l'expertise internes nécessaires pour développer un produit basé sur le cloud. Ils sont incroyablement professionnels, réactifs et très communicatifs. Nous avons lancé le produit l'année dernière et nous continuons de travailler avec eux. Je les recommanderais sans hésiter.

J'ai été incroyablement impressionné par la capacité de Redwerk à couvrir tout le spectre des spécialités. Ils ont des développeurs incroyables, des chefs de projet incroyables, et ils savent rendre l'expérience de création d'une application vraiment fluide.
Il y a un réel engagement à accomplir la tâche dans les délais impartis. La qualité du travail est très élevée. Je recommanderais sans hésiter de travailler avec l'équipe de Redwerk.
Technologies que nous utilisons
Modèles et plateformes IA
Entraînement et alignement
Évaluation et suivi des expériences
Services au-delà du fine-tuning LLM
Automatisation IA
Nous automatisons les flux de travail répétitifs tels que la gestion des documents, le support, la génération de rapports et les approbations. Pour garantir des opérations quotidiennes fiables, nous combinons des LLM, des règles métier, des intégrations système et une supervision humaine.
Développement d’agents IA
Nous concevons des agents IA axés sur les tâches avec un accès contrôlé aux outils, une mémoire, des autorisations, une validation et une surveillance, aidant les entreprises à automatiser les flux de travail en plusieurs étapes sans donner aux modèles une autorité dangereuse ou illimitée.
Développement d’API
Nous développons des API sécurisées qui connectent les modèles affinés à vos produits, bases de données, systèmes internes et services tiers tout en appliquant la validation, les autorisations, les limites de débit, la journalisation et le contrôle de version.
Développement d’applications cloud
Nous concevons et construisons des applications cloud évolutives autour de vos modèles IA, y compris des API, l’authentification, les files d’attente, le stockage, la surveillance, la mise à l’échelle automatique, le basculement, les contrôles de coûts et les pipelines de déploiement sécurisés.
FAQ
1. Quand faut-il affiner un LLM ?
Le fine-tuning est pertinent lorsque vous avez besoin d’un comportement cohérent, d’un langage spécifique au domaine, de sorties structurées ou de meilleures performances sur une tâche spécifique. Pour des connaissances changeant fréquemment, le RAG peut être une meilleure option.
2. Combien de données me faut-il pour affiner un modèle ?
Moins que ce que la plupart des gens pensent. Un modèle peut souvent être affiné sur quelques centaines à quelques milliers d’exemples spécifiques à la tâche, car il s’appuie sur ce que le modèle de base sait déjà. Ce qui importe bien plus que le volume, c’est la qualité, nous nous concentrons donc sur des exemples propres, cohérents et bien équilibrés.
3. Le fine-tuning va-t-il rendre le modèle moins performant sur des tâches générales ?
C’est possible, si cela est fait négligemment — un problème appelé oubli catastrophique, où le modèle acquiert votre compétence spécifique mais perd sa capacité plus large. Nous nous en protégeons grâce à la bonne méthode, à un équilibre attentif des données et à des évaluations réservées qui vérifient les performances générales aux côtés de votre tâche avant que quoi que ce soit ne soit livré.
4. Comment prouvez-vous que le modèle affiné est réellement meilleur ?
Nous le mesurons par rapport à un ensemble de test réservé et à votre tâche réelle, pas seulement au score d’entraînement. Vous obtenez un rapport clair avant et après comparant le modèle affiné au modèle de base, ainsi que des tests de régression que vous pouvez continuer à utiliser pour détecter toute baisse de qualité ultérieure.
5. Qui possède le modèle affiné et les données sur lesquelles il est entraîné ?
Vous. Nous vérifions également que le modèle de base que vous avez choisi et les données d’entraînement permettent votre utilisation commerciale prévue, afin que vous évitiez les surprises de licence plus tard. Les termes spécifiques de propriété et de transfert sont clairement énoncés dans l’accord avant le début des travaux.
À lire dans notre blog
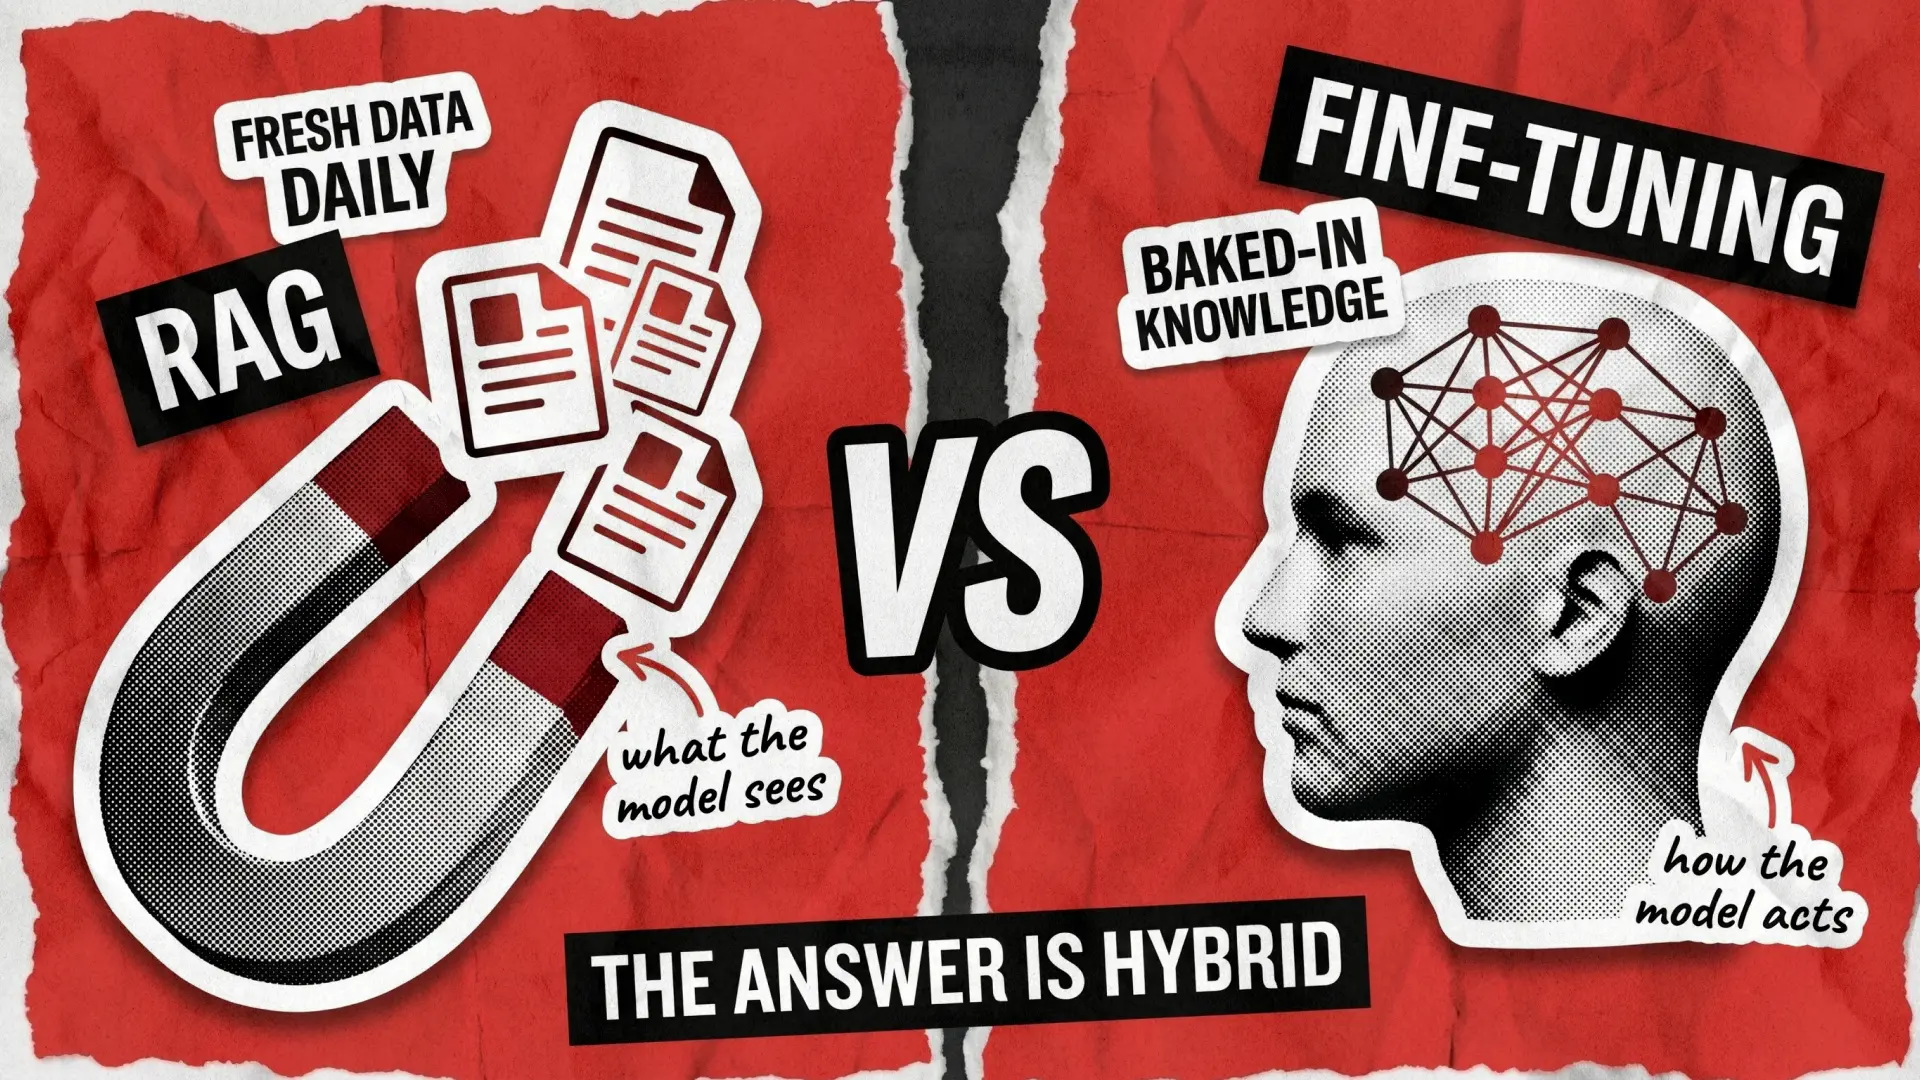
Ajustement fin vs RAG : un cadre décisionnel
7 meilleurs frameworks LLM en 2026 : lequel utiliser dans n’importe quelle situation
Optimisation de l’inférence des LLM pour les charges de travail réelles
Conseil en implémentation IA : pourquoi 70 % des déploiements de LLM stagnent au stade pilote et comment franchir le fossé
Besoin d'un modèle qui comprend votre domaine ?
Parlez-nous de votre cas d'utilisation et de vos données, et nous vous indiquerons la meilleure voie vers la production.
250+
PROJETS RÉUSSIS LIVRÉS90+
PROFESSIONNELS IA21
ANNÉES EN ACTIVITÉ65%
COLLABORATIONS DEVENUES À LONG TERME