Les démos d’OpenClaw sont incroyables. Configurez un agent le samedi, connectez-le à WhatsApp, et soudain il gère votre calendrier et rédige des e-mails. On se croirait dans le futur.
Puis vient le lundi. L’agent invente une réunion. Envoie un e-mail au mauvais contact. Oublie ce que vous lui avez dit la veille. Gartner prédit que 40 % des applications d’entreprise intégreront des agents d’IA spécifiques à une tâche d’ici fin 2026, mais avertit également que plus de 40 % des projets d’IA agentiques pourraient être annulés d’ici 2027 en raison d’un ROI incertain et de contrôles inadéquats.
L’écart entre « ça marche sur ma machine » et « ça fait tourner notre entreprise » est l’endroit où la plupart des cas d’utilisation d’OpenClaw échouent. Cet article couvre 7 cas d’utilisation que la communauté est en train de construire, et ce qu’il faut, architecturalement, pour passer de la démo à la production. Nous développons des systèmes basés sur l’IA pour nos clients depuis 2015, et les schémas ici proviennent des mêmes écueils que nous aidons les équipes à éviter sur les frameworks LLM et les architectures d’agents.
Pourquoi la plupart des projets OpenClaw échouent après la démo
Le problème est de supposer qu’un prototype équivaut à un produit.
Une démo fonctionne sur une seule machine, pour un seul utilisateur, avec des entrées préparées. La production implique des sessions simultanées, des requêtes imprévisibles, des intégrations réelles et des cas limites que la démo n’a jamais testés. Les données McKinsey montrent que 62 % des organisations expérimentent des agents d’IA, mais seulement 23 % ont déployé à l’échelle ne serait-ce qu’un seul cas d’utilisation. La raison : l’agent fonctionne, mais le système qui l’entoure, non.
Voici ce qui casse généralement : l’état de la session disparaît entre les conversations. Les prompts qui fonctionnaient en test produisent des absurdités avec des entrées réelles. Il n’y a pas de surveillance, donc les échecs sont silencieux. Pas de logique de repli, donc un seul appel API échoué plante le workflow. Et la sécurité d’OpenClaw est ignorée avec des identifiants en clair et des compétences communautaires installées sans examen.
À ce stade, vous ne construisez plus un script, vous commencez à construire un système.
7 cas d'utilisation réels d'OpenClaw (Ce qui fonctionne vs. Ce qu'il faut pour passer à l'échelle)
Nous les avons classés du plus courant au plus complexe. Chacun suit la même structure : ce que fait la démo, ce qui casse en production, et ce que vous devez réellement construire. Pour chaque cas d’utilisation, nous détaillons ce qui fonctionne immédiatement, où cela échoue dans des conditions réelles, et ce que vous devez construire pour que cela tienne.
Agent de support client IA
Connectez OpenClaw à vos documents, pointez-le vers WhatsApp ou Slack, et il répond aux questions des clients en 30 minutes. C’est le point de départ le plus populaire, et en fait, le premier à s’effondrer sous le trafic réel.
En production, ces agents ont tendance à échouer de manière prévisible :
- Hallucinations – l’agent invente des politiques qui n’existent pas, puis les défend avec assurance.
- Aucun chemin d’escalade lorsque le bot est bloqué, ce qui entraîne des boucles pour les clients.
- Ton incohérent entre les sessions, passant du formel au décontracté en pleine conversation.
- Aucun lien avec votre système de ticketing, ce qui signifie que les problèmes résolus ne sont suivis nulle part.
Rendre cela prêt pour la production commence par un pipeline RAG ancré dans des documents versionnés, puis des intégrations API avec Zendesk ou Intercom pour le routage des tickets. Vous avez besoin d’une transition humaine déclenchée par des seuils de confiance, de garde-fous de ton intégrés dans le prompt système, et d’une surveillance qui suit les taux de résolution et les indicateurs d’hallucination.
Assistant de connaissance interne
Votre équipe interroge l’agent sur les politiques de l’entreprise, les étapes d’intégration, ou les spécifications des produits. Il extrait les réponses d’une base de connaissances interne. Cela fait gagner des heures chaque semaine aux équipes RH et opérationnelles, jusqu’à ce que quelqu’un reçoive une information obsolète et prenne une décision basée sur celle-ci.
Scénario réel : un nouvel employé pose une question sur la politique de congés payés. L’agent cite avec assurance la version de l’année dernière car personne n’a réindexé le manuel mis à jour. Il n’y a pas de contrôle d’accès — un stagiaire peut se renseigner sur la rémunération des dirigeants. Les documents dispersés sur Google Drive, Notion et Confluence font que l’agent ne voit qu’une partie de l’image.
Pour rendre cela fiable, vous avez besoin de :
- Pipelines d’indexation automatisés qui re-parcourent les sources selon un calendrier.
- Permissions basées sur les rôles afin que l’agent respecte qui pose la question.
- Stratégies de découpage adaptées à vos types de documents.
- Attribution de la source dans chaque réponse afin que les employés puissent vérifier.
Vous aurez besoin de compétences personnalisées en TypeScript pour connecter vos sources de données spécifiques et appliquer la logique d’accès.
Automatisation des campagnes de vente
OpenClaw recherche des prospects, rédige des messages personnalisés et les envoie par e-mail ou LinkedIn. Un membre de la communauté a signalé avoir économisé plus de 10 heures par semaine sur les campagnes sociales uniquement. La démo est addictive jusqu’à ce que vous regardiez ce qu’elle envoie réellement.
Le problème commence avec la personnalisation. « J’ai remarqué que votre entreprise fait X » répété 500 fois est un modèle avec une variable. Le CRM reste déconnecté, ce qui entraîne une duplication des efforts pour les commerciaux. Sans flux d’approbation, l’agent envoie des messages qui violent la conformité avant que quiconque ne les examine.
La production implique une intégration CRM avec HubSpot ou Salesforce pour la déduplication et le suivi du pipeline. Des API d’enrichissement pour les données firmographiques. Des portes d’approbation où un humain examine les envois avant l’envoi. OpenClaw pour les entreprises signifie construire ces couches, où l’agent est le cerveau, mais les intégrations sont le système nerveux.
Pipelines d'extraction et d'enrichissement de données
Pointez l’agent vers des sites Web, des PDF ou des API. Il extrait, structure et retourne des données propres. Idéal pour la recherche de marché, l’analyse concurrentielle et la génération de prospects, par petits lots.
Augmentez l’échelle et les choses se compliquent. Les formats varient selon les sources. Les limites de débit des API tuent les tâches de longue durée. Une seule extraction échouée corrompt le lot. La consommation de jetons explose, une chaîne peut déclencher 5 à 10 appels API par élément, transformant une «automatisation bon marché» en une surprise coûteuse à la fin.
La pipeline de production nécessite :
- Une logique de nouvelle tentative avec backoff exponentiel pour les sources instables.
- Des couches de validation qui rejettent les sorties mal formées avant qu’elles n’atteignent votre base de données.
- Le traitement par lots avec des points de contrôle afin que les échecs ne fassent pas perdre de progrès.
- Le suivi des coûts par exécution de pipeline.
C’est l’automatisation OpenClaw dans toute sa splendeur, mais aussi là où la discipline d’ingénierie compte le plus.
Agent de productivité personnelle
C’est l’expérience open source phare de l’assistant IA personnel, et la raison pour laquelle OpenClaw a atteint plus de 240 000 étoiles GitHub. Gérez votre calendrier, résumez vos e-mails, suivez vos habitudes, contrôlez vos appareils domestiques intelligents, le tout depuis Telegram ou WhatsApp.
Les failles apparaissent en une semaine. L’agent oublie la conversation de la veille car le contexte ne persiste pas correctement. Les anciennes instructions évincent les nouvelles à mesure que la mémoire markdown grandit. Et les limites d’autorisation existent à peine — l’agent traite «lire mon calendrier» et «supprimer mon calendrier» comme le même niveau d’accès.
Pour une utilisation professionnelle quotidienne, vous avez besoin d’intégrations de calendrier et d’e-mail avec des scopes OAuth appropriés. Mémoire persistante avec classement par priorité, pas un fichier markdown plat. Limites d’autorisation dans SOUL.md avec des limites strictes sur les actions destructrices. La configuration d’OpenClaw pour le bricolage personnel prend un après-midi. La rendre fiable pour votre journée de travail demande de l’architecture.
Agent d'assurance qualité et de test IA
L’agent examine le code, détecte les bogues, exécute les suites de tests et rapporte les résultats. Certaines équipes génèrent des cas de test à partir d’histoires d’utilisateurs ou surveillent les environnements de staging 24h/24 et 7j/7. C’est prometteur seulement jusqu’à ce que vous réalisiez que l’agent se note lui-même.
Trois modes d’échec apparaissent de manière constante :
- L’agent « réussit » des tests qui devraient échouer car ses assertions sont probabilistes, pas déterministes.
- Les résultats vivent dans une fenêtre de chat au lieu de votre pipeline CI/CD, donc personne n’agit dessus.
- Les sorties instables érodent rapidement la confiance — l’équipe arrête de vérifier après le troisième faux positif.
La production signifie l’intégration avec GitHub Actions, Jenkins ou GitLab CI afin que les résultats alimentent votre pipeline. Associez des assertions générées par LLM avec des vérifications déterministes. Ajoutez une journalisation structurée et un stockage d’artefacts. L’agent signale les candidats ; les humains prennent la décision.
Automatisation des flux de travail multi-étapes
Pensez Zapier, mais conversationnel et alimenté par l’IA. Une configuration typique : « Lorsqu’un nouveau prospect arrive, enrichissez-le, notez-le, assignez-le à un représentant, rédigez un premier e-mail et enregistrez tout dans le CRM. » Cinq étapes, trois outils, un agent orchestrant tout cela.
C’est aussi le cas d’utilisation le plus fragile. Une étape échoue — disons que l’API d’enrichissement expire — et tout ce qui suit se casse silencieusement. L’agent réessaie indéfiniment ou abandonne au mauvais moment. L’absence de suivi de l’état vous empêche de savoir quelle étape a réussi. La réexécution de la chaîne duplique ce qui a déjà fonctionné.
L’orchestration de qualité production nécessite :
- Le suivi de l’état par étape de workflow, afin que vous sachiez exactement où une exécution s’est arrêtée.
- La gestion des erreurs avec des branches de repli, pas seulement des nouvelles tentatives.
- La journalisation à chaque étape pour le débogage.
- L’idempotence afin que la réexécution d’une étape échouée ne duplique pas les actions.
C’est ainsi que vous utilisez OpenClaw pour l’automatisation réelle des processus métier, et le cas d’utilisation qui exige le plus clairement les développements personnalisés OpenClaw.
Ce qui change lorsque vous passez de la démo à la production
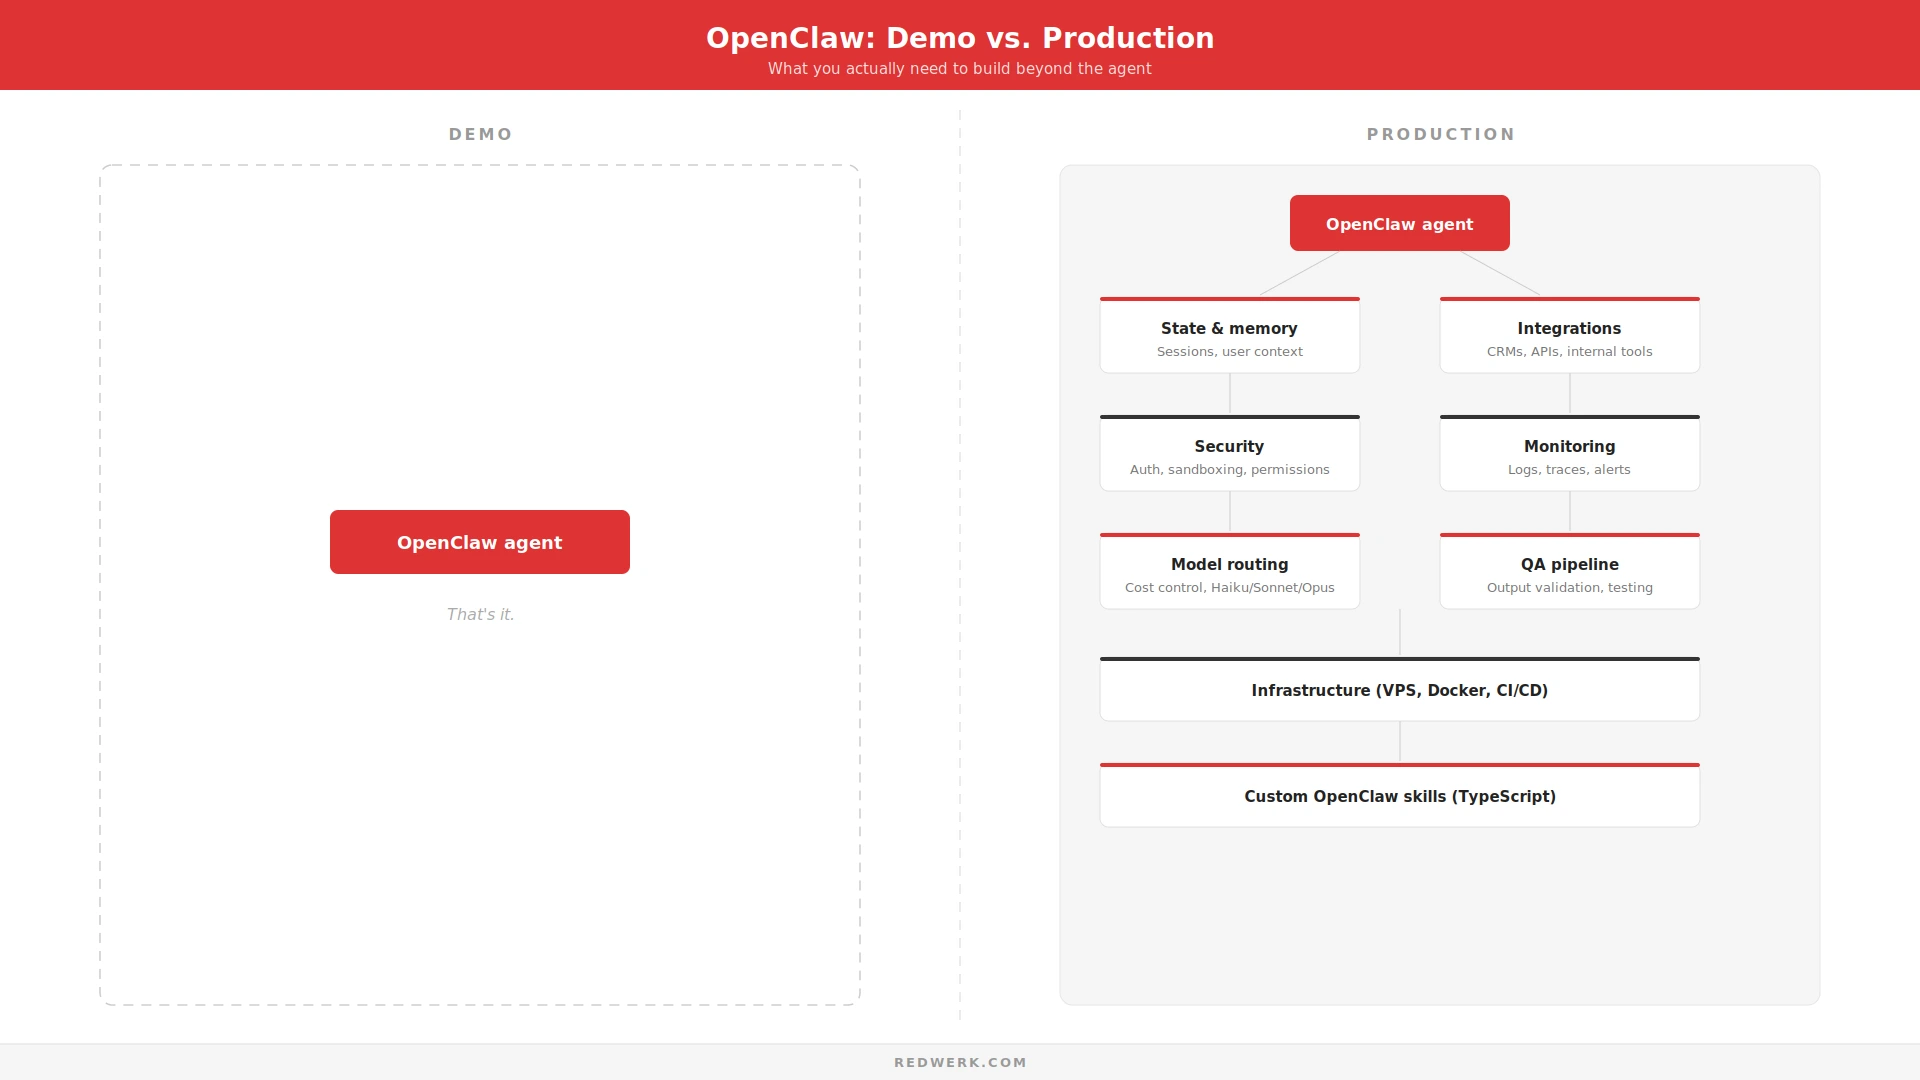
L’évolutivité d’OpenClaw repose sur l’architecture. Voici ce qui change.
Décisions architecturales
Un agent monolithique gérant tout est un schéma de démonstration. La production divise les responsabilités entre des agents modulaires — un pour la récupération, un pour l’exécution des actions, un pour l’interaction utilisateur. Cela reflète ce que nous avons vu lors de la mise à l’échelle des systèmes d’IA sans sacrifier la qualité.
Gestion de l’état et des sessions
OpenClaw utilise une mémoire basée sur markdown. Cela fonctionne pour un usage personnel. Pour les systèmes d’entreprise multi-utilisateurs, vous avez besoin d’un stockage de session structuré, d’une isolation du contexte utilisateur et d’un élagage de mémoire qui maintient les fenêtres de contexte gérables.
Routage des modèles et contrôle des coûts
Toutes les tâches ne nécessitent pas votre modèle le plus coûteux. Routage des classifications simples vers Haiku, du raisonnement complexe vers Sonnet, réservez Opus pour les décisions critiques. Des outils communautaires comme ClawRouter réduiraient les coûts d’environ 70 % grâce à la sélection dynamique des modèles.
Sécurité et conformité
CVE-2026-25253 a obtenu un CVSS de 8,8 – une RCE en un clic via le détournement de WebSocket. Bitdefender a trouvé qu’environ 17 % des compétences ClawHub contenaient du code malveillant. Le déploiement d’OpenClaw en production nécessite une liaison en boucle locale, des utilisateurs dédiés sans privilèges root, un sandboxing Docker et une revue de code pour chaque compétence tierce.
Observabilité et surveillance
Si vous ne pouvez pas voir ce que fait votre agent, vous ne pouvez pas corriger ce qu’il casse. La production nécessite une journalisation structurée, la capture de traces pour les flux de travail multi-étapes, l’alerte sur les taux d’erreur et des tableaux de bord des coûts.
Quand OpenClaw cesse d'être « gratuit »
OpenClaw est sous licence MIT. Le framework ne coûte rien. L’ingénierie nécessaire pour le rendre prêt pour la production est une autre histoire.
Les coûts des API évoluent avec l’utilisation, car une seule session intensive peut consommer plus de 200 000 jetons de contexte accumulé. L’infrastructure nécessite un VPS fonctionnant 24h/24 et 7j/7. Les compétences personnalisées nécessitent le développement en TypeScript. Les intégrations avec votre CRM et vos API internes doivent être construites, testées et maintenues. Comme l’IA remodèle la maintenance logicielle, le coût continu du maintien d’un système d’agents en bonne santé ne cesse de croître.
Le coût ne réside pas dans l’exécution d’OpenClaw, mais dans sa fiabilité.
Comment les équipes transforment les prototypes OpenClaw en produits réels
Les équipes qui passent de la démo à la production suivent un schéma cohérent. Elles définissent la portée. Elles construisent des compétences OpenClaw personnalisées en TypeScript pour leurs intégrations spécifiques. Elles investissent dans l’infrastructure : VPS, conteneurs Docker, surveillance. Elles conçoivent des pipelines QA qui valident les sorties de l’agent avant qu’elles n’atteignent les utilisateurs.
Nous avons suivi une approche similaire en créant des systèmes basés sur l’IA pour Evolv, où le défi consistait à rendre les recommandations d’IA prêtes pour la production avec des contrôles de qualité stricts et des données utilisateur réelles. Le principe est le même avec OpenClaw : l’agent est le point de départ, pas le produit fini.
Si votre configuration OpenClaw fonctionne en démo mais pas en production, vous êtes exactement au stade où le support d’ingénierie fait la différence. Qu’il s’agisse de développement de compétences personnalisées, d’intégrations système ou de transformation numérique à plus grande échelle — c’est ce que nous faisons.
Démo sympa. Et maintenant ?
OpenClaw est puissant. Il n’est pas non plus prêt à l’emploi.
Faire fonctionner ces 7 cas d’utilisation en production nécessite une architecture, des intégrations, un durcissement de la sécurité et une surveillance. C’est la réalité de tout système d’agent IA dans les années à venir.
La différence entre une démo et un produit, c’est tout ce qui entoure l’agent. Le pipeline RAG. Le modèle de permission. La gestion des erreurs. La couche d’observabilité.
Commencez par un seul cas d’utilisation. Réalisez-le correctement. Puis développez. Et si vous avez besoin d’une équipe qui a déjà fait cela — contactez-nous. Nous transformerons votre démo en produit fini.
FAQ
Quels sont les cas d'utilisation d'OpenClaw les plus courants pour les entreprises ?
Les agents de support client, les assistants de connaissance internes, la prospection commerciale et l’orchestration de flux de travail multi-étapes sont les quatre cas d’utilisation d’agents IA les plus largement adoptés. La plupart des équipes commencent par l’automatisation des e-mails ou des calendriers.
OpenClaw est-il sûr à utiliser en production ?
Pas prêt à l’emploi. Il nécessite une liaison en boucle fermée, des utilisateurs dédiés, un sandboxing Docker et des revues de code approfondies. La CVE-2026-25253 a montré que les configurations par défaut exposent une surface d’attaque sérieuse.
Combien coûte l'exécution d'OpenClaw ?
Le framework est gratuit. Les coûts d’API dépendent du modèle et du volume par million de jetons. Ajoutez l’hébergement VPS et le temps d’ingénierie pour les compétences personnalisées.
OpenClaw peut-il remplacer Zapier ou Make ?
Pour les flux de travail multi-étapes, OpenClaw peut reproduire et étendre ce que fait Zapier – avec un raisonnement IA entre les étapes. Le compromis : cela nécessite de l’ingénierie, alors que Zapier est sans code. Les équipes ayant des besoins personnalisés trouvent souvent l’IA d’OpenClaw plus flexible.
Ai-je besoin d'une équipe de développement pour utiliser OpenClaw en production ?
Pour la productivité personnelle, non. Pour les systèmes critiques pour l’entreprise avec des intégrations, la conformité et plusieurs utilisateurs, oui. Le prototype est un projet solo ; le produit est un effort d’équipe.
Découvrez comment nous avons aidé une plateforme d'expérimentation IA à gérer des flux de travail complexes et à évoluer de manière fiable en production.