Un concurrent a récemment déployé une fonctionnalité IA. Maintenant, vos utilisateurs en veulent une, votre conseil d’administration vous transmet des démos, et un investisseur veut connaître votre « feuille de route IA » pour le prochain appel. Vous avez un produit qui fonctionne et des clients qui paient pour cela, et l’idée de le démonter pour y intégrer de l’IA ressemble à un échange d’une entreprise réelle contre une expérience scientifique.
Voici la bonne nouvelle. Vous pouvez presque certainement éviter la reconstruction. La plupart des fonctionnalités IA qui stimulent la rétention et le chiffre d’affaires s’attachent à un produit fonctionnel comme une couche séparée qui lit les données que vous stockez déjà et renvoie les résultats via les API que vous possédez déjà.
La pression est réelle, tout comme le piège. Une étude MIT NANDA a révélé que 95 % des pilotes d’IA générative en entreprise n’ont eu aucun impact mesurable sur le profit et la perte, et la cause remontait à une faible intégration avec les flux de travail réels plutôt qu’au modèle lui-même. Les équipes qui réussissent sur ce point font les mêmes quelques choses : elles choisissent un point de douleur, l’exécutent bien et la connectent à la façon dont les gens travaillent réellement. Ce guide vous montre comment en faire partie, sans casser ce qui est déjà en ligne.
4 catégories de fonctionnalités IA qui fonctionnent comme des extensions pour SaaS
Toutes les fonctionnalités d’IA ne présentent pas le même risque, et la plupart des entreprises se brûlent les ailes en commençant par la plus difficile. Les quatre catégories ci-dessous apportent de la valeur en tant qu’extensions, et elles correspondent clairement à ce qu’un produit SaaS typique stocke et fait déjà. Voici comment elles se comparent avant d’approfondir chacune.
Analyses prédictives
« Que se passe-t-il ensuite ? »
6 à 12 mois d’historique propre
Faible
Automatisation intégrée à l’application
« L’application peut-elle faire cela pour moi ? »
Couche API et événements de déclenchement clairs
Faible à moyen
Personnalisation
« De quoi cet utilisateur a-t-il besoin ? »
Suivi des événements et historique utilisateur
Moyen
Flux de travail assistés par l’IA
« Aide-moi à finir plus vite »
Récupération de contexte et garde-fous de sortie
Moyen à élevé
Analyses prédictives
C’est là le risque le plus faible pour commencer, car elle lit généralement des données et renvoie un chiffre sans toucher à quoi que ce soit sur quoi un utilisateur clique. Un score d’attrition sur la page client, une prévision de la demande dans la vue des stocks, une projection d’utilisation sur le tableau de bord de facturation. Le modèle consomme l’historique que vous possédez déjà et renvoie une prédiction que votre interface affiche.
La dépendance qui fait ou défait tout, c’est la qualité des données. Une prévision entraînée sur des enregistrements incohérents ou incomplets sera sûrement erronée, ce qui érode la confiance plus rapidement que l’absence de prévision. Cette catégorie se situe clairement dans le domaine de l’apprentissage automatique classique, et c’est souvent le gain le plus rapide pour un SaaS basé sur l’IA qui repose déjà sur un ensemble de données riche. Le gros du travail consiste principalement à préparer les données et à choisir le bon modèle, c’est là que les services de développement IA dédiés font leur travail, plutôt que de réarchitecturer votre produit.
Automatisation intégrée à l'application
L’automatisation prend en charge une tâche que vos utilisateurs effectuent manuellement : étiquetage automatique des tickets de support, routage des prospects, résumé de longs fils de discussion, rédaction de réponses, extraction de champs à partir de documents téléchargés. Elle se connecte aux actions que votre application effectue déjà, vous ajoutez donc un chemin plus rapide plutôt qu’un nouveau système.
Ce dont elle a besoin, c’est d’une couche API et d’événements clairement définis auxquels se raccrocher, tels que « ticket créé » ou « document téléchargé ». Il faut faire attention à tout ce qui est destructeur ou visible par le client. Envoyer un e-mail, fermer un ticket ou modifier un enregistrement doit passer par une étape de confirmation avant que le modèle n’agisse de lui-même. Lorsque l’automatisation implique plusieurs étapes coordonnées, les équipes se tournent souvent vers l’un des frameworks d’IA multi-agents qui gèrent l’orchestration et l’état. Une configuration d’automatisation IA OpenClaw, par exemple, peut nécessiter une approbation humaine avant toute action irréversible, et cette seule garde-fou empêche une fonctionnalité utile de devenir un fardeau.
Personnalisation
La personnalisation adapte ce que chaque utilisateur voit : classement du contenu, recommandation de la prochaine action, mise en avant de l’élément approprié, ajustement du tableau de bord à la manière dont quelqu’un utilise réellement le produit. Elle ajoute une couche de classement par-dessus vos données existantes, et votre interface principale reste en place.
Si vous enregistrez déjà ce que les utilisateurs consultent, cliquent et achètent, vous avez la matière première. Le piège classique est le démarrage à froid : les nouveaux utilisateurs n’ont pas d’historique, vous avez donc besoin d’un défaut raisonnable auquel le modèle peut se rabattre pendant qu’il apprend. Bien faite, la personnalisation est l’un des leviers de rétention les plus clairs pour une IA dans le SaaS, car elle donne l’impression qu’un produit familier a été conçu pour la personne qui l’utilise.
Flux de travail assistés par l'IA
C’est le modèle de copilote, où le produit aide un utilisateur à terminer une tâche en générant une ébauche, en suggérant une modification ou en examinant le travail pendant que la personne reste aux commandes. Pensez à un assistant d’écriture dans un éditeur, à un générateur de requêtes dans un outil d’analyse ou à un réviseur de configuration dans un produit de développement.
Il nécessite une récupération de contexte pour que l’assistant connaisse les données de l’utilisateur, ainsi que des garde-fous sur ce qu’il peut produire. Des quatre, celui-ci modifie le plus l’expérience utilisateur, il nécessite donc généralement de nouveaux travaux d’interface et un flux d’approbation. Il récompense également un périmètre d’action limité : un copilote qui essaie de tout faire ne fait rien de manière fiable, alors choisissez la tâche unique qu’il exécute vraiment bien et livrez-la en premier.
Prérequis techniques : ce qu'il faut vérifier avant de commencer
Avant de vous engager sur une catégorie, vérifiez que votre produit peut la supporter. La plupart de ces éléments sont des composants que vous pouvez ajouter progressivement, et leur vérification maintenant est ce qui sépare un projet de quatre semaines d’un projet de quatre mois. La liste ci-dessous est volontairement courte, car chaque élément représente un blocage réel s’il manque.
- Données accessibles. Le modèle doit pouvoir lire les enregistrements pertinents via une API, une couche de requête ou un flux d’événements. Si vos données sont enfermées dans un code étroitement couplé, exposez-les d’abord via une interface propre.
- Événements définis. L’automatisation et la personnalisation se déclenchent sur des événements, vous avez donc besoin d’événements clairs tels que ‘enregistrement créé’, ‘statut modifié’ ou ‘page consultée’.
- Authentification et contrôle du débit. La couche IA doit s’authentifier comme tout autre service et respecter les limites de débit, afin qu’une boucle incontrôlée ne puisse pas surcharger votre système ou l’API d’un fournisseur.
- Contrôles de coûts et observabilité. Les plafonds de jetons par utilisateur, un interrupteur d’urgence, la journalisation et un tableau de bord pour les dépenses et la qualité vous permettent de voir ce que fait l’IA et ce qu’elle coûte en temps réel.
- Un ensemble d’évaluation. Une poignée de réponses connues comme étant correctes vous permet de mesurer la qualité avant le lancement et de détecter les régressions après, au lieu de vous fier à une démo.
- Une ligne de confidentialité. Décidez quelles données peuvent quitter votre environnement, ce qui doit être anonymisé, et si un cas d’utilisation nécessite un modèle s’exécutant dans votre propre cloud.
Les données que vous gérez déjà sont le fondement, et un accès propre à celles-ci est la chose qui aura le plus fort effet que vous puissiez préparer.
Votre checklist d'intégration IA pour SaaS
Un chemin qui protège votre produit en direct ressemble à la séquence ci-dessous. L’intérêt de la suivre dans cet ordre est que chaque étape est réversible, de sorte qu’une fonctionnalité qui ne fonctionne pas coûte une expérience plutôt que votre feuille de route. Une intégration IA de SaaS solide est séquentielle et mesurée, chaque étape étant suffisamment petite pour être annulée.
- Choisissez une fonctionnalité liée à une métrique. Pas « ajouter de l’IA », mais « réduire le temps de réponse aux tickets » ou « réduire l’attrition dans le segment à risque ». Décidez comment vous mesurerez le succès avant d’écrire une seule ligne de code.
- Vérifiez la préparation des données. Auditez les données dont dépend la fonctionnalité et nettoyez-les si nécessaire. Cette seule étape sépare les projets qui fonctionnent de ceux qui stagnent.
- Décidez entre acheter et construire pour la couche modèle. Pour la plupart des tâches de langage et de raisonnement, un modèle hébergé accessible via un framework vous permet d’y parvenir plus rapidement que de former le vôtre. La comparaison des principaux frameworks LLM vous aide à faire correspondre l’outil à l’utilisation.
- Construisez derrière un indicateur de fonctionnalité. Déployez d’abord auprès d’un groupe interne, puis d’une petite cohorte de vrais utilisateurs, et gardez le flux existant entièrement intact afin que quiconque puisse y revenir.
- Ajoutez des garde-fous et un humain dans la boucle. Mettez des étapes de confirmation sur les actions risquées, définissez des limites sur ce que le modèle peut produire, et donnez aux utilisateurs un moyen clair de corriger ou de rejeter un résultat.
- Mesurez les coûts et la qualité dès le premier jour. Suivez les dépenses par utilisateur et la précision par rapport à votre ensemble d’évaluation, et définissez des alertes avant de fixer une date de lancement.
- Mesurez, puis déployez progressivement. Si la métrique a bougé, élargissez le déploiement. Si ce n’est pas le cas, vous avez perdu une expérience signalée, pas votre produit.
Erreurs d'intégration qui créent plus d'attrition qu'elles n'en préviennent
Une fonctionnalité IA mal intégrée fait pire que sous-performer. Elle repousse activement les utilisateurs, car elle interrompt un flux de travail sur lequel ils comptaient et remplace quelque chose de certain par une supposition. Ce sont les schémas qui transforment un lancement de fonctionnalité en un événement d’attrition.
- Le tueur silencieux est l’implémentation de l’IA sur des données sales. Le résultat semble confiant et s’avère faux, et les utilisateurs cessent de faire confiance à la fois à la fonctionnalité et au produit qui l’entoure après quelques utilisations. Nettoyez les données avant de construire, même si c’est la partie la moins excitante du projet.
- Le deuxième schéma consiste à remplacer un flux de travail fonctionnel au lieu de l’ajouter à côté. Lorsque vous forcez les utilisateurs à suivre un chemin non éprouvé, vous supprimez le filet de sécurité sur lequel ils comptaient. Conservez la voie manuelle, placez la voie IA à côté, et laissez les gens choisir à leurs propres conditions.
- Le troisième consiste à retirer l’humain des décisions qui ont des conséquences. Tout ce qui envoie, supprime, facture ou contacte un client nécessite une étape de confirmation, car une erreur automatisée à grande échelle est bien plus coûteuse qu’une étape manuelle plus lente.
- Le quatrième revient à l’origine de ce guide. Considérer une démo solide comme une fonctionnalité terminée est le piège, car l’écart entre une démo et la production réside dans l’intégration avec les flux de travail réels et les cas limites réels. Testez là, pas dans la salle d’exposition, et vous resterez du bon côté de cette division.
Pourquoi vous n'avez probablement pas besoin d'une reconstruction
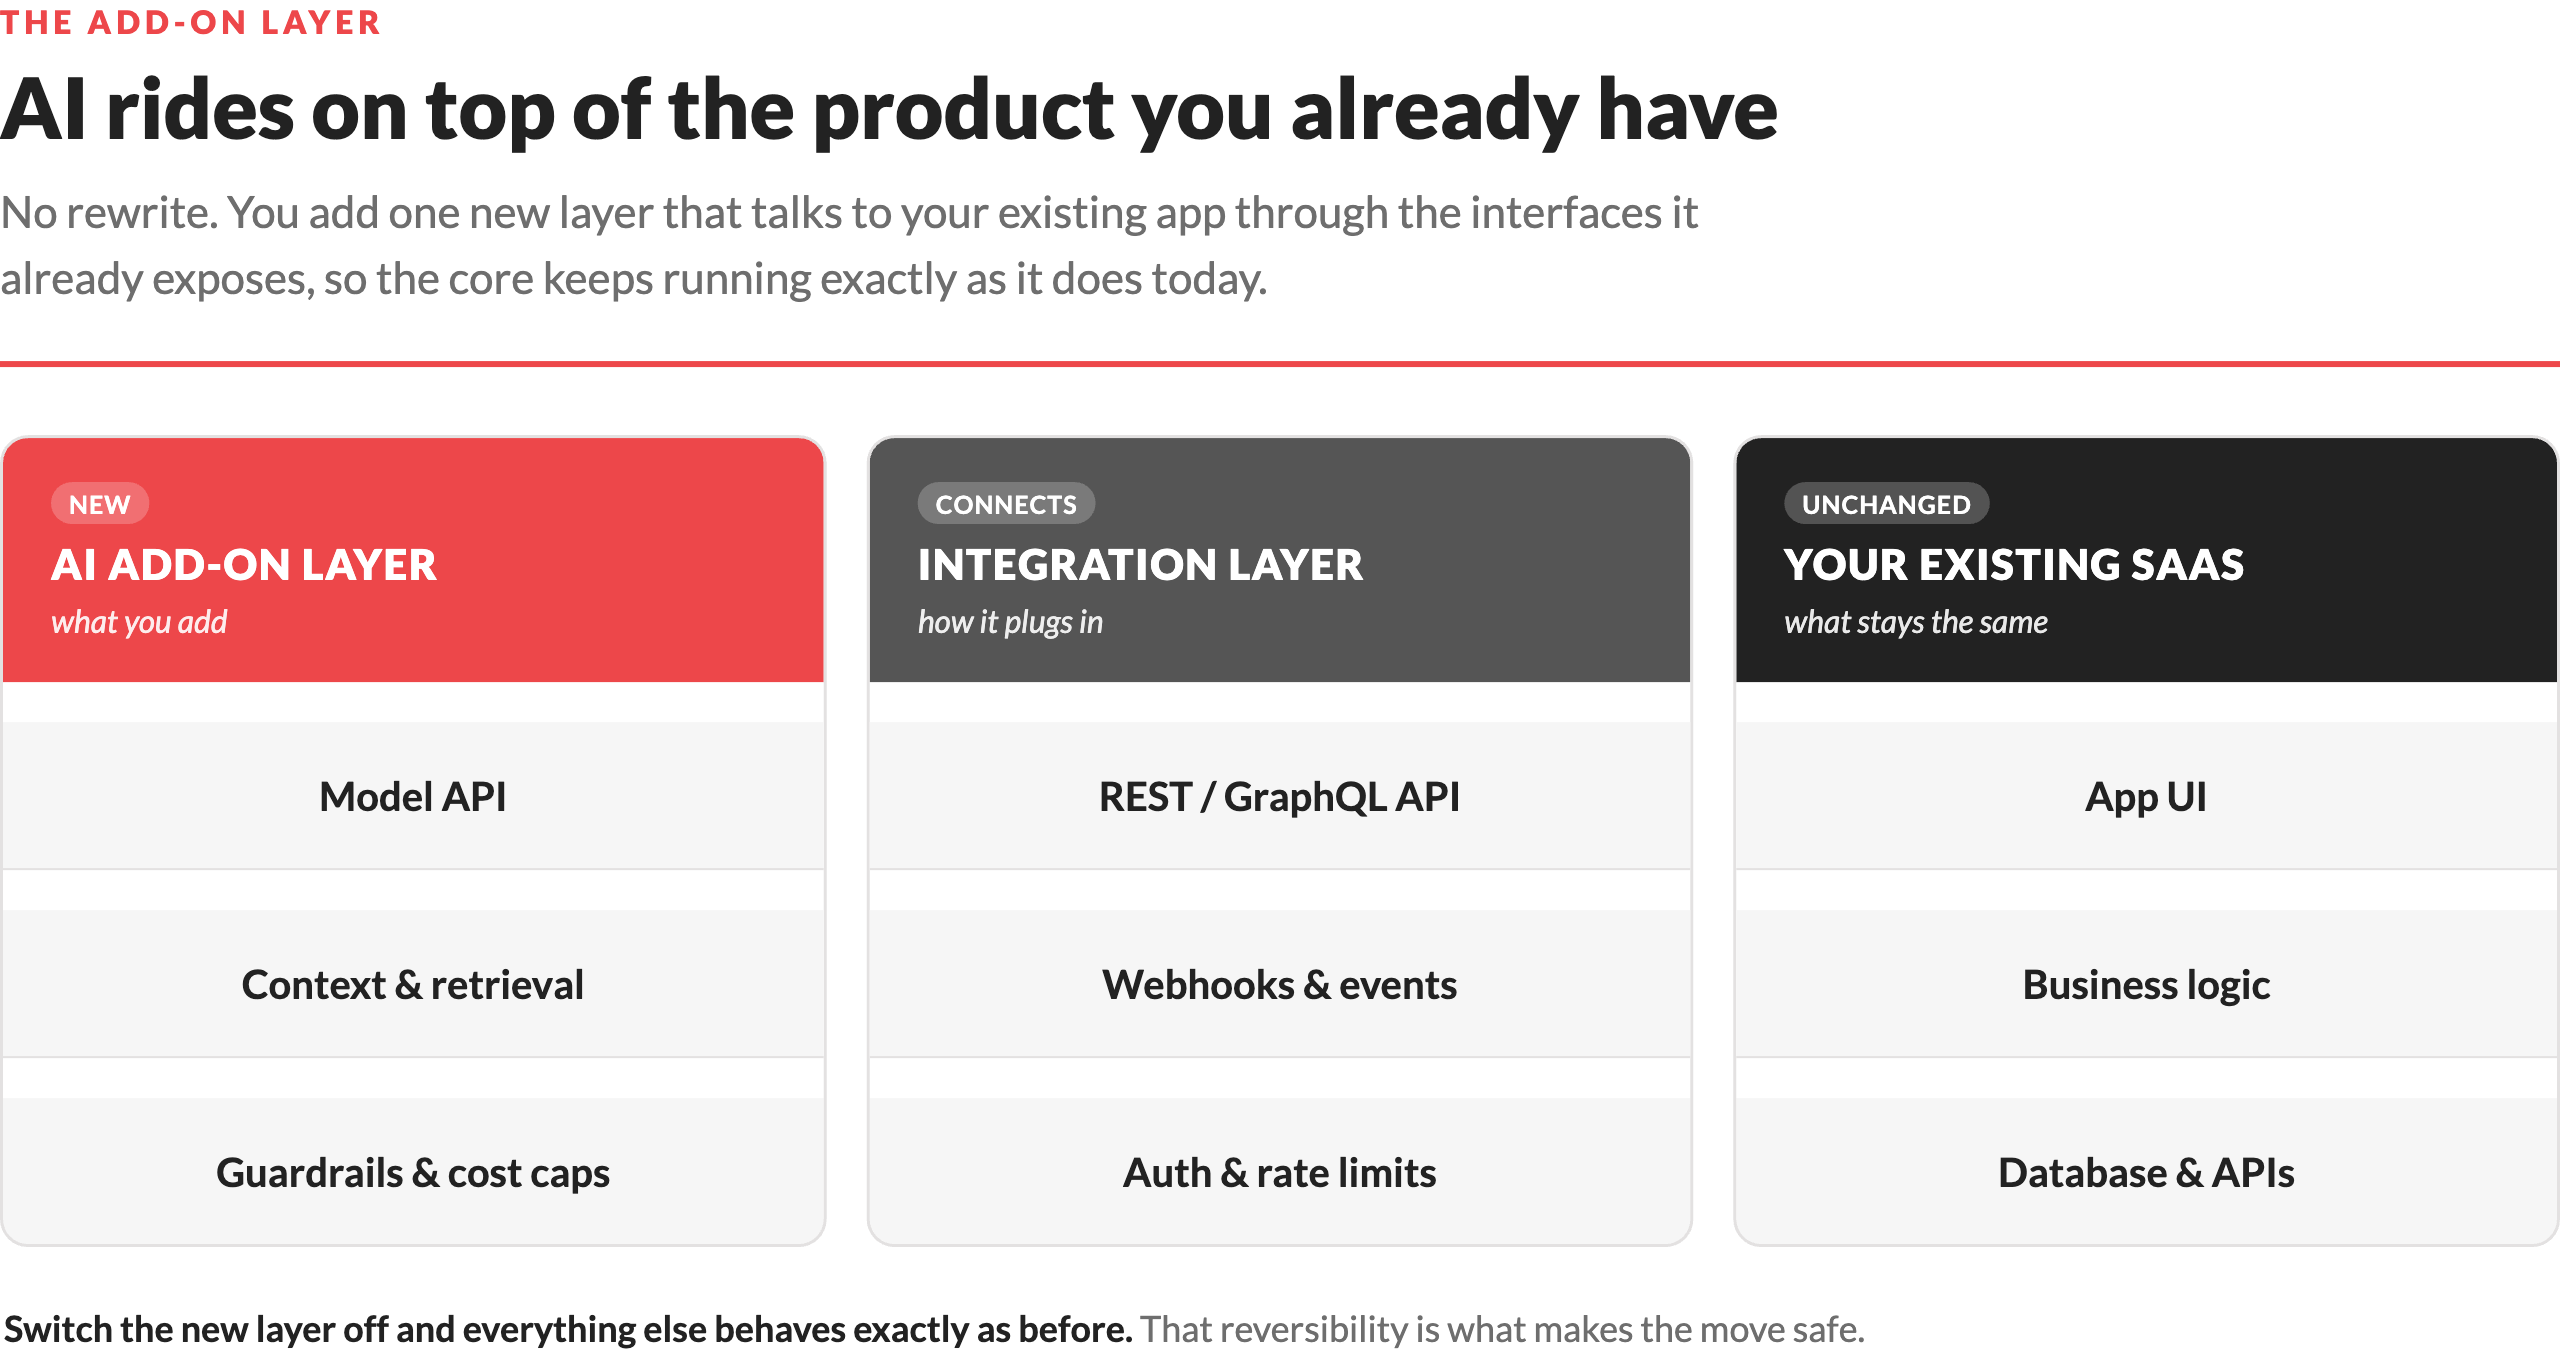
Un produit SaaS fonctionnel possède déjà les quatre éléments dont l’IA a besoin : un endroit pour lire les données, un endroit pour écrire les résultats, un moyen de déclencher des événements et un moyen de s’authentifier. L’intégration consiste principalement à se connecter à ces quatre éléments, de sorte que l’IA vive comme une couche au-dessus d’un produit qui continue de fonctionner exactement comme il le fait aujourd’hui.
Cette couche s’abonne aux événements, récupère le contexte via votre API, l’envoie à un modèle, et renvoie un score, une suggestion ou une action. Désactivez la couche et votre produit se comporte exactement comme avant, et cette réversibilité est tout l’intérêt. Vous ajoutez des capacités sans parier sur le cœur.
Deux changements rendent cela réaliste dès maintenant. Les modèles hébergés gèrent le langage, le raisonnement et la classification via un appel API, de sorte que le travail passe de la recherche à l’intégration. Et les modèles de support — récupération, orchestration d’invites, notation et garde-fous — sont maintenant des tâches d’ingénierie standard plutôt que du travail de pointe. Le développement moderne d’IA pour SaaS s’appuie sur cette maturité, c’est pourquoi les fondateurs qui franchissent le fossé GenAI partagent généralement une habitude : ils connectent une fonctionnalité unique bien choisie à un flux de travail qui avait déjà des utilisateurs.
Comment Redwerk vous aide à ajouter l'IA sans reconstruction
Si les concurrents ont commencé à proposer de l’IA et que vous examinez votre propre produit en vous demandant où une fonctionnalité pourrait s’intégrer sans le déstabiliser, c’est l’une de nos conversations d’ouverture les plus courantes en 2026. Les gains les plus rapides et les plus sûrs proviennent généralement de la prédiction de scores et des recommandations basées sur les données que vous collectez déjà, ce qui est couvert par notre travail en apprentissage automatique et science des données — des prévisions d’attrition et de demande aux recommandations de produits, y compris la préparation des données qui détermine si un modèle gagne la confiance ou la perd.
Le support à long terme d’un SaaS en direct piloté par l’IA est la discipline derrière le reste de notre livraison. Redwerk est l’équipe de livraison à long terme derrière Evolv, une plateforme d’optimisation pilotée par l’IA dont le moteur d’apprentissage automatique sert des expériences de mieux en mieux à chaque visiteur, et nous développons et mettons continuellement à niveau son éditeur Web et son gestionnaire à mesure que le produit évolue. Le même soin façonne la manière dont nous ajoutons l’IA : notre équipe de développement SaaS construit la couche d’intégration, les portes d’approbation et les contrôles de coûts qui empêchent une fonctionnalité automatisée de devenir un problème de support, et notre conseil en développement logiciel assisté par l’IA aide vos ingénieurs à façonner les habitudes de révision et de surveillance qui le maintiennent en bonne santé après le lancement.
Points clés
La question n’a jamais été de savoir s’il fallait ajouter de l’IA. Il s’agit de savoir comment l’ajouter sans casser un produit qui paie déjà les factures, et la réponse est de traiter l’IA comme une couche réversible plutôt qu’une réécriture. Commencez par une fonctionnalité qui correspond aux données dont vous disposez, livrez-la derrière un indicateur à un petit groupe, gardez un humain pour tout ce qui a des conséquences, et mesurez-la par rapport à un chiffre que vous avez défini à l’avance.
Faites cela, et vous restez du bon côté de la division entre les produits qui parlent d’IA et les produits qui la livrent discrètement. Lorsque vous êtes prêt à définir votre première fonctionnalité, contactez-nous et nous vous aiderons à trouver le chemin sûr le plus rapide pour y parvenir.
FAQ
Dois-je reconstruire mon SaaS pour ajouter des fonctionnalités IA ?
Non. La plupart des fonctionnalités IA s’attachent comme une couche séparée qui se connecte à votre produit existant via votre API actuelle. Votre base de données, votre logique métier et votre interface restent telles quelles. La couche IA lit les données, appelle un modèle et renvoie les résultats, vous pouvez donc la supprimer plus tard sans toucher au cœur.
Combien de temps prend l'intégration IA pour un SaaS ?
Une fonctionnalité prédictive ou d’automatisation ciblée sur des données propres et accessibles est souvent livrée en environ quatre à huit semaines. Les fonctionnalités de personnalisation et de copilote prennent plus de temps car elles modifient l’expérience utilisateur. Le calendrier dépend beaucoup plus de la préparation des données que du modèle lui-même.
Quelle est la fonctionnalité IA la moins chère et la moins risquée pour commencer ?
Les analyses prédictives. Elles lisent les données que vous stockez déjà et renvoient un score sans modifier aucun flux avec lequel vos utilisateurs interagissent, ce qui en fait le point d’entrée le moins coûteux et le moins risqué. Elles révèlent également les problèmes de qualité des données tôt, avant qu’ils ne puissent faire dérailler une fonctionnalité plus visible.
Découvrez comment Redwerk a pris en charge le développement principal d'une plateforme d'optimisation IA et l'a menée à un lancement de produit réussi