Ajouter des fonctionnalites d’IA a une application Ruby on Rails en 2026 implique generalement d’appeler une API LLM externe (OpenAI, Anthropic ou Gemini) depuis un objet de service Rails, puis de router le travail d’inference via Sidekiq ou Solid Queue pour que le processus web reste rapide. Une integration basique prend un a deux jours de temps d’ingenierie. Une configuration prete pour la production avec RAG, streaming et gestion d’erreurs appropriee prend deux a quatre semaines.
Si vous exploitez deja un monolithe Rails, vous n’avez pas besoin de le reecrire en Python pour deployer de l’IA. Rails gere les parties que l’IA ne peut pas : authentification, facturation, tableaux de bord d’administration, taches de fond et la couche de base de donnees qui fournit le contexte au modele. La vraie question est quel patron d’integration convient a votre produit et ou se cachent les modes de defaillance.
Ce guide presente cinq patrons que nous utilisons dans les applications Rails en production, d’un simple wrapper LLM a l’orchestration complete d’agents. Chaque section inclut les gems, les pieges et les compromis honnetes pour que vous puissiez choisir la bonne approche sans sur-ingenierer la solution.
Pourquoi Rails est un choix solide pour les fonctionnalites d'IA
La plupart des fonctionnalites d’IA en 2026 ne necessitent pas d’entrainer des modeles. Elles necessitent d’appeler une API d’inference, de gerer les prompts, de gerer les tentatives et de stocker les resultats. Rails excelle deja exactement dans ce type de logique.
Active Record vous offre un ORM mature pour stocker les embeddings, l’historique des conversations et le contexte utilisateur. Sidekiq et Solid Queue gerent les taches d’inference en arriere-plan qui bloqueraient autrement vos workers web. ActionCable et Turbo Streams fournissent une sortie en streaming temps reel sans serveur WebSocket separe.
L’ecosysteme Ruby a rattrape rapidement son retard. Le gem ruby-openai couvre OpenAI et Azure OpenAI. RubyLLM fournit une interface unifiee pour OpenAI, Anthropic, Gemini et des dizaines d’autres fournisseurs. Langchain.rb apporte les pipelines RAG, les appels d’outils et les patrons d’agents a Ruby.
Pour les equipes qui exploitent deja un monolithe Rails, le cout d’ajout d’une fonctionnalite IA dans l’application existante est une fraction de ce que couterait un microservice Python separe, un second pipeline de deploiement et la gestion de l’authentification inter-services. Un de nos clients, un SaaS de marche moyen avec une base de code Rails de 200 000 lignes, a ajoute le resume de documents par IA en 11 jours sans modifier son architecture de deploiement. La meme portee avec un sidecar Python aurait pris pres de six semaines.
5 patrons d'integration pour ajouter l'IA a Rails
Toutes les fonctionnalites d’IA n’ont pas besoin de la meme architecture. Un chatbot, un classificateur de documents et un systeme de recherche alimente par l’IA necessitent chacun une profondeur d’integration differente. Voici les cinq patrons que nous utilisons, classes du plus simple au plus complexe.
Patron 1 : Wrapper d'API LLM
Le patron le plus simple. Enveloppez un appel API LLM dans un objet de service Ruby simple et appelez-le depuis un controleur ou une tache de fond.
Cela fonctionne bien pour les taches a un seul tour : resumer un ticket de support, classifier un e-mail, generer une description de produit ou reecrire du texte pour correspondre a la voix de la marque. La requete part, la reponse revient, et vous stockez le resultat.
Meilleurs gems : ruby-openai pour OpenAI et Azure OpenAI, ruby_llm pour le support multi-fournisseur (OpenAI, Anthropic, Gemini, DeepSeek), ou anthropic pour les fonctionnalites specifiques a Claude comme la reflexion etendue.
Piege cle : Les appels API LLM prennent de 2 a 30 secondes. Ne les appelez jamais en ligne dans une requete web sauf si vous streamez la reponse (voir Patron 4). Meme un appel de 3 secondes occupera un thread Puma pendant toute sa duree.
# app/services/ai/summarizer.rb
class Ai::Summarizer
  def initialize(client: OpenAI::Client.new)
    @client = client
  end

  def call(text, max_words: 100)
    response = @client.chat(
      parameters: {
        model: "gpt-4.1-mini",
        messages: [
          { role: "system", content: "Summarize in #{max_words} words or fewer." },
          { role: "user", content: text }
        ],
        temperature: 0.3
      }
    )
    response.dig("choices", 0, "message", "content")
  end
end
Patron 2 : Taches d'IA en arriere-plan
Pour tout appel IA qui ne necessite pas de reponse synchrone, deplacez-le vers une tache de fond. C’est le choix par defaut pour le traitement par lots, l’analyse de documents, les pipelines de scoring et toute fonctionnalite ou l’utilisateur soumet des donnees et revient plus tard.
Meilleurs gems : Sidekiq (le choix eprouve, sauvegarde Redis) ou Solid Queue (par defaut dans Rails 8, sauvegarde base de donnees, zero dependance externe).
Structurez la tache pour qu’elle soit idempotente. Les APIs LLM ont des defaillances transitoires, des limites de debit et des timeouts occasionnels. Votre tache doit pouvoir reessayer proprement sans produire de resultats en double. Stockez la reponse brute de l’API a cote de la sortie traitee pour pouvoir debuguer sans relancer l’appel.
Conseil de production : Configurez une file dediee pour les taches IA avec sa propre limite de concurrence. Un pic soudain de requetes IA ne devrait pas affamer votre file de taches normale. Si vous utilisez Sidekiq, un sidekiq.yml avec :queues : [default, 5, ai_inference, 2] limite la concurrence IA a 2 threads.
# app/jobs/ai/classify_ticket_job.rb
class Ai::ClassifyTicketJob < ApplicationJob
  queue_as :ai_inference
  retry_on Faraday::TimeoutError, wait: :polynomially_longer, attempts: 3

  def perform(ticket_id)
    ticket = SupportTicket.find(ticket_id)
    return if ticket.ai_classified?

    result = Ai::Classifier.new.call(ticket.body)
    ticket.update!(
      ai_category: result[:category],
      ai_priority: result[:priority],
      ai_confidence: result[:confidence],
      ai_raw_response: result[:raw]
    )
  end
end
Patron 3 : RAG avec embeddings et pgvector
La Generation Augmentee par Recuperation (RAG) est le patron a utiliser quand l’IA doit repondre a des questions sur vos donnees, pas sur des connaissances generales. Vous convertissez vos documents en embeddings vectoriels, les stockez dans une base de donnees vectorielle et recuperez les fragments les plus pertinents au moment de la requete pour les fournir comme contexte au LLM.
Pour les applications Rails sur PostgreSQL, l’extension pgvector est le choix naturel. Pas de nouvelle base de donnees a gerer, pas de nouvelle dependance de deploiement. Le gem neighbor d’Andrew Kane integre pgvector avec Active Record, vous offrant des scopes nearest_neighbors et un stockage automatique des embeddings.
Configuration typique :
- Ajoutez pgvector a votre instance PostgreSQL (
CREATE EXTENSION vector ;) - Creez une colonne d’embeddings sur votre modele (
add_column :documents, :embedding, :vector, limit : 1536) - Generez les embeddings a la creation/mise a jour via une tache de fond (Patron 2)
- Au moment de la requete, generez l’embedding de la question utilisateur, trouvez les fragments de document les plus proches et passez-les comme contexte au LLM
Piege cle : La qualite des embeddings compte plus que le choix du modele. Si votre strategie de decoupage est mauvaise (trop grande, trop petite, ou coupant en milieu de phrase), le meilleur LLM donnera quand meme de mauvaises reponses. Commencez avec des fragments de 500 tokens avec 50 tokens de chevauchement et ajustez selon la qualite de la recuperation.
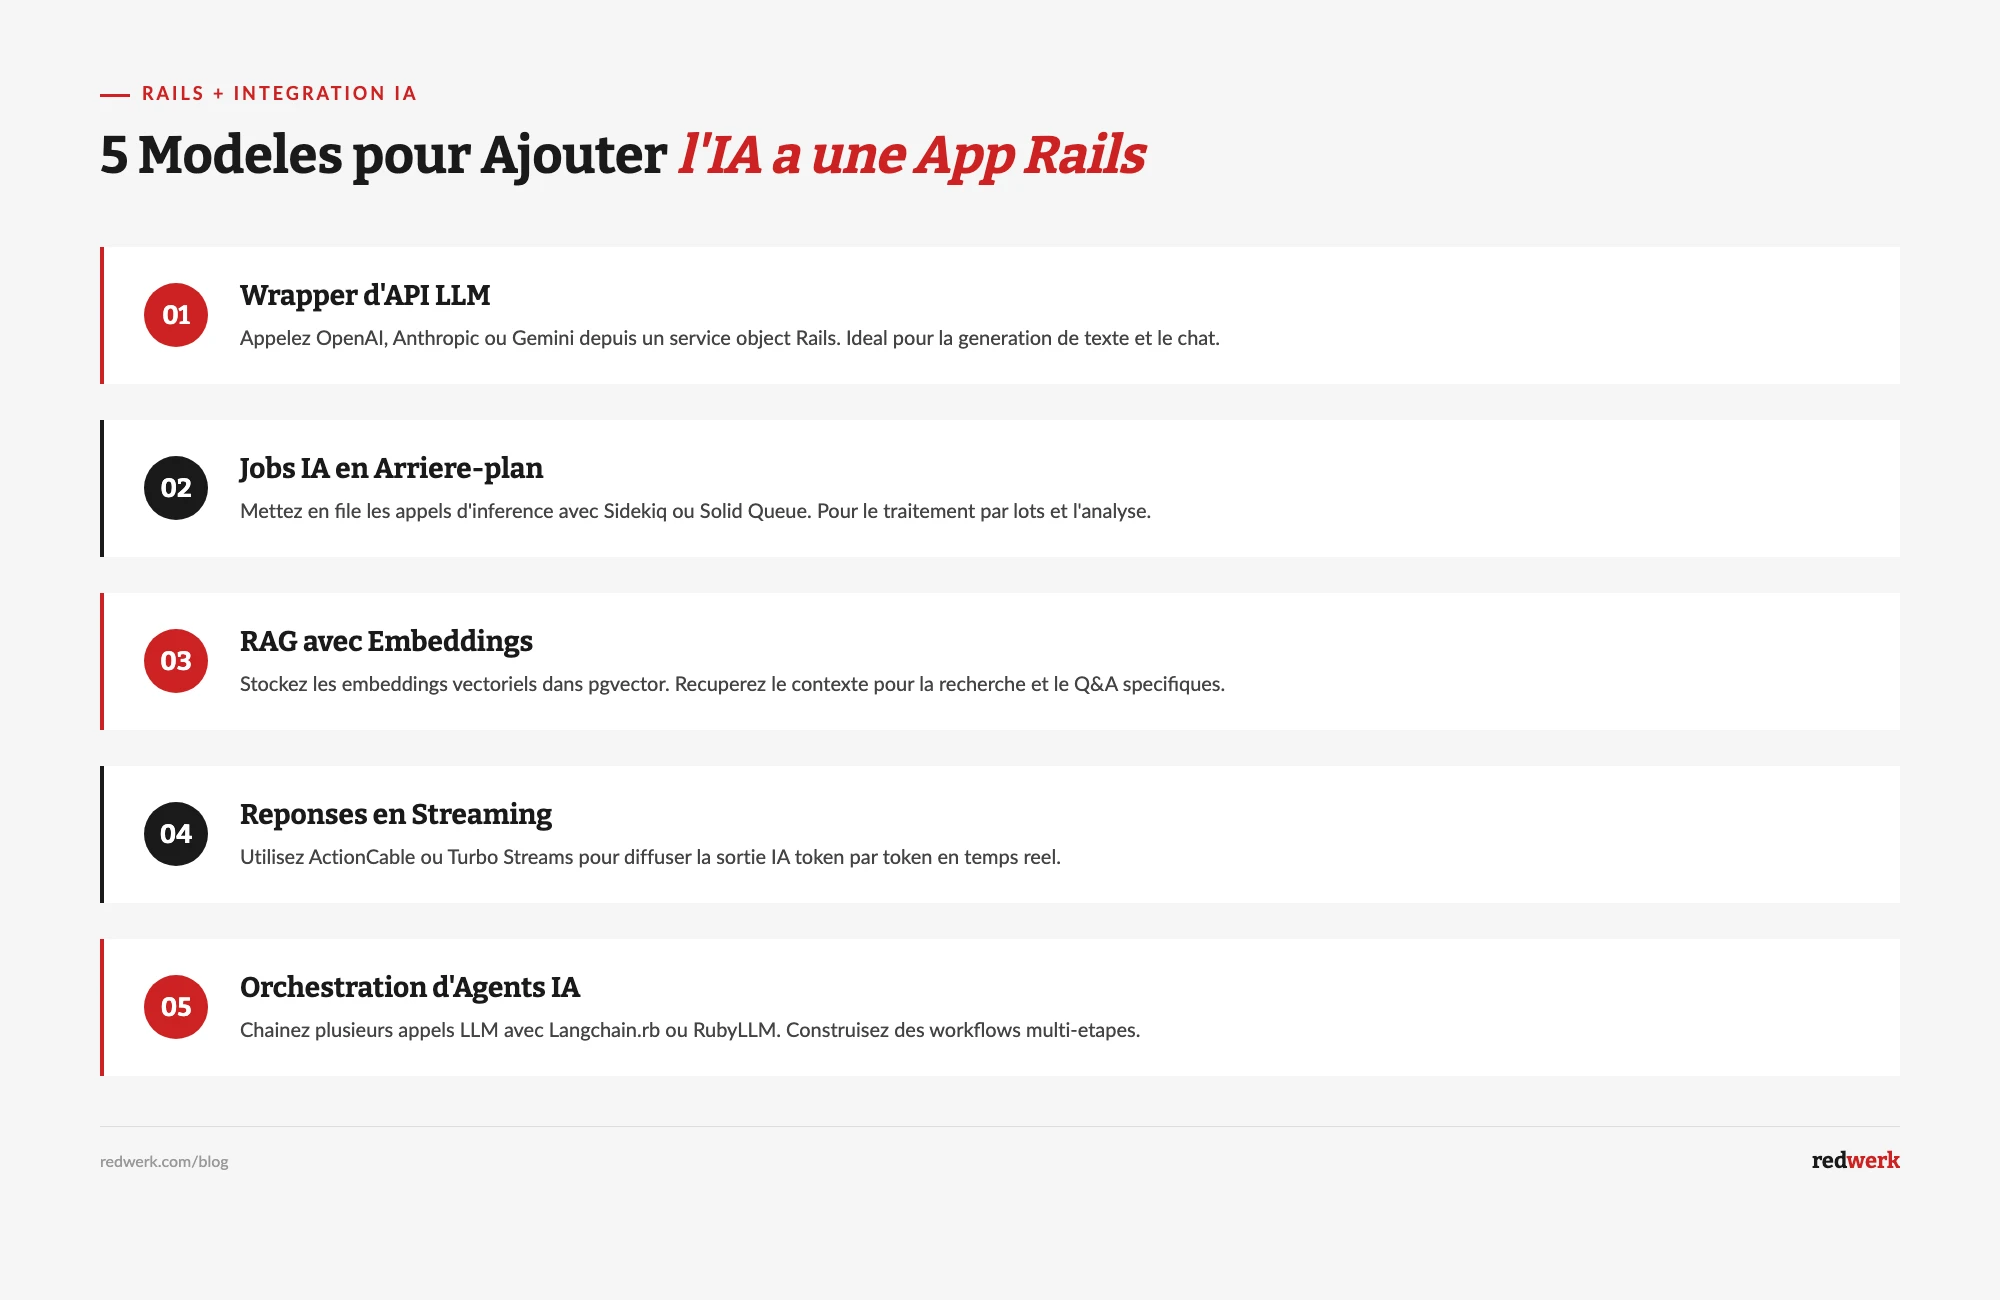
Patron 4 : Reponses en streaming
Quand les utilisateurs interagissent avec un chatbot ou toute fonctionnalite d’IA qui genere du texte long, ils s’attendent a voir la sortie apparaitre mot par mot, pas a attendre 10 secondes devant un ecran vide. Le streaming resout ce probleme.
Rails vous offre deux voies natives :
- ActionCable pour le streaming base sur WebSocket (connexion persistante, bidirectionnelle)
- Turbo Streams pour les mises a jour envoyees par le serveur (plus simple, fonctionne avec Hotwire, pas de configuration WebSocket)
Tant ruby-openai que ruby_llm supportent les callbacks de streaming. Vous recevez chaque token des qu’il arrive de l’API et le diffusez au canal client. L’utilisateur voit le texte apparaitre en temps reel pendant que le modele genere encore.
Conseil de production : Regroupez les tokens en petits lots (5 a 10 tokens) avant de les diffuser. Envoyer chaque token individuel comme sa propre diffusion ActionCable cree un overhead inutile. De plus, definissez toujours un timeout de streaming. Si l’API s’arrete en cours de flux, votre canal doit se fermer proprement apres 30 a 60 secondes de silence.
Patron 5 : Orchestration d'agents IA
Le patron le plus complexe. Un agent IA est un LLM qui peut raisonner sur une tache en plusieurs etapes, appeler des outils externes (APIs, requetes base de donnees, recherches web), evaluer les resultats intermediaires et decider quoi faire ensuite. Imaginez la difference entre une calculatrice et un comptable.
Meilleurs gems : Langchain.rb fournit l’abstraction complete agent/outil/chaine. RubyLLM supporte les appels d’outils nativement entre fournisseurs. Pour des flux plus simples, Raix offre une couche d’orchestration legere.
Cas d’usage qui justifient les agents dans Rails :
- Un bot de support client qui peut rechercher des commandes, verifier le statut d’expedition et initier des remboursements
- Un pipeline d’analyse de donnees qui interroge votre base de donnees, genere des graphiques et redige un rapport de synthese
- Un assistant d’onboarding qui guide les nouveaux utilisateurs a travers la configuration en appelant vos propres points d’acces API
Piege cle : Les agents sont puissants mais couteux et imprevisibles. Une seule execution d’agent peut faire 5 a 15 appels LLM, chacun avec sa propre latence et son propre cout. Definissez toujours une limite maximale d’iterations, enregistrez chaque appel d’outil et construisez un interrupteur d’urgence. Commencez par un workflow code en dur (logique si/alors avec des appels LLM aux points de decision) avant de passer a un agent totalement autonome.
Erreurs courantes lors de l'ajout d'IA a Rails
Appeler le LLM en ligne dans une requete web. C’est l’erreur numero un. Un seul thread Puma est bloque pendant toute la duree de l’appel API. Sous charge, cela epuise les threads disponibles de votre application et cree des timeouts en cascade. Utilisez une tache de fond pour tout ce qui ne necessite pas de reponse immediate, et streamez la reponse via ActionCable ou Turbo pour tout ce qui en necessite une.
Ignorer la gestion d’erreurs et les tentatives. Les APIs LLM ne sont pas aussi fiables qu’une requete base de donnees. Les limites de debit, les erreurs 500, les reponses malformees et les depassements de longueur de contexte se produisent en production. Enveloppez chaque appel dans une gestion d’erreurs structuree avec backoff exponentiel. Stockez la reponse brute pour le debugging.
Coder les prompts en dur. Les prompts changent constamment pendant le developpement et apres le lancement. Stockez-les dans une table de base de donnees ou un fichier de configuration YAML, pas en ligne dans vos objets de service. Cela vous permet d’iterer sur les prompts sans deploiement et de tester A/B differentes versions.
Ignorer les couts jusqu’a l’arrivee de la facture. Un agent qui fait 10 appels GPT-4.1 par interaction utilisateur peut couter 0,50 $ par requete. Avec 10 000 utilisateurs quotidiens, cela fait 5 000 $ par jour. Surveillez les depenses API par fonctionnalite des le premier jour. Utilisez des modeles moins chers (GPT-4.1-mini, Claude Haiku) pour la classification et le routage, et reservez les modeles couteux pour la generation.
Sur-ingenierer la premiere version. Vous n’avez pas besoin de RAG, d’agents et de streaming pour votre premiere fonctionnalite IA. Commencez par le Patron 1 (un objet de service enveloppant un appel API). Deployez-le. Mesurez si les utilisateurs interagissent reellement avec. Puis investissez dans les patrons plus complexes uniquement la ou les donnees le justifient.
Quand ne pas ajouter d'IA a votre application Rails
L’IA n’est pas le bon outil pour chaque fonctionnalite. Soyez honnete sur les compromis avant d’engager du temps d’ingenierie.
Logique deterministe. Si la tache a des regles claires (calculs fiscaux, validation de formulaires, routage de workflow base sur des conditions connues), une methode Ruby reguliere sera plus rapide, moins chere et plus fiable qu’un appel LLM. Les LLMs sont probabilistes. Ils produisent occasionnellement des reponses incorrectes meme quand la bonne reponse est sans ambiguite.
Chemins sensibles a la latence. Si la fonctionnalite se trouve sur un chemin critique (chaque chargement de page, chaque reponse API), meme un appel LLM en cache ajoute de la latence et un mode de defaillance. Reservez l’IA pour les fonctionnalites ou un temps de reponse de 1 a 5 secondes est acceptable.
Domaines fortement reglementes sans garde-fous. Les applications de sante, finance et droit necessitent des sorties verifiables. Un LLM peut assister un reviseur humain, mais ne devrait pas prendre la decision finale sans un humain dans la boucle et une piste d’audit claire.
Le budget ne le supporte pas. Si votre application traite 100 000 requetes par jour et que la fonctionnalite IA se declenche sur chacune, modelisez le cout API a des prix realistes par appel avant de construire. Un appel a 0,01 $ pour 100 000 requetes represente 1 000 $ par jour, 30 000 $ par mois.
Comment Redwerk aborde l'integration IA dans Rails
Redwerk developpe des applications Ruby on Rails depuis pres de 20 ans, et notre equipe ajoute des fonctionnalites d’IA aux bases de code Rails existantes depuis que les APIs LLM sont devenues viables en production.
Le schema que nous voyons le plus souvent : une equipe SaaS de marche moyen a un monolithe Rails mature, un backlog de demandes de fonctionnalites IA de la part des clients, et aucune experience interne en ML. Ils ont besoin d’ingenieurs qui connaissent deja Rails suffisamment bien pour integrer l’IA sans destabiliser le systeme existant.
C’est le probleme du tech-match. Vous n’avez pas besoin d’une equipe de recherche en IA. Vous avez besoin de developpeurs Rails seniors qui comprennent aussi les patrons d’integration LLM, l’ingenierie de prompts et les preoccupations operationnelles (surveillance des couts, limitation du debit, gestion des replis) qui rendent les fonctionnalites IA pretes pour la production.
Notre engagement typique commence par un sprint d’une semaine : nous auditons la base de code existante, identifions la fonctionnalite IA a plus forte valeur, choisissons le bon patron d’integration parmi les cinq ci-dessus et livrons un prototype fonctionnel. A partir de la, nous iterons sur la base de donnees d’utilisation reelles, pas d’hypotheses.
Si vous evaluez l’ajout de fonctionnalites IA a votre app Rails et voulez une equipe qui connait deja le stack, voici comment Redwerk gere le developpement web sur mesure. Pour les projets specifiques a l’IA, consultez nos services de developpement IA et ML.
Lecture connexe : si vous evaluez votre base de code Rails avant d’ajouter de nouvelles fonctionnalites, notre checklist de revision de code Ruby on Rails couvre ce qu’il faut verifier.
FAQ
Rails peut-il gerer des charges de travail IA en production ?
Oui. Rails gere la couche applicative (authentification, facturation, stockage de donnees, taches de fond) tandis que l’inference reelle s’execute sur des APIs externes (OpenAI, Anthropic, Gemini). Le fournisseur LLM gere le travail de calcul intensif. Rails orchestre le workflow, gere les tentatives et livre les resultats aux utilisateurs. Des entreprises exploitant des monolithes Rails de plus de 200 000 lignes deploient des fonctionnalites IA en production aujourd’hui.
Quels gems Ruby fonctionnent le mieux pour l'integration LLM ?
Les trois meilleurs sont ruby-openai (mature, bien maintenu, supporte le streaming et les appels de fonctions), RubyLLM (support multi-fournisseur pour OpenAI, Anthropic, Gemini et d’autres avec une API unifiee) et Langchain.rb (pipelines RAG complets, patrons d’agents et appels d’outils). Pour la recherche vectorielle, le gem neighbor integre pgvector avec Active Record. Choisissez ruby-openai si vous n’utilisez qu’OpenAI, RubyLLM si vous voulez de la flexibilite entre fournisseurs.
Combien coute l'ajout de fonctionnalites IA a une app Rails existante ?
Une integration LLM basique (Patron 1 ou 2) coute typiquement de 5 000 $ a 15 000 $ en temps de developpement et prend une a deux semaines. Un systeme RAG de niveau production ou une orchestration d’agents (Patrons 3 a 5) va de 20 000 $ a 60 000 $ et prend trois a huit semaines. Les couts API continus varient selon l’utilisation : une fonctionnalite a faible trafic peut couter de 50 $ a 200 $ par mois en appels API, tandis qu’un chatbot a fort trafic peut atteindre 1 000 $ a 5 000 $ par mois.
Dois-je reecrire mon app Rails en Python pour l'IA ?
Non. La plupart des fonctionnalites IA appellent des APIs externes qui sont agnostiques au langage. Ruby a des gems matures (ruby-openai, RubyLLM, Langchain.rb) qui couvrent les memes patrons d’integration que les bibliotheques Python. Le seul scenario ou Python est veritablement meilleur est si vous devez entrainer ou affiner des modeles personnalises, ce qui est une tache separee et specialisee que la plupart des fonctionnalites IA en production ne necessitent pas.
Combien de temps prend une integration IA dans Rails ?
Un simple wrapper d’API LLM prend 1 a 2 jours. L’ajout du traitement par taches de fond prend 2 a 3 jours. Un pipeline RAG avec pgvector prend 1 a 2 semaines. Les reponses en streaming prennent 3 a 5 jours. L’orchestration complete d’agents prend 2 a 4 semaines. Ces delais supposent un developpeur Rails experimente qui connait les patrons d’integration. Si l’equipe apprend l’integration IA de zero, multipliez par 2 a 3x.
Decouvrez comment Muskelhirn a divise par deux le temps de ses operations de recrutement en numerisant le travail que les humains ne pouvaient pas gerer a grande echelle.