Une attaque par distillation de modèle ne nécessite pas d’intrusion dans vos systèmes, car vous avez divulgué la clé dès l’ouverture de votre API au public. Pour vos concurrents, le moyen le plus économique d’obtenir un modèle similaire au vôtre pourrait être votre propre produit, interrogé des milliers de fois jusqu’à ce qu’une copie, plus modeste, apprenne à répondre de la même manière. Dans vos journaux, cela ressemble à un client actif, mais pour votre entreprise, il s’agit d’une fuite progressive de la capacité d’IA que vous avez développée pendant de longs mois et pour laquelle vous avez investi des sommes considérables.
Si vous avez intégré un modèle optimisé ou conçu spécifiquement pour une API, c’est à vous d’en tenir compte, et non pas simplement d’un titre sur Frontier Labs. Rassurez-vous, vous pouvez vous en prémunir et même transformer cette technique sous-jacente en avantage en l’utilisant de manière responsable pour vos propres produits. Cet équilibre, entre la protection de votre modèle et une utilisation appropriée, est précisément au cœur de nos services de distillation de modèles. Nous allons maintenant détailler le fonctionnement de ces attaques, les signes avant-coureurs à surveiller et les mesures pratiques pour rendre votre modèle beaucoup plus difficile à cibler.
Qu'est-ce qu'une attaque par distillation de modèle en IA ?
La distillation de modèles a vu le jour comme une méthode d’apprentissage tout à fait respectable. Un modèle performant et de grande taille (le « professeur ») répond à un vaste ensemble de questions, et un modèle plus petit (l’« élève ») apprend à imiter ces réponses jusqu’à pouvoir accomplir la même tâche à moindre coût. Réalisée avec l’autorisation du système et sur des données dont vous êtes autorisé l’utilisation, cette méthode est l’une des plus efficaces pour développer un produit d’IA performant.
Une attaque par distillation de modèle reprend ce principe, mais sans autorisation. Au lieu d’entraîner le modèle sur ses propres données, un attaquant lui envoie un flux continu de questions via son API publique, enregistre chaque réponse et utilise ces paires question-réponse pour entraîner un modèle concurrent qui imite votre comportement. Imaginez que vous embauchiez quelqu’un pour travailler aux côtés de votre meilleur consultant, noter toutes ses recommandations pendant un an, puis créer une entreprise concurrente en utilisant ces notes.
L’exemple le plus flagrant remonte à février 2026. Selon NBC News, Anthropic a accusé trois sociétés d’IA d’avoir généré plus de 16 millions d’échanges avec son modèle Claude via environ 24 000 comptes frauduleux, le tout dans le but d’entraîner des systèmes concurrents. L’ampleur du phénomène était colossale, mais les mécanismes étaient ordinaires. Personne n’a forcé de serrure, on s’est contenté de poser de nombreuses questions.
Qui est réellement exposé aux risques liés aux attaques par extraction de modèles ?
Il est tentant, à la lecture d’un article sur Anthropic, de conclure que les attaques par extraction de modèles (terme générique désignant la même menace) ne concernent que les entreprises disposant de budgets de recherche de plusieurs milliards de dollars. C’est dans cette optique que de nombreux fondateurs se laissent aller à une certaine complaisance, un peu trop tôt.
Les entreprises les plus exposées sont souvent des entreprises de taille moyenne, dont l’avantage concurrentiel repose entièrement sur un modèle unique. Si vous avez passé deux ans à peaufiner un modèle à partir de données propriétaires de sinistres, de codage médical, de langage juridique ou d’optimisation logistique, ce modèle constitue votre principal atout. Il en va de même pour les entreprises qui ont intégré un modèle performant à leurs opérations quotidiennes, comme l’ont fait nombre d’équipes à l’origine de ces exemples d’API Claude pour l’automatisation des processus métier. Un concurrent capable d’obtenir un résultat similaire pour quelques milliers de dollars de ressources informatiques a en réalité évité la partie la plus coûteuse de votre parcours.
Les chiffres expliquent la tentation : par exemple, l’Institut Stanford pour l’IA centrée sur l’humain a constaté que l’entraînement d’un modèle de pointe peut coûter bien plus de 100 millions de dollars. Même un modèle spécialisé, adapté à un domaine précis, représente des mois de salaires, de licences de données et d’un réglage minutieux. La distillation permet de copier le résultat de ce travail sans en payer le coût, ce qui explique précisément son attrait pour les concurrents en quête d’un raccourci.
Si votre produit repose sur un modèle de ce type, il mérite la même protection que n’importe quel actif critique. Un bon fonctionnement et une sécurité renforcée sont étroitement liés, un sujet que nous approfondissons lorsque nous abordons la question de la mise à l’échelle des modèles d’IA sans compromettre la qualité. Les équipes qui conçoivent ou perfectionnent ces systèmes grâce à nos services de développement de modèles de langage à grande échelle intègrent généralement des mécanismes de protection dès la conception, plutôt que de les ajouter a posteriori.
Comment fonctionne une attaque par distillation de modèle via une API ?
Vous n’avez pas besoin de dévoiler le fonctionnement interne de votre modèle pour qu’il soit copié, et c’est là le problème. Un attaquant n’a besoin que de la même porte d’entrée que vos clients légitimes utilisent : votre API.
Le schéma est approximativement le suivant, volontairement simplifié. L’attaquant envoie une grande variété de questions sur de nombreux sujets, capture les réponses de votre modèle et utilise ces paires de réponses dans un modèle plus petit jusqu’à ce qu’il apprenne à répondre de la même manière. Plus les questions sont variées et nombreuses, plus la copie est fidèle. Aucun logiciel malveillant, aucun mot de passe volé et aucune base de données compromise n’interviennent dans ce processus.
C’est ce qui rend la menace si insidieuse. Votre modèle fonctionne exactement comme prévu : il répond parfaitement aux questions. Or, ce comportement même qui confère de la valeur à votre produit est précisément celui qu’un attaquant exploite. L’OWASP (Open Worldwide Application Security Project), qui tient à jour la liste de référence des risques de sécurité liés à l’IA pour le secteur, considère officiellement le vol de modèles comme une menace avérée, et ce, précisément pour cette raison. Vous n’êtes donc pas paranoïaque. Vous consultez le même registre des risques que celui utilisé par la communauté de la sécurité.
Signes avant-coureurs d'une attaque par extraction de modèle dans vos journaux d'API
Comme aucun dysfonctionnement technique n’est constaté, les preuves d’une attaque par distillation de modèle se dissimulent dans vos habitudes d’utilisation plutôt que dans vos alertes de sécurité. Un utilisateur lambda se comporte comme une personne effectuant une tâche, tandis qu’une campagne d’extraction agit comme une machine cherchant à cartographier chaque recoin de votre modèle. Une fois cette distinction établie, les signaux d’alerte deviennent facilement repérables.
Voici les schémas à surveiller dans vos journaux d’API :
- Un seul compte, ou un petit groupe de comptes flambant neufs, envoie beaucoup plus de requêtes que ce dont un utilisateur légitime aurait raisonnablement besoin.
- Les questions abordent de manière systématique des sujets sans lien apparent, comme si l’on testait toute l’étendue des connaissances de votre modèle plutôt que de résoudre un problème concret.
- Le trafic ne présente aucun rythme humain, arrivant par salves programmatiques régulières sans les pauses, les relances et les formulations confuses que produisent de vraies personnes.
- Les comptes continuent de sonder les limites des connaissances de votre modèle, en posant sans cesse des questions inhabituelles ou à la frontière des connaissances pour voir comment il réagit.
- Les inscriptions et le trafic se concentrent dans des régions ou des réseaux proxy qui ne correspondent pas aux lieux de résidence et de travail de vos clients.
Pris individuellement, chacun de ces éléments peut être inoffensif. Un nouvel utilisateur avancé peut se montrer enthousiaste, et une équipe de recherche peut poser des questions pertinentes. L’inquiétude grandit lorsque plusieurs de ces signaux apparaissent simultanément et persistent, ce qui est la marque d’une personne qui construit un ensemble de données plutôt que d’utiliser un produit.
Comment protéger votre LLM contre l'extraction
Il est impossible de rendre l’extraction impossible, car un modèle qui refuse de répondre aux questions n’est pas un modèle pour lequel on paie. En revanche, il est possible de rendre la copie du modèle suffisamment lente, coûteuse et risquée pour qu’elle devienne inenvisageable. L’approche la plus efficace consiste à combiner plusieurs défenses, de sorte que même en contournant une, un attaquant doive encore en franchir une autre.
- La limitation du débit est une première mesure judicieuse, et elle est plus efficace lorsqu’elle analyse le comportement plutôt que le seul volume brut. Un simple plafond de requêtes par minute est utile, mais des limites plus intelligentes permettent également de repérer les comptes dont les schémas de requêtes ressemblent à une cartographie systématique, puis de les ralentir ou d’ajouter des restrictions avant qu’ils ne puissent collecter des données importantes.
- La conception réfléchie des résultats est la couche la plus discrète et la plus souvent négligée. Plus votre modèle fournit de détails avec chaque réponse, notamment des scores de confiance précis et une explication détaillée du raisonnement interne, moins un attaquant aura besoin de questions pour le reconstituer. Ne renvoyer que les informations réellement nécessaires à chaque cas d’utilisation permet de minimiser les risques liés à chaque réponse.
- Le tatouage numérique ajoute une preuve supplémentaire. En intégrant des signatures statistiques subtiles aux résultats de votre modèle, vous créez un moyen de reconnaître vos propres empreintes digitales ultérieurement. Si le modèle d’un concurrent s’avère contenir ces signatures, vous détenez la preuve concrète qu’il a été entraîné sur vos réponses, ce qui est crucial si le litige est porté devant les tribunaux.
- Vos conditions d’utilisation constituent le dernier rempart juridique. Une formulation claire interdisant l’utilisation de vos résultats pour entraîner des modèles concurrents transforme un acte technique anodin en une violation de contrat susceptible de donner lieu à des poursuites.
Intégrer tout cela dans un produit nécessite une planification, et c’est le genre de travail que nos services de développement d’intelligence artificielle prennent en charge en parallèle du modèle lui-même, de sorte que la sécurité fait partie intégrante de la conception plutôt que d’être un correctif appliqué ultérieurement.
Est-il légal de s'inspirer du modèle d'IA d'une autre entreprise ?
Voilà la question qui rend le sujet vraiment complexe, et la réponse honnête est : cela dépend. La distillation, en tant que technique, est parfaitement légale et largement utilisée, y compris par les entreprises mêmes qui la critiquent. Le problème réside rarement dans la méthode elle-même. Tout dépend de la manière dont les données ont été obtenues et des règles convenues au cours du processus.
La plupart des fournisseurs d’IA commerciale incluent dans leurs conditions générales d’utilisation une interdiction d’utiliser leurs résultats pour développer des modèles concurrents. Lorsqu’une entreprise ignore cette clause et extrait malgré tout le modèle, il s’agit d’une rupture de contrat qui, selon les circonstances, peut également relever du secret commercial et du droit de la concurrence déloyale. Le litige entre OpenAI et DeepSeek, toujours en cours à ce jour, porte sur ces questions plutôt que sur l’acte d’extraction lui-même.
Pour vous, propriétaire d’un modèle, la conclusion pratique est simple : des conditions d’utilisation claires et explicites n’empêcheront pas physiquement une attaque, mais elles vous confèrent un recours légal lorsque des filigranes ou des journaux révèlent ce qui s’est passé. La législation en la matière étant encore en évolution, les entreprises qui documentent clairement leurs mesures de protection aujourd’hui seront bien mieux armées demain.
Distillation responsable et éthique
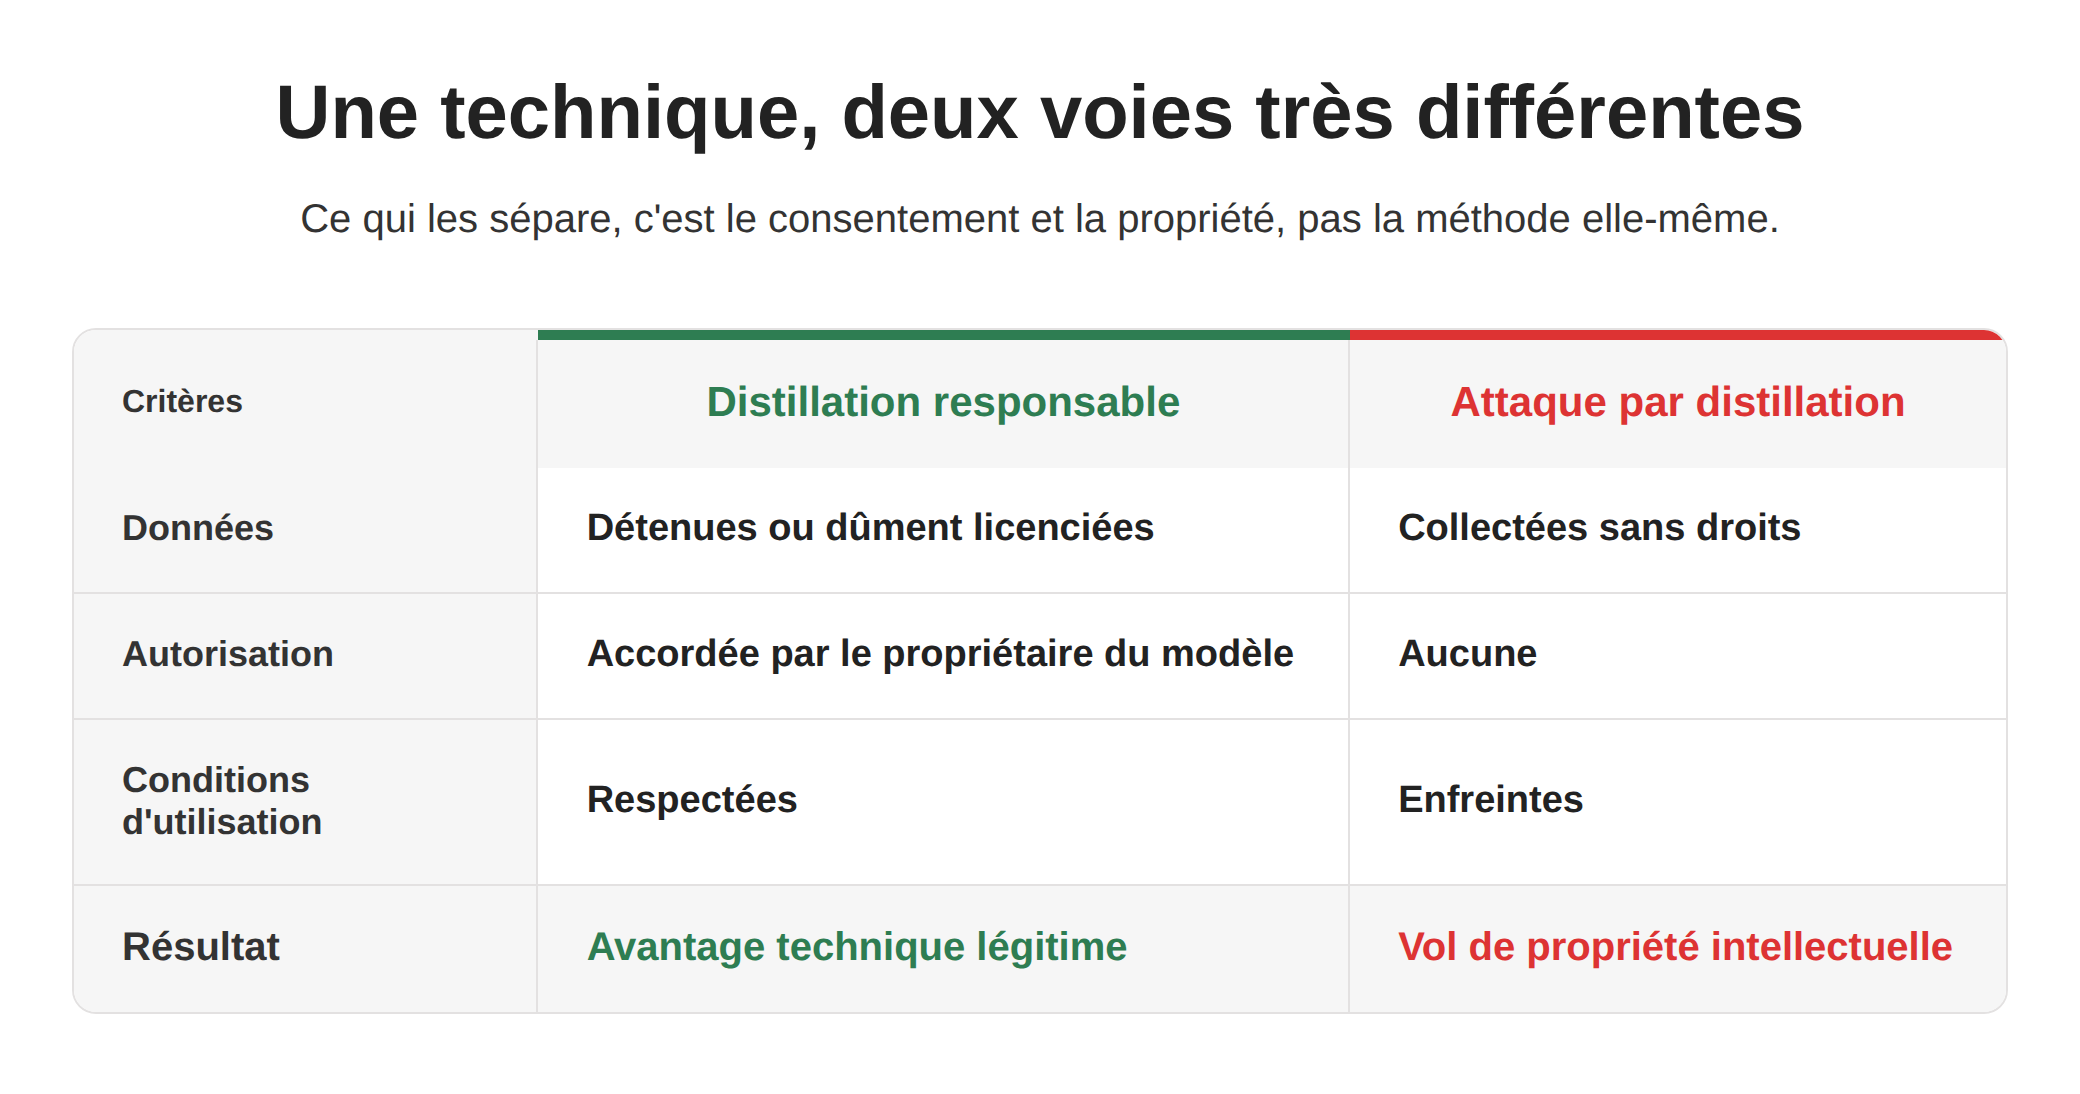
Il serait dommage de conclure à la crainte d’une attaque par distillation de modèle. La technique sous-jacente est la même que celle qui permet de construire une version allégée, moins chère et plus rapide d’un modèle dont vous êtes légitimement propriétaire. La différence entre l’exemple à ne pas suivre et la réussite tient au consentement et à la propriété.
La distillation responsable repose sur quelques principes clairs :
- Vous effectuez une distillation à partir d’un modèle que vous avez le droit d’utiliser, qu’il s’agisse de votre propre système ou d’un système dont le fournisseur l’a explicitement autorisé.
- Vous vous entraînez sur des données dont vous êtes propriétaire ou pour lesquelles vous disposez des licences nécessaires.
- Vous respectez les conditions d’utilisation liées à chaque modèle concerné, au lieu de les considérer comme un obstacle à contourner.
Lorsqu’elle est appliquée avec rigueur, la distillation devient un véritable atout technique, et nous explorons ses performances dans notre guide sur les techniques d’optimisation de l’inférence des grands modèles de langage.
C’est cet aspect de notre travail qui nous tient le plus à cœur. Qu’il s’agisse de vous aider à optimiser votre modèle pour réduire ses coûts d’exécution ou de mettre en place des systèmes de protection pour empêcher toute copie non autorisée de votre travail, notre objectif reste le même : nous considérons votre modèle comme l’atout précieux qu’il représente. Les équipes qui font appel à nous pour le développement d’agents d’IA constatent souvent qu’une distillation appropriée permet d’obtenir des résultats plus clairs et plus faciles à maintenir, avec l’avantage non négligeable de protéger leur travail.
Il est important de se rappeler qu’une attaque par distillation de modèle est un vol insidieux. Aucune faille spectaculaire n’est constatée, seulement une fuite progressive des fonctionnalités que vous avez développées avec soin et investissement en temps et en argent. Si vous exposez un modèle important ou si vous souhaitez utiliser la distillation de manière responsable pour créer une solution plus légère, nous serions ravis de vous aider. Nos services de distillation de modèles couvrent ces deux aspects : la protection de votre travail et la création responsable des fonctionnalités dont vous avez besoin. Alors appelez-nous et discutons de la meilleure approche pour vous.
FAQ
Qu'est-ce qu'une attaque par distillation de modèle en IA ?
Une attaque par distillation de modèle se produit lorsqu’une personne interroge de manière répétée votre modèle d’IA via son API publique, enregistre les réponses et utilise ces paires question-réponse pour entraîner un modèle concurrent qui imite le vôtre. Aucun système n’est compromis. L’attaquant utilise simplement votre modèle comme n’importe quel client, mais à grande échelle et dans le but de le copier.
Quelqu'un pourrait-il copier mon modèle d'IA via l'API ?
Oui, du moins dans une certaine mesure. Un attaquant ne peut pas récupérer votre code source exact ni vos pondérations via l’API, mais il peut reproduire le comportement de votre modèle avec une précision suffisante pour lancer un produit concurrent. La fidélité de la copie dépend du nombre de requêtes envoyées et de la quantité de détails que vos réponses révèlent.
Comment protéger mon LLM contre l'extraction ?
Combinez plusieurs systèmes de défense plutôt que de vous fier à un seul.
- Utiliser la limitation de débit tenant compte du comportement
- Ne renvoyez que le niveau de détail nécessaire à chaque cas d’utilisation.
- Apposez un filigrane sur vos documents afin de pouvoir prouver ultérieurement le vol.
- Rédigez des conditions d’utilisation interdisant explicitement l’entraînement de modèles concurrents sur vos réponses.
Conjuguées, ces méthodes rendent l’extraction lente, coûteuse et risquée sur le plan juridique.
Est-il légal de s'inspirer du modèle d'une autre entreprise ?
La distillation en elle-même est légale et courante. Les problèmes surviennent lorsqu’une entreprise distille un modèle en violation des conditions d’utilisation de son fournisseur ou utilise abusivement des données auxquelles elle n’a pas droit. Dans ces cas, il peut s’agir d’une rupture de contrat, voire d’une atteinte au secret commercial ou d’une pratique de concurrence déloyale. Le cadre juridique est encore en évolution, comme le montre le litige en cours entre OpenAI et DeepSeek.
Quelle est la différence entre la distillation de modèles et l'extraction de modèles ?
Ils décrivent la même menace sous des angles légèrement différents. L’extraction de modèle est le terme général désignant le vol du comportement d’un modèle par interrogation de son API, tandis qu’une attaque par distillation de modèle fait spécifiquement référence à l’utilisation des réponses récupérées pour entraîner un modèle élève plus petit qui imite le modèle original. Dans le langage courant, les deux termes sont utilisés indifféremment.
Découvrez comment nous avons aidé Evolv, une plateforme basée sur l'IA, à repenser son produit phare et à réaliser plus de 20 lancements réussis