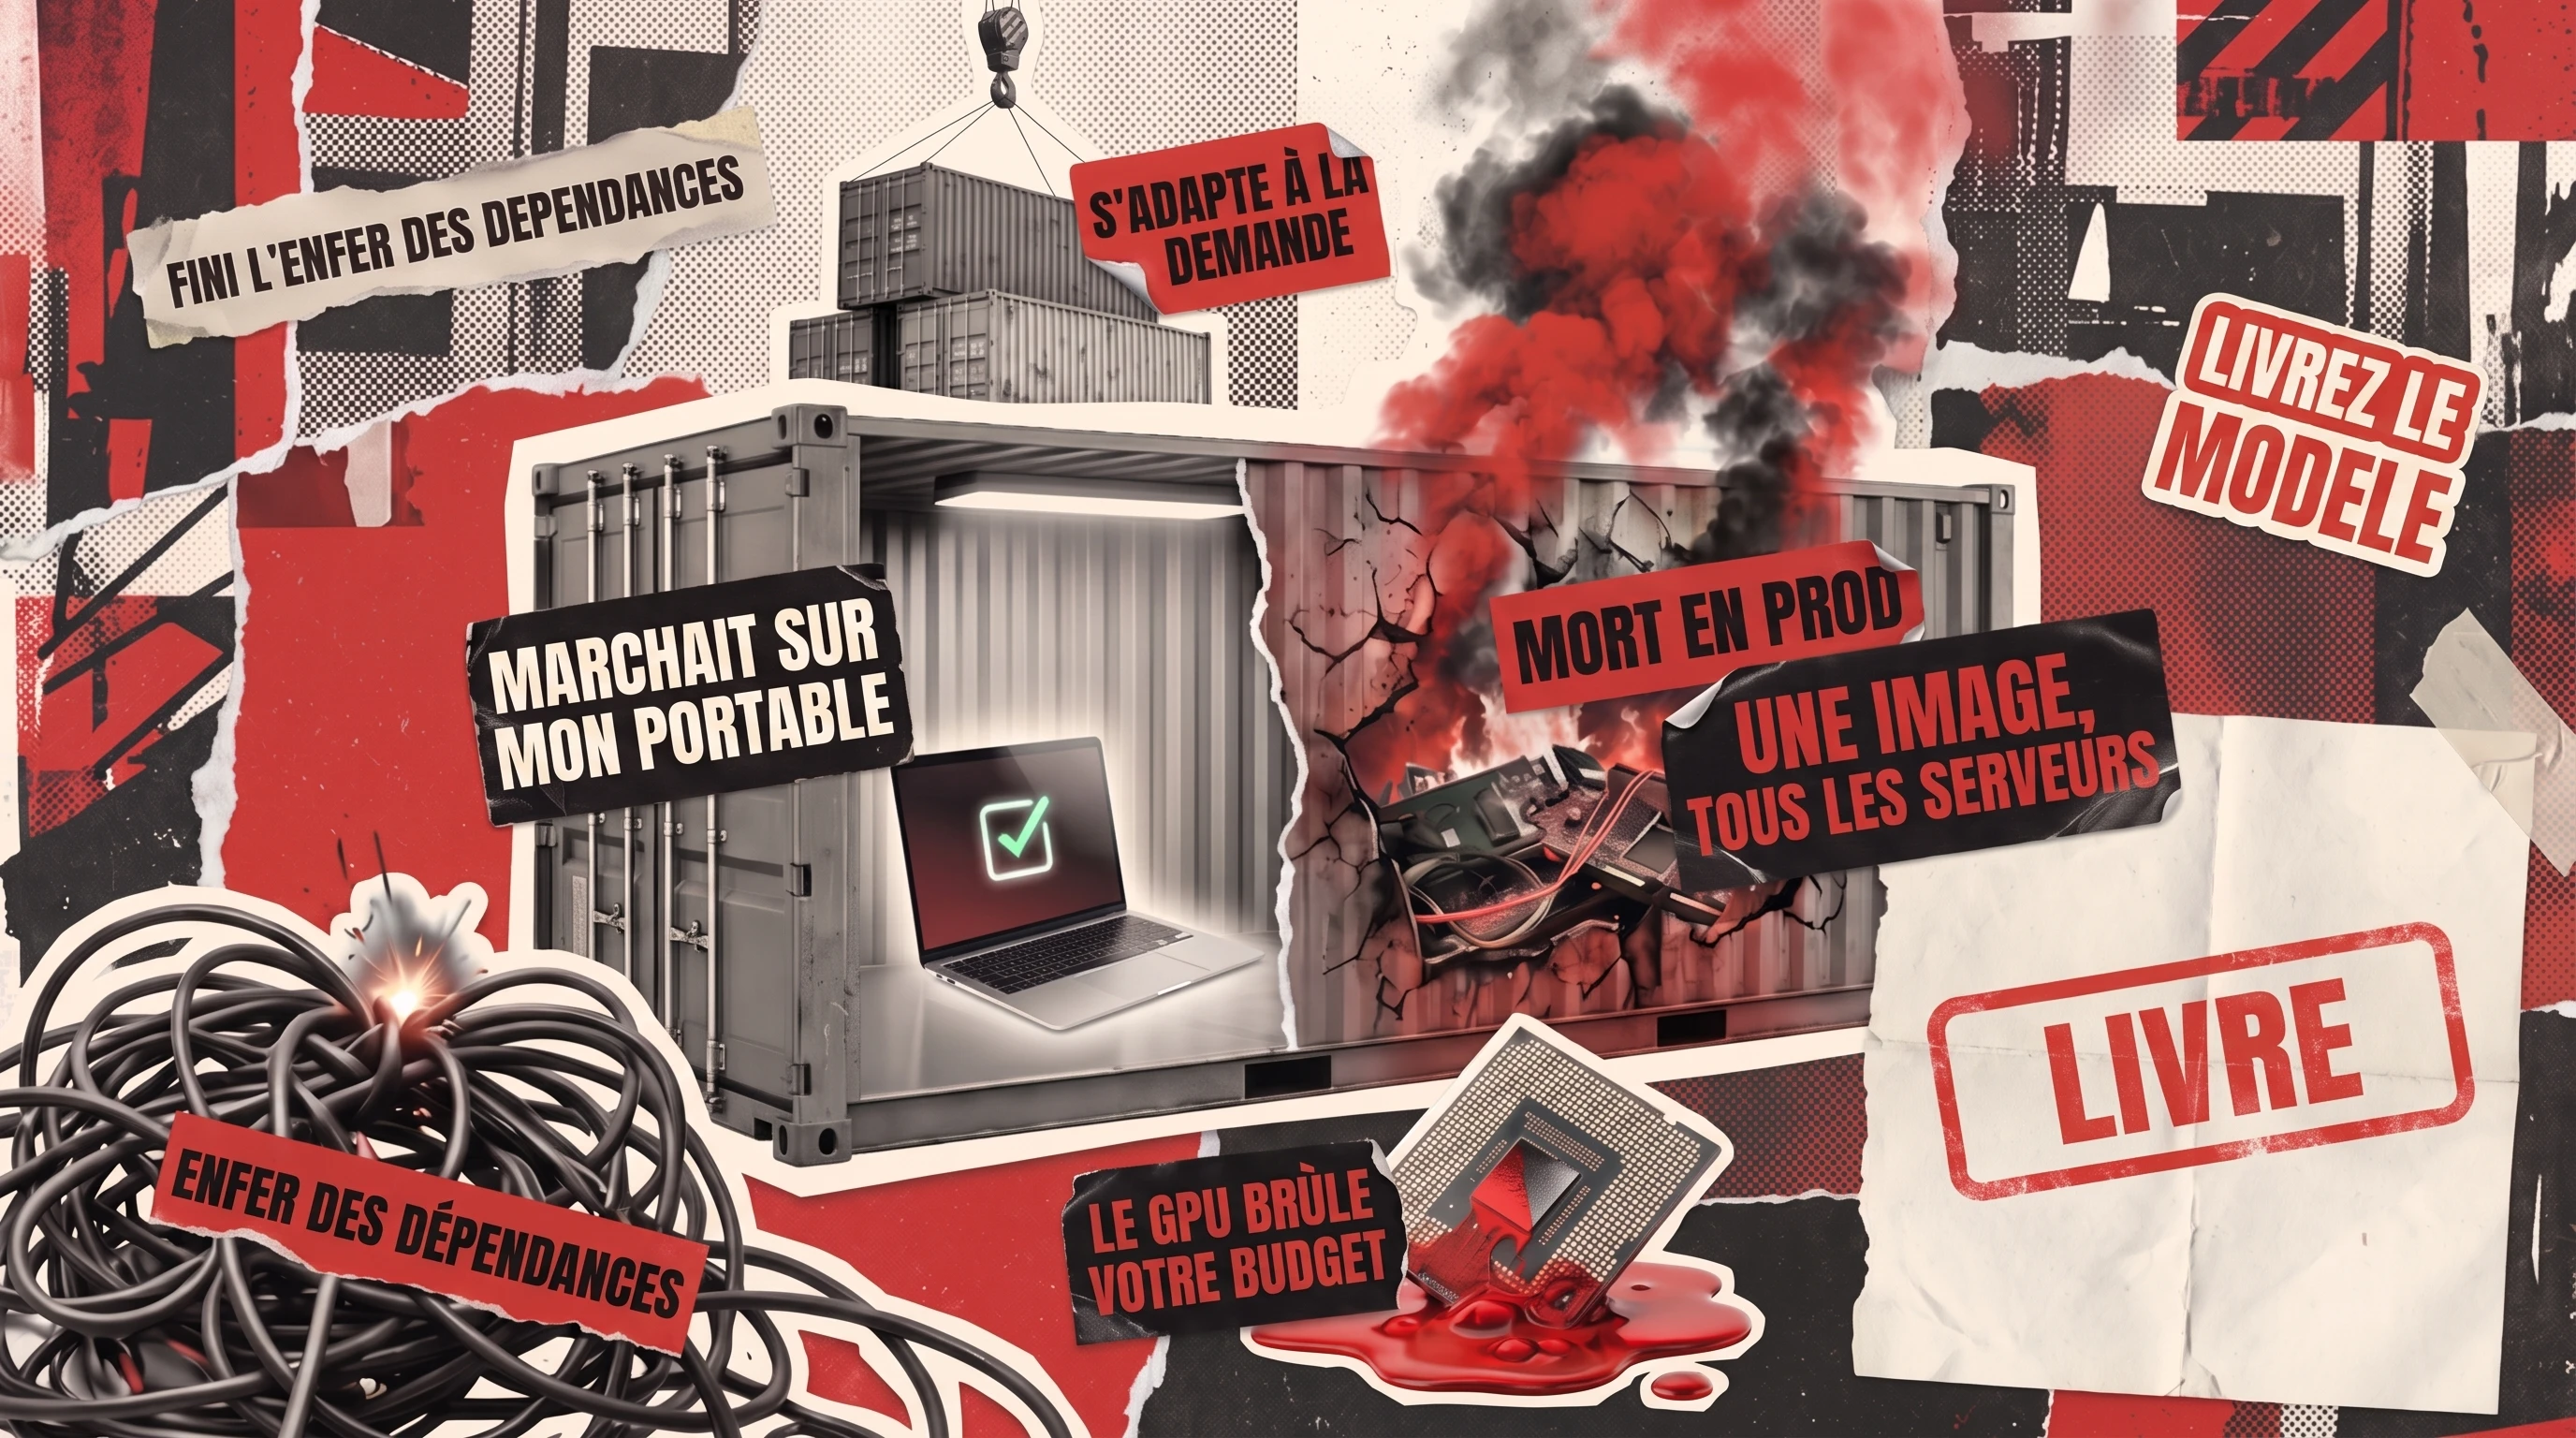
Votre équipe de data science a entraîné un modèle qui fonctionne sur ses ordinateurs portables. Maintenant, un product manager le veut en production dans l’application avant la fin du trimestre, et les deux parties n’arrivent pas à s’accorder sur la façon de le livrer. Cet écart, entre un modèle qui tourne dans un notebook et un modèle qui sert de vrais utilisateurs, est l’endroit où la plupart des fonctionnalités d’IA calent.
Pour déployer des modèles d’IA avec Docker, vous empaquetez le modèle, son runtime et chaque dépendance dans une seule image de conteneur, vous l’exposez derrière une API d’inférence et vous exécutez cette image sur une plateforme de conteneurs telle que Kubernetes ou un service de conteneurs managé. Docker rend le modèle reproductible et portable, de sorte qu’il se comporte de la même façon sur un ordinateur portable, en staging et en production, quelle que soit la version de Python ou de CUDA de l’hôte.
Ce guide explique comment cela fonctionne étape par étape, ce que cela coûte en temps d’ingénieur, quand un conteneur est le mauvais outil et les erreurs précises que nous voyons les équipes commettre la première fois qu’elles mettent un modèle en production.
Que signifie déployer un modèle d'IA avec Docker ?
Un conteneur Docker est un environnement léger et isolé qui regroupe votre modèle avec tout ce dont il a besoin pour fonctionner : l’interpréteur Python, le framework de ML tel que PyTorch, TensorFlow ou ONNX Runtime, les bibliothèques système et les poids du modèle eux-mêmes. Vous décrivez cet environnement une seule fois dans un fichier texte appelé Dockerfile, vous le construisez en une image, et vous exécutez des copies de cette image en tant que conteneurs.
Déployer un modèle d’IA avec Docker signifie transformer votre modèle entraîné en l’une de ces images et l’exécuter comme un service que d’autres systèmes appellent. Au lieu d’exiger que chaque serveur dispose de la bonne version de Python et des pilotes CUDA, vous livrez un artefact autonome qui les contient déjà. L’hôte n’a besoin que de Docker.
Le résultat est un service d’inférence : une petite API qui prend une entrée (une chaîne de texte, une image, une ligne de caractéristiques), la fait passer par le modèle et renvoie une prédiction. Tout ce dont le modèle a besoin voyage à l’intérieur de l’image.
Pourquoi déployer des modèles d'IA avec Docker plutôt que sur un serveur nu ?
Quatre raisons reviennent sur presque chaque projet.
Reproductibilité. Un modèle de ML est sensible aux versions des bibliothèques. Un modèle entraîné avec PyTorch 2.1 peut se comporter différemment, ou ne pas se charger, sous la 2.3. L’image fige chaque version, de sorte que le modèle que vous avez testé est le modèle qui s’exécute.
Isolation des dépendances. Les charges d’IA entraînent des dépendances lourdes et conflictuelles : CUDA, cuDNN, des builds NumPy spécifiques. Les conteneurs gardent la pile de chaque modèle séparée, si bien que deux modèles aux exigences différentes tournent sur le même hôte sans se gêner.
Parité entre les environnements. Le classique problème du « ça marche sur ma machine » disparaît. La même image s’exécute sur l’ordinateur portable d’un développeur, sur un cluster de staging et en production, ce qui rend les bugs reproductibles et les rollbacks instantanés.
Mise à l’échelle et récupération. Quand le trafic grimpe, la plateforme démarre davantage de copies de l’image. Quand un conteneur plante, il est remplacé en quelques secondes à partir du même artefact fiable et connu.
Comment déployer un modèle d'IA avec Docker, étape par étape ?
Le chemin d’un modèle entraîné vers un service en fonctionnement compte six étapes. Le schéma ci-dessous montre toute la séquence, et les sections qui le suivent expliquent les parties qui font trébucher les équipes.
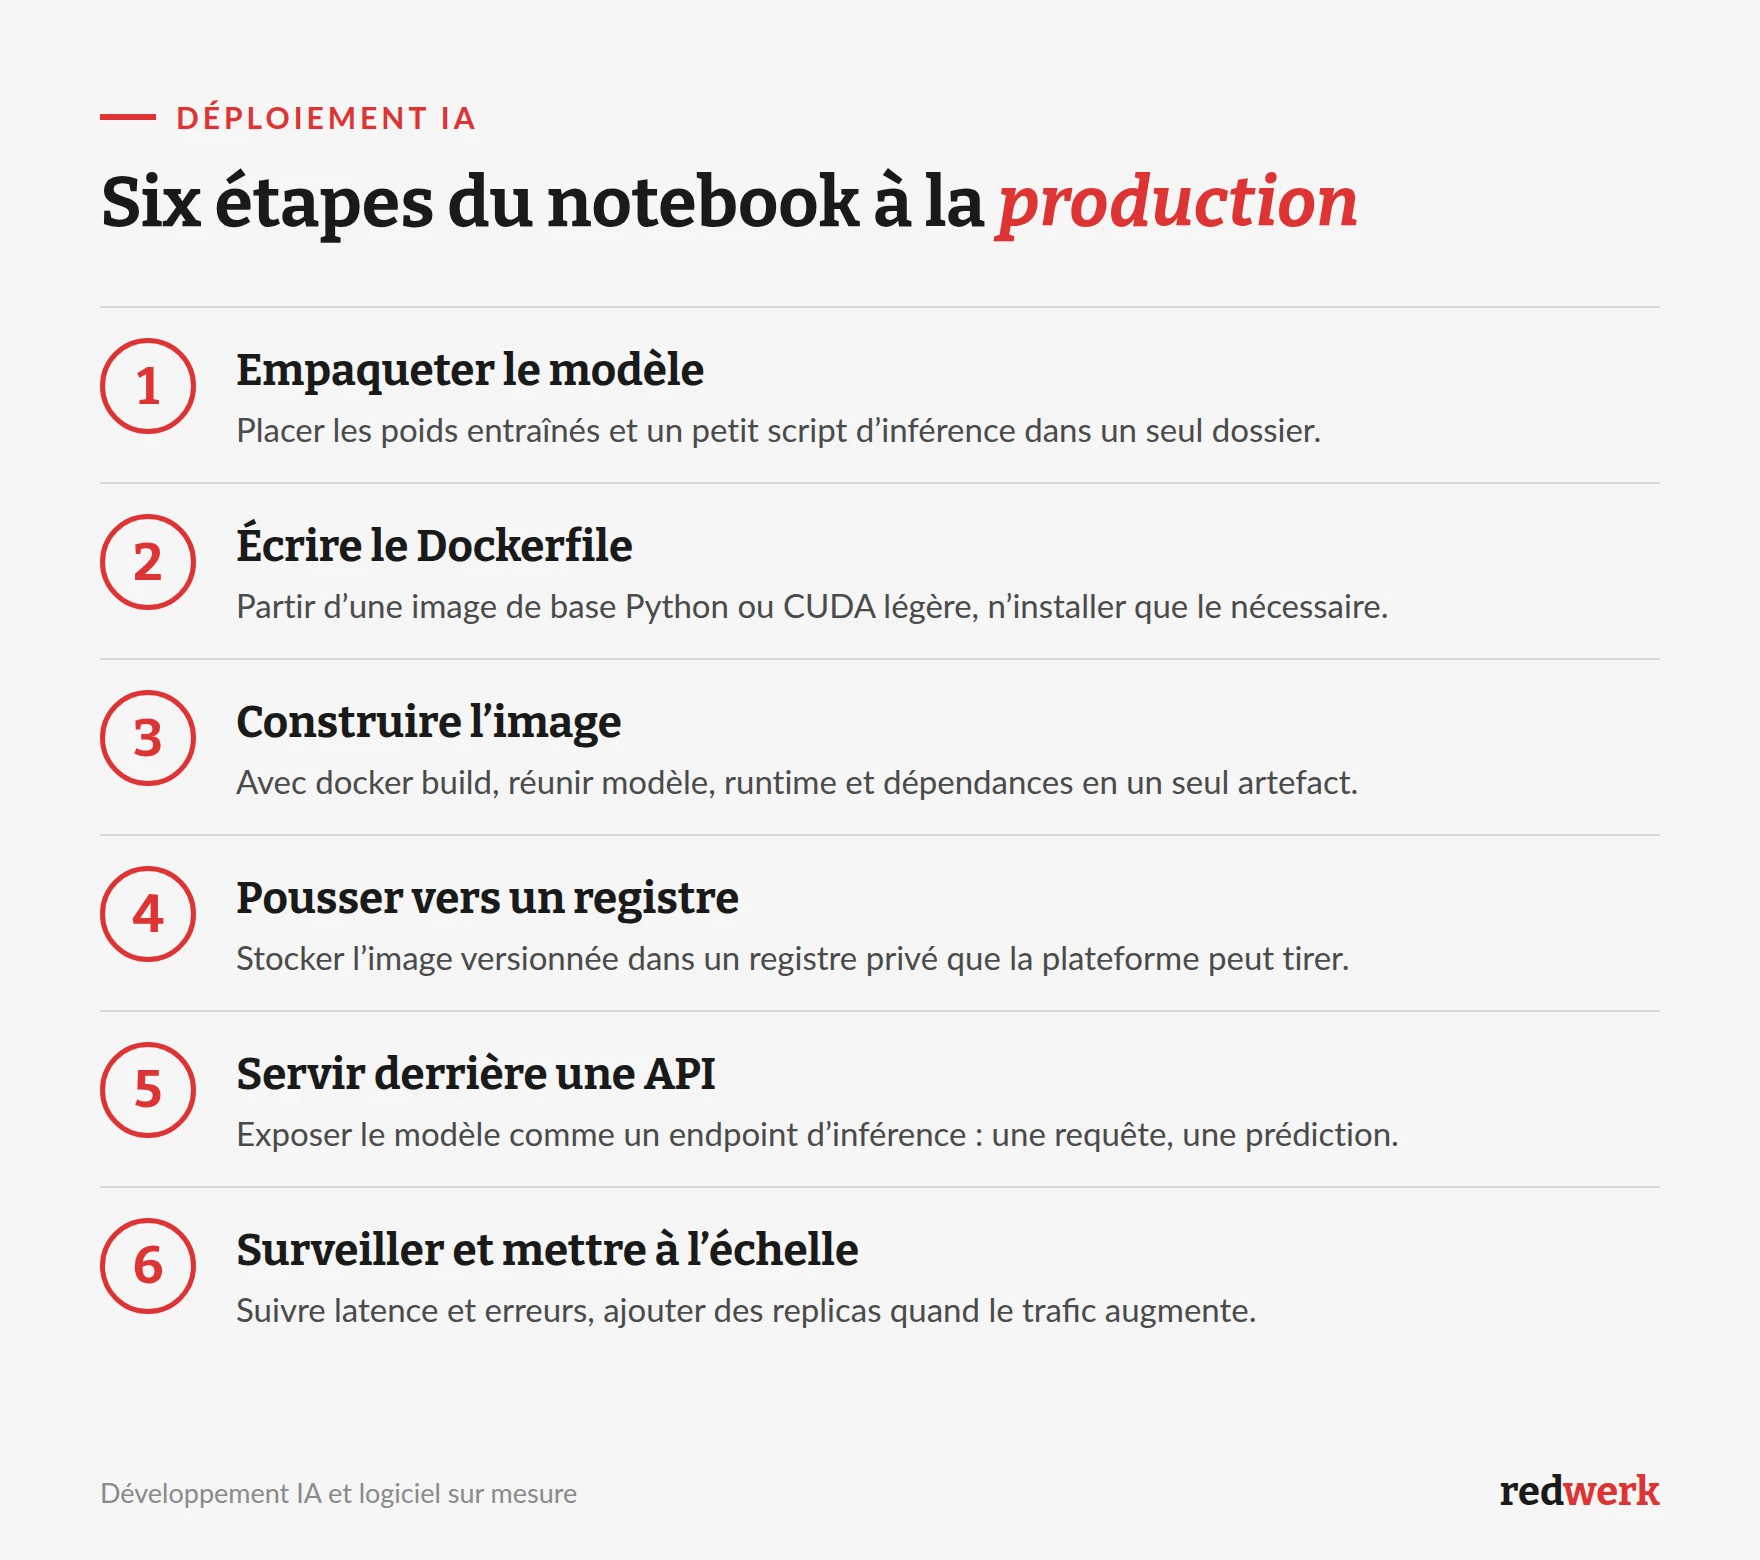
1. Empaquetez le modèle. Exportez les poids entraînés vers un format portable tel qu’un fichier .pt ou .onnx et écrivez un petit script d’inférence qui charge les poids et expose une fonction de prédiction.
2. Écrivez le Dockerfile. Choisissez une image de base. Pour l’inférence CPU, une image Python slim maintient la taille réduite. Pour l’inférence GPU, partez d’une image de base officielle NVIDIA CUDA pour que les pilotes concordent. N’installez que les bibliothèques dont le modèle a besoin à l’inférence, pas toute la pile d’entraînement.
3. Construisez l’image. Lancez le build, qui exécute le Dockerfile et intègre le modèle, le runtime et les dépendances dans un unique artefact versionné.
4. Poussez-la vers un registre. Stockez l’image dans un registre de conteneurs privé tel qu’Amazon ECR, Google Artifact Registry ou Azure Container Registry depuis lequel votre plateforme de production peut la récupérer.
5. Servez-la derrière une API. Enveloppez le modèle dans un serveur web tel que FastAPI ou TorchServe pour que d’autres services puissent envoyer des requêtes et recevoir des prédictions via HTTP.
6. Supervisez et mettez à l’échelle. Suivez la latence, les taux d’erreur et, pour les charges GPU, la mémoire. Ajoutez des répliques à mesure que le trafic augmente et revenez au tag d’image précédent si un nouveau modèle se comporte mal.
# Image d'inference CPU pour un modele PyTorch servi avec FastAPI
FROM python:3.11-slim

WORKDIR /app

# Installer uniquement les dependances d'inference, pas la pile d'entrainement
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copier les poids du modele et le code d'inference
COPY model/ ./model/
COPY app.py .

# Une requete entre, une prediction sort
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
Pour un modèle GPU, le seul changement significatif est l’image de base. Remplacez python:3.11-slim par une image nvidia/cuda et installez le build GPU de votre framework. Le code de l’application reste identique.
Conteneurs CPU ou GPU : de quoi votre modèle a-t-il besoin ?
Tous les modèles n’ont pas besoin d’un GPU en production, et les GPU sont le poste de coût unique le plus élevé dans la plupart des déploiements d’IA. La règle empirique est d’adapter le conteneur au budget de latence réel du modèle, pas au matériel sur lequel vous avez entraîné.
Idéal pour
Modèles plus petits, classification de texte, modèles tabulaires, faible volume de requêtes
Grands modèles de langage, modèles d’image ou de vidéo, débit élevé
Image de base
python:slim, environ 150 Mo
nvidia/cuda, 1 à 3 Go
Coût
Faible, tourne sur du calcul standard
Élevé, nécessite des instances GPU facturées à l’heure
Effort de configuration
Minimal
NVIDIA Container Toolkit plus l’appariement des pilotes
Adéquation typique
Modèles où la latence CPU est acceptable
Quand l’inférence CPU est trop lente pour l’utilisateur
Docker face au serverless face aux endpoints de modèles managés
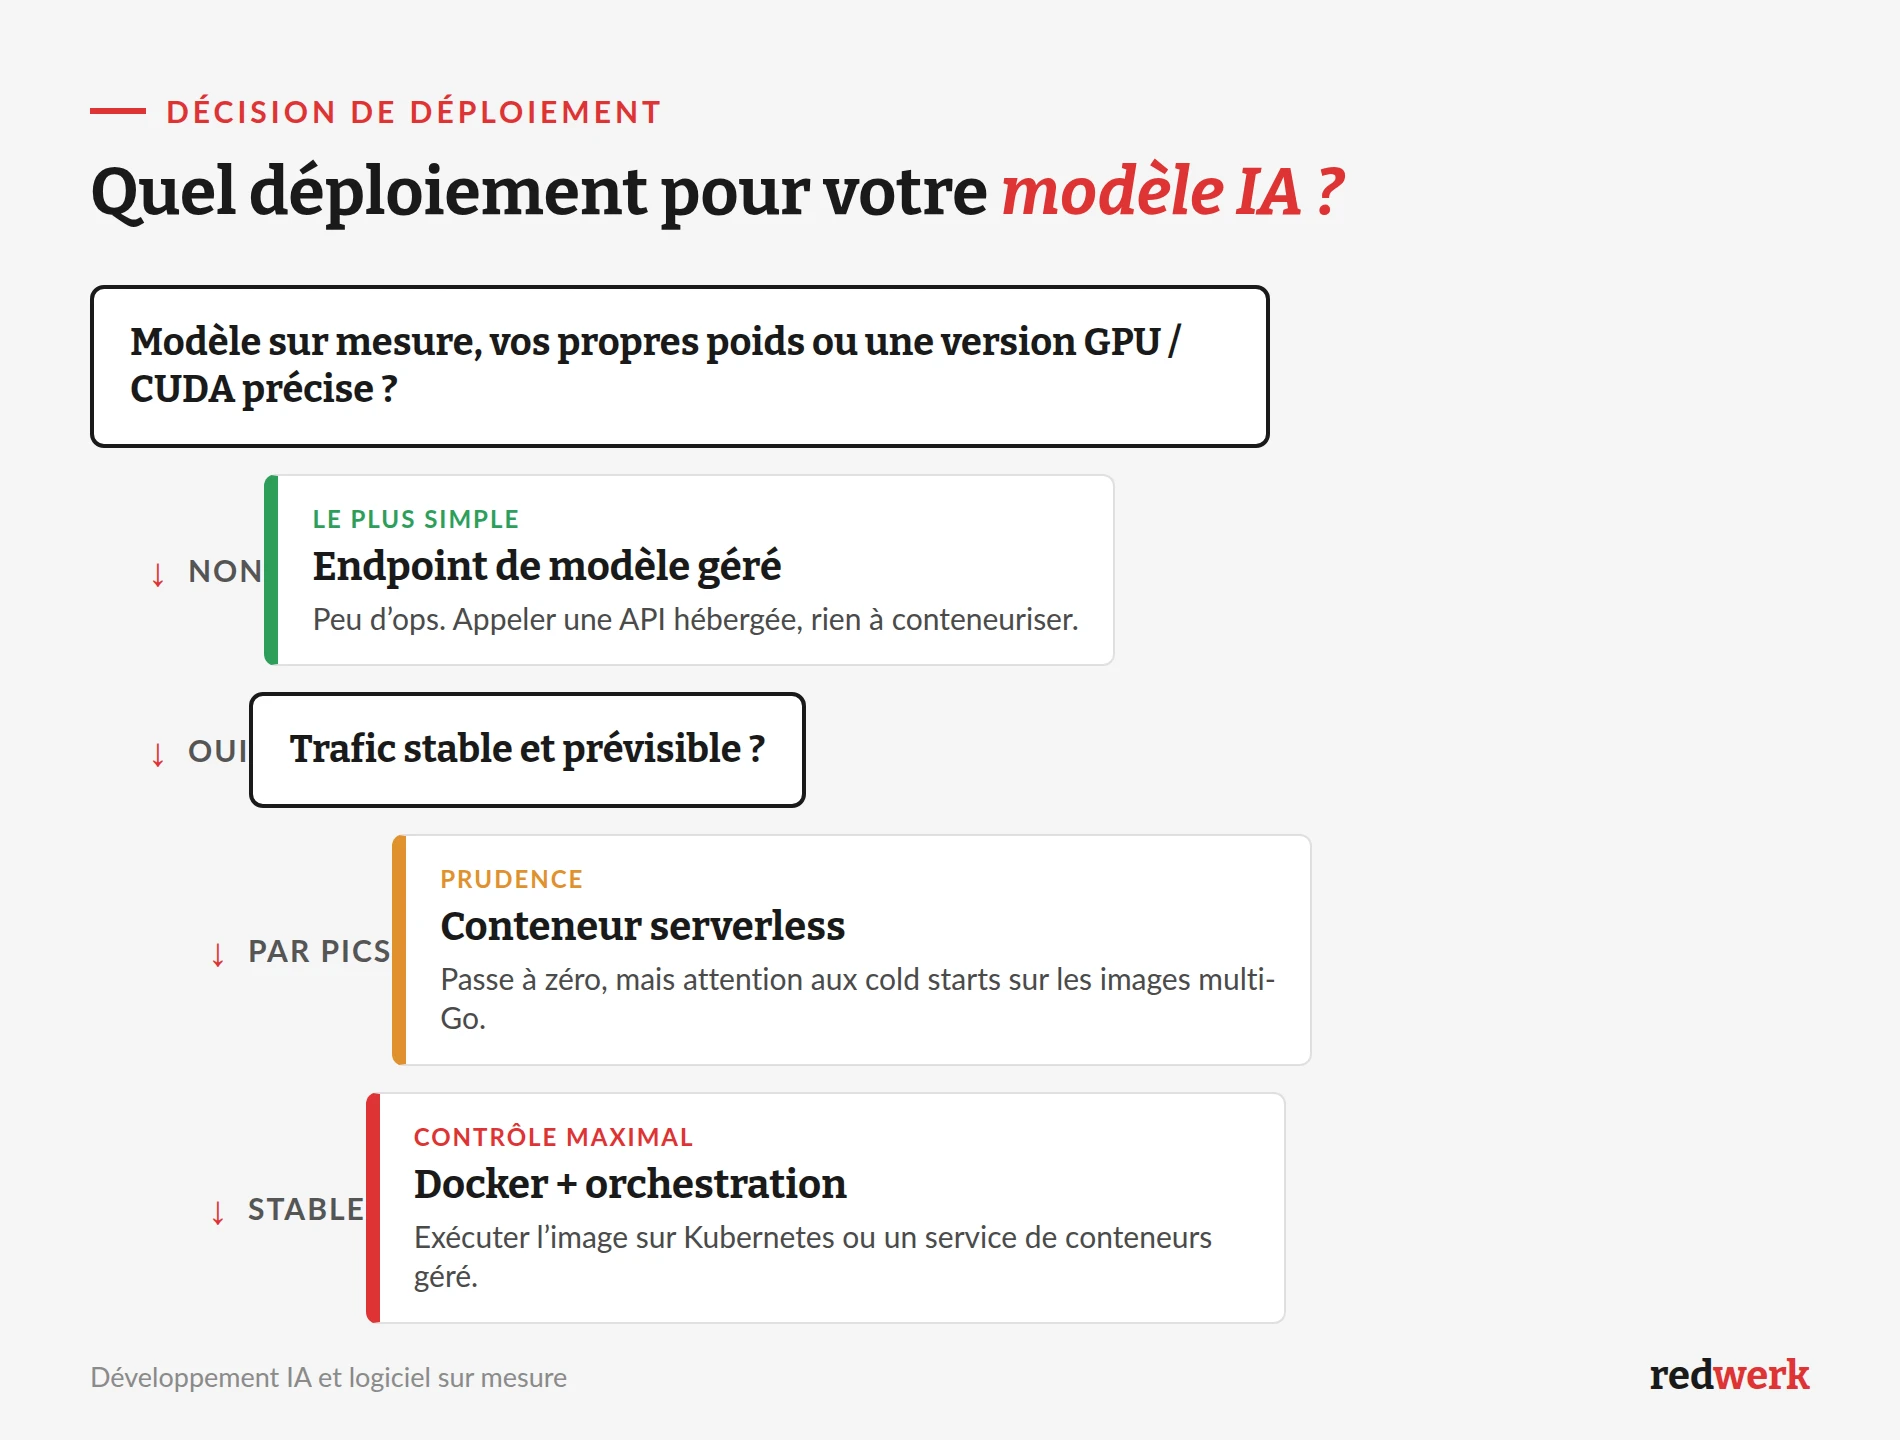
Docker n’est pas la seule façon de livrer un modèle, et ce n’est pas toujours la moins chère. Voici comment se comparent les trois options courantes, et le schéma après le tableau en fait une décision rapide.
Contrôle
Total
Moyen
Faible
Effort d’exploitation
Le plus élevé
Moyen
Le plus faible
Modèle de coût
Paiement pour les instances en fonctionnement
Paiement à la requête, mise à l’échelle jusqu’à zéro
Paiement à l’appel ou à l’heure
Démarrages à froid
Aucun une fois en fonctionnement
Peuvent atteindre des secondes sur de grandes images
Rares
Meilleur choix quand
Trafic stable, modèles personnalisés ou GPU
Trafic irrégulier ou occasionnel
Utilisation d’un modèle de fondation hébergé
Quand Docker est-il le mauvais choix pour le déploiement d'IA ?
Les conteneurs sont le choix par défaut pour les modèles personnalisés, mais ils ne sont pas gratuits, et il existe des cas où recourir d’abord à Docker est une erreur.
Vous ne faites qu’appeler un modèle hébergé. Si votre fonctionnalité est une surcouche autour de l’API d’un modèle de fondation hébergé, il n’y a pas de modèle à conteneuriser. Appelez l’API depuis votre backend existant et sautez la couche supplémentaire.
Le trafic est rare et imprévisible. Un modèle qui sert une poignée de requêtes par jour ne justifie pas un conteneur toujours actif ni son coût au repos. Un conteneur serverless ou un endpoint managé qui se met à l’échelle jusqu’à zéro est généralement moins cher, tant que vous pouvez tolérer un démarrage à froid.
L’image est énorme et la latence est critique. Les images GPU avec des piles CUDA complètes peuvent atteindre plusieurs gigaoctets. Si un pull à froid ajoute des secondes que vous ne pouvez pas vous permettre, il vous faut des pools chauds et des images pré-téléchargées, ce qui ajoute du coût et de la complexité.
Personne n’est responsable de la plateforme. Docker plus Kubernetes, c’est de la vraie infrastructure. Si vous n’avez personne pour prendre en charge la mise à l’échelle, les correctifs de sécurité et le contrôle des coûts, un service managé vous servira mieux jusqu’à ce que vous en ayez un. Être honnête là-dessus dès le départ fait économiser beaucoup d’argent.
Comment Redwerk déploie des modèles d'IA pour les équipes du mid-market
La plupart des équipes qui viennent nous voir ne manquent pas du modèle. Elles ont un prototype qui fonctionne et un chemin vers la production au point mort, généralement parce que les personnes qui ont entraîné le modèle ne sont pas celles qui exploitent l’infrastructure. C’est exactement cet écart que nous comblons.
Redwerk mobilise des ingénieurs qui connaissent déjà la pile précise, que ce soit PyTorch sur CUDA, ONNX Runtime ou un service d’inférence Python derrière Kubernetes, si bien que nous sommes productifs en quelques jours plutôt que de passer des semaines à monter en compétence sur votre outillage. Lors d’un projet de développement d’IA, nous avons repris une plateforme d’optimisation par IA en cours de construction et l’avons menée jusqu’au lancement en production, en prenant en charge la conteneurisation, l’API d’inférence et la supervision que l’équipe initiale n’avait pas encore atteintes.
Nous le faisons aussi sans exiger de spécification finalisée. Si vous connaissez le résultat dont vous avez besoin mais pas l’architecture exacte, nous la définissons avec vous et vous tenons informés tout du long, ce qui compte quand les personnes qui approuvent le travail ne sont pas celles qui lisent le Dockerfile.
Si votre pile est en .NET, consultez .NET Core face à .NET Framework pour les conteneurs Docker pour le choix du runtime. Quand vous voulez une équipe senior qui sait déjà mettre des modèles en production, voici comment Redwerk construit et déploie l’IA dans les produits SaaS.
FAQ : déployer des modèles d'IA avec Docker
Combien de temps faut-il pour conteneuriser un modèle d'IA ?
Pour un seul modèle avec un chemin d’inférence clair, un service conteneurisé prêt pour la production prend généralement à un ingénieur senior de deux à quatre semaines, y compris l’API, la configuration du registre et une supervision de base. Une preuve de concept sommaire peut tourner en un jour ou deux, mais l’écart entre « tourne dans un conteneur » et « sûr en production » est là où passe l’essentiel du temps.
Ai-je besoin de Kubernetes pour exécuter des modèles d'IA dans Docker ?
Non. Kubernetes en vaut la peine quand vous exploitez de nombreux modèles ou avez besoin d’une mise à l’échelle automatique et d’auto-réparation. Pour commencer, un seul conteneur sur un service de conteneurs managé tel qu’AWS App Runner, Google Cloud Run ou Azure Container Apps est plus simple et souvent suffisant. Vous pourrez passer à Kubernetes plus tard sans changer l’image.
Quelle est la taille d'une image Docker typique d'un modèle d'IA ?
Les images CPU construites sur une base Python slim font souvent de 200 Mo à 1 Go. Les images GPU qui incluent le toolkit CUDA atteignent couramment 3 à 8 Go, et les poids du modèle s’ajoutent par-dessus. Les builds multi-étapes et les images de base slim sont les principaux leviers pour contenir la taille.
Puis-je exécuter de l'inférence GPU dans un conteneur Docker ?
Oui. Avec le NVIDIA Container Toolkit installé sur l’hôte, les conteneurs peuvent accéder directement au GPU. Vous partez d’une image de base NVIDIA CUDA, installez le build GPU de votre framework et exécutez le conteneur avec l’accès GPU activé. Le code du modèle ne change pas entre CPU et GPU.
Découvrez comment Redwerk a repris le développement central d'une plateforme d'optimisation par IA et l'a mené jusqu'au lancement réussi du produit