La plupart des équipes découvrent ce qu’un agent d’IA coûte vraiment environ six mois après sa mise en production, lors de la réunion où quelqu’un propose de le désactiver. La construction était la partie abordable. L’heure coûteuse est consacrée à expliquer pourquoi l’agent a émis deux remboursements pour une seule commande, pourquoi personne ne peut reconstituer sa décision, et qui a autorisé la permission à l’origine de cela. La gouvernance des agents d’IA en entreprise est ce qui rend cette réunion brève, et c’est une décision d’architecture plutôt qu’une politique rédigée après coup.
Traitez-la comme une couche de supervision à quatre éléments mobiles : qui définit le périmètre de l’agent, qui peut l’arrêter en pleine tâche, qui remarque quand ses permissions s’étendent, et ce qui se passe le jour où il faut s’en débarrasser. Chaque élément a besoin d’un responsable, d’un mécanisme et d’un test. Les négliger revient à payer le même agent deux fois, une fois pour le construire et une fois pour le retirer des flux de travail construits autour de lui. C’est la couche que notre travail d’entreprise de développement d’agents d’IA intègre dès le premier jour, plutôt que de traiter la supervision comme un ajout après coup une fois l’agent déjà en production.
Le paradoxe du retour en arrière dans la gouvernance des agents d'IA en entreprise
Les chiffres de retour en arrière sont pires que ce que la plupart des conseils d’administration imaginent. Une étude relayée par Customer Experience Dive en mai 2026, s’appuyant sur une enquête menée auprès de plus de 2500 décideurs seniors, a révélé que les trois quarts des entreprises ont déjà annulé ou désactivé un agent d’IA en contact avec les clients après sa mise en production. Les raisons invoquées relèvent davantage du contrôle que de la capacité : près d’un tiers a cité l’exposition de données clients, 22 % les hallucinations ou le risque de marque, et 16 % l’incapacité à diagnostiquer ce que l’agent avait fait.
Un détail change la manière de lire ce chiffre : parmi les organisations dotées des cadres de gouvernance les plus matures, le taux de retour en arrière grimpe à 81 %. Les équipes plus matures détectent les défaillances plus tôt et retirent l’agent pendant que les dégâts sont encore limités, si bien qu’un retour en arrière y est la preuve que la supervision fonctionne. Les équipes sans couche de supervision signalent moins de retours en arrière parce qu’elles l’apprennent plus tard, généralement par un client.
Cela redéfinit l’objectif pour quiconque exploite des agents d’IA en production. Le but est un retour en arrière peu coûteux et sans drame, de la même façon qu’un bon pipeline transforme l’annulation d’une mauvaise version en une décision de cinq minutes. Les entreprises qui sont allées le plus loin en confiant des workflows entiers à des agents logiciels ont tendance à avoir les sorties les mieux répétées.
Trois défaillances de gouvernance derrière les données de retour en arrière
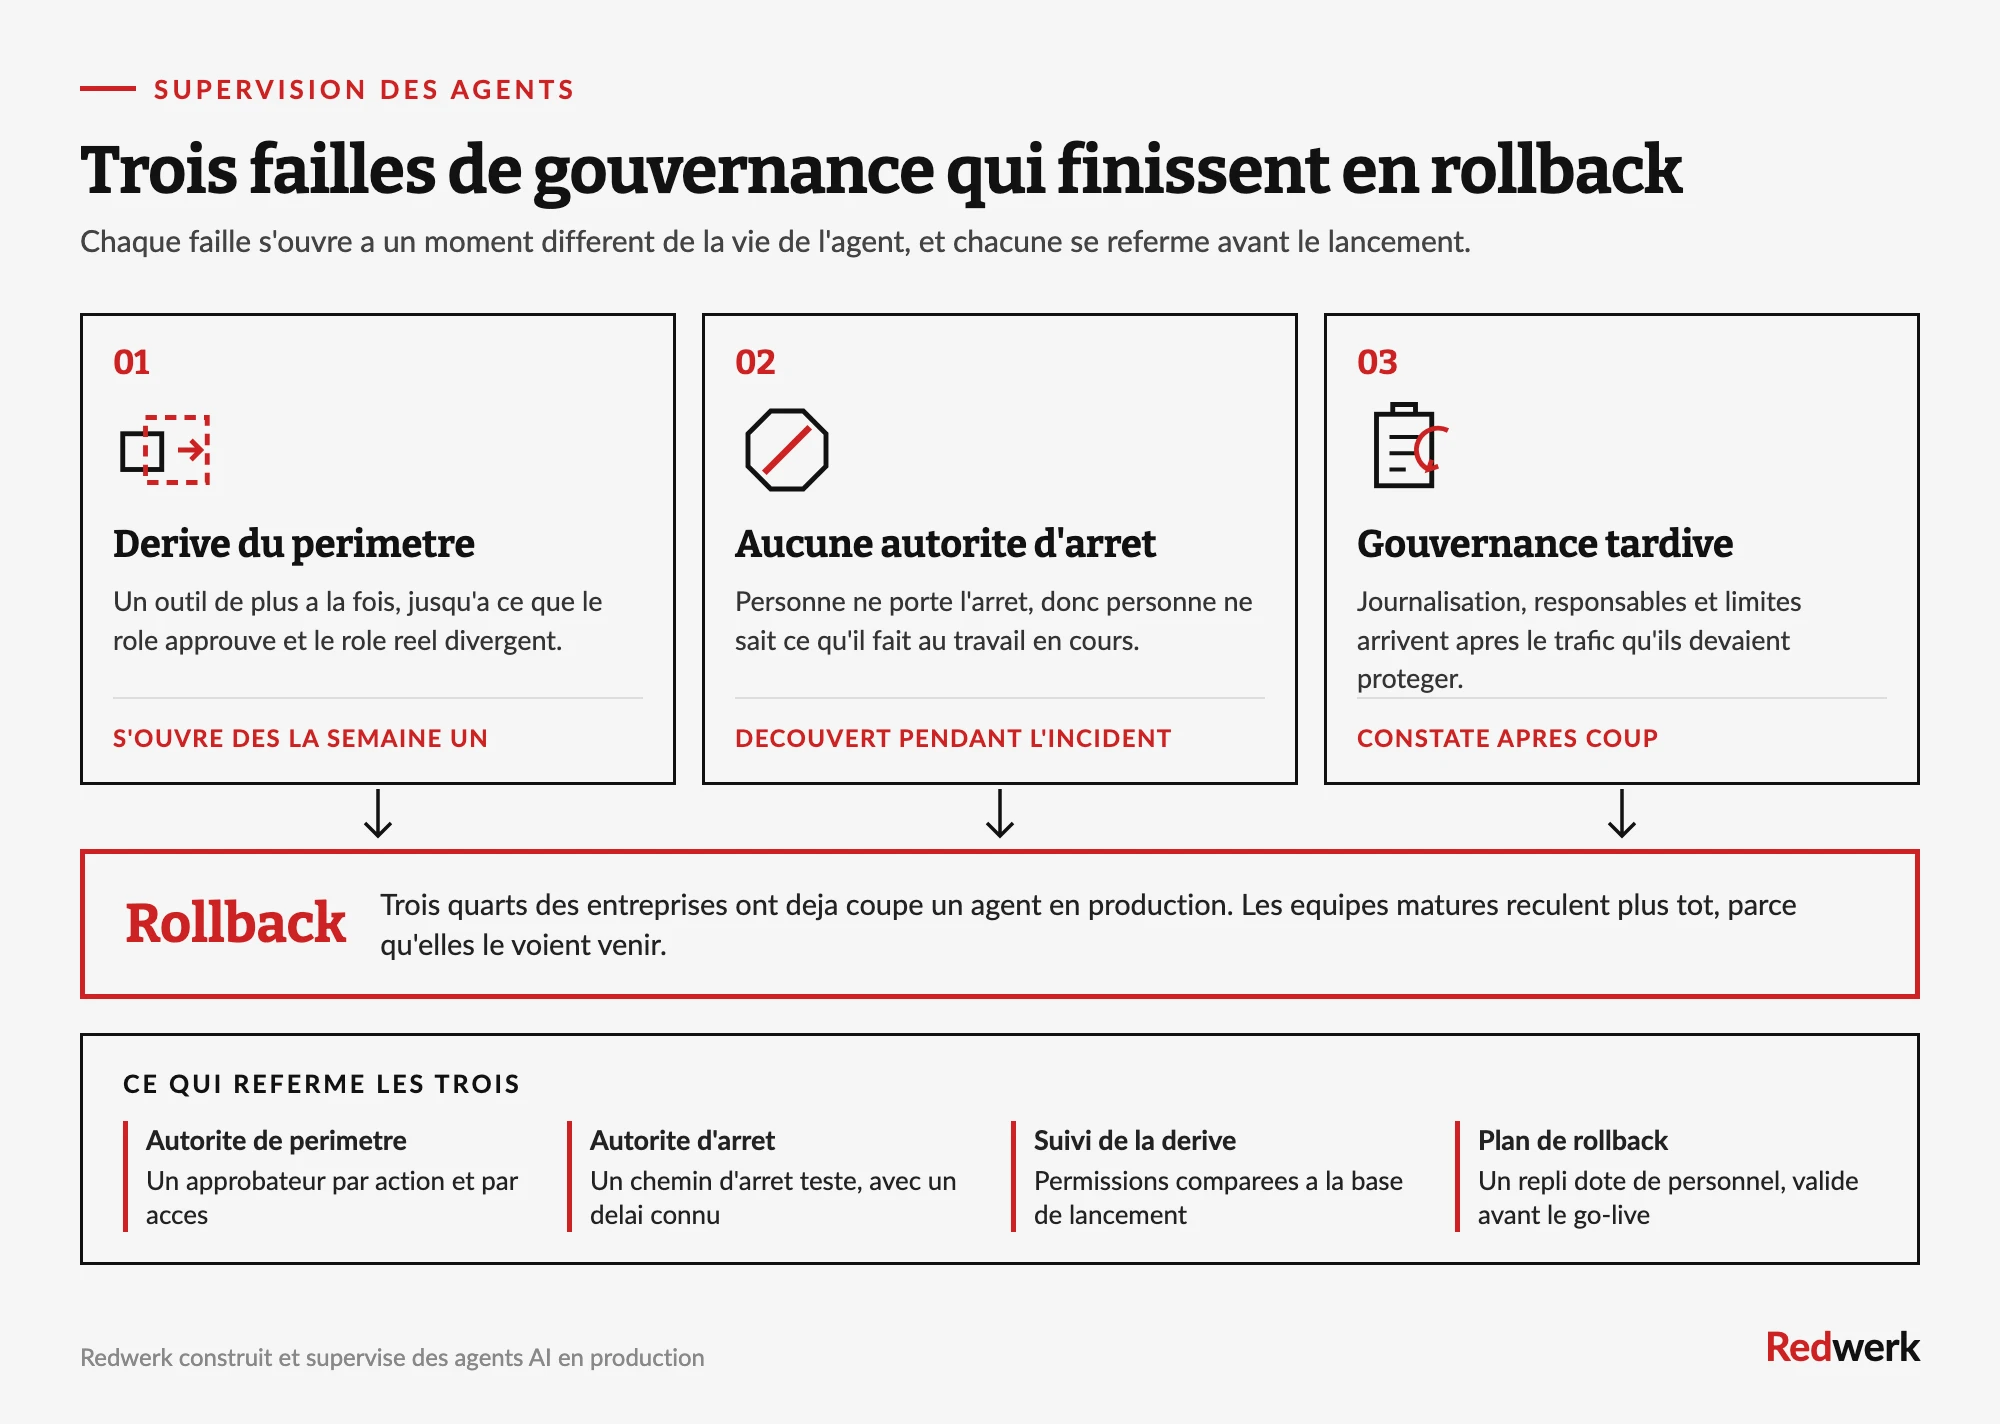
Les causes de retour en arrière sont consignées comme des incidents techniques et, une fois triées, s’alignent comme autant de lacunes de gouvernance. Le rapport State of AI in the Enterprise 2026 de Deloitte, issu d’une enquête menée fin 2025, a révélé qu’une seule entreprise sur cinq dispose d’un modèle mature pour gouverner les agents d’IA autonomes. Cela laisse quatre entreprises sur cinq improviser face aux trois défaillances ci-dessous, et une gouvernance sérieuse des agents d’IA referme ces trois failles avant l’exécution de la première tâche en production.
Dérive de périmètre
La dérive de périmètre commence comme un service rendu. L’agent avait été approuvé pour répondre aux questions sur le statut des commandes, puis quelqu’un remarque qu’il pourrait aussi traiter des remboursements simples, ajoute un outil de paiement, et le périmètre double sans nouvelle approbation. Six semaines plus tard, il exécute quatre tâches, dont trois n’ont fait l’objet d’aucune revue.
La cause mécanique est que le périmètre réside dans un prompt et un ensemble d’outils, et les deux sont faciles à modifier. Un prestataire à qui l’on remet les clés d’une seule pièce ne peut pas repeindre tout l’étage sans se faire remarquer, alors qu’un agent auquel on confie un outil supplémentaire double sa portée en une seule pull request. Les équipes qui considèrent les agents comme un moyen d’ajouter de la capacité sans ajouter d’effectifs sont les premières touchées, car chaque tâche absorbée ressemble à un meilleur retour sur la même construction.
Aucune autorité pour arrêter l'agent
L’autorité d’arrêt est une question distincte du périmètre, et elle se découvre au pire moment possible. L’Institute for Business Value d’IBM, qui a interrogé 2000 cadres dirigeants technologiques avec Oxford Economics entre janvier et avril 2026, a constaté que deux tiers des DSI et directeurs techniques sont responsables de systèmes d’IA qu’ils ne contrôlent pas entièrement, et 70 % déclarent que les équipes déploient plus vite que l’IT ne peut suivre. Une responsabilité sans interrupteur est un problème d’équité pour celui qui la porte et un problème de sécurité pour tous les autres.
Posez trois questions avant que des agents d’IA d’entreprise n’entrent en contact avec un client. Qui peut arrêter cet agent à 2h du matin un samedi, que devient le travail déjà en cours lors de l’arrêt, et combien de temps faut-il pour qu’un arrêt atteigne chaque file d’attente et chaque intégration. La plupart des équipes répondent à la première avec assurance et calent sur la deuxième.
Gouvernance ajoutée après le lancement
La troisième défaillance est une question de séquencement. La supervision ajoutée après le lancement hérite de tous les raccourcis pris auparavant, ce qui explique pourquoi la piste d’audit ne démarre si souvent que la semaine suivant l’incident qui a donné à tout le monde envie d’en avoir une. Dans la même étude IBM, seuls 11 % des dirigeants technologiques se disaient pleinement prêts pour l’ampleur du déploiement d’agents qu’ils anticipent d’ici un an.
Ajouter la supervision après coup coûte plus cher que de l’intégrer dès le départ, tout comme ajouter des tests à du code non testé coûte plus cher que de les écrire en même temps. Le déploiement d’agent d’IA qui survit à sa première année disposait généralement, dès le premier jour, d’une journalisation, d’un chemin d’arrêt et d’un responsable nommé, autant d’éléments peu coûteux avant qu’il n’y ait un trafic réel à protéger.
L'autorité sur le périmètre comme premier garde-fou
L’autorité sur le périmètre signifie qu’une personne nommément désignée approuve par écrit ce que l’agent peut faire, au niveau de chaque action individuelle. Elle est propriétaire de la liste, si bien que tout ajout devient une décision portant un nom plutôt qu’une modification de configuration silencieuse. Quatre caractéristiques distinguent une véritable définition de périmètre d’une fiche de poste :
- Une liste blanche des actions autorisées. Écrivez « lit les dossiers de facturation, rédige des réponses, escalade les litiges vers une file d’attente humaine » plutôt que « traite les questions de facturation ».
- Une liste noire explicite couvrant les actions adjacentes que l’on demandera plus tard, comme émettre des avoirs, modifier des dossiers clients ou envoyer des e-mails en dehors du titulaire du compte.
- Un approbateur nommé par outil et par identifiant, consigné à côté de l’octroi, de sorte qu’élargir le périmètre exige une conversation avec une personne précise.
- Les changements de périmètre examinés comme des changements de code, via la même pull request, le même relecteur et le même journal.
De bons garde-fous pour agents d’IA sont ennuyeux précisément de cette manière, car ils transforment « l’agent a décidé de » en « quelqu’un a approuvé qu’il puisse ». Convenir tôt de cette liste d’approbateurs fait la différence entre un déploiement gouverné et une négociation menée en pleine panne, ce qui explique pourquoi le travail de transformation agentique de la main-d’œuvre par l’IA commence par cartographier qui est responsable de quelle action.
Une intervention en temps réel qui arrête vraiment
« Arrêter l’agent » recouvre en réalité trois mécanismes, et les équipes qui n’en construisent qu’un seul découvrent l’écart pendant un incident. Suspendre la prise en charge de nouvelles tâches laisse le travail en cours se terminer. Interrompre les tâches en cours laisse des séquences à moitié achevées, un remboursement enregistré sans sa notification, un ticket clos sans son avoir. Révoquer les identifiants arrête tout instantanément, y compris les parties qui fonctionnaient correctement.
Un cordon d’arrêt de chaîne de montage est un meilleur modèle qu’un interrupteur d’alimentation, car il arrête la ligne dans un état connu, chaque poste conservant sa pièce. Pour un agent, cela signifie des actions idempotentes, des étapes compensatoires qui défont une séquence à moitié terminée, et une file d’attente qui survit à l’arrêt pour que rien ne soit perdu. Une gouvernance efficace de l’IA agentique traite ce chemin comme une fonctionnalité livrée, avec ses propres tests et son propre responsable.
Ensuite, entraînez-vous. Le chemin d’arrêt mérite le même exercice qu’une restauration de base de données, effectué selon un calendrier, avec quelqu’un qui chronomètre le temps entre la décision et l’arrêt complet. Les équipes qui l’intègrent dès le départ à leur travail de développement d’IA font remonter tôt les cas délicats, généralement une API tierce sans point de terminaison d’annulation et une file d’attente qui continue joyeusement à redistribuer.
Surveillance de la dérive lors de l'expansion des permissions
L’autorité sur le périmètre fixe la limite, et l’autorité d’arrêt la fait respecter sur le moment. La surveillance de la dérive est l’instrument au ralenti qui vous indique que la limite s’est déplacée. Le chiffre qui mérite un tableau de bord est l’écart entre les outils, périmètres et identifiants que l’agent détenait au lancement et ceux qu’il détient aujourd’hui.
Trois signaux permettent de repérer la dérive tant qu’elle reste peu coûteuse à corriger. Le nombre de permissions dans le temps rend visible la progression insidieuse, en particulier lorsqu’un octroi temporaire pour une migration ponctuelle n’a jamais expiré. La répartition des actions effectuées, semaine après semaine, montre quand un agent de support se met à consacrer 30 % de ses appels à un outil de paiement qu’il touchait à peine le premier mois. Les journaux d’audit par action, contenant chacun l’entrée, l’outil appelé et le motif, sont ce qui rend un incident diagnosticable, ce qui compte lorsque 16 % des retours en arrière s’expliquent par le fait que personne ne peut dire ce que l’agent a fait.
Fixez une date d’expiration à chaque permission temporaire dès son octroi, et passez en revue l’ensemble chaque mois. Un déploiement d’agent d’IA d’entreprise bien instrumenté affiche la dérive en une seule vue, de sorte que cette revue prend vingt minutes et produit une courte liste d’octrois à révoquer. Sans cette vue, cela devient un projet d’archéologie et cesse de se produire dès le troisième mois.
Le plan de retour en arrière comme condition de lancement
La réversibilité fait partie des critères de lancement, aux côtés du seuil de précision dont tout le monde discute. Les migrations de bases de données sont livrées avec une migration de retour, et les agents méritent la même discipline. Un plan de retour en arrière rédigé le jour du lancement est un document, alors qu’un plan rédigé pendant un incident n’est qu’une supposition.
Un plan exploitable répond à cinq questions : les seuils de déclenchement qui lancent la discussion, la personne qui tranche, la solution de repli qui absorbe le travail, les étapes de réconciliation pour les actions déjà effectuées, et la communication client qui sera envoyée. Notez en particulier l’hypothèse d’effectifs. Les équipes qui ont réaffecté les personnes remplacées par l’agent découvrent qu’un retour en arrière signifie reconstruire une équipe, ce qui explique qu’il vaille la peine de conserver une solution de repli opérationnelle pendant les deux premiers trimestres.
L’honnêteté sur les limites compte ici. Certaines actions ne peuvent être annulées à aucun coût raisonnable, notamment l’argent déjà transféré, les e-mails déjà envoyés et les enregistrements qu’un système partenaire a déjà consommés. Celles-ci doivent se trouver derrière une étape d’approbation humaine, et les distinguer de celles qui sont réversibles fait partie de la question plus large de transformation numérique sur ce qu’un logiciel peut faire de sa propre initiative.
La checklist en quatre volets pour la supervision des agents d'IA
Quatre questions déterminent si un agent survit à sa première année de trafic réel. Chacune nécessite un responsable, un mécanisme et des preuves que l’on pourrait montrer à un auditeur, et tout « on gère ça de manière informelle » signale la faille qui produira le prochain retour en arrière.
Autorité sur le périmètre
Quelles actions spécifiques cet agent peut-il effectuer, et qui a approuvé chacune d’elles ?
Une liste blanche et une liste noire écrites, avec un approbateur nommé pour chaque outil et chaque identifiant.
Autorité d’arrêt
Qui peut l’arrêter, en combien de temps, et qu’advient-il du travail déjà en cours ?
Un chemin d’arrêt testé, avec un délai documenté entre la décision et l’arrêt complet.
Surveillance de la dérive
Ses permissions ou son comportement ont-ils changé depuis le lancement ?
Une vue de l’écart de permissions par rapport à la référence de lancement, plus une revue mensuelle avec les révocations consignées.
Plan de retour en arrière
Si nous le retirons demain, qu’est-ce qui absorbe le travail ?
Un runbook validé avec des seuils de déclenchement, un décideur nommé et une solution de repli dotée en personnel.
Appliquez cela à un agent que vous avez déjà en production. Le résultat habituel est trois lignes remplies et un blanc honnête, et c’est dans ce blanc qu’attend le prochain incident.
La couche de supervision en pratique
Le travail sur les agents qui arrive jusqu’à nous se présente à l’un de ces deux moments. Parfois avant la première tâche en production, quand une équipe veut que la couche de supervision soit conçue en même temps que l’agent. Plus souvent après une pause, quand une version prometteuse a été désactivée et doit revenir sous une forme que les responsables des risques accepteront.
Une mise à niveau commence par un inventaire, car presque personne ne dispose d’une liste à jour des outils, identifiants et données auxquels son agent peut accéder. À partir de là, l’ordre reste constant : ajouter une journalisation par action, tester le chemin d’arrêt, rédiger la liste blanche et la liste noire avec un approbateur nommé pour chaque octroi, puis rédiger le runbook de retour en arrière et le répéter.
Une limite honnête mérite d’être posée sur la table. Si le travail de l’agent ne peut pas s’écrire sous la forme d’une liste bornée d’actions, la supervision ne le sauvera pas, et la bonne approche consiste à restreindre le périmètre du travail jusqu’à ce que ce soit possible. Un agent de support qui répond aux questions de facturation et escalade tout le reste est gouvernable dès cette semaine, tandis qu’un agent à qui l’on demande de « gérer la relation client » dérivera quel que soit le niveau de surveillance en place. Les équipes de Redwerk sont généralement sollicitées pour la stack qu’un client exploite déjà, ce qui explique pourquoi ce travail s’inscrit dans la même pratique de développement logiciel d’entreprise que les services .NET ou Python que l’agent appelle, et non dans une filière distincte réservée à l’IA.
Les entreprises qui maintiennent leurs agents en production sont rarement celles qui disposent des meilleurs modèles. Ce sont celles qui peuvent répondre sur-le-champ à quatre questions : ce qu’il peut faire, qui peut l’arrêter, s’il a changé depuis le lancement, et ce qui absorbe le travail s’il disparaît. Ces réponses sont peu coûteuses avant le lancement et coûteuses à reconstituer après un incident, et elles distinguent un pilote qui passe à l’échelle d’un pilote discrètement désactivé. Si vous envisagez ce travail pour quelque chose que vous avez déjà construit, ou sur le point d’être mis en production, parlez à notre équipe et nous cartographierons à quoi ressemblerait la couche de supervision sur votre stack.
FAQ
Qu'est-ce que la gouvernance des agents d'IA en entreprise ?
Il s’agit de l’ensemble des contrôles qui déterminent ce qu’un système autonome peut faire au sein d’une entreprise : qui approuve chaque capacité, qui peut l’arrêter en pleine tâche, comment ses permissions sont surveillées après le lancement, et comment il est retiré. En pratique, cela réside dans le code, les octrois d’accès et les runbooks plutôt que dans un document de politique.
Comment gouverner les agents d'IA en production ?
Confiez à une personne nommée la propriété de la liste blanche des actions, livrez un chemin d’arrêt testé avec un délai connu jusqu’à l’arrêt complet, comparez les permissions à la référence de lancement chaque mois, et conservez un runbook de retrait répété avec une solution de repli humaine dotée en personnel. Chaque contrôle nécessite des preuves qu’un auditeur pourrait lire.
Pourquoi les déploiements d'agents d'IA en entreprise échouent-ils ?
Les causes rapportées se regroupent davantage autour du contrôle que de la qualité du modèle : exposition de données clients, risque de marque lié à des réponses erronées, et incapacité à reconstituer ce que le système a réellement fait. En dessous se trouvent trois lacunes : une limite qui s’est élargie discrètement, aucun moyen répété d’arrêter le travail, et une supervision ajoutée après le lancement.
Quel pourcentage d'agents d'IA fait l'objet d'un retour en arrière ?
Une étude publiée en mai 2026 a révélé que les trois quarts des entreprises interrogées avaient déjà annulé ou désactivé un agent en contact avec les clients après son déploiement, un chiffre qui grimpe à 81 % parmi les organisations dotées des cadres de gouvernance les plus matures. Ce chiffre plus élevé reflète une détection plus précoce, les équipes plus matures repérant les problèmes alors qu’ils sont encore mineurs.
Que sont les garde-fous des agents d'IA ?
Ce sont les limites techniques qui maintiennent un système autonome dans les bornes de sa mission approuvée : une liste blanche d’actions autorisées, une liste noire explicite, des identifiants par outil avec des approbateurs nommés, une étape d’approbation humaine pour les actions irréversibles, et une journalisation de chaque action effectuée. Les garde-fous limitent la capacité, et la surveillance en rend compte.
Découvrez comment Redwerk a pris en charge le développement principal d'une plateforme d'optimisation IA et l'a menée à un lancement de produit réussi