Un AIBOM est un inventaire structuré de ce dont se compose un système d’IA : les modèles et la manière dont leurs poids ont été produits, les jeux de données utilisés sur l’ensemble du cycle de vie du modèle, l’infrastructure sur laquelle il s’exécute, les contrôles de sécurité qui l’entourent, et les chiffres de performance sur lesquels il a été validé. Une nomenclature IA fait pour un pipeline de modèles ce qu’une liste de pièces fait pour une machine, et au cours de l’année écoulée, elle est passée des articles de recherche aux achats. Ce basculement se manifeste directement dans notre propre travail de développement de grands modèles de langage, où l’inventaire est de plus en plus construit en même temps que le modèle plutôt qu’assemblé après qu’un client en fait la demande.
En mai 2026, les agences de cybersécurité du G7 ont publié un guide conjoint des éléments minimaux pour exactement cet artefact, couvrant 50 éléments nommés répartis en sept clusters. Cette liste est désormais le vocabulaire auquel recourt l’équipe sécurité d’un acheteur d’entreprise lorsqu’elle demande ce que contient le produit que vous vendez. Vous trouverez ci-dessous d’où proviennent ces demandes, chaque champ qui doit figurer dans l’enregistrement, quels champs un pipeline génère de lui-même, et où l’analogie avec l’inventaire logiciel cesse d’être utile.
D'où viennent les demandes d'AIBOM
Le document à l’origine de la vague actuelle est Software Bill of Materials for AI : Minimum Elements, publié le 12 mai 2026 par sept agences nationales de cybersécurité en collaboration avec la Commission européenne : le BSI allemand, l’ACN italienne, l’ANSSI française, le CSE canadien, la CISA américaine, le NCSC britannique et le NCO japonais. Il est issu d’un chantier du groupe de travail sur la cybersécurité du G7 qui s’est déroulé d’août 2025 à février 2026.
Sa propre présentation est inhabituellement directe quant à ses limites, précisant que les éléments minimaux « ne sont pas obligatoires ; ils ne créent ni exigences, ni normes, ni législation ». Cette clause explique la rapidité de sa diffusion : une liste de champs volontaire portant la signature de sept gouvernements est presque gratuite à copier dans un questionnaire pour une équipe achats. Elle atteint un fournisseur par l’une de quatre voies :
- Un questionnaire de sécurité lors de l’intégration du fournisseur, avec une section IA greffée sur une question existante d’inventaire logiciel.
- Un livrable contractuel dans un accord-cadre de services d’entreprise, formulé comme une obligation de tenir à jour un inventaire des composants d’IA.
- Un programme de gouvernance interne chez le client, où quelqu’un rend compte de l’usage de l’IA à un conseil d’administration, un auditeur ou un régulateur.
- Une diligence raisonnable lors d’une acquisition ou d’un tour de financement, où l’acheteur demande si la provenance de votre modèle résiste à un examen approfondi.
Deux de ces voies aboutissent à un examen technique de votre base de code et de votre pipeline de modèles plutôt qu’à un échange de documents, ce qui se rapproche bien davantage d’un audit de mise en œuvre de l’IA en entreprise que du remplissage d’un formulaire. Le guide note également que, dans certaines juridictions, ses éléments « peuvent déjà être, ou peuvent être appelés à être, couverts par des exigences et obligations légales », une phrase qui fait beaucoup de travail pour quiconque vend dans l’UE. Pour un examen plus approfondi de ce que vérifie réellement cet examen technique et des raisons pour lesquelles les régulateurs le poussent, consultez notre analyse de ce que couvre un audit d’IA et pourquoi les régulateurs s’y intéressent.
Ce que contient un AIBOM, champ par champ
Voici l’ensemble complet, cluster par cluster, en reprenant les noms d’éléments propres au guide. Considérez ceci comme votre modèle d’AIBOM et ne supprimez rien sans une raison que vous seriez prêt à défendre devant le responsable sécurité d’un client.
Métadonnées (10 éléments) décrit l’enregistrement lui-même plutôt que le système : auteur du SBOM, version du SBOM, nom du format de données du SBOM, version du format de données du SBOM, signature de l’auteur du SBOM, nom de l’outil du SBOM, version de l’outil du SBOM, contexte de génération du SBOM, horodatage du SBOM et relation de dépendance du SBOM. L’élément que l’on saute souvent est le contexte de génération, qui indique si l’inventaire provient du code source, du build ou d’un binaire livré. Ces trois sources divergent de façons prévisibles, et le lecteur doit savoir laquelle est en jeu.
Propriétés au niveau du système (9 éléments) couvre le système dans son ensemble : nom du système, composants du système, producteur du système, version du système, horodatage du système, flux de données du système, utilisation des données du système, propriétés d’entrée/sortie du système et domaine d’application prévu. C’est dans le flux de données du système que sont déclarés les protocoles multi-agents, les API de services externes et le trafic bidirectionnel d’ancrage web (web-grounding), ce qui fait de ce cluster celui qui révèle si votre produit appelle discrètement le modèle d’un tiers au moment de l’inférence. C’est précisément cette couche que nos missions de transformation de la main-d’œuvre par l’IA agentique doivent cartographier en premier, car un agent qui appelle trois autres modèles en votre nom signifie trois entrées supplémentaires que ce cluster doit porter.
Modèles (13 éléments) est le plus grand cluster : nom du modèle, identifiant du modèle, version du modèle, horodatage du modèle, producteur du modèle, description du modèle, valeur de hachage du modèle, algorithme de hachage du modèle, propriétés du modèle, propriétés d’entrée-sortie du modèle, propriétés d’entraînement du modèle, licence du modèle et références externes du modèle. C’est la paire de hachage qui pèse le plus lourd ici, car sans une valeur de hachage et l’algorithme qui l’a produite, toute autre affirmation du cluster n’est qu’une assertion que le destinataire ne peut pas vérifier.
Propriétés des jeux de données (10 éléments) couvre le nom du jeu de données, la description du jeu de données, le contenu du jeu de données, l’identifiant du jeu de données, le hachage du jeu de données, la provenance du jeu de données, les propriétés statistiques du jeu de données, la sensibilité du jeu de données, la relation de dépendance du jeu de données et la licence du jeu de données. C’est le cluster qui déclenche les débats internes, puisqu’il s’applique à chaque jeu de données sur tout le cycle de vie du modèle, y compris les jeux d’évaluation et de réglage fin (fine-tuning). Démêler cette filiation relève généralement d’abord d’un problème d’ingénierie des données avant d’être un problème de documentation, car on ne peut pas consigner une provenance que l’on n’a jamais suivie.
Infrastructure (2 éléments) couvre le logiciel d’infrastructure et le matériel d’infrastructure, plus un lien vers une nomenclature matérielle (Hardware Bill of Materials) lorsqu’elle existe.
Propriétés de sécurité (4 éléments) couvre les contrôles de sécurité, la conformité de sécurité, les informations sur la politique de cybersécurité et les références aux vulnérabilités.
Indicateurs clés de performance (2 éléments) couvre les indicateurs de sécurité et les KPI de performance opérationnelle. Ces trois clusters courts sont ceux qui sont le plus souvent livrés vides, ce qui donne l’image d’un inventaire abandonné en cours de route.
Champs générés automatiquement et champs rédigés manuellement
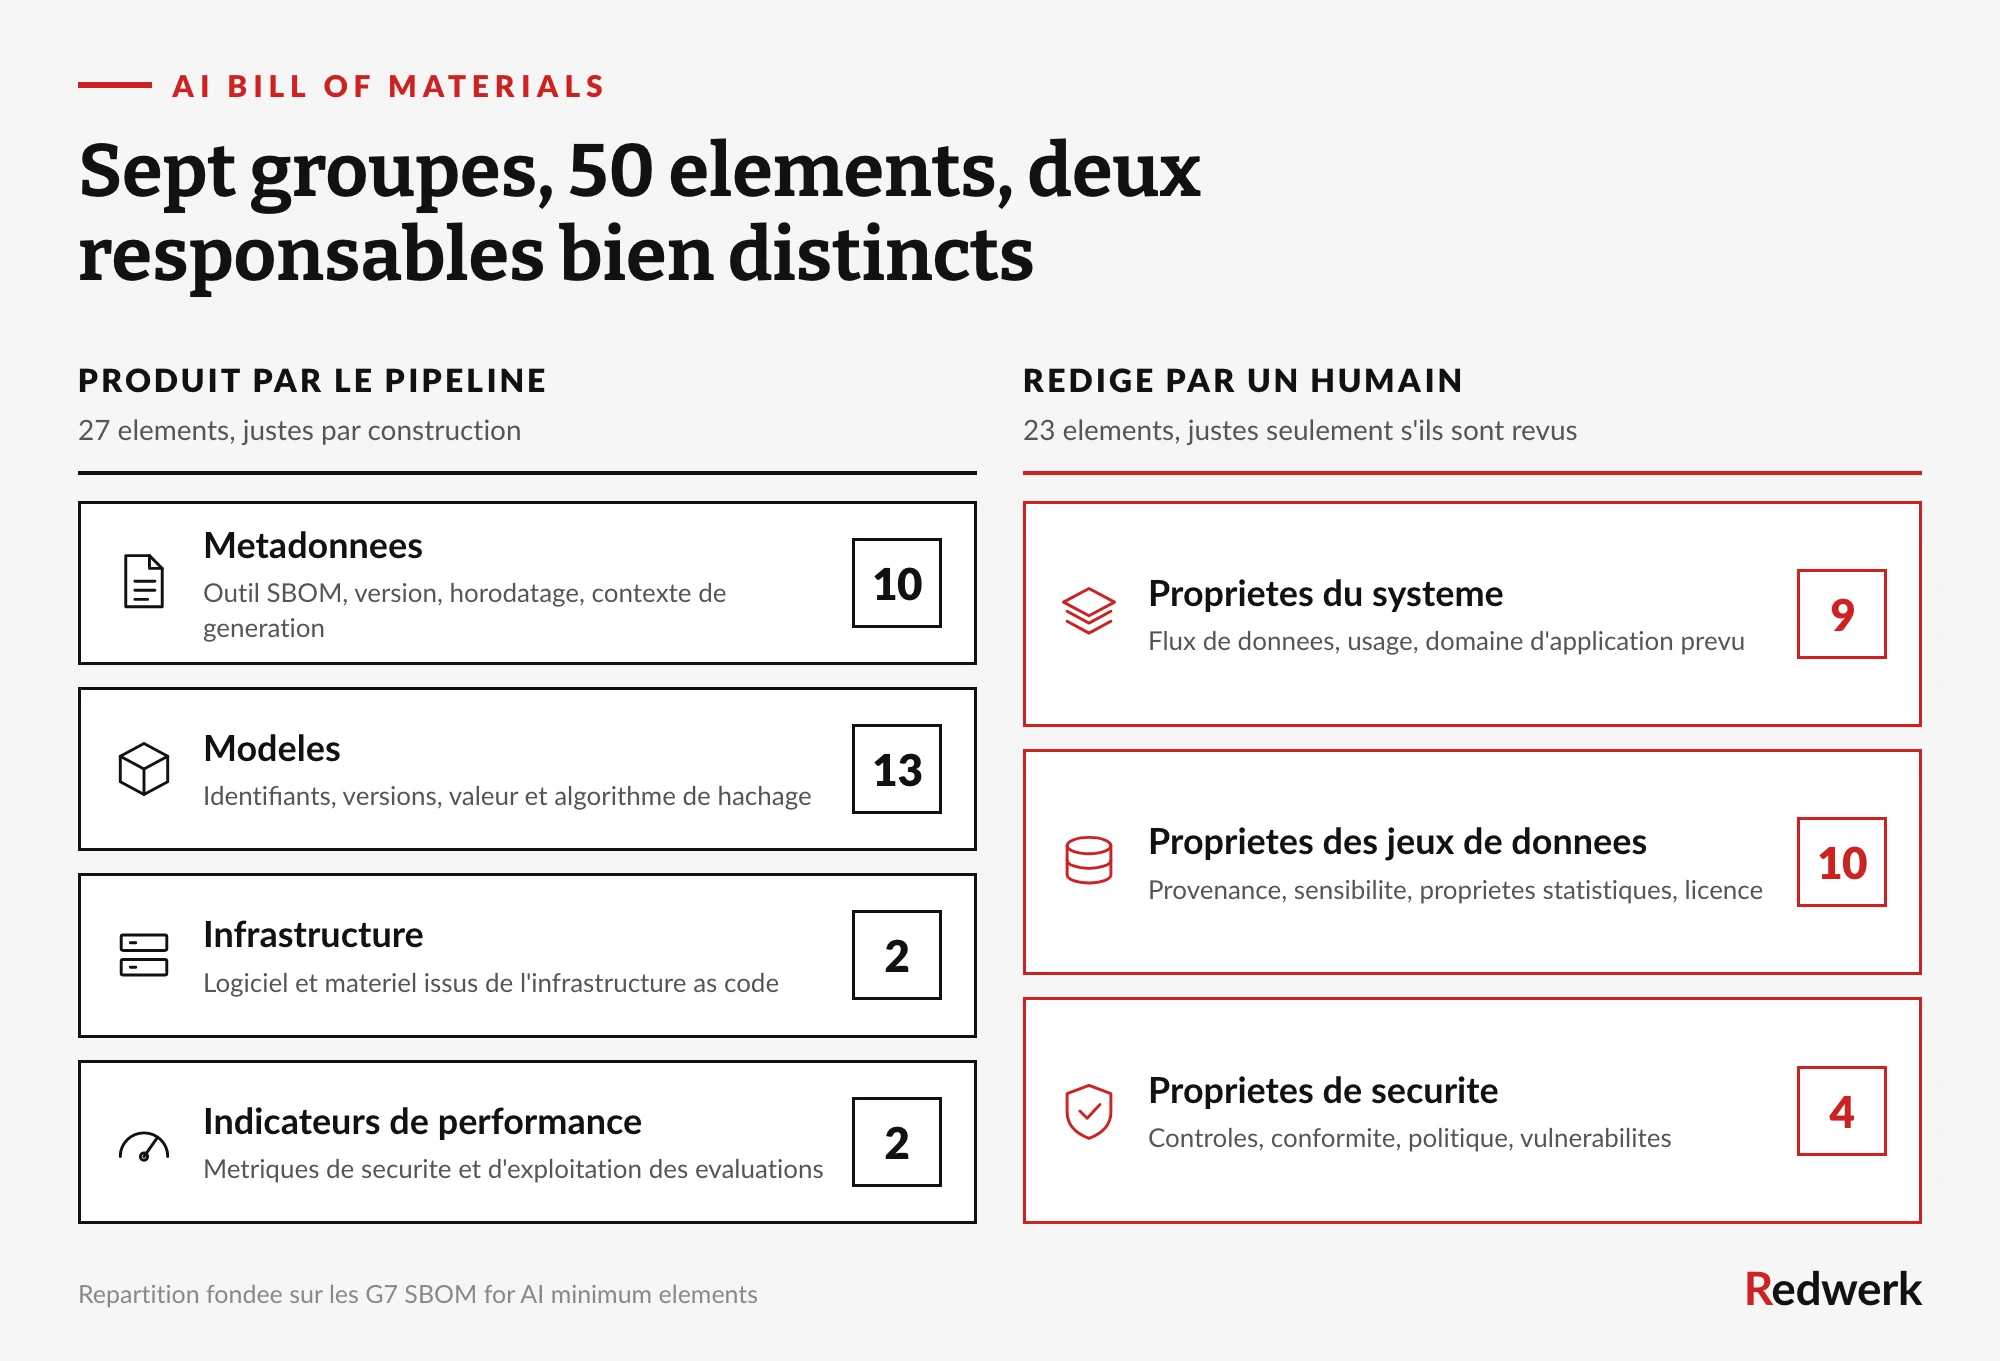
Les recommandations sur la manière de créer des enregistrements AIBOM ont tendance à présenter le fichier comme un livrable unique avec un seul propriétaire. Cinquante éléments couvrant le code, les données, l’infrastructure, la sécurité et le juridique sont transversaux par nature, et les répartir selon qui peut les produire transforme un projet bloqué en deux projets gérables. Selon notre décompte, 27 éléments proviennent directement d’outils que la plupart des équipes utilisent déjà, tandis que les 23 restants nécessitent un jugement humain qu’aucun scanner ne peut exercer.
Champs générés par le pipeline
Tout ce qui relève de l’identité et tout ce qui relève du hachage appartient au pipeline. Le cluster Métadonnées est presque entièrement un sous-produit de l’étape de génération, puisque l’outil connaît son propre nom et sa version, l’horodatage, le format de données et la phase du cycle de vie dans laquelle il s’est exécuté. Les identifiants, versions, horodatages et hachages des modèles et des jeux de données proviennent de votre registre de modèles et de votre stockage d’objets, et le cluster Infrastructure provient des définitions d’infrastructure as code qui provisionnent déjà vos accélérateurs.
Les deux éléments d’indicateurs de performance n’ont leur place ici qu’à une condition : que votre dispositif d’évaluation écrive les résultats quelque part de façon durable. Générez-les depuis l’intégration continue (CI) à chaque publication de modèle et ils sont corrects par construction, alors que les ressaisir trimestriellement dans un tableur les rend faux dans la semaine suivant le déploiement suivant.
Champs rédigés par une personne
Les éléments restants relèvent du jugement, et un scanner n’a aucune base pour les établir. Chacun a besoin d’un propriétaire nommé :
- Domaine d’application prévu. Déclarer qu’un classificateur fonctionne dans un contexte médical, financier ou de cybersécurité est une décision de cadrage aux conséquences réglementaires, qu’aucune analyse statique ne permet de déduire.
- Provenance et sensibilité du jeu de données. La provenance indique d’où viennent les données et selon quelles conditions, et la sensibilité indique ce que coûterait une fuite. Les deux relèvent de la gouvernance des données et du juridique, et les deux sont ce qu’un examinateur sérieux vérifie en premier.
- Propriétés d’entraînement et limitations du modèle. La version utile précise les conditions dans lesquelles le modèle se dégrade, exactement ce que les fournisseurs adoucissent instinctivement.
- Contrôles de sécurité, conformité et informations de politique. Ces éléments renvoient à un cadre de contrôle existant, ils sont donc repris de votre programme de sécurité plutôt que générés à partir du code.
- La signature de l’auteur. Une signature est une décision de gestion des clés qui détermine quelle entité se porte garante du contenu, et elle transforme une description en engagement.
Les champs de ce groupe se périment silencieusement, car rien ne casse en production lorsqu’ils deviennent faux. Attribuez à chacun un propriétaire et un déclencheur de révision lié au réentraînement du modèle plutôt qu’à une date du calendrier.
L'analogie avec le SBOM et ses limites
La comparaison entre AIBOM et SBOM tient bien la route au niveau de l’objectif, mais se fissure au niveau de la vérification. Les deux sont des listes d’ingrédients qui permettent à un consommateur de raisonner sur le risque de quelque chose qu’il n’a pas construit lui-même, et le document du G7 précise explicitement que les systèmes d’IA sont aussi des systèmes logiciels, de sorte que les clusters IA viennent s’ajouter à un inventaire logiciel classique.
Unité d’inventaire
Composants et paquets logiciels
Modèles, jeux de données et le système qui les compose
Preuve d’identité
Nom du composant, version, hachage
Valeur de hachage du modèle plus algorithme de hachage, hachage et identifiant du jeu de données
Provenance
Fournisseur et relation de dépendance
Provenance du jeu de données sur l’ensemble du cycle de vie du modèle
Comportement en cours d’exécution
Hors périmètre
Flux de données du système, propriétés d’entrée/sortie, domaine d’application prévu
Surface juridique
Licence du composant
Licence du modèle et licence du jeu de données, y compris le statut de poids ouverts (open-weight)
Performance
Hors périmètre
Indicateurs de sécurité et KPI de performance opérationnelle
Le destinataire peut le vérifier seul
Généralement, en recalculant le hachage du paquet
Partiellement : les poids se hachent proprement, les données d’entraînement non
C’est au niveau de la vérification que l’analogie s’arrête. Une affirmation de dépendance est bon marché à tester : on récupère le paquet, on le hache, on compare. Une affirmation sur la provenance des données d’entraînement reste impossible à vérifier pour un destinataire qui ne dispose ni des données ni de la puissance de calcul nécessaires pour recréer les poids. Sanchit Vir Gogia a formulé cette limite avec précision dans CSO Online : « Les éléments minimaux créent de la visibilité. Ils ne créent pas de garantie. Ils indiquent à l’acheteur ce que le fournisseur affirme exister. »
Les auteurs du G7 arrivent au même constat par le chemin inverse, en précisant qu’un inventaire de ce type « ne suffit pas à lui seul à renforcer la cybersécurité tout au long de la chaîne d’approvisionnement » et qu’il ne fonctionne que s’il est relié à des outils d’analyse des vulnérabilités et de gestion. Pour un acheteur, cela fait de ce document un point de départ pour poser des questions, et la suite naturelle est un examen indépendant de la base de code et du pipeline de modèles qui vienne étayer les affirmations. Pour un fournisseur, les champs que vous pouvez appuyer sur un hachage ou un artefact signé valent bien plus dans une négociation que les champs que vous ne pouvez que déclarer.
Du document administratif à l'artefact produit
Les équipes qui cessent de redouter cette demande sont celles qui intègrent l’artefact directement dans le build. La mécanique n’a rien de remarquable : choisissez un format lisible par machine, générez les champs automatiques dans la CI à chaque publication de modèle, conservez les champs rédigés par des humains dans le contrôle de version aux côtés du code afin qu’ils passent en revue, et publiez le résultat sous forme d’artefact signé lors de la publication.
Le choix du format est désormais suffisamment établi pour être ennuyeux. Le CycloneDX d’OWASP dispose d’un type de composant pour les modèles de machine learning et d’une référence externe vers la fiche de modèle (model card) conçus précisément pour cet usage, et la version 1.7 de la spécification est sortie en octobre 2025, si bien que l’outillage existe déjà aujourd’hui plutôt que de figurer sur une feuille de route. SPDX est l’alternative crédible, et le guide du G7 désigne les champs de SPDX et de CycloneDX comme des emplacements acceptables pour les informations de licence des modèles.
Deux décisions de conception font l’essentiel du travail. Générez l’inventaire à chaque publication plutôt que chaque trimestre, car un inventaire dont l’horodatage retarde par rapport à votre modèle déployé indique à un examinateur que votre processus n’est que décoratif. Traitez les champs rédigés par des humains comme du code passé en revue, de sorte que rétrograder une classification de sensibilité nécessite l’aval de quelqu’un qui en est responsable.
Il s’agit là d’une automatisation ordinaire des artefacts de publication, ce qui explique pourquoi les équipes d’ingénierie qui ajoutent des fonctionnalités d’IA à un produit existant ont tout intérêt à concevoir l’étape de génération en même temps que le chemin d’inférence. Les équipes qui peinent sont celles où personne ne possède le registre de modèles, ce qui est un écart organisationnel déguisé en problème de documentation.
La demande pour cet artefact continue de croître, et la liste des champs est désormais assez stable pour qu’on puisse s’appuyer dessus avec confiance. Produisez l’inventaire une fois, comme sous-produit de votre processus de publication, et une question gênante se transforme en un lien que vous collez dans un questionnaire. Si vous souhaitez de l’aide pour intégrer cette étape de génération dans un pipeline que vous exploitez déjà, contactez-nous et nous partirons de ce que vous avez déjà plutôt que d’une page blanche.
FAQ
Qu'est-ce qu'un AIBOM ?
Il s’agit d’un inventaire structuré des composants d’un système d’IA : les modèles et la manière dont leurs poids ont été produits, les jeux de données utilisés sur l’ensemble du cycle de vie du modèle, l’infrastructure sur laquelle il s’exécute, les contrôles de sécurité qui lui sont appliqués et ses indicateurs de performance. Le guide des éléments minimaux du G7 l’organise en sept clusters regroupant 50 éléments nommés, dont un décrit le document lui-même et six décrivent le système.
Quelle est la différence entre SBOM et AIBOM ?
Un inventaire logiciel répertorie les composants, les versions et les relations de dépendance. La version IA ajoute des clusters pour les modèles, les jeux de données, l’infrastructure, les propriétés de sécurité et les indicateurs clés de performance, que le guide du G7 traite comme des ajouts plutôt que comme un remplacement. La différence pratique tient à la vérifiabilité : un hachage de paquet peut être recontrôlé par quiconque le reçoit, alors qu’une affirmation sur la provenance des données d’entraînement ne le peut généralement pas.
Que doit contenir un AIBOM ?
Au minimum, les sept clusters du guide du G7 : Métadonnées, Propriétés au niveau du système, Modèles, Propriétés des jeux de données, Infrastructure, Propriétés de sécurité et Indicateurs clés de performance. Les champs qui pèsent le plus dans l’examen d’un acheteur sont la valeur de hachage et l’algorithme de hachage du modèle, la provenance et la sensibilité du jeu de données, le flux de données du système, le domaine d’application prévu et la signature de l’auteur.
Un AIBOM est-il obligatoire ?
Les éléments minimaux du G7 sont volontaires et précisent directement qu’ils ne créent ni exigences, ni normes, ni législation. L’obligation arrive plutôt par voie contractuelle, via des questionnaires de sécurité, des conditions d’achat et des programmes de gestion des risques fournisseurs, et le guide note que, dans certaines juridictions, ces mêmes éléments peuvent déjà relever d’exigences légales existantes.
Ce que révèle réellement un examen approfondi : plus de 80 améliorations et risques de sécurité sur une plateforme d'applications mobiles