Dès que votre produit fait appel à plus d’un grand modèle de langage, vous êtes confronté à une décision d’infrastructure que la plupart des équipes repoussent jusqu’à ce qu’elle commence à coûter de l’argent. Le choix consiste à savoir si chaque service parle directement à chaque fournisseur, ou si tout transite par une seule couche que vous contrôlez.
Un AI gateway est un reverse proxy qui se place entre vos applications et chaque fournisseur de LLM que vous utilisez, vous offrant un point unique pour gérer le failover, le suivi des coûts, les rate limits et les clés API. Les entreprises qui utilisent plus d’un modèle y ont recours pour la même raison qu’elles placent un load balancer devant leurs serveurs web : arrêter de résoudre le même problème dans dix bases de code différentes. Notre propre travail de développement de grands modèles de langage confirme sans cesse le même schéma : dès qu’une fonctionnalité LLM dépasse une intégration unique, la question du gateway finit par se poser d’elle-même.
La pression est réelle et récente. L’enquête State of AI in the Enterprise menée par Deloitte en janvier 2026 auprès de 3 235 dirigeants a révélé que seulement 25 % d’entre eux avaient mis en production 40 % ou plus de leurs pilotes d’IA, et l’écart entre une démo et un système de production fiable est exactement là où cette couche trouve sa justification. Les analystes d’IDC décrivent une « constellation de modèles » en train de devenir la nouvelle norme, ce qui signifie que l’intégration à un fournisseur unique par laquelle la plupart des équipes ont commencé accuse déjà du retard.
Trois problèmes qu'un AI gateway résout vraiment
Un gateway justifie son existence lorsqu’il supprime un travail que vous répétez actuellement à la main à plusieurs endroits. Trois problèmes passent ce test sans ambiguïté, car chacun s’aggrave à chaque modèle, équipe ou client ajouté. Les sections suivantes détaillent précisément ce que cette couche gère bien.
Failover entre fournisseurs : OpenAI, Anthropic et Google
Quand un seul fournisseur traverse une mauvaise heure, toutes les fonctionnalités construites dessus s’éteignent au même instant. ChatGPT et l’API d’OpenAI sont tombés en panne pour des milliers d’utilisateurs en décembre 2025, l’une des plusieurs interruptions de cette année-là, et les équipes sans solution de repli ont simplement attendu que ça passe pendant que leur file d’assistance se remplissait. Un gateway vous permet d’enregistrer OpenAI, Anthropic et Google Gemini derrière un seul endpoint et de basculer le trafic automatiquement dès que l’un d’eux commence à renvoyer des erreurs ou des timeouts.
Au-delà de la disponibilité, l’avantage concret est de pouvoir changer de fournisseur sans déploiement. La règle de routage vit dans le gateway plutôt que d’être codée en dur dans chaque service qui appelle un modèle, si bien que remplacer un modèle principal par un modèle moins cher ou plus rapide devient un changement de configuration plutôt qu’une mise en production.
Gouvernance des coûts et attribution par équipe
La plupart des mauvaises surprises sur les coûts d’IA remontent à une seule cause profonde : personne ne peut voir qui a dépensé l’argent. Quand une dizaine de services partagent une seule clé API, la facture mensuelle arrive sous la forme d’un chiffre unique sans détail, et personne ne peut dire quelle fonctionnalité ou quel client a provoqué la hausse. Un gateway étiquette chaque requête avec une équipe, un environnement et un cas d’usage, si bien que la dépense se transforme en un rapport sur lequel vous pouvez agir.
C’est la même discipline que vous appliquez déjà au reste de la production. Traiter la dépense en tokens comme quelque chose que vous instrumentez et surveillez en continu, plutôt que de réconcilier en fin de mois, est ce qui transforme un budget IA d’une estimation en une prévision. Une pratique sérieuse d’AI FinOps, qui suit le coût par requête et le coût par client, dépend de l’existence de cette attribution par équipe au niveau du gateway.
Rate limiting unifié et sensible aux tokens
Les limites des fournisseurs se mesurent en tokens par minute, pas en requêtes par minute, si bien qu’une limitation naïve par requête se déclenche soit trop tôt, soit laisse une tâche lourde affamer toutes les autres. Un routeur LLM sensible aux tokens applique les limites dans l’unité même utilisée par le fournisseur pour facturer, et il le fait sur l’ensemble des applications à la fois plutôt que service par service. C’est ce point d’observation unique qui permet aux limites de tenir réellement sous charge.
En pratique, un gateway regroupe trois contrôles pénibles à construire et à coordonner séparément. Chacun d’eux est standard dans une configuration mature :
- Des budgets de tokens par équipe ou par clé, pour qu’un batch job devenu incontrôlable ne puisse pas épuiser le quota de tout un département.
- Des niveaux de priorité, pour que les requêtes destinées aux clients soient servies avant les résumés en arrière-plan.
- Une contre-pression maîtrisée (backpressure), qui met en file d’attente ou rejette la charge avec une erreur claire plutôt que de laisser les timeouts s’enchaîner en cascade.
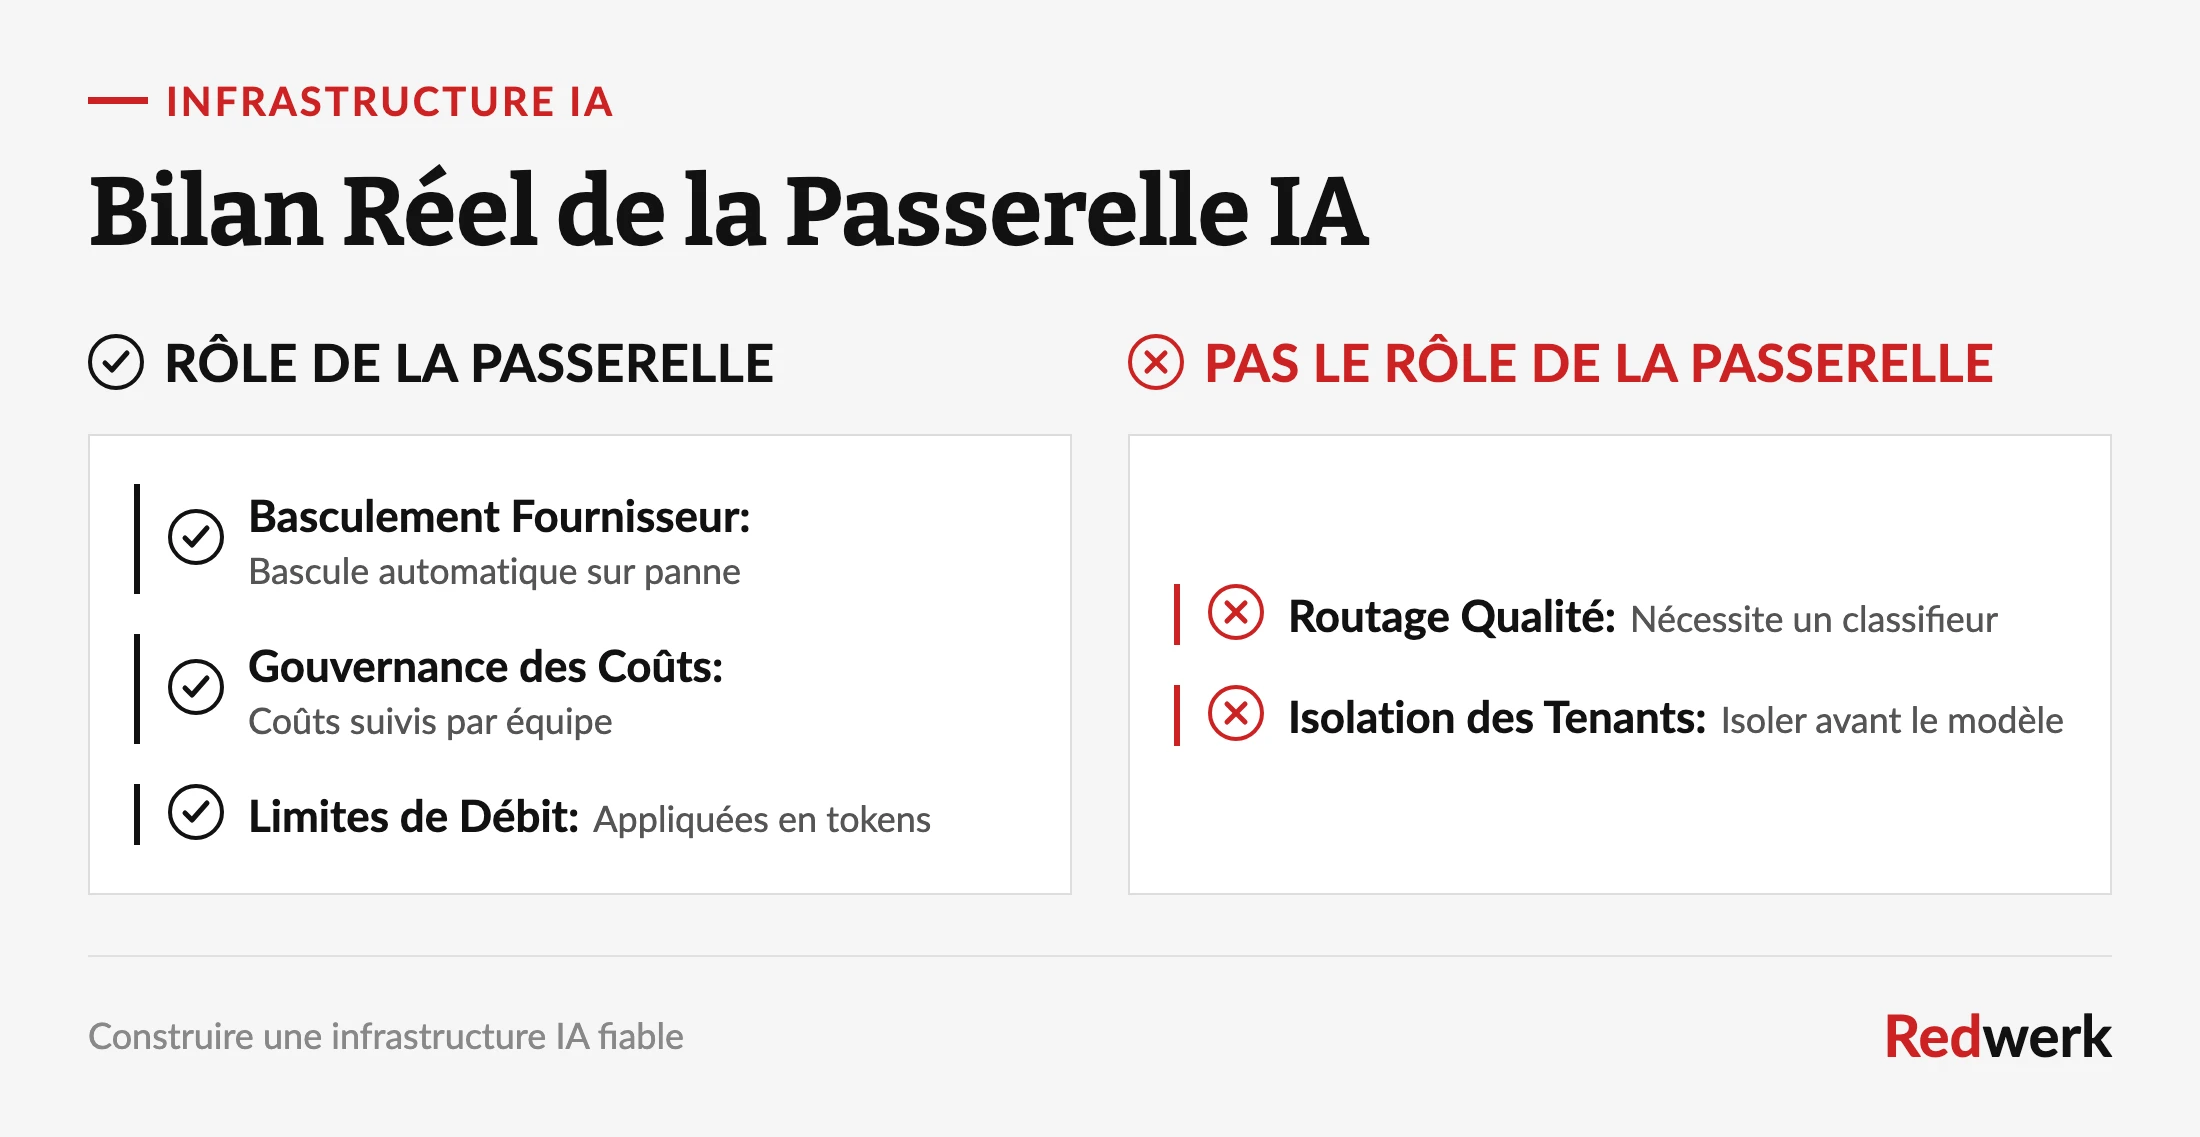
Deux problèmes qu'il ne résout pas (et ce qu'il vous faut à la place)
Un gateway, c’est de la plomberie, et la plomberie a des limites. Deux capacités sont commercialisées comme des fonctionnalités de gateway puis déçoivent en production, car chacune requiert un jugement ou une isolation qu’une couche de proxy ne peut pas fournir seule. Comprendre cette frontière avant d’acheter vous épargne un trimestre entier de reprise pénible.
Le routage par qualité, un problème de classification
Les fournisseurs adorent la promesse d’envoyer automatiquement les prompts faciles vers un modèle bon marché et les prompts difficiles vers un modèle coûteux. Le hic, c’est que décider qu’un prompt est « facile » est en soi une prédiction, si bien que le routage de modèles d’IA fondé sur la qualité est en réalité un problème de classification déguisé en infrastructure. Un proxy peut router selon des signaux statiques comme le nom du modèle, un en-tête ou un chemin, mais il n’a aucun moyen fiable de juger quel modèle répondra le mieux à un prompt donné.
Bien faire les choses signifie entraîner ou ajuster un petit classificateur sur votre propre trafic et votre propre définition d’une bonne réponse, puis le mesurer sur des exemples mis de côté pour l’évaluation. C’est un travail de machine learning avec des données étiquetées et une évaluation, et c’est le type de mission que nos ingénieurs IA et ML cadrent comme un projet à part entière plutôt que de le traiter comme une simple case à cocher du gateway.
L'isolation des tenants en amont du modèle
Si vous servez plusieurs clients, les données d’un tenant ne doivent jamais fuiter dans le prompt, le cache ou les logs d’un autre tenant. Un gateway ne voit une requête qu’après que votre application l’a déjà assemblée, ce qui en fait la mauvaise couche pour décider qui a le droit de voir quoi. L’isolation doit se produire en amont, dans la manière dont vous délimitez les données, construisez le contexte et séparez les caches pour chaque tenant.
Le gateway continue néanmoins d’apporter sa contribution en conservant des logs par tenant et des clés séparées, et cette piste d’audit est réellement utile. La véritable isolation, en revanche, relève d’une décision d’architecture applicative et de données qui vit dans votre propre code. Lorsque nous reprenons une construction multi-tenant à moitié terminée, c’est l’une des premières choses que nous auditons, car une fuite découverte après le lancement coûte cher à corriger.
Construire, acheter ou open source
Une fois que vous acceptez d’avoir besoin d’un gateway, la vraie question est de savoir comment en obtenir un sans en faire un projet parallèle qui entre en concurrence avec votre roadmap. Il existe trois voies, et la bonne dépend du contrôle dont vous avez besoin sur les données et de la quantité de travail de plateforme que vous pouvez staffer. De nombreuses équipes commencent avec LiteLLM, open source, puis cherchent une alternative à LiteLLM dès qu’elles ont besoin de single sign-on, de logs d’audit et de budgets par équipe qu’un proxy léger n’a jamais été conçu pour gérer.
Délai jusqu’au premier déploiement
Semaines à mois, l’ingénierie porte chaque intégration
Quelques jours pour le mettre en place, mais vous assumez la disponibilité et les mises à jour
Quelques heures, le fournisseur gère la disponibilité et les mises à jour
Contrôle des données
Contrôle total, tout reste au sein de votre infrastructure
Contrôle total, autohébergé sur votre propre infrastructure
Dépend de la localisation des données et des conditions de rétention du fournisseur
Maintenance continue
Votre équipe le patche, le fait évoluer et le surveille indéfiniment
Noyau maintenu par la communauté, mais vous continuez à l’exploiter, le patcher et le mettre à jour
Le fournisseur le patche, le fait évoluer et le surveille
Modèle de coûts
Temps d’ingénierie uniquement, aucun frais de licence
Licence gratuite, les coûts d’infrastructure et d’effectifs demeurent
Tarification par requête ou par utilisateur, en plus des coûts du fournisseur
Convient le mieux à
Entreprises régulées disposant d’une équipe plateforme dédiée
Équipes ayant une capacité DevOps et souhaitant éviter le vendor lock-in
Équipes qui veulent des fonctionnalités de gateway dès maintenant sans staffer une équipe plateforme
Aucune de ces voies n’est mauvaise en soi. L’erreur coûteuse consiste à dériver par accident vers un gateway bricolé maison, en ajoutant une fonctionnalité à la fois jusqu’à devenir, sans l’avoir prévu, propriétaire d’une plateforme que personne n’avait projeté de maintenir.
Le gateway comme nouvelle frontière de vos secrets
Voici le changement que la plupart des équipes manquent jusqu’à ce qu’un audit de sécurité les y force. Une fois que chaque appel de modèle passe par une seule couche, cette couche détient toutes les clés des fournisseurs, et elle devient le service le plus sensible que vous exploitez. Traité avec ce respect, un gateway LLM réduit votre problème de secrets de dizaines de clés éparpillées à une seule frontière surveillée.
La concentration ne compte comme une amélioration que si le gateway est durci à la hauteur de la frontière qu’il représente désormais. Les clés des fournisseurs doivent vivre dans le coffre-fort de secrets du gateway et jamais dans le code applicatif ou des fichiers d’environnement, les services applicatifs doivent s’authentifier auprès du gateway avec leurs propres identifiants de courte durée, et chaque requête doit être journalisée avec l’identité qui l’a émise. Faire tourner une clé compromise devient alors un seul changement à un seul endroit plutôt qu’une chasse à travers tous les dépôts.
Le mode d’échec qu’il vaut la peine de nommer est un gateway qui journalise les prompts et réponses complets en clair, ce qui recrée discrètement le risque d’exposition de données que l’on cherchait justement à contenir. Journalisez les métadonnées par défaut, et masquez ou échantillonnez les payloads délibérément, pas par accident.
Des clés éparpillées à un gateway unique
La plupart des entreprises ne partent pas d’une feuille blanche. Elles arrivent à ce stade avec des clés déjà copiées dans une dizaine de services, chaque équipe ayant intégré le modèle dont elle avait besoin selon son propre calendrier. Consolider tout cela en toute sécurité, sans casser les fonctionnalités qui servent déjà des clients, voilà le vrai travail.
La migration qui réussit est incrémentale plutôt qu’une réécriture. Un ordre d’opérations concret ressemble à ceci :
- Passez en revue chaque endroit où un modèle est appelé et chaque clé en circulation dans vos services.
- Mettez en place le gateway et faites-y pointer d’abord une fonctionnalité interne à faible risque.
- Déplacez le trafic service par service, en conservant l’ancien chemin direct comme solution de repli jusqu’à ce que chaque bascule ait fait ses preuves.
- Une fois que tout transite par le gateway, révoquez les anciennes clés éparpillées et émettez des identifiants par service.
Un AI gateway auquel les équipes d’entreprise peuvent se fier n’est ici que rarement la partie difficile. C’est la discipline consistant à déplacer du trafic en production sans gel qui fait caler ces projets, et c’est là qu’un partenaire ayant déjà mené une telle bascule justifie ses honoraires. Pour une première étape plus légère en périphérie, une option hébergée comme l’AI Gateway de Cloudflare pour le cache et le contrôle des coûts peut couvrir les besoins initiaux avant d’investir dans une couche autohébergée.
Redwerk a construit et consolidé des couches d’intégration de modèles sur des stacks .NET et Python, et nos équipes ont l’habitude d’expliquer aux parties prenantes non techniques exactement ce qui change et pourquoi, ce qui est généralement ce qui permet à une migration comme celle-ci de rester sereine. Si vous hésitez entre construire, acheter ou consolider ce que vous exploitez déjà, contactez-nous et nous cartographierons votre configuration actuelle ainsi que le chemin sûr le plus court vers un gateway unique.
FAQ
Qu'est-ce qu'un AI gateway ?
C’est un reverse proxy qui se place entre vos applications et les fournisseurs de grands modèles de langage que vous utilisez, comme OpenAI, Anthropic et Google. Il vous donne un point unique pour gérer les clés API, basculer entre fournisseurs, suivre les dépenses par équipe et appliquer des rate limits, au lieu de résoudre chacun de ces points séparément dans chaque service.
Quand avez-vous besoin d'un gateway LLM ?
Vous en avez besoin dès que plus d’une équipe ou d’un service appelle un modèle, dès que vous dépendez de plus d’un fournisseur, ou quand une seule clé API partagée rend impossible de voir qui dépense quoi. En deçà de cette échelle, une intégration directe est plus simple et un proxy ajoute de la latence pour peu de bénéfice.
LiteLLM ou Portkey : lequel choisir ?
LiteLLM est open source et autohébergé, ce qui convient aux équipes qui veulent un contrôle total des données et de l’infrastructure et qui peuvent staffer la maintenance. Portkey est un service managé qui échange une part de contrôle contre de la rapidité et des tableaux de bord, guardrails et analytics intégrés. Choisissez LiteLLM quand la localisation des données et le contrôle des coûts guident votre décision, et Portkey quand le délai de mise en production et une faible maintenance comptent davantage.
Comment router entre plusieurs modèles d'IA ?
Commencez par des règles statiques que le proxy peut évaluer à moindre coût, selon le nom du modèle, le chemin de la requête, l’en-tête ou l’équipe, ce qui couvre la plupart des besoins. Pour le routage fondé sur la qualité, c’est-à-dire envoyer les prompts faciles vers un modèle bon marché et les difficiles vers un modèle plus performant, vous entraînez un petit classificateur sur votre propre trafic, car cette décision est une prédiction plutôt qu’une règle fixe. Gardez un modèle de repli configuré pour qu’une panne chez un fournisseur n’interrompe pas la fonctionnalité.
Découvrez comment nous avons construit une application de recrutement alimentée par l'IA, acquise par un géant américain du recrutement