Si votre SaaS a lancé une fonctionnalité LLM cette année, votre facture OpenAI ou Anthropic est désormais une ligne budgétaire que la direction financière surveille, et elle évolue avec un usage que vous ne maîtrisez pas entièrement. Le réflexe consiste à développer en interne un proxy de mise en cache et un plafond de dépenses. Avant d’y consacrer un sprint, Cloudflare AI Gateway vous en apporte l’essentiel en modifiant une seule ligne dans l’URL de base de votre API.
Cloudflare AI Gateway est un proxy qui se place entre votre application et les fournisseurs de LLM comme OpenAI, Anthropic et Google. Vous y acheminez les appels aux modèles pour bénéficier de la mise en cache, de la limitation de débit, des nouvelles tentatives, des plafonds de dépenses et de la journalisation par requête, sans changer le SDK de votre fournisseur. Les fonctionnalités de base sont gratuites et ajoutent au plus quelques dizaines de millisecondes de latence.
Ce guide explique ce qu’il fait, comment la mise en cache et les limites de débit réduisent réellement les coûts, comment le mettre en place, comment il se compare au développement de votre propre proxy ou à l’utilisation d’outils comme LiteLLM et Helicone, et dans quels cas il n’est pas adapté.
Qu'est-ce que Cloudflare AI Gateway ?
Cloudflare AI Gateway est un proxy de requêtes géré pour le trafic des modèles d’IA. Au lieu que votre application appelle directement api.openai.com ou api.anthropic.com, elle appelle un point d’accès de la passerelle sur le réseau périphérique de Cloudflare, qui transmet la requête au fournisseur et renvoie la réponse. Comme chaque appel passe par un point unique, vous disposez d’un point de contrôle que vous n’aviez pas auparavant.
Ce point de contrôle offre cinq choses qui méritent votre attention :
- La mise en cache, afin que les requêtes identiques ou similaires soient servies sans solliciter à nouveau le fournisseur.
- La limitation de débit, pour qu’une boucle incontrôlée ou un client abusif ne puisse pas accumuler des milliers d’appels.
- Les nouvelles tentatives et les solutions de repli, pour qu’un délai d’attente du fournisseur ne se traduise pas par une fonctionnalité en échec.
- Les limites de dépenses et de requêtes, pour que la passerelle cesse de répondre dès qu’elle franchit un seuil que vous avez défini.
- La journalisation et les analyses, pour que vous puissiez voir le coût, la latence et le nombre de jetons par requête plutôt que de consulter une facture mensuelle.
Elle prend en charge les principaux fournisseurs, dont OpenAI, Anthropic, Google AI Studio, Groq et Mistral, ainsi que Workers AI, le service maison de Cloudflare. Vous n’avez pas besoin d’héberger votre application sur Cloudflare pour l’utiliser. La passerelle est indépendante du fournisseur et fonctionne avec un backend standard, où qu’il soit.
Comment la mise en cache réduit-elle votre facture LLM ?
C’est avec la mise en cache que la plupart des équipes réalisent les économies les plus rapides, car un accès au cache ne coûte aucun jeton du fournisseur et répond en quelques dizaines de millisecondes au lieu de la seconde à plusieurs secondes que prend un appel au modèle. La passerelle stocke une réponse indexée sur la requête, et lorsque la même requête se présente à nouveau, elle rejoue la réponse enregistrée.
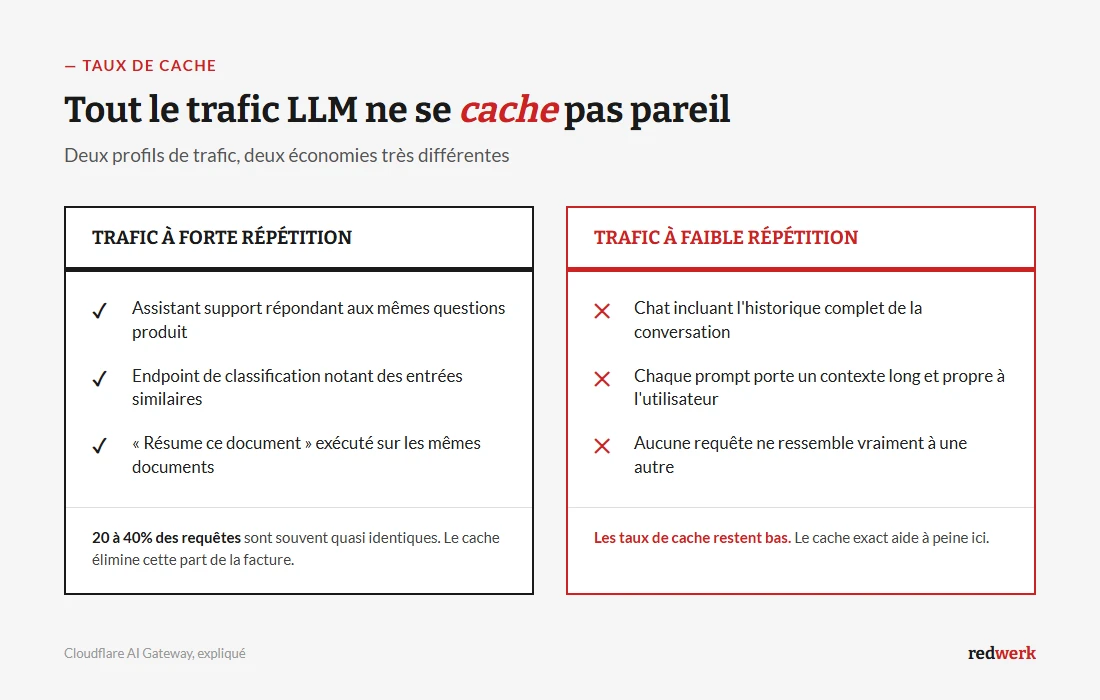
Le montant des économies dépend entièrement du caractère répétitif de votre trafic. Un assistant de support qui répond aux mêmes questions sur un produit, un point d’accès de classification qui évalue des entrées similaires, ou une fonctionnalité de type « résume ce document » appliquée aux mêmes documents connaîtront des taux de répétition élevés. Dans ce type de charges de travail, 20 à 40 pour cent des requêtes sont souvent des quasi-doublons, et la mise en cache supprime purement et simplement cette part de la facture.
Soyez honnête sur le cas inverse. Si chaque requête transporte un long contexte propre à l’utilisateur, comme une conversation qui inclut tout l’historique des échanges, les taux d’accès au cache sont faibles et la mise en cache par correspondance exacte n’aide guère. Cloudflare propose aussi une mise en cache par similarité, qui rapproche des requêtes proches mais non identiques. Cela augmente les taux d’accès pour les requêtes reformulées, mais peut renvoyer une réponse correcte pour une question légèrement différente. Testez donc la pertinence sur du trafic réel avant de l’activer pour des réponses destinées aux utilisateurs.
Comment la limitation de débit et les plafonds de dépenses protègent-ils votre budget ?
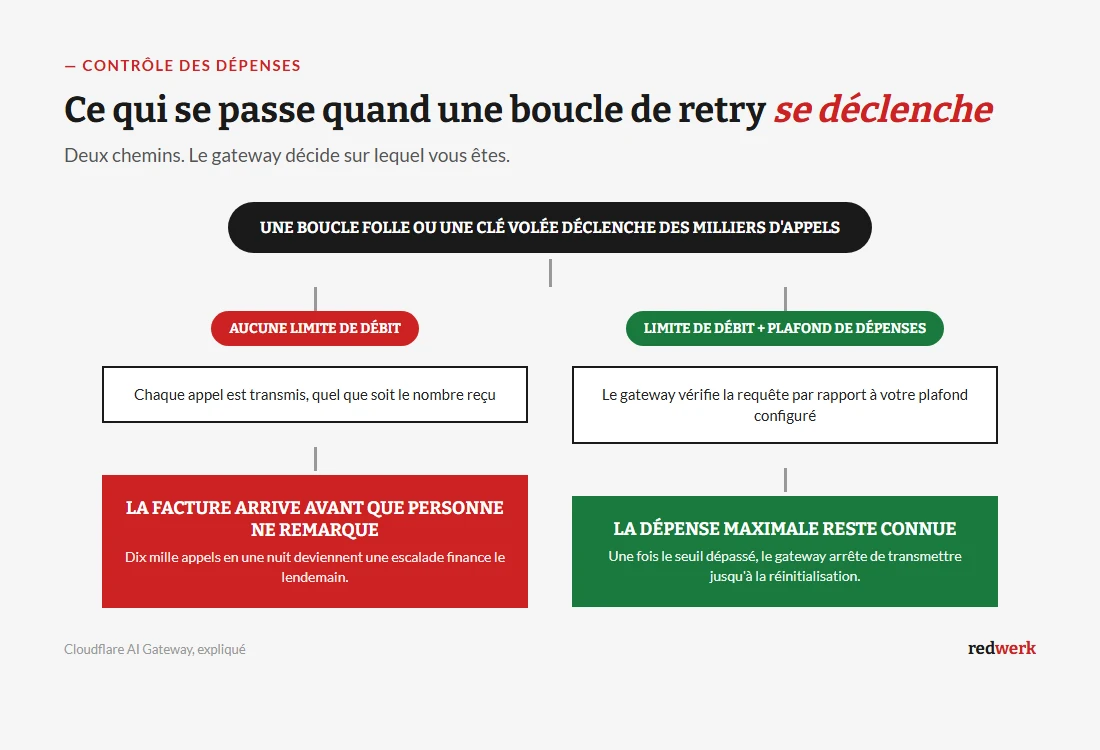
Les factures LLM les plus effrayantes ne viennent pas d’un usage régulier. Elles viennent d’une boucle de nouvelles tentatives qui déclenche dix mille appels pendant la nuit, d’une clé d’API divulguée, ou d’un lancement qui va plus loin que prévu. La limitation de débit et les plafonds de dépenses sont les garde-fous contre cela.
La limitation de débit vous permet de plafonner les requêtes par fenêtre de temps, par passerelle. Réglez-la juste au-dessus de votre pic réel et un processus incontrôlé atteint le plafond plutôt que le fournisseur. Les limites de dépenses et de requêtes vont plus loin : dès qu’une passerelle dépasse le nombre de requêtes ou le budget que vous avez configuré, elle cesse de transmettre les appels jusqu’à la réinitialisation de la fenêtre. Cela transforme un risque illimité en un maximum connu.
Le compromis est réel, alors réglez ces valeurs de façon réfléchie. Un plafond trop serré freine les utilisateurs légitimes lors d’un pic authentique, ce qu’ils perçoivent comme une panne. Basez les chiffres sur votre trafic de pointe réel augmenté d’une marge, et déclenchez une alerte à l’approche du seuil plutôt qu’au seul franchissement, afin qu’un humain puisse réagir avant que de vrais utilisateurs ne soient refusés.
Comment configurer Cloudflare AI Gateway ?
La configuration est volontairement légère. Vous créez une passerelle dans le tableau de bord Cloudflare, puis vous dirigez le SDK de votre fournisseur existant vers l’URL de la passerelle. Aucun changement de SDK, aucune réécriture de vos points d’appel.
Les étapes :
- Dans le tableau de bord Cloudflare, ouvrez AI, puis AI Gateway, et créez une passerelle. Notez son identifiant de compte et son identifiant de passerelle.
- Remplacez l’URL de base utilisée par votre SDK par le point d’accès de la passerelle correspondant à ce fournisseur.
- Si vous le souhaitez, activez la mise en cache, définissez une durée de vie (TTL) par défaut et configurez les limites de débit ou de dépenses dans les paramètres de la passerelle.
- Déployez et surveillez l’onglet des analyses pour le taux d’accès au cache, le coût et la latence.
Voici l’unique modification qui assure le routage, avec le SDK Node d’OpenAI en exemple :
import OpenAI from "openai";

// Point the existing SDK at the gateway. Nothing else changes.
const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL:
    "https://gateway.ai.cloudflare.com/v1/{account_id}/{gateway_id}/openai",
});

const completion = await client.chat.completions.create({
  model: "gpt-4o-mini",
  messages: [{ role: "user", content: "Summarize this ticket." }],
});
La mise en cache peut être activée pour l’ensemble de la passerelle, ou contrôlée par requête à l’aide d’un en-tête, ce qui est utile lorsque certaines réponses peuvent être mises en cache sans risque et que d’autres doivent rester à jour. Vous définissez la durée de vie en secondes :
const completion = await client.chat.completions.create(
  {
    model: "gpt-4o-mini",
    messages: [{ role: "user", content: "Summarize this ticket." }],
  },
  {
    headers: {
      "cf-aig-cache-ttl": "3600",
    },
  }
);
C’est là toute l’intégration pour un fournisseur. Anthropic, Google et les autres suivent le même schéma avec leur propre segment de chemin dans l’URL de la passerelle. Si votre application utilise déjà une surcharge baseURL en ligne pour la préproduction, cela se place au même endroit dans votre configuration.
Cloudflare AI Gateway ou développer votre propre proxy
Vous n’avez pas strictement besoin de Cloudflare pour tout cela. Un proxy de mise en cache est un modèle connu, et des outils comme LiteLLM et Helicone couvrent un terrain qui se recoupe. Le bon choix dépend de la quantité de logique de routage dont vous avez besoin et de votre volonté de gérer vous-même une infrastructure. Voici comment se comparent les principales options.
Cloudflare AI Gateway
Un contrôle rapide, sans infrastructure à gérer
Exacte et par similarité
Oui
Non, service périphérique géré
LiteLLM
Routage multifournisseur et logique de repli
Oui, avec Redis
Oui
Oui
Helicone
L’observabilité et les analyses avant tout
Oui
Limité
Cloud ou auto-hébergé
Proxy sur mesure
Une règle qu’aucun produit ne couvre
À développer
À développer
Oui
Pour la plupart des équipes du marché intermédiaire, la réponse honnête est que Cloudflare AI Gateway couvre 80 pour cent des cas avec le moins d’efforts : mise en cache, garde-fous et visibilité par requête grâce à une modification d’une seule ligne et sans serveur à gérer. Optez pour LiteLLM lorsque vous avez besoin d’un véritable routage multifournisseur, de chaînes de repli entre modèles, ou d’une interface unifiée entre de nombreux fournisseurs. Ne choisissez un proxy sur mesure que lorsque vous avez une règle qu’aucun produit ne couvre et le temps d’ingénierie pour l’assumer. Développer le vôtre pour économiser des frais de service géré coûte généralement plus cher en maintenance que ce que cela permet d’économiser.
Quand Cloudflare AI Gateway n'est pas le bon choix
Aucun outil n’est exempt de compromis, et une passerelle constitue une dépendance de plus sur le chemin de vos requêtes. Renoncez-y, ou réfléchissez-y à deux fois, dans les cas suivants.
- Vos requêtes sont presque toutes uniques. Si la mise en cache ne peut pas aider et que vous disposez déjà de l’observabilité, la passerelle ajoute un saut réseau pour un faible gain.
- Vous avez des règles strictes de résidence des données ou de confidentialité. La journalisation des requêtes et des réponses peut capturer des invites contenant des données personnelles. Vérifiez ce qui est journalisé et où avant d’activer la journalisation complète, et gardez les champs sensibles hors des invites.
- Vous avez besoin d’un routage complexe dès aujourd’hui. La passerelle n’est pas un routeur complet. Si votre besoin central est la répartition de charge pondérée ou le repli entre cinq fournisseurs, un routeur conçu pour cela convient mieux.
- Vous ne pouvez pas accepter une dépendance externe supplémentaire. Le réseau périphérique de Cloudflare est fiable, mais il reste un saut entre vous et le fournisseur. Pour un système soumis à des contraintes strictes de fournisseur unique, cela peut ne pas passer la revue.
Aucune de ces raisons n’impose de l’éviter par défaut. Ce sont des raisons de décider en connaissance de cause plutôt que de l’ajouter simplement parce que c’est facile.
Comment Redwerk maîtrise les coûts des LLM en production
La plupart des problèmes de coût des LLM ne sont pas des problèmes de modèle. Ce sont des décisions d’architecture prises avant que quiconque ne surveille la facture : pas de couche de mise en cache, pas de plafond de dépenses, des invites qui transportent plus de contexte que la tâche ne l’exige, et aucune visibilité, fonctionnalité par fonctionnalité, sur le coût réel de chaque appel.
Redwerk mobilise des ingénieurs qui ont déjà livré sur le réseau périphérique de Cloudflare et avec les principaux SDK de LLM, si bien que la passerelle, une stratégie de clés de cache pertinente et des garde-fous de dépenses sont mis en place dès l’intégration plutôt qu’après une facture surprise. C’est l’avantage du tech-match : vous ne payez pas une équipe pour apprendre la stack à vos frais. Nous gardons aussi la courbe de coût projetée visible dès le départ, afin qu’un responsable produit voie où va la dépense avant qu’elle ne soit engagée, et non après.
Si vous ajoutez des fonctionnalités d’IA et souhaitez qu’elles soient à la fois performantes et peu coûteuses à exploiter, notre équipe de développement en IA et ML les conçoit avec la maîtrise des coûts intégrée dès le départ, et nos ingénieurs en développement web sur mesure intègrent la passerelle et les garde-fous à votre application existante. Pour approfondir la mise en production de l’IA, consultez nos guides sur la création d’une recherche sémantique LLM dans votre produit SaaS et la réduction du coût des modèles par la distillation.
Questions fréquentes
Cloudflare AI Gateway fonctionne-t-il avec les modèles OpenAI, Anthropic et Google ?
Oui. Elle prend en charge les principaux fournisseurs, dont OpenAI, Anthropic, Google AI Studio, Mistral et Groq, ainsi que Cloudflare Workers AI. Vous conservez le SDK de votre fournisseur existant et ne changez que l’URL de base pour le point d’accès de la passerelle correspondant à chaque fournisseur que vous acheminez.
Combien coûte Cloudflare AI Gateway ?
Les fonctionnalités de base de la passerelle, à savoir la mise en cache, la limitation de débit, les nouvelles tentatives et les analyses, sont gratuites au départ. Vous ne payez que pour une conservation prolongée des journaux et un stockage à plus grand volume sur les forfaits payants. Les coûts de jetons du fournisseur s’appliquent toujours à chaque échec de cache, puisque ces appels atteignent le modèle normalement.
La mise en cache des réponses LLM nuit-elle à la qualité des réponses ?
La mise en cache par correspondance exacte renvoie une réponse identique pour une requête identique, ce qui est sûr pour les invites déterministes. La mise en cache par similarité peut renvoyer une réponse générée pour une requête proche mais différente. Testez donc la pertinence sur du trafic réel avant de l’activer pour des réponses destinées aux utilisateurs.
Cloudflare AI Gateway remplace-t-il LiteLLM ou Helicone ?
Elle recoupe la mise en cache et l’observabilité, mais n’est pas un routeur multifournisseur complet. Les équipes qui ont besoin d’un routage pondéré ou de chaînes de repli entre plusieurs fournisseurs choisissent souvent LiteLLM, tandis que celles qui veulent des garde-fous rapides et une visibilité par requête sans infrastructure optent pour la passerelle.
Cloudflare AI Gateway peut-il arrêter une facture LLM incontrôlée ?
Oui. La limitation de débit et les plafonds de dépenses ou de requêtes par passerelle arrêtent une boucle ou un client abusif avant que les appels n’atteignent le fournisseur. Définissez les seuils à partir de votre trafic de pointe réel augmenté d’une marge, car un plafond trop bas freinera les utilisateurs légitimes lors d’un pic authentique.
Découvrez comment Redwerk a repris le développement central d'une plateforme d'optimisation par IA et l'a mené jusqu'au lancement réussi du produit