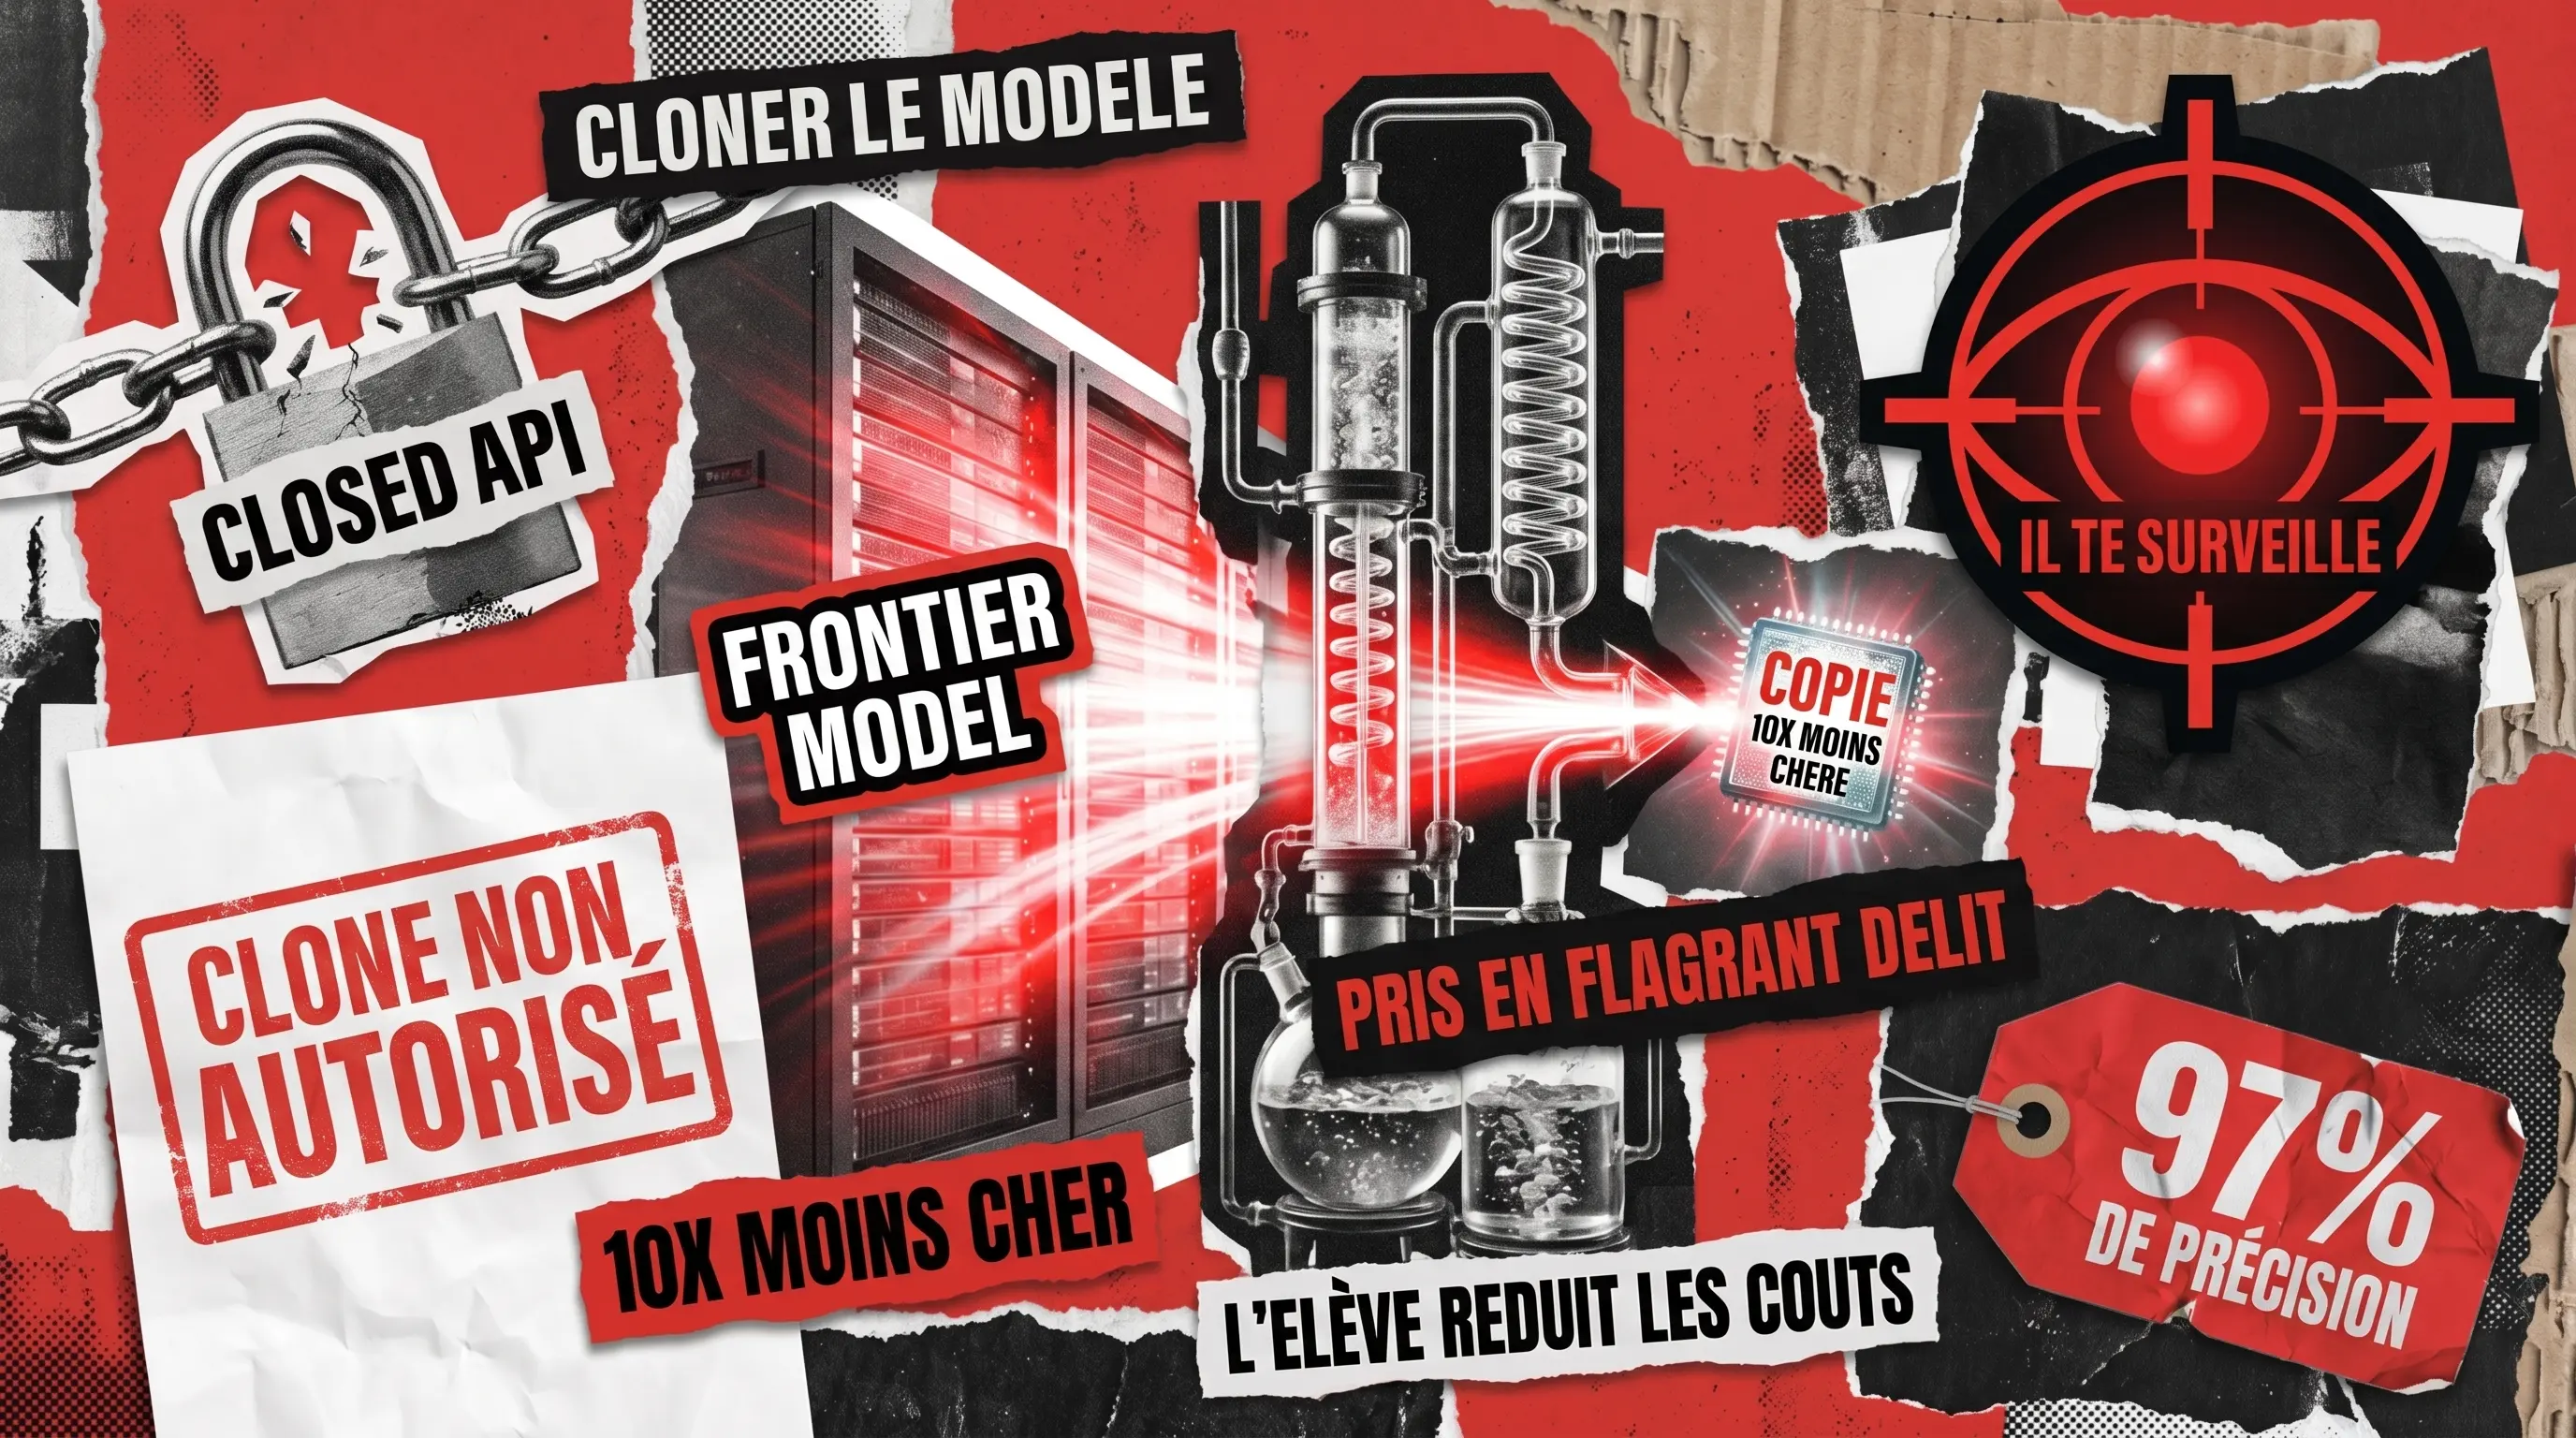
Début 2025, un laboratoire appelé DeepSeek a publié des modèles égaux aux capacités de raisonnement de systèmes frontier bien plus coûteux, pour un budget d’entraînement qui ressemblait à une erreur d’arrondi, et le monde de l’IA a collectivement perdu son calme. Un seul mot revenait dans toutes les explications : distillation. Un an plus tard, le sujet est revenu à la une quand Anthropic a signalé que plusieurs laboratoires avaient copié son modèle Claude à l’échelle industrielle, générant plus de 16 millions d’échanges avec Claude via environ 24 000 comptes frauduleux.
Quelle est donc la technique derrière ces deux histoires, et a-t-elle sa place dans votre feuille de route ? Ce guide couvre la distillation de modèles depuis les fondations : ce que c’est, comment cela fonctionne, où cela fait ses preuves, ce qu’elle ne peut véritablement pas faire, et s’il est même légal de distiller ChatGPT ou de distiller Claude. Si vous l’envisagez pour un produit, notre équipe de services de distillation de modèles IA peut vous aider à planifier le projet et à comprendre les coûts avant d’engager un budget.
Qu’est-ce que la distillation de modèles ?
La distillation de modèles est le processus de transfert des connaissances d’un grand modèle performant (l’enseignant) vers un modèle plus petit et moins coûteux (l’élève), de sorte que l’élève s’approche de la qualité de l’enseignant sur une tâche spécifique tout en s’exécutant plus rapidement et à moindre coût. L’élève égale rarement l’enseignant dans tout ce qu’il peut faire. Dans un domaine étroit, cependant, il peut s’en approcher remarquablement. L’idée n’est pas nouvelle. Elle a été formalisée par Geoffrey Hinton et ses collègues dans leur article de 2015 « Distilling the Knowledge in a Neural Network », et c’est depuis lors un outil discret mais incontournable de l’apprentissage automatique pratique.
La preuve classique est DistilBERT. BERT était un modèle de langage phare de Google qui a alimenté une vague d’outils de recherche et de compréhension de texte, et DistilBERT en est une version compressée construite par l’équipe de Hugging Face. Selon Sanh et al., 2019, DistilBERT a conservé environ 97 % de la compréhension linguistique de BERT tout en étant environ 40 % plus petit et 60 % plus rapide. Ce seul résultat illustre tout l’attrait de la distillation de modèles IA : conserver l’essentiel de l’intelligence, éliminer l’essentiel du coût.
Comment fonctionne la distillation de modèles ?
Vous prenez un modèle puissant, l’utilisez pour produire des réponses de haute qualité, puis entraînez un modèle plus petit à imiter ces réponses jusqu’à ce que le petit se comporte comme une copie compacte du grand pour votre cas d’usage. L’élève ne mémorise pas une table de correspondance. Il apprend les schémas de raisonnement et de réponse de l’enseignant pour la tâche qui vous intéresse. La plupart des distillations modernes de LLM utilisent l’un de deux mécanismes, et la différence compte lorsque vous planifiez un projet.
Distillation basée sur les réponses (données)
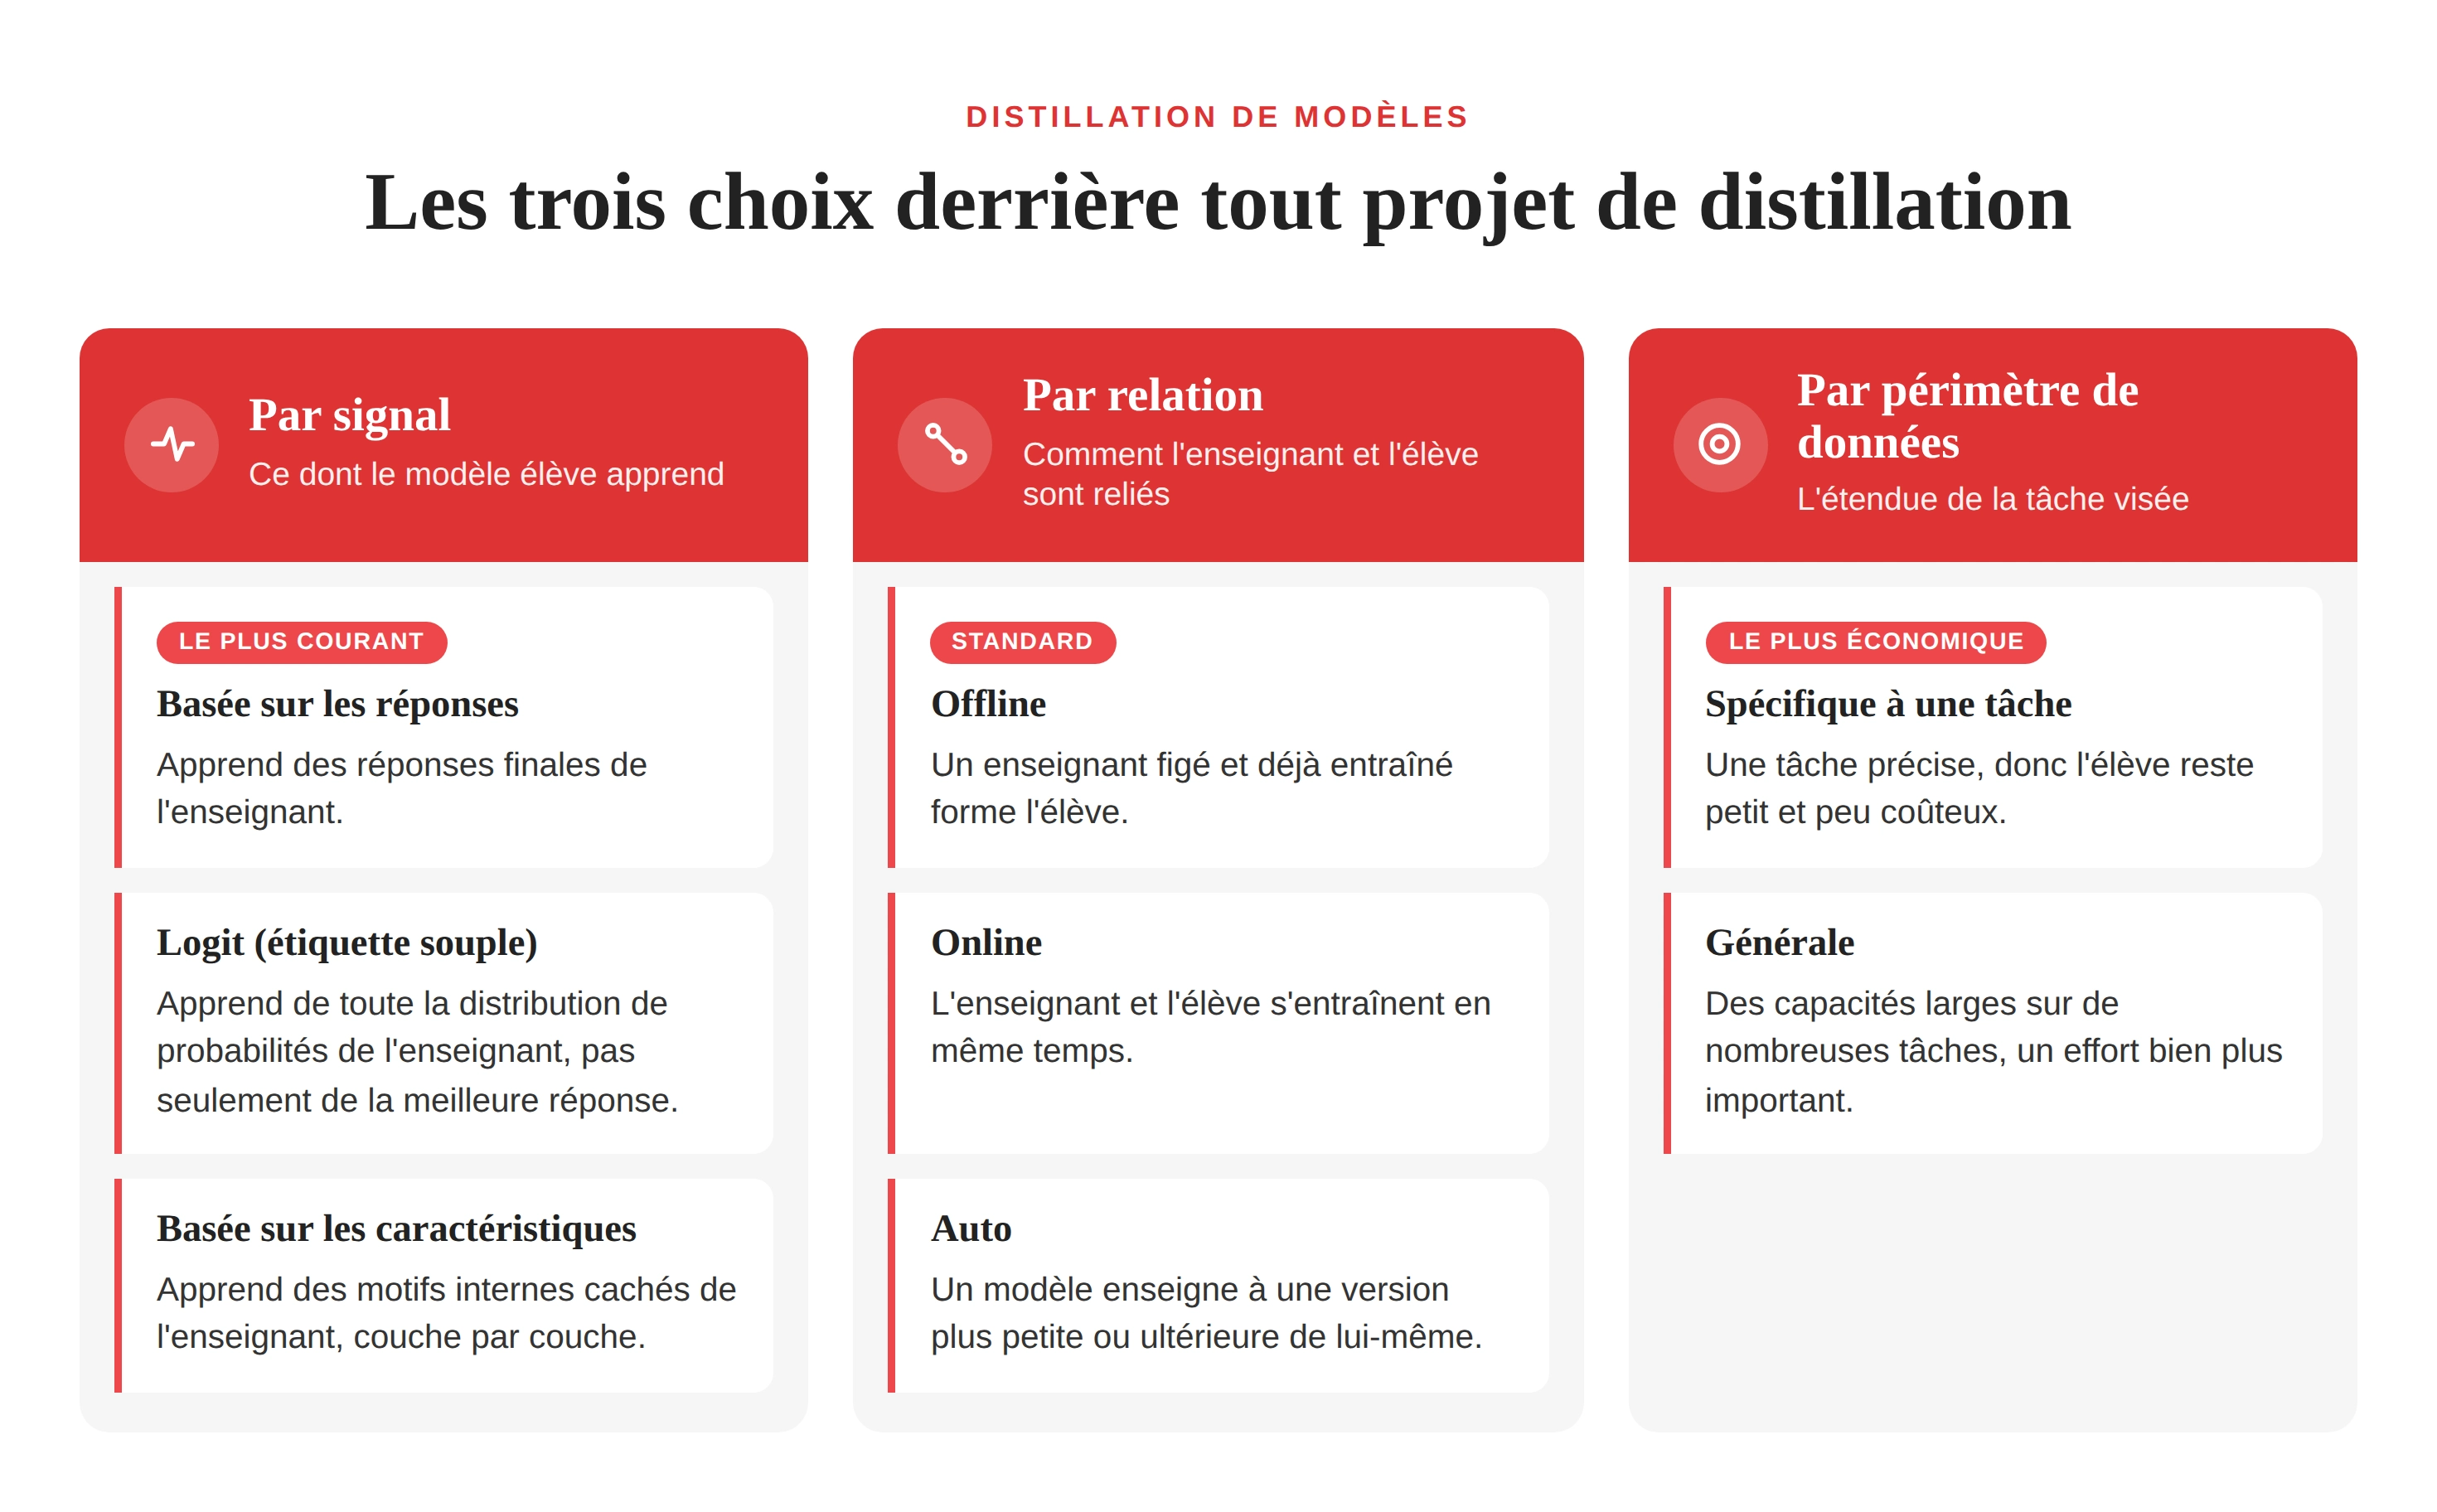
C’est l’approche courante pour les modèles de langage, et c’est celle que la plupart des plateformes automatisent. Vous exécutez l’enseignant sur un grand ensemble de prompts, capturez ses sorties et affinez l’élève sur ces paires entrée-sortie. L’élève apprend à reproduire directement le comportement de l’enseignant. C’est exactement ainsi que DeepSeek a construit ses modèles distillés : l’équipe a constitué un jeu de données de 800 000 exemples générés par son propre modèle R1, puis a utilisé ces données pour affiner des modèles ouverts existants comme Qwen et Llama.
Distillation à étiquettes souples (logit)
Au lieu de s’entraîner uniquement sur le texte final de l’enseignant, l’élève s’entraîne sur la distribution de probabilité complète de l’enseignant sur les tokens possibles – les étiquettes souples (« soft labels »). Ce signal contient plus d’informations, car il indique à l’élève non seulement que la réponse était A, mais aussi que B était presque aussi probable.
Le problème est l’accès. Les API fermées comme ChatGPT n’exposent pas leurs probabilités internes, donc la distillation à étiquettes souples est principalement disponible lorsque vous contrôlez l’enseignant ou utilisez un modèle ouvert (un modèle sous licence ouverte dont vous pouvez inspecter et exécuter les éléments internes vous-même, comme Llama ou Qwen).
Distillation basée sur les caractéristiques
Cette variante va une couche plus profond que la réponse finale ou ses probabilités et regarde à l’intérieur de l’enseignant lui-même. Plutôt que de copier uniquement ce que dit l’enseignant, l’élève apprend à reproduire les représentations intermédiaires de l’enseignant – les schémas internes que le modèle forme dans ses couches cachées en cheminant vers une sortie. Une analogie approximative serait de faire reproduire à l’élève le raisonnement de l’enseignant, pas seulement sa réponse finale. Comme la distillation à étiquettes souples, elle nécessite l’accès aux éléments internes de l’enseignant et pas seulement à son texte, elle convient donc aux modèles ouverts ou auto-possédés, et elle était au cœur de la construction de DistilBERT.
Techniques de distillation de modèles et types
Les techniques de distillation de modèles que vous rencontrerez se classent selon trois questions simples : quel signal l’élève apprend, comment l’enseignant et l’élève sont liés pendant l’entraînement, et quelle est la portée de la tâche cible. La première question, le signal d’entraînement, est celle que nous avons couverte dans les mécanismes ci-dessus : la distillation basée sur les réponses apprend des sorties finales, celle basée sur les logits des probabilités souples, et celle basée sur les caractéristiques des représentations cachées de l’enseignant. Les deux autres questions produisent les types qu’il vaut la peine de connaître avant de briefer une équipe d’ingénierie, et trouver la bonne combinaison est là où un développement expérimenté de grands modèles de langage sépare une victoire nette d’un trimestre perdu.
Distillation hors ligne
C’est la configuration standard et quotidienne. L’enseignant est déjà entraîné et reste figé pendant que l’élève apprend de ses sorties. Comme l’enseignant ne change jamais, le processus est simple à exécuter et facile à comprendre, c’est pourquoi la plupart des projets de production commencent ici.
Distillation en ligne
Ici, l’enseignant et l’élève s’entraînent en même temps plutôt que l’un après l’autre. L’enseignant continue de s’améliorer aux côtés de l’élève, ce qui peut produire un résultat plus fort, mais c’est plus complexe et plus coûteux à coordonner. Les équipes y ont généralement recours seulement lorsque la distillation hors ligne laisse des performances sur la table.
Auto-distillation
En auto-distillation, un modèle agit comme son propre enseignant et transmet ses connaissances à une version plus petite ou ultérieure de lui-même. Cela semble circulaire, mais c’est une manière pratique de comprimer un modèle ou de nettoyer son comportement sans faire appel à un enseignant séparé et plus grand. L’approche apparaît quand une équipe veut une version allégée d’un modèle qu’elle possède déjà.
Distillation spécifique à une tâche
Celle-ci cible une seule tâche étroite, comme le triage de tickets d’assistance, la classification de documents ou l’extraction de données structurées. Étant donné que l’élève n’a besoin d’être performant que sur une seule tâche, il peut être petit, peu coûteux et très rapide. C’est la forme de distillation la plus rentable et celle que la plupart des entreprises devraient envisager en premier.
Distillation générale
Celle-ci vise à transférer une capacité large plutôt qu’une compétence unique, produisant un modèle plus petit qui reste compétent sur de nombreuses tâches. C’est un effort plus lourd, car elle exige bien plus de données et de calcul, et c’est la voie qu’a prise DeepSeek avec ses modèles de raisonnement à usage général. La plupart des entreprises n’ont pas besoin d’aller aussi loin, mais c’est le bon choix quand un modèle doit gérer un large éventail de travaux.
Distillation de modèles vs ajustement fin : quelle est la différence ?
Les gens utilisent souvent les deux termes de manière interchangeable, et la confusion est compréhensible car la dernière étape est la même dans les deux cas. La distinction la plus claire est la source du signal d’entraînement. Dans l’ajustement fin ordinaire de LLM, le modèle apprend à partir d’étiquettes de référence rédigées par des humains que vous fournissez. En distillation, les étiquettes proviennent d’un autre modèle, l’enseignant, qui génère les données dont l’élève apprend.
Autrement dit, la distillation est une manière de produire des données d’entraînement, et l’ajustement fin est l’acte de s’entraîner sur celles-ci. Un pipeline de distillation se termine presque toujours par un cycle d’ajustement fin supervisé, c’est pourquoi la frontière se brouille en pratique. La raison de se soucier de la différence est le coût et la propriété. L’ajustement fin sur vos propres données étiquetées consiste à enseigner le style ou le format. La distillation consiste à hériter à moindre coût de la capacité d’un modèle beaucoup plus grand sur une tâche définie.
Pourquoi les équipes misent sur la distillation de modèles
L’économie est l’argument central, et elle devient plus convaincante trimestre après trimestre. Sur son service géré de distillation de modèles, AWS rapporte que les modèles distillés peuvent s’exécuter jusqu’à 500 % plus vite et 75 % moins cher que les originaux, avec moins de 2 % de perte de précision pour des cas d’usage comme la génération augmentée par récupération. Vous obtenez également des modèles plus petits qui s’adaptent à du matériel moins cher ou fonctionnent sur l’appareil, une consommation d’énergie réduite, et, lorsque vous hébergez vous-même, un contrôle total sur les poids sans frais d’API par token.
La courbe de coût globale pointe dans la même direction. Selon le rapport AI Index 2025 de Stanford HAI, porté par des petits modèles de plus en plus performants, le coût d’inférence pour un système de niveau GPT-3.5 a chuté de plus de 280 fois entre novembre 2022 et octobre 2024, passant d’environ 20 $ à 0,07 $ par million de tokens. Le marché s’oriente déjà dans ce sens. Gartner prédit que d’ici 2027, les organisations utiliseront des petits modèles IA spécifiques à des tâches au moins trois fois plus que les grands modèles de langage à usage général.
La qualité sur les tâches étroites est ce qui surprend les gens. L’article DeepSeek-R1 rapporte que son élève distillé 32B obtient 94,3 % sur le benchmark MATH-500 de niveau compétitif, contre 97,3 % pour son enseignant de 671 milliards de paramètres – un écart minime pour un modèle environ vingt fois plus petit. La spécialisation devient la norme plutôt que l’exception, et Gartner s’attend à ce que d’ici 2027 plus de 50 % des modèles d’IA générative utilisés par les entreprises soient spécifiques à un secteur ou à une fonction métier, contre environ 1 % en 2023.
Ce que la distillation de modèles ne peut pas faire
Un modèle distillé est un spécialiste, pas un généraliste, et prétendre le contraire est la voie la plus rapide vers un pilote décevant. L’élève dépasse rarement l’enseignant, et il hérite des angles morts et des biais de l’enseignant avec ses forces. Si l’enseignant se trompe sur quelque chose, l’élève se trompera avec assurance sur la même chose, donc les vérifications des biais font partie du plan dès le premier jour.
La généralisation étroite est le piège plus subtil. Un élève réglé pour un domaine peut se dégrader silencieusement ailleurs, et une étude récente a constaté que chaque point de contrôle DeepSeek-R1-Distill-Qwen obtenait un score inférieur à la référence de taille correspondante sur un benchmark de résolution de contraintes, même si ces mêmes modèles excellent en mathématiques et en code. La distillation achète des performances sur la tâche, pas une amélioration universelle. Il y a aussi une dérive cumulative des coûts à surveiller, car la génération de données synthétiques à partir d’un enseignant haut de gamme implique de payer les tarifs premium de ce dernier, et les cycles d’entraînement répétés s’accumulent même lorsque le modèle final s’exécute à bas coût.
La distillation de modèles est-elle légale ? Peut-on distiller ChatGPT ou Claude ?
La distillation elle-même est une technique légitime vieille de plusieurs décennies. La question juridique porte entièrement sur les sorties sur lesquelles vous vous entraînez et dans quelles conditions. Distiller au sein de la propre plateforme d’un fournisseur n’est pas seulement autorisé, c’est une fonctionnalité prise en charge : OpenAI propose la distillation de modèles dans son API pour que vous puissiez utiliser un plus grand modèle GPT comme GPT-4o pour affiner un plus petit comme GPT-4o mini, le tout en un seul endroit.
Tenter de distiller ChatGPT depuis l’extérieur est une autre affaire. Les conditions d’utilisation d’OpenAI interdisent d’utiliser ses sorties pour entraîner des modèles concurrents, ce qui est exactement ce que DeepSeek a subi comme examen début 2025. Il en va de même pour toute tentative de distiller Claude contre les règles. Anthropic a signalé en février 2026 que trois laboratoires avaient mené des attaques de distillation à l’échelle industrielle contre Claude, et l’entreprise gère désormais des systèmes de détection qui signalent le trafic de type distillation et l’activité coordonnée des comptes.
La conclusion honnête est que vous n’obtenez pas les poids ou les probabilités d’un modèle fermé, et vous ne pouvez pas légalement clôner l’API d’un concurrent pour construire un rival. Les voies réalistes sont de distiller au sein de la plateforme d’un fournisseur ou d’utiliser un enseignant sous licence ouverte comme Llama, Qwen ou DeepSeek, où vous possédez l’ensemble du pipeline. Nous parcourons les mécaniques pratiques dans notre article complémentaire, comment distiller un LLM étape par étape.
Quel est le coût réel ?
Un petit projet spécifique à une tâche coûte moins cher que la plupart des gens ne l’imaginent. Prenez un exemple réaliste : générer quelques milliers d’échantillons d’entraînement à partir d’un enseignant puissant, affiner un élève compact, puis le servir pendant un mois avec un trafic modéré. La configuration initiale tend à atterrir dans les dizaines de dollars inferieures lorsque vous utilisez une plateforme gérée, et la facture d’inférence continue pour le spécialiste distillé peut se monter à quelques dollars par mois.
Le même volume de requêtes mensuelles sur le modèle frontier original coûterait bien plus, ce qui est l’argument central pour distiller. L’hébergement autonome change la forme de la facture plutôt que sa taille : vous échangez les frais d’API par token contre l’hébergement GPU, ce qui gagne à fort volume et perd à faible volume.
Avant d’engager un budget, faites le calcul avec vos propres chiffres. Consultez les tarifs actuels par token et par heure GPU directement sur la page de tarification du fournisseur, car les tarifs publiés évoluent mensuellement et différents fournisseurs citent différents chiffres. Estimez votre volume mensuel réel (grossièrement, le nombre attendu de requêtes multiplié par les tokens que chacune utilise), puis comparez les deux options côte à côte : l’enseignant frontier sur une API de paiement par token contre l’élève distillé, que vous le serviez en mode sans serveur ou en auto-hébergement. Cette comparaison, et non un chiffre titre unique, vous dit si la distillation est rentable à votre échelle.
Construisez votre distillation de modèles avec Redwerk
Si la distillation semble adaptée, l’étape suivante est un plan ancré dans vos données et vos chiffres. En tant qu’entreprise de développement IA, Redwerk aide les entreprises à sélectionner le bon modèle et la pile technologique appropriée pour la distillation de modèles. Grâce à une phase de découverte professionnelle, vous obtenez une feuille de route adaptée à votre secteur et à vos cas d’usage, ainsi qu’une image claire des coûts et des efforts impliqués, et nous fournissons une estimation avant que tout travail commence.
Nous appliquons les principes d’ingénierie fondamentaux et les meilleures pratiques de sécurité affinés au fil de décennies de construction de logiciels sur mesure pour des entreprises d’Amérique du Nord et d’Europe, dont des entreprises Fortune 500 comme Siemens, J.B. Hunt et Universal Music Group. Cela signifie un modèle distillé qui performe sur votre tâche, résiste en production et ne divulgue pas silencieusement les risques de PI ou de conformité que la distillation peut introduire lorsqu’elle est effectuée négligemment. Parlez-nous de votre cas d’usage, et nous vous aiderons à décider si vous devez distiller, affiner ou emprunter une voie entièrement différente.
Découvrez comment nous avons construit une application de recrutement alimentée par l’IA, acquise par un géant américain du placement