Chaque équipe de développement logiciel finit par atteindre un point de rupture où la question de l’amélioration du processus de revue de code devient primordiale. Les fondateurs et les PDG constatent un ralentissement des mises en production, l’apparition de bugs et l’accumulation des plaintes des utilisateurs. Parallèlement, les directeurs techniques et les vice-présidents de l’ingénierie savent que le problème sous-jacent provient souvent d’un manque de contrôles qualité automatisés et performants. Tous deux aspirent au même résultat : savoir comment construire un pipeline CI/CD réellement efficace.
Mettre en place des revues d’intégration continue n’est pas une simple tâche de configuration DevOps. Il s’agit d’un contrôle qualité essentiel qui détermine précisément ce qui parvient à vos utilisateurs finaux. Les équipes qui détectent les problèmes en amont consacrent beaucoup moins de temps aux corrections post-mise en production que celles qui s’appuient uniquement sur l’assurance qualité manuelle ou la surveillance de la production.
Dans cet article, nous détaillerons la structure d’une couche de revue continue bien conçue. Nous explorerons les types de bugs détectés par les contrôles automatisés et, plus important encore, les failles critiques qu’ils ne repèrent pas.
Qu'est-ce que la revue de code en intégration continue ?
La revue de code en intégration continue consiste à intégrer une couche de revue structurée dans votre pipeline CI. Chaque modification est automatiquement évaluée selon des règles de qualité, de sécurité et de conception architecturale dès qu’elle est soumise — avant toute fusion dans la branche principale.
Le mot clé est « automatiquement ». Contrairement à la revue de code traditionnelle (qui repose entièrement sur la disponibilité humaine), le CI garantit que des vérifications de base ont lieu à chaque fois, sans exception ni oubli. Les humains interviennent ensuite pour les décisions qui nécessitent un contexte, un jugement et une compréhension des objectifs métier.
Un dispositif moderne de revue de code CI/CD combine trois couches :
- des vérifications automatisées (linters, analyse statique, scanners de sécurité, audits de dépendances) qui s’exécutent sur chaque pull request
- une revue humaine du diff avec une checklist claire
- des audits approfondis périodiques, idéalement incluant une revue par des experts tiers, pour examiner ce que l’automatisation ne peut pas voir
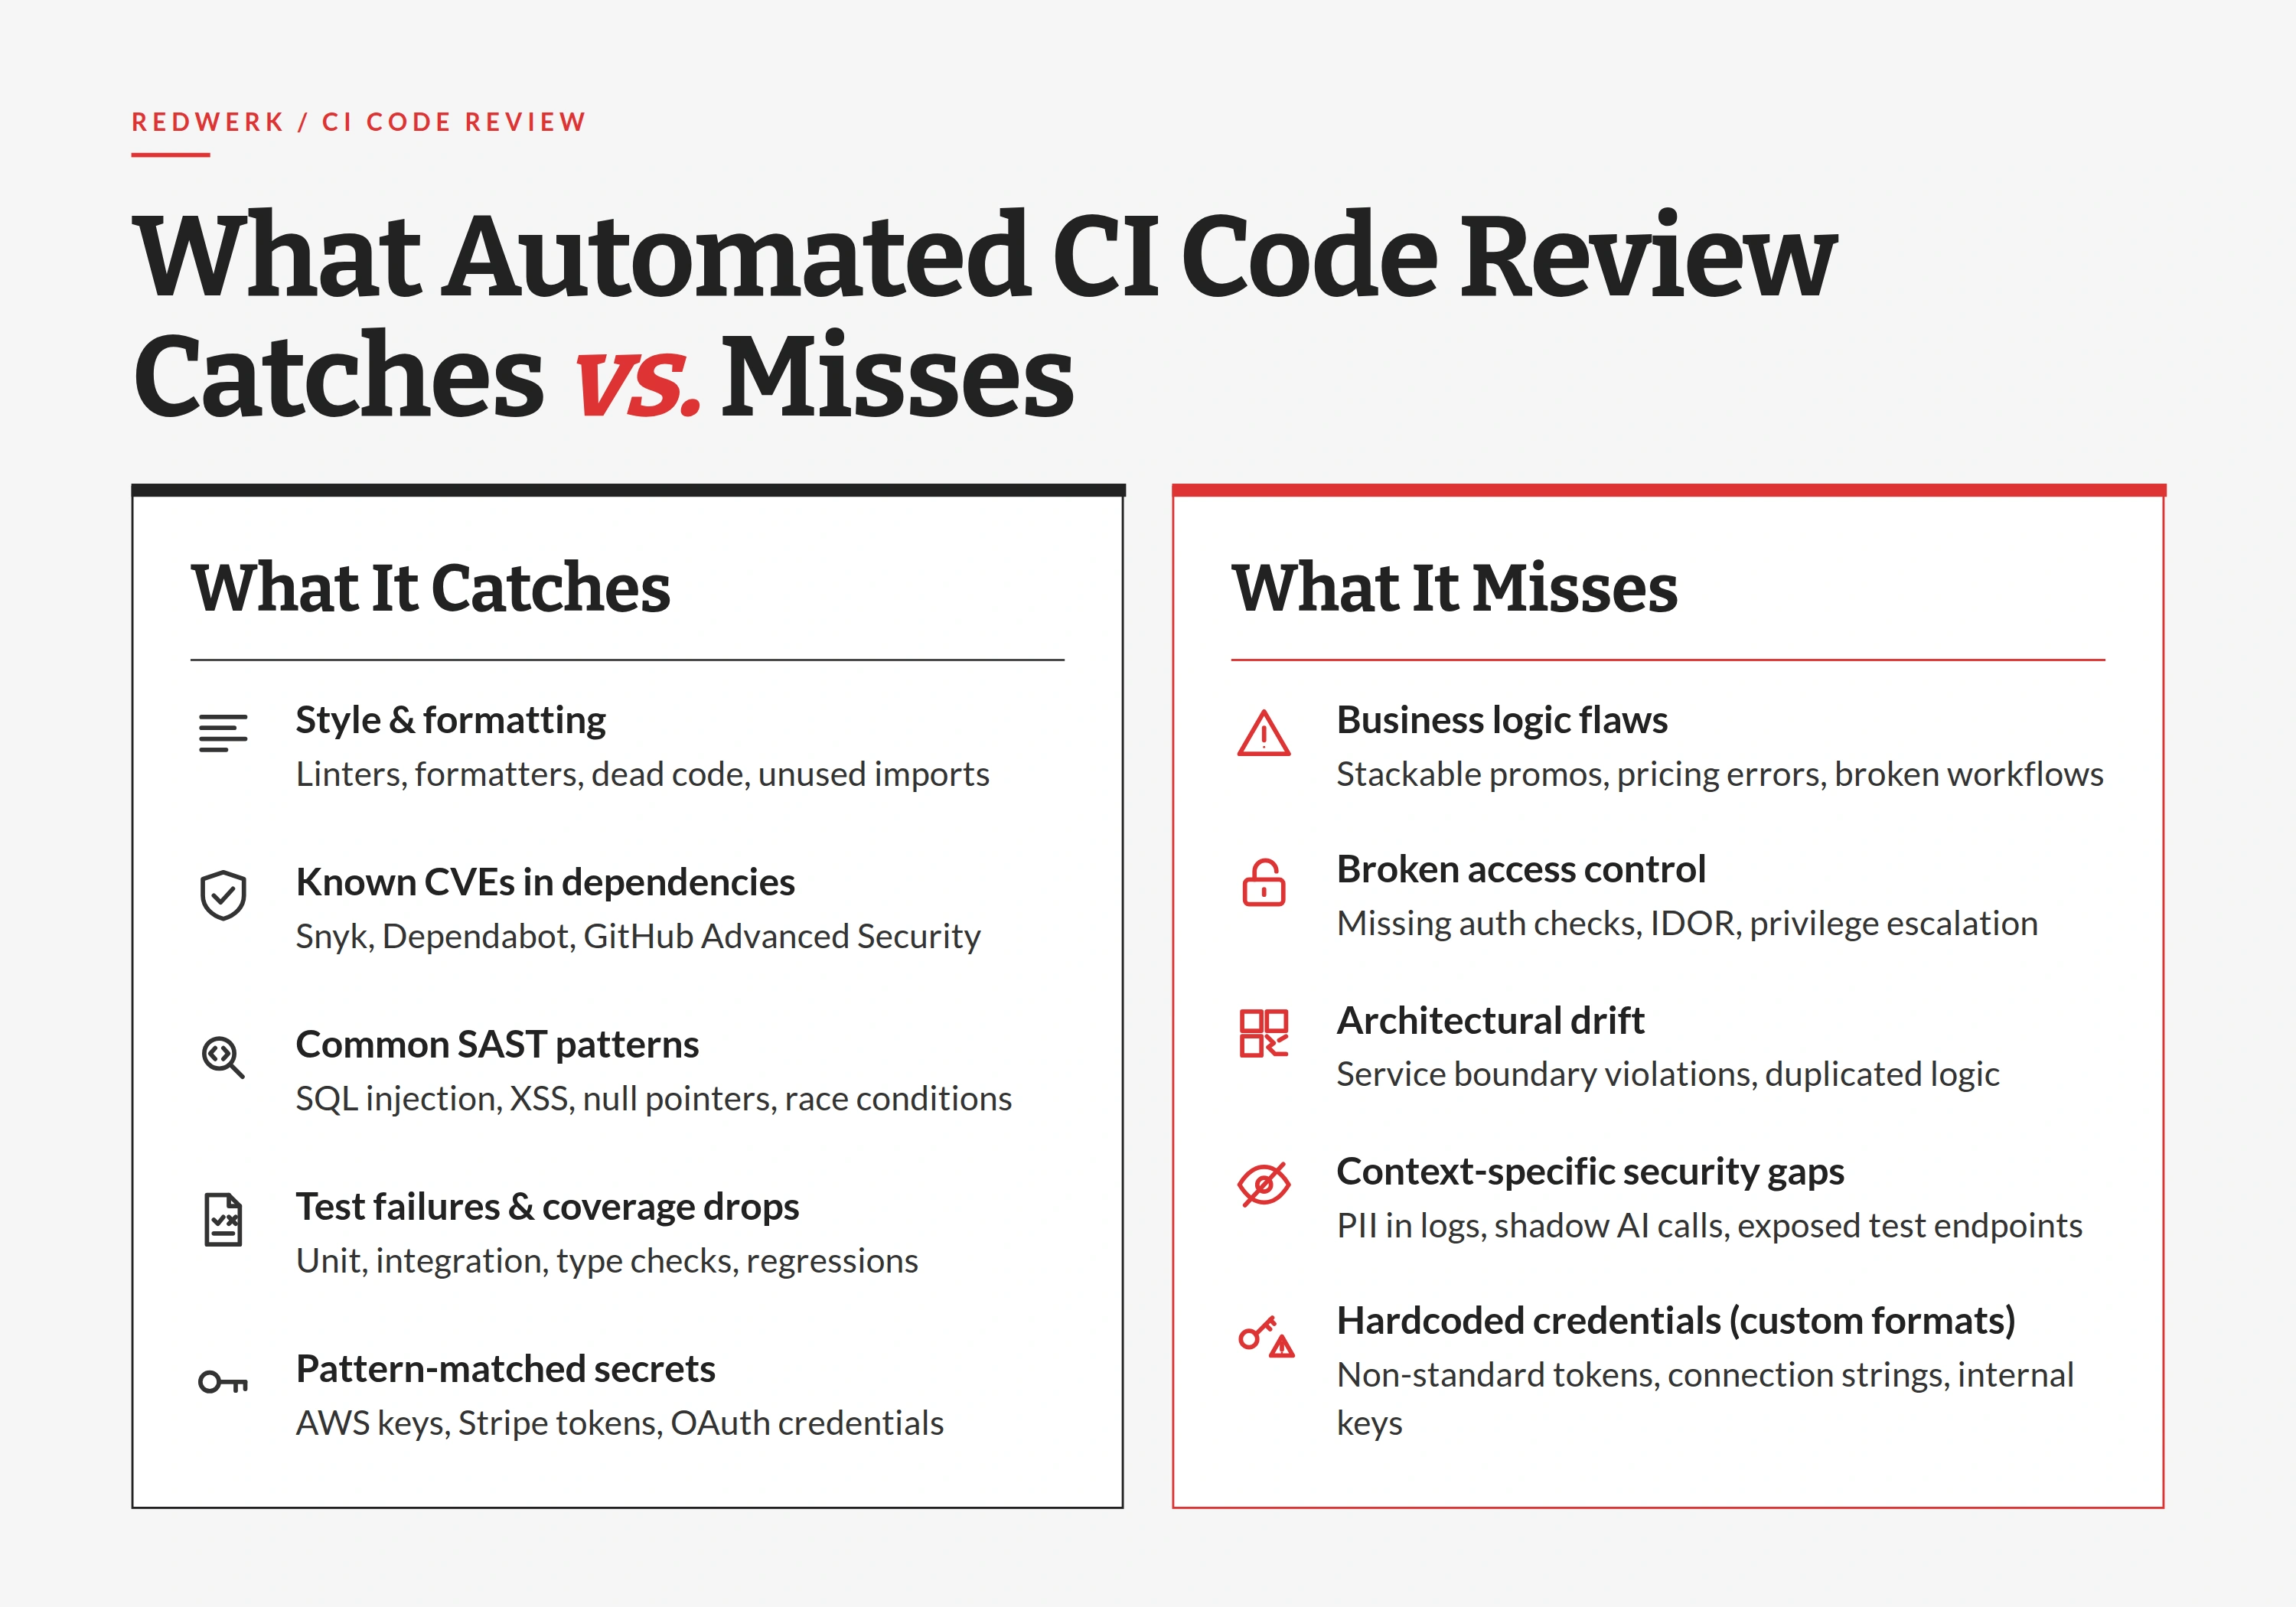
Ce que la revue de code CI automatisée détecte réellement
Parlons de ce que vos meilleurs outils d’automatisation de la revue de code CI savent réellement faire. Ces outils se sont considérablement améliorés, et un pipeline bien configuré détectera beaucoup de problèmes avant qu’un relecteur humain n’ait à se pencher sur le sujet.
Voici la liste honnête de ce que la revue de code en intégration continue gère de manière fiable.
Style, formatage et mauvaises pratiques évidentes
Les linters et formateurs (ESLint, Prettier, Black, RuboCop, golangci-lint) signalent l’indentation incohérente, les variables inutilisées, le code mort et les violations stylistiques. Cela peut sembler trivial, mais un style cohérent réduit la charge cognitive des relecteurs et évite que la discussion « tabulations contre espaces » ne ressurgisse plus d’une fois dans l’histoire de l’entreprise.
Vulnérabilités connues dans les dépendances
Des outils tels que Snyk, Dependabot et GitHub Advanced Security croisent votre package.json, pom.xml ou requirements.txt avec des bases de données de vulnérabilités. Si vous utilisez une bibliothèque présentant un CVE connu, vous le savez en quelques minutes. Sachant que les violations impliquant des identifiants compromis coûtent en moyenne 4,4 millions de dollars en 2025 selon le rapport IBM Cost of a Data Breach, détecter une dépendance vulnérable avant le déploiement est une très bonne journée.
Résultats de l'analyse statique
Les outils SAST (SonarQube, Semgrep, CodeQL, Checkmarx) analysent l’arbre syntaxique abstrait de votre code à la recherche de patterns associés à des bugs et des vulnérabilités. Ils excellent dans la détection des vecteurs d’injection SQL, des risques de pointeurs nuls, des conditions de course et de nombreux problèmes listés dans l’OWASP Top 10.
Couverture de tests et builds cassés
Si vous disposez d’une suite de tests, le CI est l’endroit où elle rapporte ses dividendes. Les outils de couverture signalent les pull requests qui font baisser la couverture ; les tests échoués bloquent les fusions ; les vérificateurs de types détectent les changements de contrat. C’est la base de tout plan de pipeline CI/CD, et l’ignorer n’est pas une option pour une équipe sérieuse.
Détection de secrets
Des outils comme Gitleaks, TruffleHog et la protection push de GitHub peuvent détecter des identifiants correspondant à des patterns connus (clés AWS, tokens Stripe, secrets OAuth). Mais le rapport State of Secrets Sprawl de GitGuardian a signalé près de 23,8 millions de nouveaux secrets codés en dur dans des commits GitHub publics en 2024, ce qui suggère que ces outils fonctionnent — mais seulement quand les équipes les activent et les configurent réellement. Les secrets génériques (tokens personnalisés, chaînes de connexion aux bases de données, clés d’API internes) passent fréquemment entre les mailles des matchers de patterns.
L’intégration CI/CD pour la revue de code détecte donc une part significative des problèmes automatiquement, et toute équipe sans cette couche laisse passer des victoires faciles. Pour en savoir plus sur la façon dont l’IA transforme cette couche, consultez notre article sur les revues de code alimentées par l’IA.
Ce que la revue de code CI automatisée ne détecte pas
Les revues en intégration continue automatisées sont des matchers de patterns. Elles excellent à trouver des choses qui ressemblent à des mauvaises choses connues. Elles sont incapables de comprendre ce que votre code essaie réellement de faire, si l’architecture est logique, ou si votre logique métier protège les revenus. Plusieurs catégories entières de problèmes vivent dans cet angle mort.
Failles dans la logique métier
Un analyseur statique ne peut pas détecter que votre endpoint de code de réduction permet aux utilisateurs d’empiler des promos qui étaient censées être mutuellement exclusives, ou qu’un coupon « premier achat » fonctionne toujours sur un compte actif depuis trois ans. Le code se compile, les tests passent et le linter est ravi — mais votre équipe financière ne le sera pas.
Bugs d'autorisation et de contrôle d'accès
La plupart des outils CI voient la syntaxe, pas l’intention. Ils ne peuvent pas facilement détecter qu’un nouvel endpoint d’administration a oublié son décorateur d’autorisation, ou qu’un utilisateur peut accéder aux factures d’un autre en modifiant un paramètre d’URL. L’OWASP Top 10 2025 classe le Broken Access Control comme le risque n° 1 des applications web pour une raison. Le détecter requiert généralement un relecteur qui comprend réellement votre modèle de permissions.
Dérive architecturale et dette technique
Les outils automatisés ne peuvent pas vous dire que le nouveau service de paiement accède directement à la base de données utilisateurs au lieu de passer par la frontière de service appropriée, ou que trois parties différentes du codebase implémentent désormais leur propre logique de retry avec des comportements légèrement différents. C’est le type de dommages à accumulation lente qui transforme un codebase sain en cauchemar de maintenance. La plupart des équipes savent qu’elles ont de la dette technique ; bien moins savent combien — c’est pourquoi nous avons rédigé un guide complet sur comment mesurer la dette technique.
Lacunes de sécurité spécifiques au contexte
Les scanners automatisés détectent les vulnérabilités génériques. Ils ne connaissent pas votre domaine. Ils ne signaleront pas que vous stockez des informations de santé personnelles dans un champ de journalisation, ou que votre endpoint de paiement en « mode test » est accessible en production, ou qu’une intégration IA envoie silencieusement les prompts des clients à une API tierce que l’équipe n’a jamais examinée. Ce dernier point est de plus en plus courant — c’est pourquoi nous avons traité la détection de l’IA fantôme comme une discipline à part entière.
Comment structurer la revue de code en intégration continue
Voici maintenant la partie utile. À quoi ressemble concrètement une couche de revue CI/CD mature, et comment en construire une sans transformer votre pipeline en un système lent et fragile.
La structure ci-dessous est ce que la plupart des organisations d’ingénierie devraient viser. Ce n’est pas la configuration la plus sophistiquée possible, mais c’est définitivement celle qui fonctionne.
Étape 1 : définir ce que signifie réellement « prêt à fusionner »
Avant d’écrire une seule GitHub Action ou un Jenkinsfile, notez vos critères de fusion. La plupart des équipes sautent cette étape et se demandent ensuite pourquoi leur pipeline continue à livrer des bugs. Une base raisonnable : tous les tests passent, la couverture ne descend pas en dessous d’un seuil, aucune découverte SAST de haute sévérité, aucune nouvelle vulnérabilité de dépendance, scan de secrets propre, au moins une approbation humaine. Tout critère plus strict est un jugement basé sur votre profil de risque.
Étape 2 : superposer les vérifications par vitesse et signal
Les vérifications rapides et peu coûteuses s’exécutent en premier ; les vérifications lentes et coûteuses s’exécutent ensuite. Le linting et le formatage en moins de 30 secondes. Les tests unitaires et le SAST en moins de 5 minutes. Les tests d’intégration, les scans de conteneurs et les vérifications de licences après cela. Voici à quoi ressemblent les solutions d’automatisation de la revue de code CI fluides une fois que l’on perce le marketing : une hiérarchie sensée de vérifications qui respecte le temps des développeurs.
Étape 3 : exiger une revue humaine du diff
L’automatisation gère les patterns, tandis que les humains gèrent le contexte. La recherche de SmartBear a constamment montré que 80 % des équipes satisfaites de leur qualité logicielle utilisent la revue de code basée sur des outils, mais ces outils soutiennent les relecteurs humains, ils ne les remplacent pas. Une bonne règle : au moins un relecteur qui n’a pas écrit le code, avec des instructions explicites pour considérer la logique métier, les autorisations et l’adéquation architecturale — et pas seulement la syntaxe.
Étape 4 : construire des boucles de retour, pas des barrières
Un pipeline qui échoue mystérieusement et force les développeurs à deviner est un pipeline qui finit par être désactivé. Chaque vérification automatisée devrait produire un message d’erreur exploitable qui pointe vers le fichier, la ligne et idéalement la correction. Une revue de code en intégration continue qui frustre les développeurs cesse très rapidement d’être continue.
Étape 5 : mesurer et affiner
Suivez quelles vérifications détectent de vrais problèmes, lesquelles produisent de faux positifs et lesquelles sont ignorées. Une règle SAST qui se déclenche 200 fois par semaine sans jamais identifier un vrai bug est du bruit ; désactivez-la ou affinez-la. La mesure périodique est ce qui distingue les meilleurs outils d’automatisation de revue de code CI des outils que vous avez installés une fois et n’avez plus jamais regardés.
Étape 6 : planifier ce que l'automatisation ne peut pas voir
C’est l’étape que la plupart des équipes sautent. Planifiez des revues de code approfondies périodiques, idéalement avec des ingénieurs qui n’ont pas écrit le code, en examinant spécifiquement les catégories que la revue automatisée manque : la logique métier, l’architecture, le contexte de sécurité et le risque opérationnel. Pour les logiciels gérant de l’argent, des données de santé ou des informations utilisateurs sensibles, ce n’est pas facultatif. Si vous n’avez pas la capacité interne, c’est exactement là qu’un partenaire externe apporte une valeur disproportionnée.
Bonnes pratiques de revue de code continu
Une fois le pipeline en place, les pratiques qui l’entourent déterminent s’il reste utile ou devient ce que tout le monde contourne. Quelques règles distinguent les équipes qui livrent en toute sécurité de celles qui livrent et espèrent.
- Gardez les pull requests petites. Une pull request de 50 lignes fait l’objet d’une vraie revue. Une pull request de 5 000 lignes reçoit un pouce levé. Limitez les modifications à une unité logique par PR : une fonctionnalité, une correction ou un refactoring. Les grandes modifications sont décomposées en une séquence de petites.
- Révisez le diff, pas la description. Les relecteurs expérimentés lisent ce qui a changé, pas ce que l’auteur dit avoir changé. Les deux divergent souvent.
- Définissez ce qui bloque une fusion. Écrivez-le. « Une découverte de sécurité au-dessus de la sévérité moyenne bloque la fusion. » « Une baisse de couverture de tests bloque la fusion. » « Deux approbations requises sur /payments/. » Quand les règles sont explicites, les relecteurs cessent de discuter si une modification mérite d’être fusionnée et commencent à vérifier si elle respecte les critères.
- Faites tourner les relecteurs. Quand la même personne relit tout, deux choses arrivent : elle s’épuise et tous les autres cessent d’apprendre le codebase. Faites tourner la propriété et associez les ingénieurs juniors aux seniors sur les modifications complexes.
- Traitez les retours de revue comme une partie du produit. Une pull request bloquée pour une vraie raison, c’est le système qui fonctionne. L’auteur ne devrait pas le prendre personnellement, et le relecteur ne devrait pas adoucir le retour au point de le rendre inutile. Direct, spécifique et bienveillant est la cible.
- Mesurez ce qui compte. Temps depuis l’ouverture de la PR jusqu’à la fusion. Défauts qui atteignent la production. Tendance de la couverture. Temps moyen de retour en arrière. Si vous ne pouvez pas voir la tendance, vous ne pouvez pas vous améliorer. La recherche DORA State of DevOps montre constamment que les équipes avec des cycles de revue plus courts et des boucles de feedback plus serrées surpassent sur tous les indicateurs de fiabilité.
- Auditez séparément votre code généré par IA. Si votre équipe livre du code assisté par IA, votre processus de revue doit en tenir compte. La revue consciente de l’IA détecte une classe différente de bugs et est désormais une pratique de base. Les mêmes principes s’appliquent à la détection et à la gestion de l’utilisation de l’IA fantôme dans les outils de votre équipe.
Quand faire appel à une revue de code externe
Un processus de revue interne raisonnable détecte la plupart des problèmes quotidiens. La revue externe existe pour ce que votre équipe ne peut pas voir, soit parce qu’elle a écrit le code, soit parce qu’elle n’a jamais rencontré les patterns qui causent des dommages spécifiques.
Les déclencheurs évidents pour une revue externe incluent les suivants :
- la préparation d’une due diligence (les investisseurs effectueront absolument leur propre audit)
- l’entrée dans des secteurs réglementés comme la fintech ou la santé
- la migration entre architectures
- l’intégration avec des fournisseurs de paiement ou des API sensibles
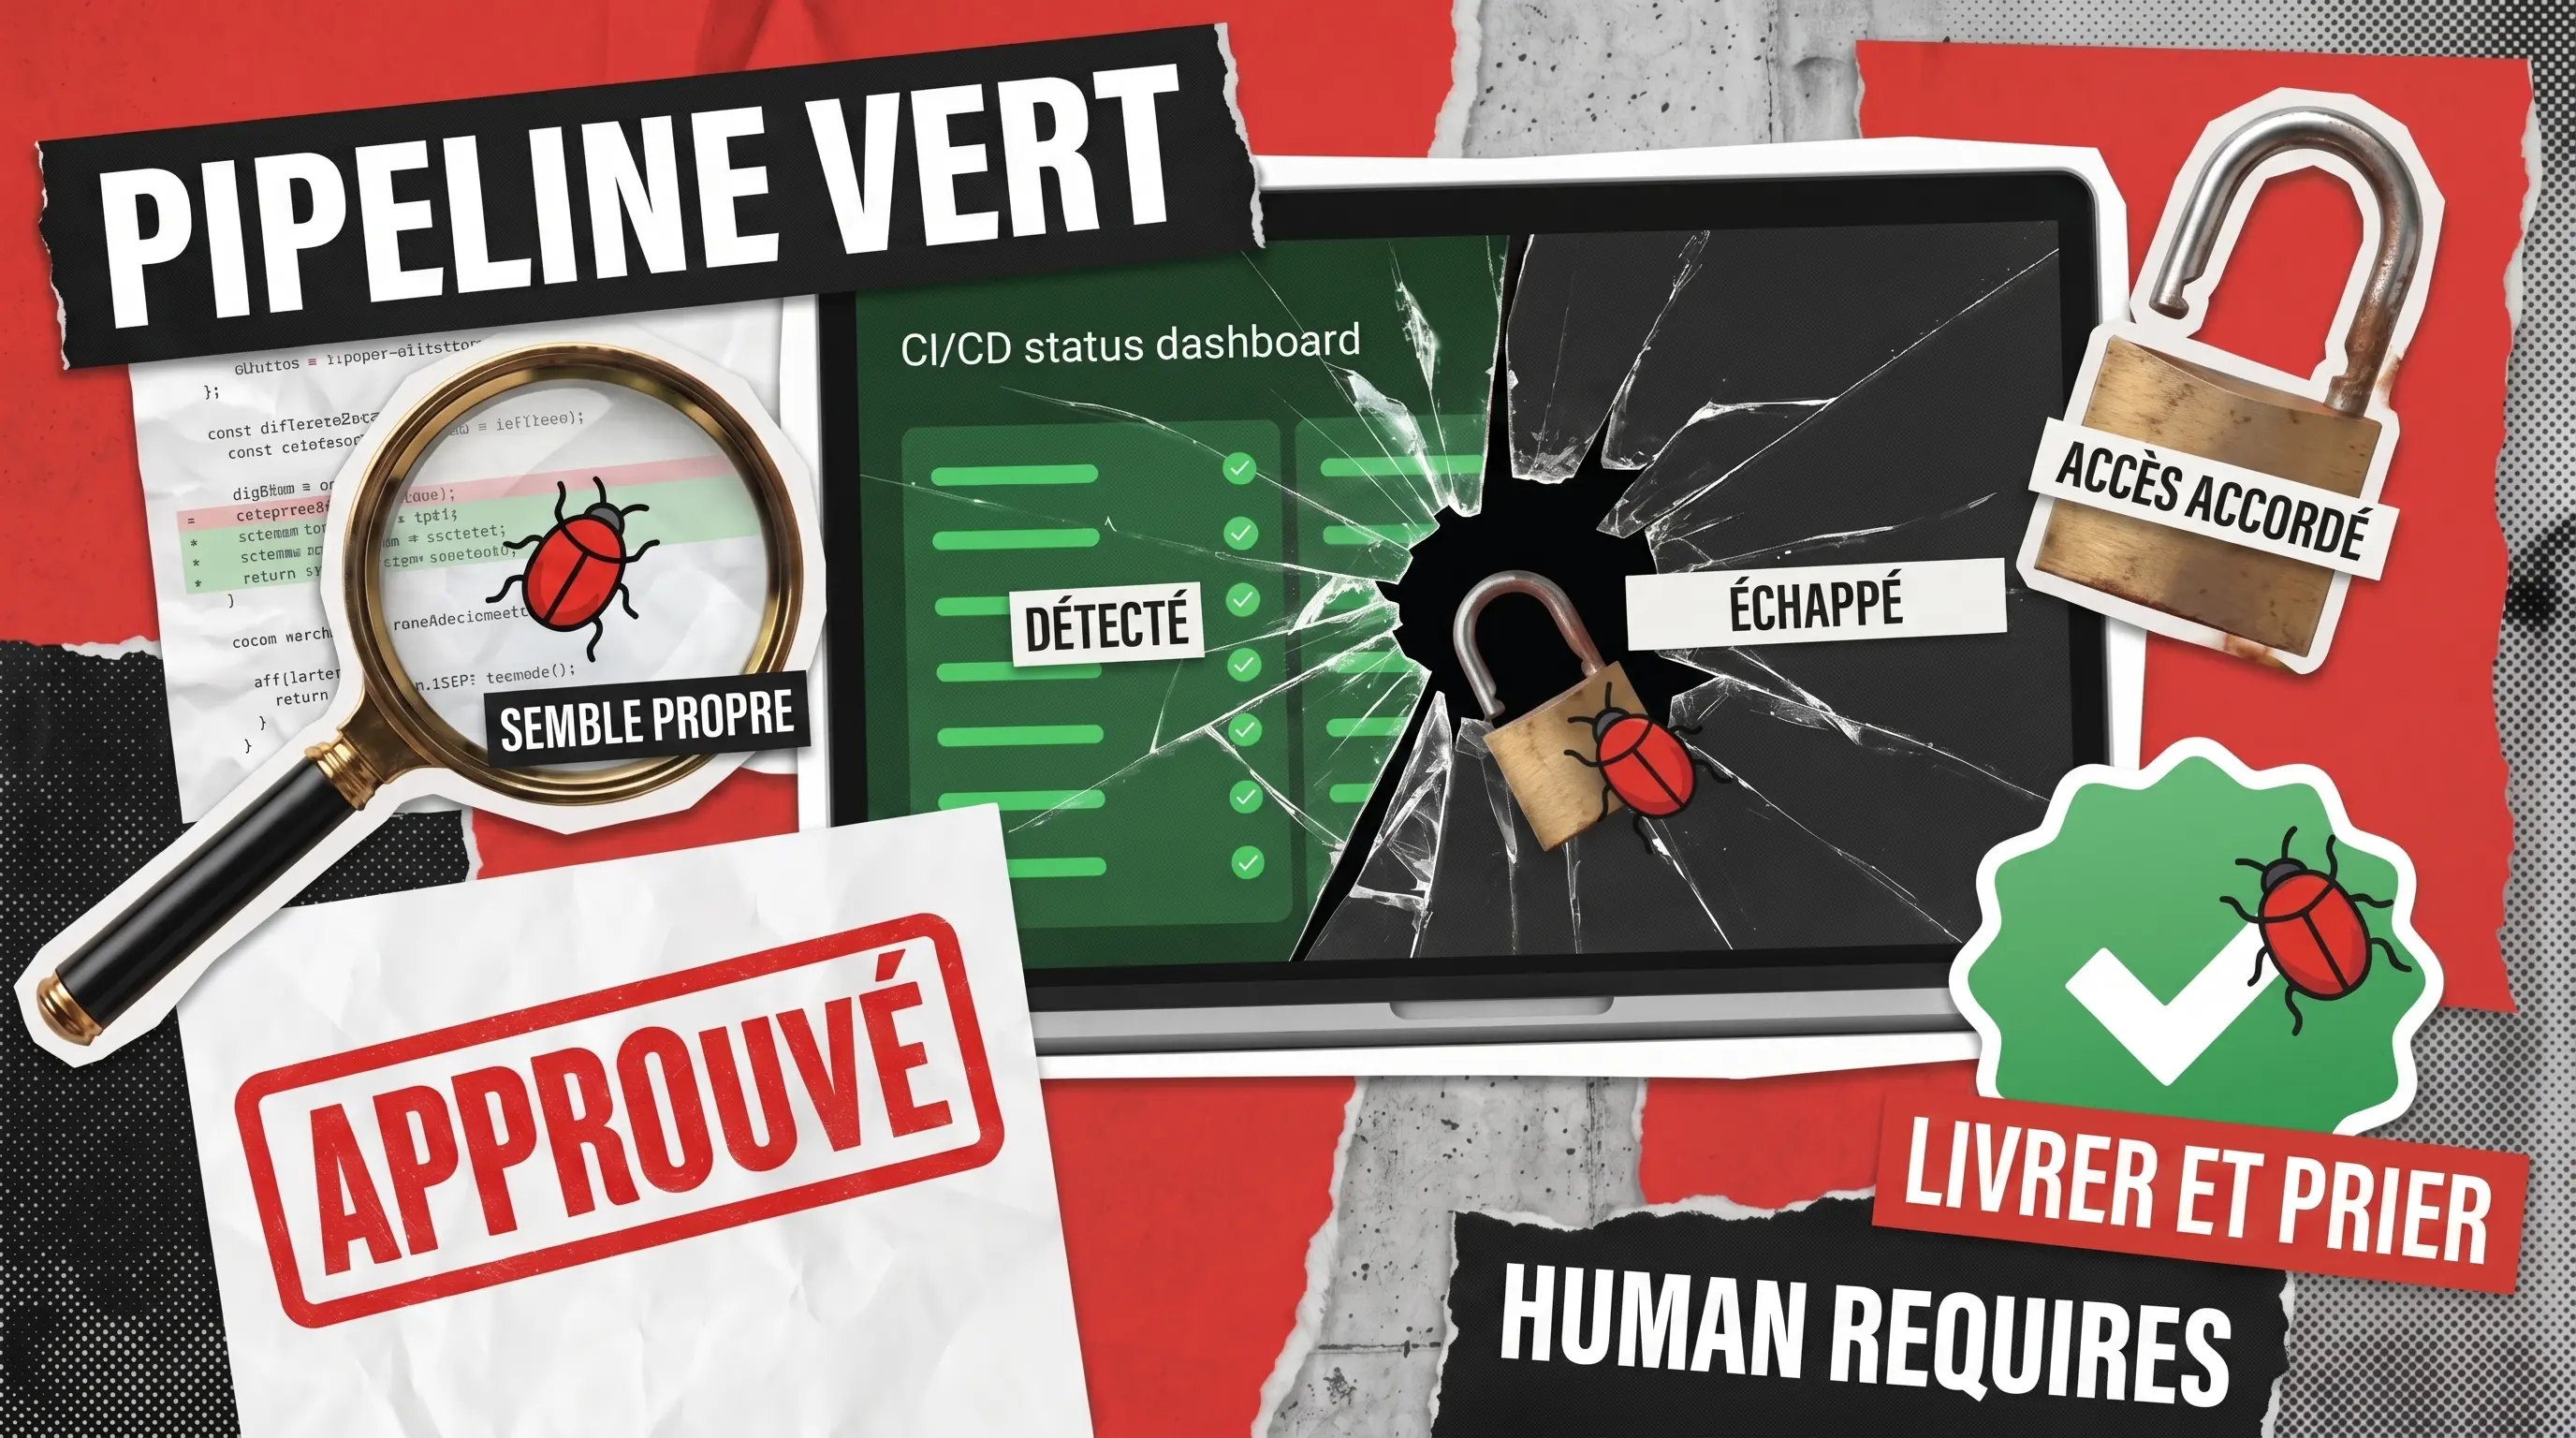
- le constat que des incidents continuent de se produire malgré un pipeline au vert
Un audit de développement logiciel par un tiers apporte des ingénieurs seniors qui ne se sont pas enfermés dans vos hypothèses. Ils lisent le code sans contexte, ce qui est exactement ce que l’équipe d’ingénierie d’un investisseur ou d’un acquéreur fera. Les conclusions sont généralement un mélange : la confirmation que les parties évidentes sont solides, plus une liste de problèmes spécifiques que l’équipe interne avait cessé de voir.
C’était le cas d’Adoorabelle. L’équipe avait un produit fonctionnel et un pipeline fonctionnel. Notre revue a mis en lumière ce qu’ils ne pouvaient pas voir de l’intérieur, notamment le problème de credentials, la surcharge AWS, un backlog priorisé de 80 éléments et les lacunes de documentation qui auraient rendu la prochaine due diligence difficile.
Si vous souhaitez un second regard sur ce que votre pipeline détecte réellement, notre équipe effectue des revues continues spécifiquement conçues pour combler les lacunes que les outils automatisés laissent. Si cela correspond à ce dont votre équipe a besoin, contactez-nous et nous définirons une revue adaptée à votre stack, votre profil de risque et votre calendrier.
Obtenez votre exemple gratuit d'audit de développement logiciel