Lorsqu’un utilisateur tape une question complète dans votre barre de recherche et n’obtient aucune réponse utile, il reformule rarement et réessaie. Il abandonne tout simplement, et cette friction s’accumule à chaque session et à chaque compte.
Cette friction coûte plus cher qu’il n’y paraît. Une enquête menée par The Harris Poll pour Google Cloud a révélé que 94% des consommateurs américains ont abandonné une session d’achat en raison de résultats de recherche non pertinents, coûtant aux détaillants une estimation de 300 milliards de dollars par an.
Ce qui a changé, c’est que le développement de grands modèles linguistiques a atteint un tel niveau de maturité que la résolution de ce problème est à la portée d’une équipe produit ordinaire. Ce guide présente aux décideurs des entreprises de logiciels en tant que service (SaaS) la recherche sémantique LLM en langage clair : ce que c’est, comment la construire, à quoi faire attention et comment déterminer si vous devriez la construire.
Qu'est-ce que la recherche sémantique ?
La recherche sémantique est une méthode de recherche qui se concentre sur le sens et l’intention derrière une requête, plutôt que sur les mots exacts tapés par une personne. Au lieu de rechercher des correspondances littérales de chaînes de caractères, elle prend en compte les relations entre les mots et le contexte de la demande, de sorte que « gants chauds d’hiver » puisse suggérer des options en laine et en polaire, même si le mot « chauds » n’apparaît jamais dans la description du produit. C’est une technique qui vise à comprendre le sens profond d’une recherche, un peu comme le ferait un humain.
En coulisses, cela est alimenté par deux proches cousines de l’intelligence artificielle (IA) moderne. Les modèles d’apprentissage automatique de recherche sémantique convertissent le texte en représentations numériques appelées intégrations (embeddings), et le NLP (traitement du langage naturel) de la recherche sémantique gère la tâche complexe d’interpréter la formulation humaine. Un grand modèle linguistique (LLM) amplifie cela en générant des intégrations plus riches et, dans certaines configurations, en écrivant une réponse directe au-dessus des résultats. Cette combinaison est ce que les gens entendent par recherche sémantique alimentée par l’IA.
Recherche sémantique vs Recherche par mots-clés
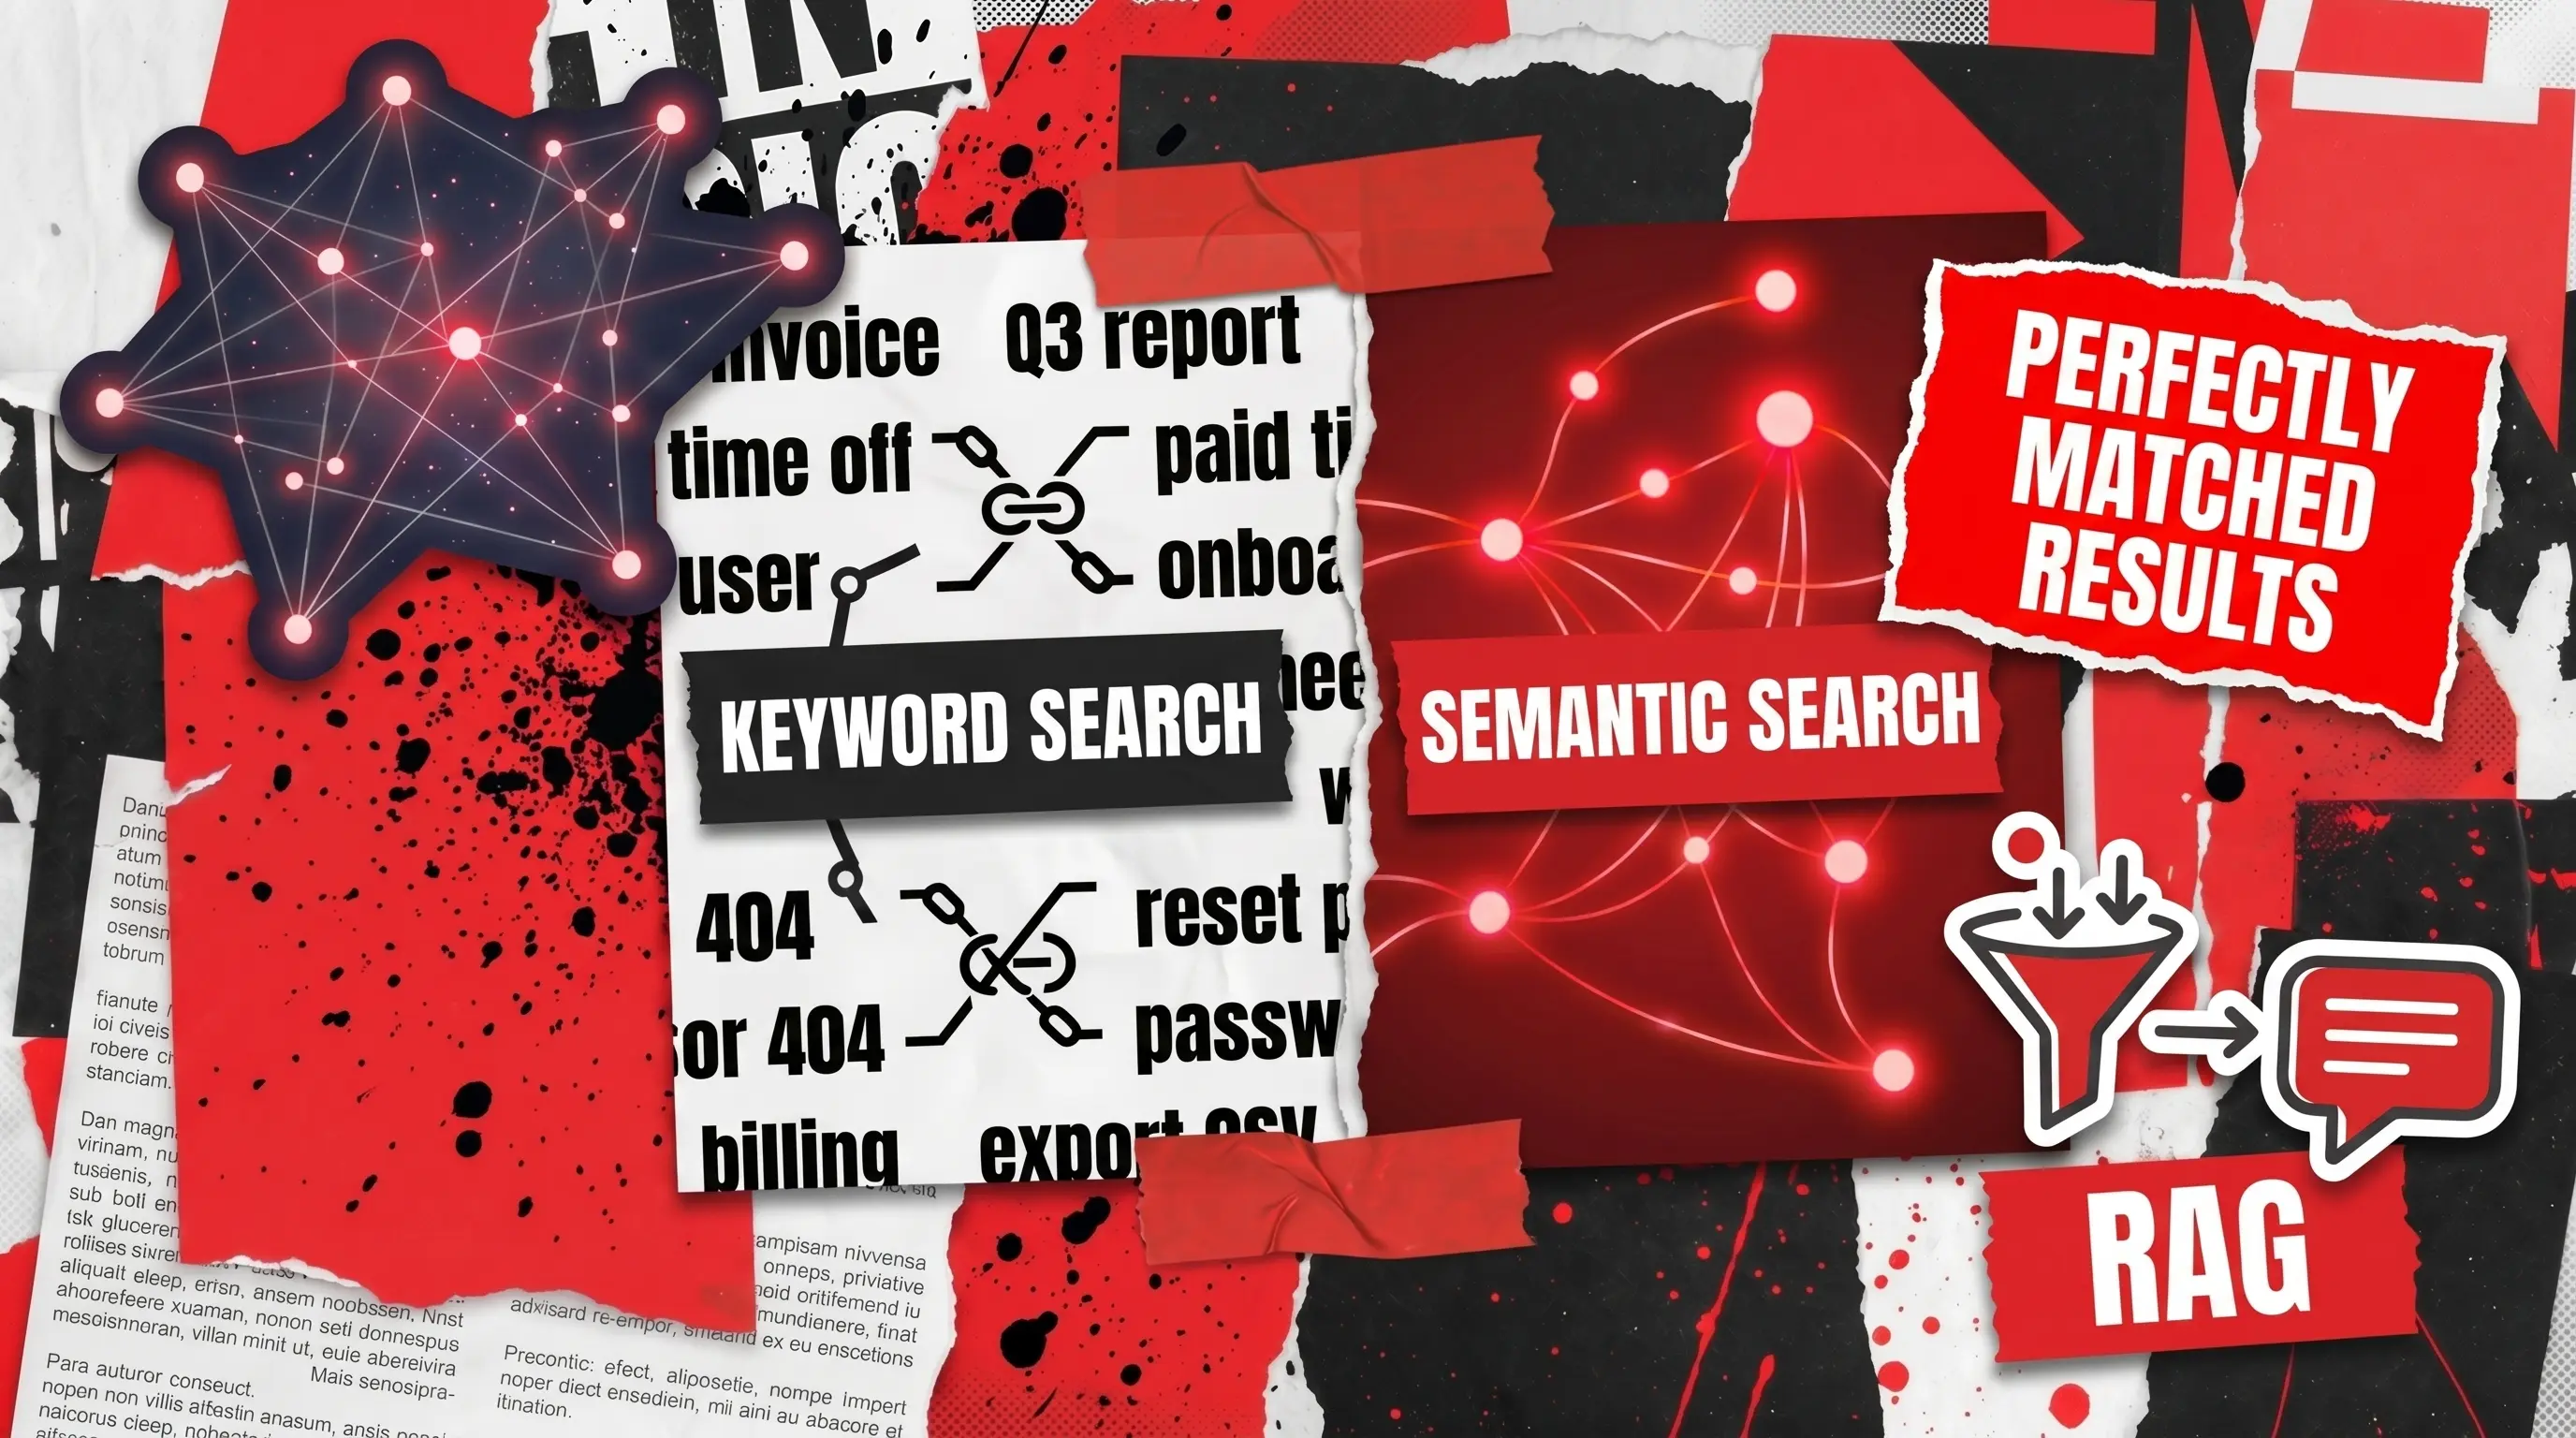
La différence entre la recherche sémantique et la recherche par mots-clés réside dans la correspondance du sens par rapport à la correspondance des caractères. La recherche par mots-clés recherche les termes littéraux de votre requête, c’est pourquoi une recherche de « politique de congés payés » peut complètement manquer un document intitulé « Directives sur les vacances et les congés ».
La distinction entre la recherche lexicale et la recherche sémantique est la même idée exprimée plus formellement : la recherche lexicale repose sur la forme superficielle des mots, tandis que la recherche sémantique interprète ce à quoi ces mots renvoient réellement. Pour les équipes SaaS, la conclusion est simple. La recherche par mots-clés pénalise les utilisateurs qui ne devinent pas votre vocabulaire interne, et la recherche sémantique leur pardonne.
Recherche sémantique basée sur les vecteurs
La plupart des implémentations modernes sont basées sur la recherche sémantique vectorielle. Chaque contenu et chaque requête est transformé en un vecteur, qui est une longue liste de nombres capturant le sens, et le système trouve des correspondances en mesurant quels vecteurs sont les plus proches dans l’espace mathématique. C’est la salle des machines de la recherche vectorielle sémantique, et c’est ce qui permet à « automobile » et « voiture » de se retrouver automatiquement proches les uns des autres.
Recherche sémantique contextuelle
La recherche sémantique contextuelle ajoute une autre couche en prenant en compte des signaux au-delà de la requête elle-même, tels que la localisation, le rôle ou le comportement passé de l’utilisateur, de sorte qu’une recherche de « cartes de sentiers » sur une application de parc national puisse prioriser les sentiers près de l’entrée actuelle du visiteur. Pour une vue architecturale plus approfondie, l’équipe de services de développement en intelligence artificielle de Redwerk modélise souvent ces signaux contextuels dans le cadre de la couche de données plutôt que de les ajouter ultérieurement.
RAG vs Recherche sémantique
Les équipes confondent souvent ces deux éléments, alors traçons une ligne claire entre eux. La réponse honnête à la question RAG vs recherche sémantique est qu’ils ne sont pas concurrents. La génération augmentée par récupération (RAG) est un flux de travail qui utilise la recherche sémantique comme première étape, puis alimente le contenu récupéré à un LLM pour écrire une réponse en langage naturel.
En d’autres termes, la recherche sémantique récupère ; RAG récupère puis compose. Si votre objectif est « montrez-moi les bons résultats », vous avez besoin de la recherche sémantique ; s’il s’agit de « répondez à ma question avec des sources », vous avez besoin de RAG par-dessus. Nous abordons la couche de génération dans notre guide sur les meilleures pratiques RAG, donc cet article reste concentré sur la base de récupération dont dépendent les deux approches.
Implémentation de la recherche sémantique dans votre produit SaaS
Construire la recherche sémantique LLM tôt, alors que votre modèle de données et votre architecture sont encore flexibles, coûte beaucoup moins cher que de la rétroconcevoir sur un produit mature plus tard. La recherche touche votre couche de données, vos permissions et votre pipeline d’indexation, de sorte que les décisions que vous prenez maintenant se répercutent sur tout ce que vous ajoutez par la suite. Obtenir les bonnes bases dès le départ est ce qui sépare une fonctionnalité qui évolue gracieusement d’une fonctionnalité que vous finissez par reconstruire sous pression.
Tout au long du processus, rappelez-vous que l’objectif de l’implémentation de la recherche sémantique dans la pile SaaS que vous possédez déjà est le plus petit système fiable qui améliore mesurablement les résultats, pas une reconstruction de votre produit autour de celle-ci.
Étape 1 : Diagnostiquer si vous en avez vraiment besoin
Avant d’écrire une ligne de code, effectuez un diagnostic rapide. Consultez vos journaux de recherche et examinez trois éléments : la proportion de recherches ne retournant aucun résultat, la proportion où les utilisateurs affinent leur requête plus de deux fois, et le nombre de requêtes formulées sous forme de questions complètes plutôt que de mots-clés. Si ces chiffres sont élevés, vos utilisateurs parlent humain et votre recherche écoute en robot.
Appliquez maintenant un cadre de décision simple. La recherche sémantique justifie son coût lorsqu’elle traite un volume significatif de contenu non structuré (documents, tickets, produits, messages), lorsque les synonymes et la variété des formulations vous nuisent, et lorsque la recherche est liée à un résultat commercial réel comme la conversion ou la rétention.
Si votre catalogue est minuscule et que vos utilisateurs connaissent toujours le numéro de pièce exact, un index de mots-clés bien ajusté peut suffire. Savoir quand faire appel à une aide extérieure est une compétence en soi, que nous détaillons dans quand faire appel à un consultant en architecture logicielle.
Étape 2 : Préparer et segmenter vos données
« Garbage in, garbage out » s’applique brutalement ici. La première tâche réelle consiste à rassembler votre contenu et à le diviser en segments (chunks), c’est-à-dire des passages suffisamment petits pour représenter une idée unique mais suffisamment grands pour conserver le contexte. Un point de départ courant est de quelques centaines de tokens par segment avec un léger chevauchement afin que le sens ne soit pas coupé en plein milieu d’une phrase.
La mise en garde que la plupart des équipes manquent est celle des métadonnées. Chaque segment doit comporter des champs structurés tels que l’auteur, la date, la catégorie, les permissions d’accès et l’URL source, car vous en aurez besoin plus tard pour le filtrage et la sécurité, et les rétroéquiper est douloureux. Des données propres et bien étiquetées sont le prédicteur le plus important du succès de votre projet de création d’un moteur de recherche sémantique, qu’il soit magique ou médiocre.
Étape 3 : Choisir un modèle d'intégration (embedding)
Les intégrations sont le cœur du système, et le modèle que vous choisissez détermine la qualité, le coût et la latence. Vous pouvez appeler un modèle d’intégration hébergé via une interface de programmation d’applications (API) pour une configuration rapide, ou exécuter un modèle open-source vous-même pour plus de contrôle et de résidence des données. En pratique, un bon modèle transforme une requête comme « quelle est notre politique de congés » et un document intitulé « Directives sur les vacances et les congés » en vecteurs qui se situent à proximité les uns des autres, même si les deux ne partagent aucun mot.
Une mise en garde pratique : ne mélangez pas les modèles d’intégration. Les vecteurs d’un modèle ne sont pas comparables à ceux d’un autre, donc si vous mettez à niveau, vous réintégrez tout. Les équipes qui souhaitent de l’aide pour choisir et affiner les modèles s’appuient souvent sur le support dédié au développement de grands modèles linguistiques pour éviter des surprises coûteuses de réindexation à l’avenir.
Étape 4 : Configurer la couche de recherche vectorielle sémantique
Une fois que votre contenu est intégré, les vecteurs ont besoin d’un endroit où vivre et être recherchés rapidement. C’est le rôle d’une base de données vectorielle, le cheval de bataille de la recherche vectorielle sémantique à grande échelle. Vous indexez le vecteur de chaque segment avec ses métadonnées, et au moment de la requête, la base de données renvoie les correspondances les plus proches en quelques millisecondes.
Vous avez des options ici, et le choix est plus important pour les opérations que pour les résultats. Certaines équipes ajoutent des capacités vectorielles à une base de données qu’elles gèrent déjà ; d’autres adoptent un entrepôt vectoriel spécialement conçu. À petite échelle, presque tout fonctionne, mais le rappel, la latence et le coût divergent fortement au-delà de millions de vecteurs, alors dimensionnez votre test par rapport à des volumes réalistes plutôt qu’à un jeu de données jouet.
Étape 5 : Construire la couche de récupération et de classement
Les correspondances vectorielles brutes sont un bon début, mais rarement le produit fini. Les systèmes les plus performants utilisent une récupération hybride, combinant la recherche vectorielle sémantique avec un classement par mots-clés traditionnel, de sorte que vous obtenez à la fois le sens et la précision de la correspondance exacte (essentiel pour les codes de produits, les noms et les acronymes). Après la récupération, une étape de ré-classement réordonne les meilleurs candidats en utilisant un modèle plus puissant pour ce gain final en pertinence.
Cette couche est également l’endroit où résident le filtrage et les permissions. En utilisant les métadonnées de l’étape 2, vous limitez les résultats à ce qu’un utilisateur donné est autorisé à voir avant que quoi que ce soit n’atteigne l’écran. Omettre cela est une erreur classique et grave, car une boîte de recherche qui affiche les données d’un autre client est une violation de données portant un joli interface utilisateur.
Étape 6 : Intégrer dans votre recherche en application et mesurer
Enfin, connectez le service de récupération à l’expérience de recherche intégrée à votre produit. Gardez l’interface familière, renvoyez les résultats rapidement et, là où cela apporte de la valeur, superposez un LLM pour résumer ou répondre directement (votre étape RAG). Ensuite, crucialement, instrumentez tout.
Vous ne pouvez pas améliorer ce que vous ne mesurez pas, alors suivez le taux de clics, le taux de zéro résultat et les reformulations de requêtes avant et après le lancement, et déployez derrière un indicateur de fonctionnalité pour une partie des utilisateurs en premier. Si vous intégrez cela dans une initiative IA plus large, un audit d’implémentation IA d’entreprise structuré est un moyen judicieux de tester le déploiement par rapport aux normes de sécurité et de performance avant qu’il ne touche tous les comptes.
Bonnes pratiques d'implémentation de la recherche sémantique
Ces bonnes pratiques d’implémentation de la recherche sémantique proviennent des modèles qui tiennent constamment en production. Traitez-les comme une checklist à revisiter, pas comme une configuration unique.
- Commencez par une base de référence mesurable. Capturez votre taux de zéro résultat et votre taux de clics avant de changer quoi que ce soit, afin de pouvoir prouver l’amélioration plus tard.
- Utilisez la recherche hybride par défaut. La recherche sémantique pure peut échouer sur les identifiants exacts ; la coupler avec un classement par mots-clés couvre à la fois le sens et la précision.
- Ré-classez les meilleurs résultats. Un passage de récupération léger plus un modèle de ré-classement plus puissant offre la plupart des gains de qualité pour une fraction du coût.
- Intégrez la sécurité dès le premier jour. Appliquez les filtres de permission pendant la récupération, jamais après, de sorte que les utilisateurs ne voient jamais que ce à quoi ils ont droit.
- Planifiez la ré-intégration. Enregistrez votre modèle et sa version, car la mise à niveau signifie le retraitement de votre corpus et les migrations surprises sont coûteuses.
- Gardez un humain dans la boucle. Créez un petit ensemble « doré » de requêtes réelles avec des réponses connues et testez chaque changement par rapport à celui-ci.
- Surveillez la latence et le coût à mesure que vous évoluez. Ce qui semble instantané sur dix mille vecteurs peut être lent sur dix millions.
Pour les organisations qui pèsent les options de création par rapport à l’achat, notre cabinet de conseil en développement logiciel aide fréquemment les équipes à tester ces compromis avant qu’elles ne s’engagent budgétairement envers une seule architecture.
Cas d'utilisation et exemples concrets de recherche sémantique LLM
La théorie est agréable, mais il est utile de voir où cette technologie porte réellement ses fruits. Les cas d’utilisation ci-dessous couvrent diverses industries, et chacun est fondé sur une implémentation réelle ou des recherches crédibles. Le fil conducteur est que la recherche basée sur le sens transforme une impasse frustrante en un résultat qui correspond à ce que l’utilisateur voulait réellement.
Recherche sémantique de produits dans le e-commerce
Le gain le plus visible est la recherche sémantique de produits dans le commerce de détail en ligne. Lorsqu’un acheteur tape « chaussures confortables pour rester debout toute la journée », la recherche par mots-clés a du mal, mais la recherche sémantique associe l’intention à des chaussures rembourrées et de soutien, quelle que soit la formulation exacte.
La personnalisation multiplie l’effet. McKinsey rapporte que les entreprises en croissance plus rapide tirent 40 % de leurs revenus de la personnalisation que leurs pairs à croissance plus lente. Si vous associez la recherche sémantique aux recommandations et à l’automatisation, notre guide sur l’automatisation IA dans le e-commerce décrit où les deux se renforcent mutuellement.
Recherche sémantique d'entreprise pour les connaissances internes
Au sein des entreprises, la recherche sémantique d’entreprise s’attaque à la perte de productivité due à la dispersion des informations. Les employés posent des questions en langage naturel et obtiennent des réponses provenant de wikis, de tickets et de bases de documents au lieu de naviguer entre une douzaine d’outils. C’est un exemple typique de recherche sémantique générant un retour sur investissement concret, car récupérer ne serait-ce qu’une fraction du temps que McKinsey estime que les travailleurs perdent à chercher permet de rentabiliser le système maintes et maintes fois.
Plateformes de développement et technologies pour le recrutement
Les plateformes techniques ont été des adopteurs précoces car leur contenu est dense et leurs utilisateurs sont exigeants. Stack Overflow, par exemple, a documenté publiquement la création de la recherche sémantique pour permettre aux utilisateurs de « poser des questions comme un humain » plutôt que de deviner les mots-clés parfaits. Le même principe alimente des outils de talent et de recrutement plus intelligents, où l’adéquation entre un candidat et un poste est fondamentalement un problème de sens.
Notre étude de cas Recruit montre comment la mise en correspondance axée sur le sens remodèle un produit de recrutement. Dans chacun de ces exemples, le différenciateur n’est pas le modèle lui-même, mais la rigueur de l’implémentation de la recherche sémantique autour de celui-ci.
Votre meilleur consultant en stratégie de recherche sémantique
S’il y a une barrière qui freine ces projets plus que toute autre, ce n’est pas le budget ni même les données. C’est le manque d’expertise interne spécialisée pour concevoir, construire et sécuriser le système de bout en bout. De nombreuses entreprises vous conseilleront volontiers sur une feuille de route ; beaucoup moins la mettront réellement en œuvre avec votre équipe.
C’est exactement là qu’intervient Redwerk. Nous appliquons des principes d’ingénierie fondamentaux et des meilleures pratiques de sécurité, perfectionnés au fil de décennies de création de logiciels personnalisés pour des entreprises en Amérique du Nord et en Europe, y compris des organisations du Fortune 500 telles que Siemens, J.B. Hunt et Universal Music Group.
Concrètement, cela signifie que nous traitons votre fonctionnalité de recherche sémantique LLM comme nous traitons tout système de production : avec une attention particulière à la qualité des données, à l’évolutivité, à la sécurité et aux résultats mesurables. Nous vous aidons à effectuer le diagnostic, à choisir l’architecture, à la construire et à prouver son efficacité. Si vous êtes prêt à transformer une boîte de recherche frustrante en un véritable avantage concurrentiel, contactez-nous et notre équipe vous mènera de la feuille de route au logiciel opérationnel sans le décalage de transition qui fait échouer tant de projets IA.
Questions fréquemment posées
Qu'est-ce que la recherche sémantique en IA ?
La recherche sémantique en IA est une méthode de recherche qui interprète le sens et l’intention derrière une requête au lieu de faire correspondre des mots-clés exacts. Elle utilise le traitement du langage naturel et l’apprentissage automatique pour convertir le texte en vecteurs et renvoyer des résultats conceptuellement pertinents, même lorsque la formulation diffère du contenu source.
Quelle est la différence entre la recherche sémantique et une base de données vectorielle ?
Une base de données vectorielle est une infrastructure ; la recherche sémantique est la capacité qu’elle permet. La base de données stocke et recherche rapidement les intégrations numériques, tandis que la recherche sémantique est le système plus large qui intègre les requêtes, récupère les vecteurs voisins, applique des filtres et classe les résultats.
Combien de temps prend une implémentation de recherche sémantique ?
Une preuve de concept ciblée sur un jeu de données propre peut prendre quelques semaines, tandis qu’un déploiement de qualité production et sécurisé dure généralement quelques mois. La variable la plus importante n’est presque jamais le modèle, mais presque toujours l’état de vos données et vos exigences de sécurité.
Ai-je besoin d'un LLM pour ajouter la recherche sémantique à mon produit SaaS ?
Pas nécessairement. La recherche sémantique de base nécessite un modèle d’intégration et un entrepôt vectoriel, et cela seul améliore considérablement la pertinence. Vous ajoutez un LLM complet lorsque vous souhaitez que le système génère des réponses écrites directes au-dessus des résultats, ce qui correspond au modèle de génération augmentée par récupération.
Quel est le coût de création d'un moteur de recherche sémantique ?
Les coûts se répartissent en trois catégories : intégration et inférence, stockage vectoriel et infrastructure de recherche, et temps d’ingénierie. Les petites installations fonctionnent avec des budgets modestes, mais le coût augmente avec la taille du corpus et le volume des requêtes, alors testez la charge sur des volumes réalistes et choisissez délibérément votre modèle d’intégration avant de vous engager.
Découvrez comment nous avons entraîné un réseau neuronal sur plus de 1,5 million de textes pour alimenter la recherche axée sur la pertinence au sein d'un SaaS de recrutement