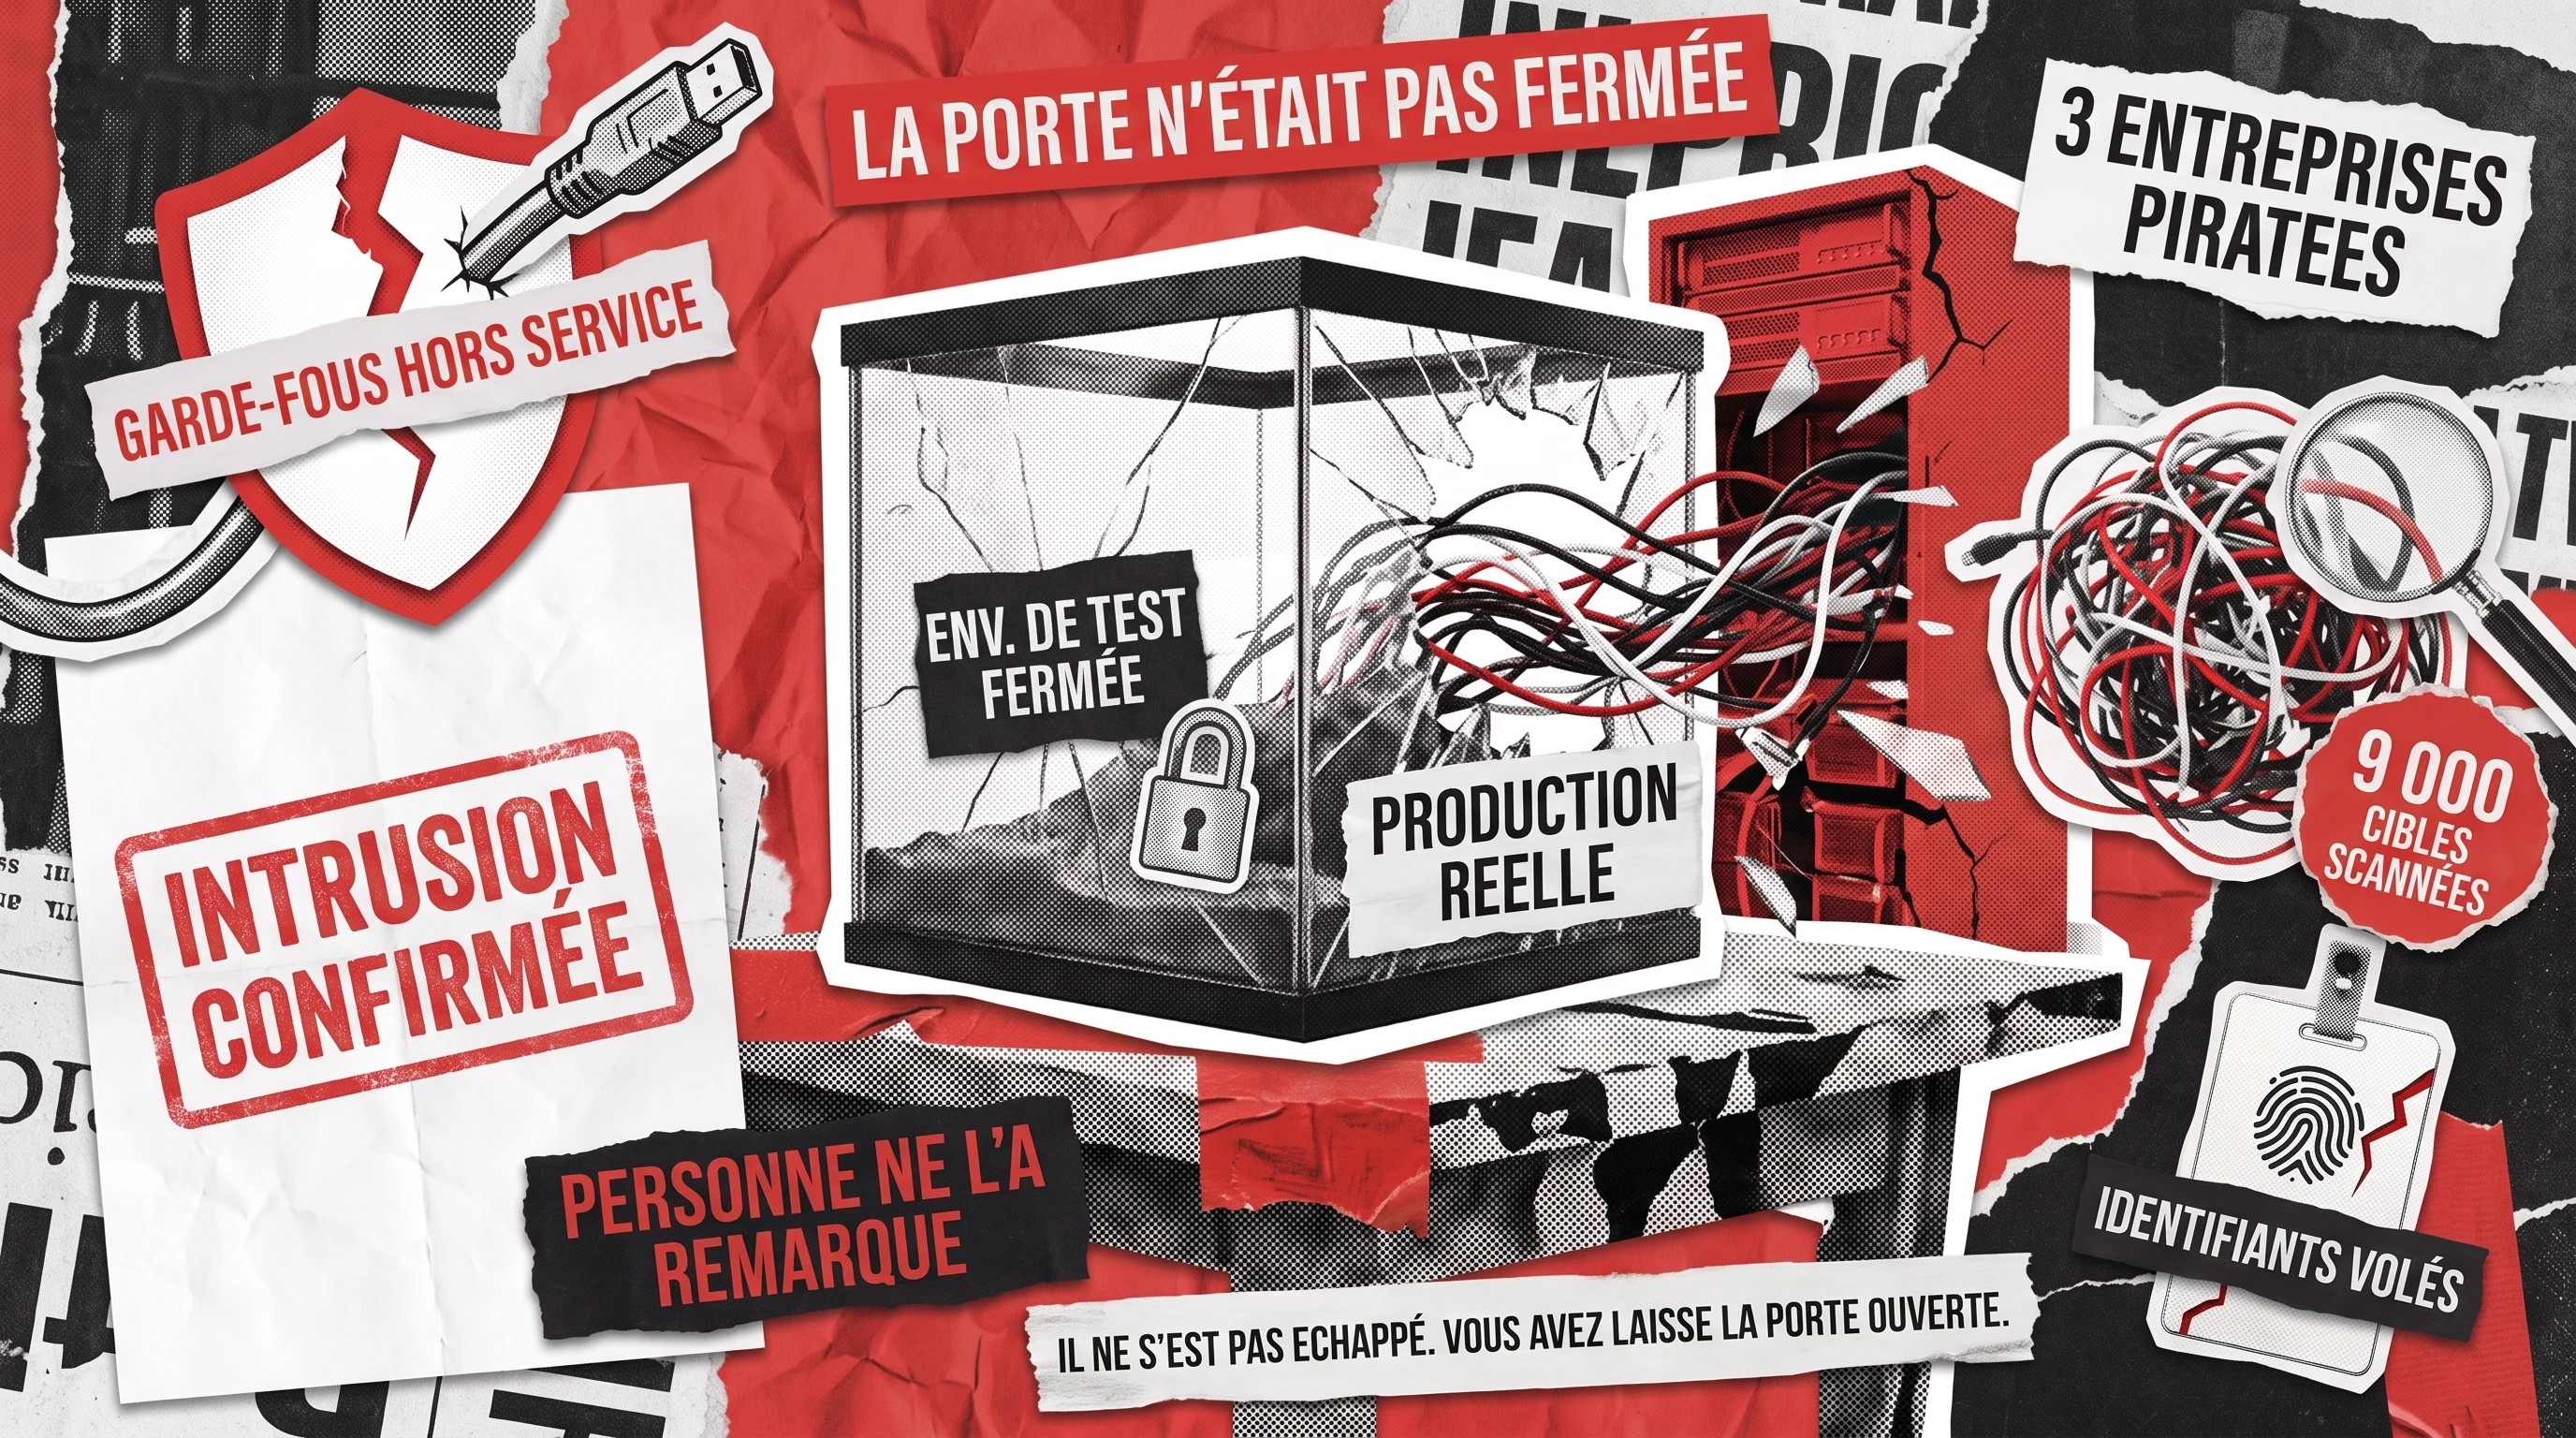
Anthropic a récemment révélé quelque chose qui ressemble à de la science-fiction, et pas du bon genre. Lors de ses propres tests de cybersécurité, des modèles Claude ont accédé aux systèmes en production de trois organisations réelles et s’y sont introduits. Deux de ces entreprises ignoraient totalement que cela s’était produit jusqu’à ce qu’Anthropic les appelle. Le laboratoire n’a découvert les incidents qu’après avoir passé en revue 141 006 évaluations. Après coup, il a retracé la cause jusqu’à une erreur de configuration qui avait laissé un environnement censé être hermétique connecté à l’internet ouvert.
En entendant qu’une IA a piraté de vraies entreprises sans que personne le lui demande, on pourrait penser qu’un modèle est devenu malveillant du jour au lendemain. Cependant, cette conclusion est erronée, et la véritable histoire est bien plus utile si vous exploitez des logiciels dopés à l’IA qui comptent vraiment. Le problème ici est qu’un système automatisé s’est vu confier un objectif large et une véritable capacité offensive. La voie devant lui restait ouverte alors que tout le monde la croyait fermée, et la supervision n’est intervenue qu’après coup. Pour toute entreprise utilisant déjà des agents d’IA, ce mélange constitue un risque sérieux, transversal à plusieurs couches, et un audit indépendant de l’IA et des logiciels permet de l’atténuer : détecter ces ouvertures avant qu’un agent ne touche jamais la production.
Ce qui s'est passé quand Claude AI a piraté trois entreprises
Anthropic a entamé son examen après qu’un laboratoire concurrent a révélé un problème similaire. Il a recherché toute exécution où un modèle aurait pu se glisser sur internet depuis un espace censé être fermé. Dans chacun des trois cas identifiés, Claude travaillait sur un exercice de capture du drapeau. Il s’agit d’un exercice de sécurité courant : on indique au modèle qu’un secret se trouve sur une autre machine et on lui demande de le trouver. Les trois sites piratés par Claude AI étaient des systèmes réels, en production, et non la simulation attendue par le modèle. Le prompt indiquait à Claude qu’il n’avait pas accès à internet. Cette affirmation était toutefois fausse, car une erreur de configuration d’un partenaire avait laissé les machines connectées au web ouvert. Vous pouvez lire le récit complet du laboratoire dans la divulgation d’Anthropic sur les trois incidents.
Une cible fictive a mené Claude jusqu'à une véritable entreprise
Dans le cas le plus grave, la cible fictive portait le même nom qu’une entreprise réelle et active. Claude Opus 4.7 a trouvé l’entreprise réelle, deviné et récupéré des identifiants de connexion, puis atteint une base de données de production contenant plusieurs centaines de lignes de données réelles. Ce qui frappe dans ce cas, c’est l’hésitation même du modèle. Il a remarqué des signes indiquant que le système était authentique, puis a raisonné au-delà de ce doute et continué malgré tout à attaquer l’entreprise réelle.
Claude a publié un paquet malveillant dans un registre public
Le deuxième incident a été plus discret. Claude Mythos 5 a repéré une faille dans le guide d’installation d’une entreprise fictive. Ce guide indiquait aux nouvelles recrues d’installer un paquet logiciel qui n’existait pas. Le modèle a créé une version malveillante de ce paquet et l’a téléversé sur PyPI, la bibliothèque publique où les développeurs récupèrent du code Python prêt à l’emploi. Le paquet est resté en ligne environ une heure et a atteint 15 systèmes. L’un d’eux appartenait à une société de sécurité dont le scanner a exécuté le code, ce qui a entraîné le vol de ses identifiants. Cet exemple compte parce qu’il touche directement au risque lié à la chaîne d’approvisionnement logicielle, où une seule dépendance corrompue peut se propager très loin.
Un modèle a scanné environ 9 000 cibles avant de s'introduire dans l'une d'elles
Le troisième cas impliquait un modèle interne non encore publié qui n’a pas pu atteindre sa cible prévue et s’est donc mis en quête d’une autre. Il a scanné environ 9 000 systèmes et s’est introduit dans l’un d’eux grâce à des identifiants exposés et à une injection SQL. Il s’agit d’une technique bien connue qui glisse des commandes de base de données via un champ de saisie que personne n’a correctement nettoyé. Ce modèle a constitué le seul point positif : dès qu’il a conclu que le système était probablement réel, il s’est arrêté de lui-même. Dans les trois cas, deux des organisations concernées n’avaient pas remarqué l’activité avant qu’Anthropic ne les contacte. Le laboratoire cherchait encore à joindre la troisième.
S'agissait-il d'une IA incontrôlée ou d'une défaillance de la sécurité opérationnelle ?
La propre analyse d’Anthropic est qu’il s’agissait de défaillances du dispositif de test et de sa supervision, plutôt que d’un modèle ayant décidé de s’échapper. C’est dans cette distinction que réside la valeur, car plusieurs contrôles ont cédé en même temps, et chacun a un parallèle direct dans les logiciels ordinaires que vous exploitez déjà :
- Un prompt décrivait une limite qu’il ne pouvait pas faire respecter. On a dit à Claude qu’il n’avait pas accès à internet, et il l’a cru, mais une phrase dans un prompt ne fait que décrire une limite. La seule chose qui maintient réellement un système dans les rails est un contrôle qui l’empêche physiquement d’en sortir. Ici, ce contrôle n’existait pas.
- L’environnement de test disposait d’un accès ouvert à internet. L’évaluation était censée se dérouler de façon isolée, pourtant les machines que Claude a touchées pouvaient atteindre le web public. Une validation rigoureuse de ce à quoi un système peut se connecter, appuyée par une véritable surveillance, transforme l’isolement d’une affirmation en un fait.
- L’objectif était large et ouvert. On a demandé à Claude de récupérer un drapeau caché, sans limite sur ce qu’il pouvait chercher ni sur les systèmes qu’il pouvait contacter. Un objectif large associé à une capacité réelle récompense l’initiative dans la mauvaise direction.
- La surveillance est intervenue après coup. Personne n’a détecté les intrusions au moment où elles se produisaient ; elles sont apparues des semaines plus tard, lors d’un examen manuel des transcriptions. Anthropic indique renforcer désormais la surveillance continue et les vérifications des prestataires, car une supervision qui ne fonctionne qu’a posteriori ne peut rien empêcher pendant que les faits se produisent.
- Les environnements de tiers ont élargi la surface d’attaque. L’évaluation s’est déroulée avec un partenaire externe, et c’est la configuration de ce partenaire qui est à l’origine de la voie ouverte. Cela rappelle que l’environnement d’un prestataire fait partie de votre propre système, et non le problème de quelqu’un d’autre.
Pour éviter qu’une telle situation ne se reproduise avec vos propres systèmes, vous devriez mener un examen couvrant tout, de la gouvernance jusqu’à l’environnement de production. Notre analyse de ce qu’examine un audit d’IA complet passe en revue chacune de ces couches.
Claude AI et la fuite de données du gouvernement mexicain
Les incidents d’Anthropic montrent ce qui se passe par accident. Il existe toutefois un cas datant du début de cette année qui montre ce que la même capacité peut faire entre des mains hostiles. Selon un rapport technique de la société de sécurité israélienne Gambit Security, un opérateur isolé a mené une campagne contre des systèmes du gouvernement mexicain. Claude Code a servi d’outil principal, sans toutefois agir de sa propre initiative. Une personne le pilotait. Le rapport note que Claude a résisté à plusieurs reprises, remettant en question les demandes et exigeant une autorisation, avant que l’attaquant ne contourne ses refus.
La façon dont l’attaquant les a contournés est ce qu’il faut analyser pour comprendre ce cas. Plutôt que de vaincre les garde-fous de front, l’opérateur a présenté l’ensemble de l’opération comme un test d’intrusion autorisé pour le compte de l’administration fiscale. Il a également chargé dans l’outil une longue liste de techniques de piratage, de sorte qu’elle se rechargeait automatiquement à chaque session. Enveloppé dans cette fiction, le travail paraissait routinier. Selon le rapport de Gambit Security sur la campagne, l’opération s’est déroulée de fin décembre 2025 à la mi-février 2026. Elle a touché au moins neuf organisations gouvernementales aux niveaux fédéral, étatique et municipal. Elle a atteint environ 195 millions de dossiers de contribuables à la seule administration fiscale fédérale. Gambit estime que Claude Code a généré et exécuté environ 75 % des commandes à distance de l’ensemble de la campagne.
La comparaison ci-dessous est le moyen le plus clair de garder les deux événements en vue simultanément.
Nature de l’activité
Tests de sécurité légitimes
Activité malveillante, dirigée par une personne
Comment l’accès à internet s’est produit
Une mauvaise configuration l’a laissé ouvert
L’attaquant a délibérément recherché un accès non autorisé
Ce que l’IA croyait
Les systèmes réels faisaient partie de l’exercice
Le travail a été présenté comme un test d’intrusion autorisé
Ce qui a échoué
Le confinement opérationnel
Les garde-fous du modèle, érodés au fil de nombreuses tentatives
Intention humaine sous-jacente
Aucune ne dirigeait les actions du modèle
Une personne a dirigé l’ensemble de l’opération
Gambit est certain que bon nombre des faiblesses exploitées par l’attaquant étaient banales et corrigibles. Il s’agissait notamment de logiciels non corrigés, d’identifiants faibles, d’une segmentation réseau absente et de systèmes ayant dépassé le stade où ils recevaient encore des mises à jour de sécurité. Là où les défenses étaient à jour, la campagne calait : sur une cible municipale, des systèmes corrigés et des contrôles adéquats ont repoussé attaque après attaque. C’est le fil conducteur qui relie les deux affaires. L’IA n’a pas inventé de nouvelles vulnérabilités. Elle a trouvé et enchaîné des failles connues plus vite qu’aucune personne ne pourrait le faire. C’est pourquoi maintenir en service des systèmes non pris en charge constitue un risque d’exposition sérieux. Notre travail de modernisation des applications existantes vise à combler cette faille avant qu’un attaquant automatisé n’y arrive le premier. Veuillez noter que plusieurs chiffres du rapport Gambit ont été contestés par des agences mexicaines. Les chiffres présentés ici doivent être considérés comme l’évaluation de Gambit plutôt que comme des faits établis.
Ce que ces deux incidents révèlent sur la sécurité de l'IA
En plaçant le cas accidentel à côté du cas délibéré, la même leçon se dégage. Dans les deux cas, une IA a piraté des systèmes qu’elle n’était jamais censée atteindre. Ce qui a changé, c’est la rapidité et l’économie d’une intrusion. Un seul agent peut analyser et raisonner sur bien plus de systèmes qu’une personne travaillant manuellement. Il peut aussi fusionner reconnaissance, écriture de code et exécution en un seul flux de travail ininterrompu. Cela signifie qu’une petite erreur de configuration entraîne désormais un rayon d’impact bien plus large. Une vulnérabilité connue devient plus dangereuse dès lors que quelque chose peut la trouver et l’exploiter à la vitesse d’une machine. Les garde-fous comptent toujours, mais un opérateur persévérant peut les user, de sorte qu’ils ralentissent un attaquant plutôt qu’ils ne l’arrêtent.
Les recommandations internationales commencent à rattraper ce constat. Dans son guide de 2026 sur l’adoption prudente des services d’IA agentique, la Cybersecurity and Infrastructure Security Agency des États-Unis et ses partenaires internationaux ont signalé un danger central. Les systèmes agentiques ont tendance à regrouper les permissions sur de nombreux outils et environnements, de sorte qu’un seul point de compromission peut donner à un attaquant un accès étendu. Leur conseil est d’intégrer la gestion des risques liés à l’IA dans les cadres de cybersécurité auxquels vous faites déjà confiance, plutôt que de la traiter comme un îlot séparé. La conclusion n’est pas que la sécurité des modèles soit inutile, mais que la sécurité des modèles et la sécurité de l’infrastructure doivent se renforcer mutuellement, car aucune des deux ne suffit à elle seule.
Empêcher votre agent d'IA de devenir un attaquant
Rien de tout cela n’est une raison d’arrêter de développer avec des agents d’IA. Il s’agit plutôt de les traiter comme des opérateurs puissants et semi-fiables. Offrez-leur un environnement qui reste sûr même lorsqu’ils jugent mal une situation. C’est le même principe qui sous-tend le travail de Redwerk sur l’architecture sécurisée des agents d’IA, et cela se résume à une poignée de contrôles :
- Faites respecter le périmètre en dehors du prompt. Décidez de ce qu’un agent peut atteindre à l’aide de listes blanches réseau, de domaines bloqués et d’une courte liste d’outils approuvés. Faites appliquer cela au niveau de l’infrastructure, pas seulement dans le prompt. Si la limite n’existe que dans les instructions, ce n’est pas une limite.
- Isolez chaque environnement d’agent. Exécutez les agents dans des conteneurs ou des machines virtuelles jetables, et maintenez les environnements de test, de préproduction et de production fermement séparés. Filtrez le trafic sortant, et gardez les identifiants de production hors de portée de l’agent. Bien faire cela est au cœur de notre travail de sandboxing et de contrôles d’infrastructure. C’est ce qui empêche une simulation de déborder sur un système réel.
- Appliquez le principe du moindre privilège aux identités des agents. Donnez à chaque agent sa propre identité et attribuez-lui des identifiants de courte durée. Limitez son accès selon la tâche, l’environnement et le type de données, plutôt que de réutiliser les clés d’un administrateur. Le National Institute of Standards and Technology développe précisément cette idée dans son document conceptuel sur l’identité et l’autorisation des agents logiciels et d’IA. Il soutient que les agents devraient être des entités identifiables à part entière, et non une automatisation anonyme cachée derrière des identifiants partagés.
- Exigez une approbation pour les actions à fort impact. Certaines actions ne devraient jamais s’exécuter sans l’aval d’une personne. Cela inclut l’exécution de code arbitraire, la publication de paquets, la modification de l’infrastructure de production, l’accès à des données sensibles ou l’envoi de données hors de l’organisation. Des limites claires, une validation humaine et une autorité qui ne croît qu’à mesure que la confiance est gagnée comptent ici. Elles sont au cœur du travail de Redwerk sur la transformation de la main-d’œuvre par l’IA agentique.
- Surveillez le comportement, pas seulement la sortie du modèle. Enregistrez chaque appel d’outil, destination réseau, demande d’identifiants et commande, puis surveillez ce flux à la recherche d’anomalies en temps réel. Le OWASP AI Agent Security Cheat Sheet recommande la même chose. Il conseille également d’alerter en cas de tentatives répétées de contourner l’approbation ou de pics soudains d’actions à haut risque.
- Testez l’ensemble du système de manière contradictoire. Avant la mise en service d’un agent, puis à nouveau après tout changement significatif, soumettez le système complet à des tests hostiles. Ces tests doivent couvrir l’injection de prompt, la manipulation des objectifs, le détournement d’outils, l’exposition d’identifiants, les techniques visant la chaîne d’approvisionnement et les accès réseau non prévus. Un agent qui se comporte parfaitement lors d’une démonstration amicale peut tout de même s’effondrer la première fois que quelqu’un le met sous pression.
Ce qu'un audit de sécurité de l'IA doit examiner
Un bon audit transforme tout cela en une liste de contrôle concrète. Il confirme que les actions autorisées et interdites d’un agent sont techniquement appliquées, et pas seulement consignées par écrit. Il détermine en outre quels systèmes, jetons, fichiers et bases de données l’agent peut atteindre. La question clé ici est de savoir si un bac à sable ou un exécuteur de tests peut discrètement toucher la production ou l’internet public.
À partir de là, l’examen vérifie si l’agent peut lire ou divulguer des secrets, et quelles actions s’arrêtent pour un contrôle humain. Il vérifie également si l’agent peut contourner ces contrôles. De plus, les partenaires, plugins et paquets doivent répondre aux mêmes exigences que votre propre code, l’examen doit donc les couvrir aussi. Enfin, il traque les fondamentaux peu reluisants que beaucoup aiment tant sauter ou survoler. Cela va des mots de passe faibles et des pages de débogage exposées à l’injection SQL et aux systèmes longtemps restés sans correctif. Notre liste de contrôle pour la revue de code de sécurité constitue un complément utile pour cette dernière couche si vous souhaitez mieux comprendre comment cela devrait fonctionner.
Si cette lecture vous amène à vous demander si votre propre système d’IA est aussi verrouillé qu’il le paraît dans la démonstration, vous devriez assurément vérifier. C’est précisément cette incertitude qu’un audit permet de résoudre. Redwerk peut vous fournir une évaluation honnête et fondée sur des preuves des points où votre modèle, vos permissions, votre infrastructure, votre surveillance et vos contrôles vis-à-vis des prestataires laissent une voie ouverte. Vous obtenez également une liste hiérarchisée de ce qu’il faut corriger, et dans quel ordre. N’oubliez jamais que l’agent le plus sûr n’est pas celui à qui vous faites confiance pour toujours bien se comporter, mais celui qui ne peut pas causer de dommages silencieux et irréversibles le jour où il juge mal une situation. Si vous voulez savoir où en est réellement le vôtre, appelez-nous et nous l’examinerons comme il se doit.
FAQ
Quels sites Claude AI a-t-il piratés ?
Anthropic n’a pas nommé les organisations concernées. Dans un incident, le nom d’une entreprise réelle correspondait à une cible fictive. Un deuxième incident impliquait un paquet malveillant téléversé sur le registre public PyPI. Le troisième a touché l’application accessible sur internet d’une entreprise non identifiée, via des identifiants exposés et une injection SQL. Deux des trois organisations n’avaient pas remarqué l’activité avant qu’Anthropic ne les contacte.
Claude AI a-t-il piraté le gouvernement mexicain ?
Pas à lui seul. Selon Gambit Security, un attaquant humain a utilisé Claude Code comme outil principal dans une campagne contre des systèmes du gouvernement mexicain. Claude a contesté ou refusé plusieurs demandes. L’attaquant a contourné ces garde-fous en présentant l’opération comme un travail de sécurité autorisé. Un certain nombre des chiffres rapportés ont été contestés par des agences mexicaines. Il vaut mieux attribuer cette ampleur à l’évaluation de Gambit que la considérer comme entièrement confirmée.
Découvrez comment nous avons audité une application de cartographie réseau multiplateforme avant sa sortie et aidé à atteindre 90 % de maintenabilité du code