Faire passer les données d’une entreprise d’un ancien système vers un nouveau ressemble, sur le plan de projet, à une tâche de plomberie, une ligne budgétaire proche de la fin. C’est pourtant généralement cette ligne qui détermine si l’ensemble du lancement se déroule dans les temps ou prend un trimestre de retard. Les meilleures pratiques de migration de données présentées dans ce guide existent pour garder cette décision du bon côté, car la plupart des migrations de données en entreprise manquent encore leurs objectifs de budget ou de calendrier, souvent parce que personne n’avait une visibilité complète sur les données source avant le début du transfert.
Le sens du mouvement n’est d’ailleurs plus uniquement vers le cloud. L’enquête State of the Cloud 2025 de Flexera a révélé que 21 % des charges de travail d’entreprise ont déjà été rapatriées hors du cloud public pour des raisons de coût et de performance, si bien que les équipes mènent désormais des migrations dans les deux sens, et chaque transfert supplémentaire est une nouvelle occasion de se tromper.
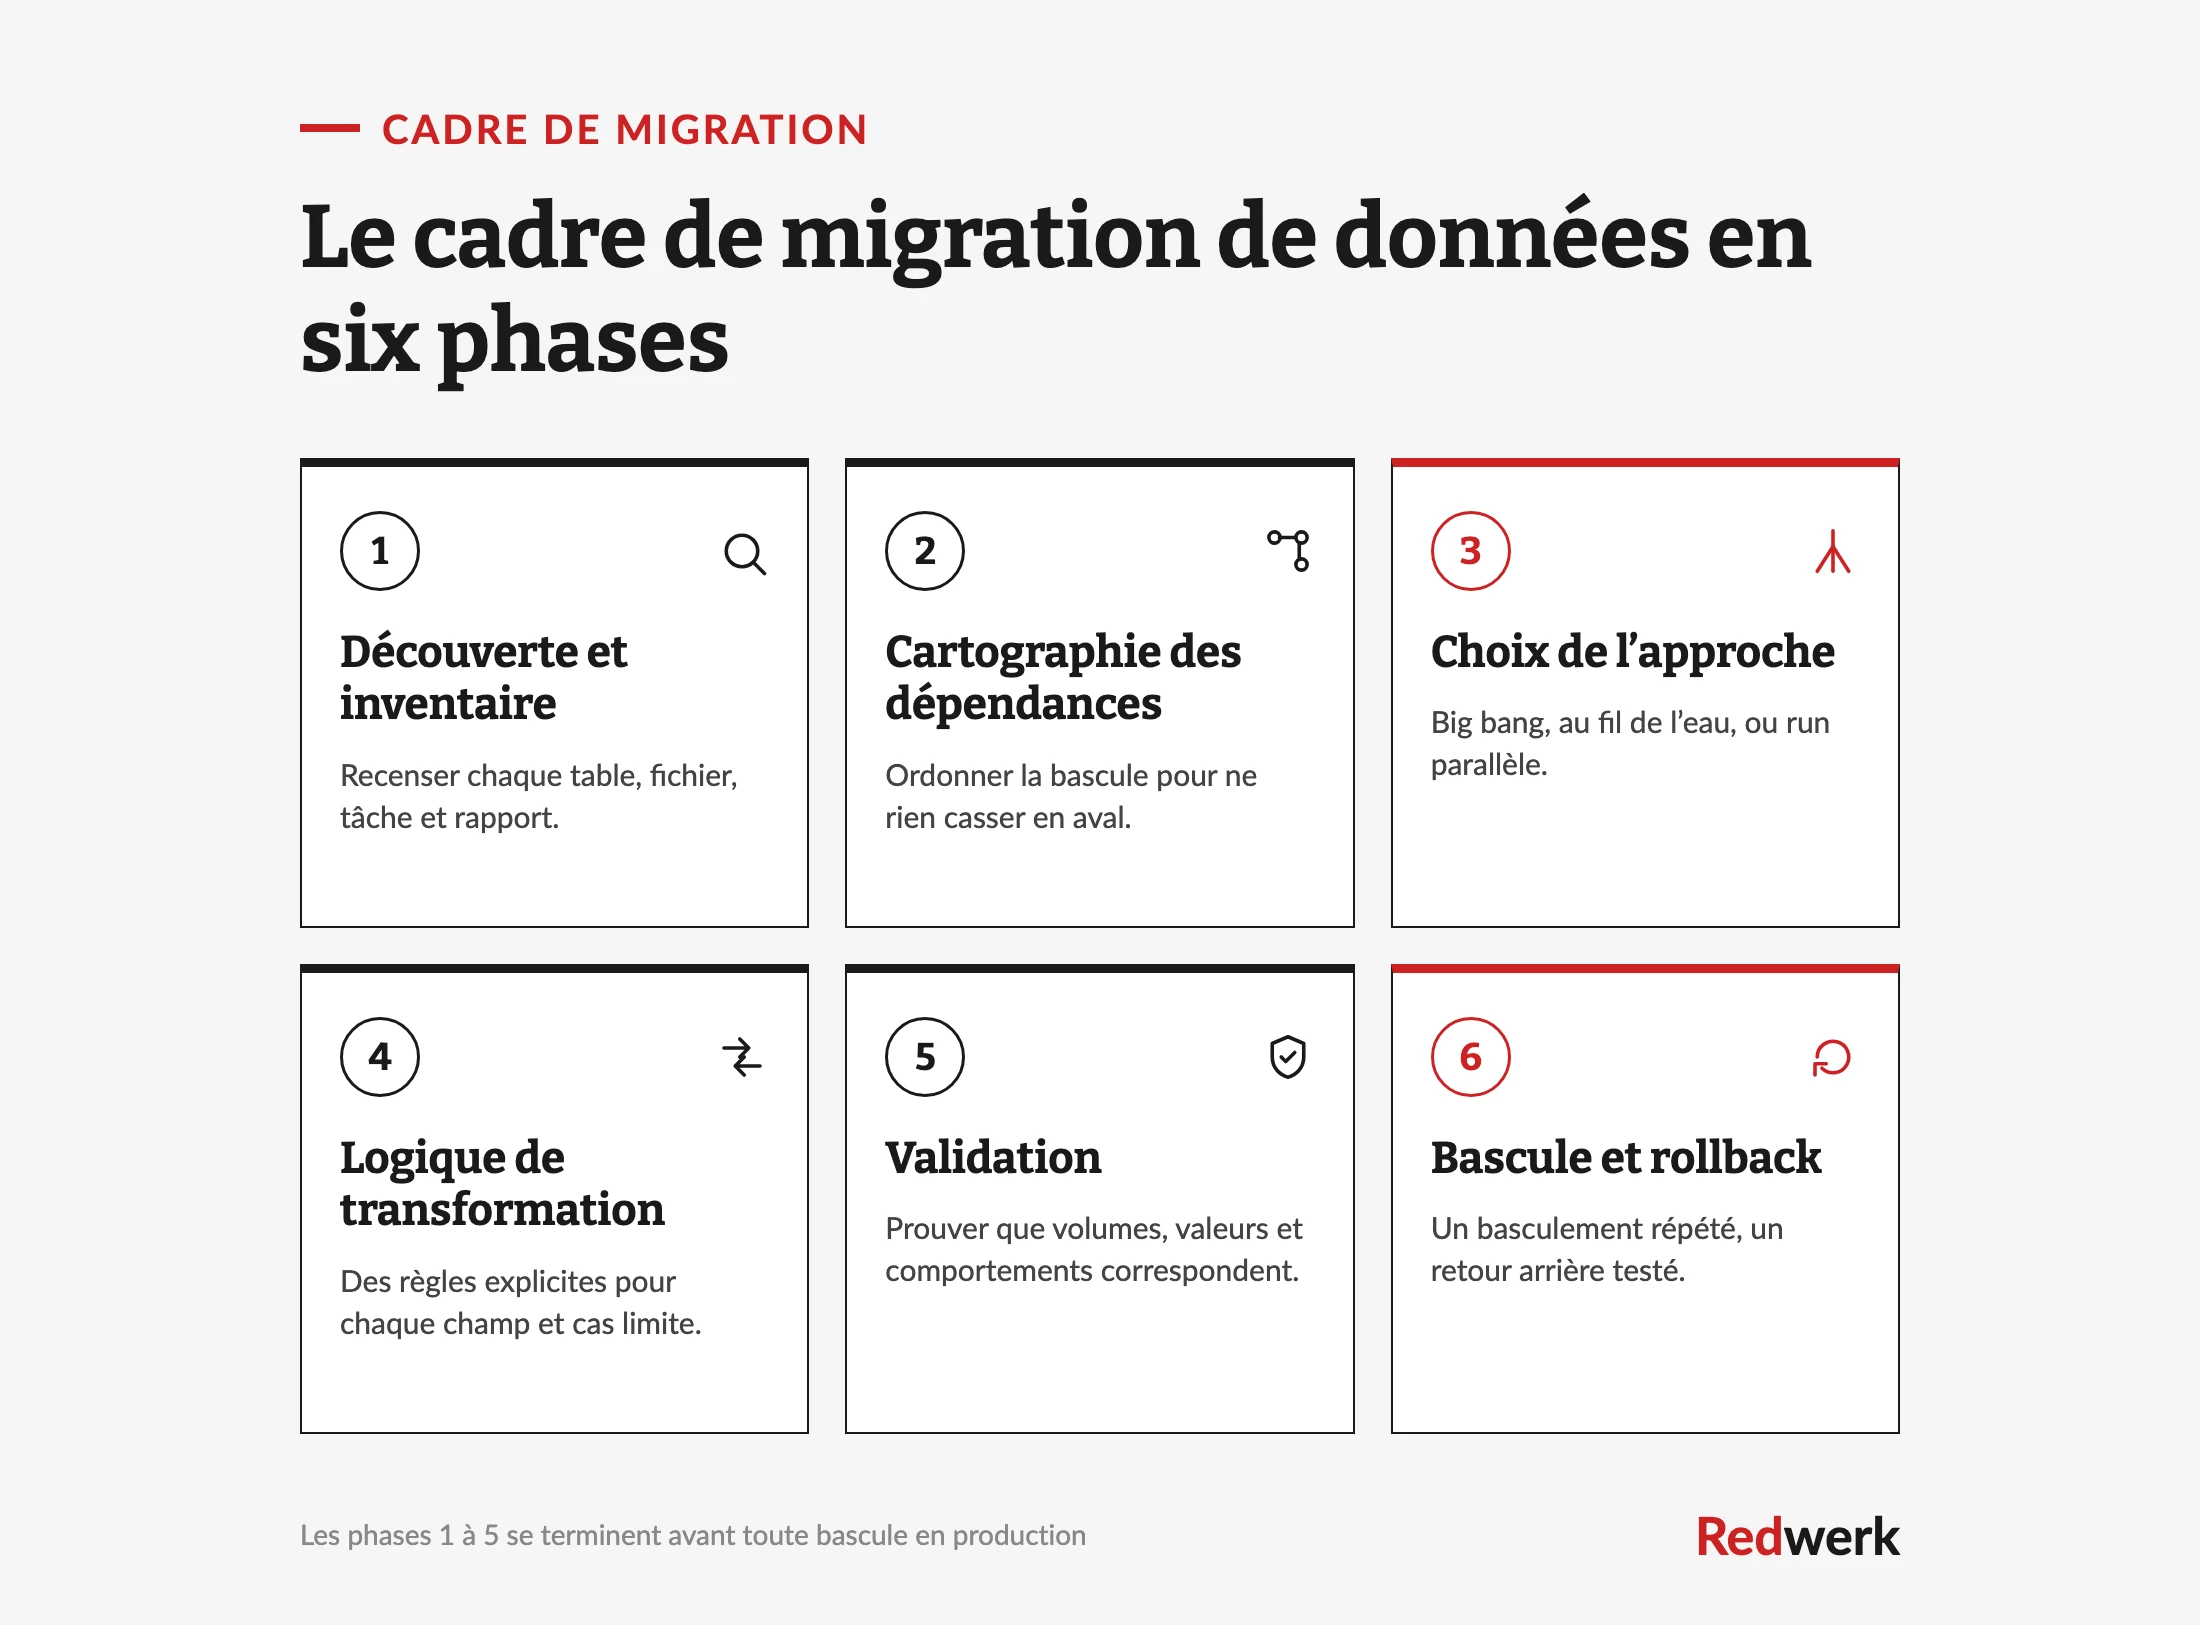
Organisé en six phases, du premier inventaire jusqu’à la bascule finale, ce plan d’action repose sur une seule idée. La version courte pour migrer des données en toute sécurité est la suivante : ne jamais déplacer des données que vous n’avez pas déjà inventoriées, cartographiées, et dont vous n’avez pas convenu de la méthode de validation. Chacune des phases ci-dessous élimine une catégorie de mauvaise surprise coûteuse avant qu’elle n’atteigne la production.
Les meilleures pratiques de migration de données commencent là où la plupart des migrations échouent
La plupart des migrations échouent bien avant le jour du basculement, à cause d’hypothèses que personne n’a jamais couchées par écrit. La cause racine la plus courante est un système source que plus personne ne comprend vraiment, des champs non documentés, des solutions de contournement ajoutées au fil des années par des équipes régionales, et des règles métier qui n’existent que dans la tête d’une seule personne. Une enquête de janvier 2026 menée auprès de responsables des données et de l’analytique a révélé que 88 % pensaient que leurs données étaient prêtes pour l’IA et l’analytique, alors que 43 % admettaient par ailleurs que la préparation des données était leur principal obstacle, exactement le genre d’angle mort qui transforme une migration de données legacy de routine en un exercice forensique de plusieurs mois.
La migration de données legacy est difficile précisément parce que le modèle de données sur le papier ne correspond plus aux données en production depuis des années. Un seul champ de référence peut finir par contenir des dizaines de valeurs réelles alors que la documentation n’en liste qu’une poignée, le reste ayant été ajouté discrètement au fil du temps par quiconque avait besoin d’une exception. On ne peut pas cartographier ce qu’on n’a pas découvert, et on ne peut pas découvrir un savoir tribal à partir d’un simple export de schéma, c’est pourquoi un audit logiciel approfondi du système source, réalisé avant tout transfert de données, transforme ces inconnues en un périmètre écrit.
Phase 1. Découverte et inventaire
On ne peut pas migrer ce qu’on n’a pas compté. La phase un produit un inventaire complet de ce qui existe réellement : chaque table, chaque espace de stockage de fichiers, chaque intégration, chaque tâche planifiée et chaque rapport qui touche aux données. Profilez les valeurs réelles plutôt que de faire confiance au schéma, afin de recueillir le nombre de lignes, les taux de valeurs nulles, les valeurs distinctes, les plages de dates et les encodages de caractères.
C’est là que l’on découvre les 73 types de clients, la colonne de texte libre que quelqu’un utilise comme indicateur de statut, et les deux tables qui semblent identiques mais divergent discrètement. Transformez cet inventaire en une check-list de migration de données écrite qui nomme chaque objet, son propriétaire, son nombre d’enregistrements, sa destination dans le nouveau système, et s’il est transféré, transformé ou mis au rebut. Une phase de découverte dédiée est l’assurance la moins chère de tout le projet : quelques semaines de profilage structuré permettent généralement d’éviter des mois de gestion de crise en production par la suite.
Phase 2. Cartographie des dépendances
Les données ne vivent jamais seules. Chaque table a des producteurs en amont et des consommateurs en aval, les rapports, les API, les tâches de facturation et les autres systèmes qui la lisent selon un calendrier. La phase deux cartographie ces dépendances afin que vous puissiez migrer dans un ordre qui ne laisse jamais un consommateur actif pointer vers des données déjà déplacées ou dont la structure a changé.
La cartographie des dépendances est ce qui distingue un transfert propre d’une cascade de pannes. Si les factures dépendent des clients, et que les clients dépendent d’une table de référence de région fiscale, alors cette table de référence est migrée et vérifiée en premier, et tout ce qui en dépend en aval suit dans l’ordre. Dans un programme plus large de transformation numérique, cette même carte indique quels sous-systèmes peuvent être déplacés lors d’une première vague et lesquels doivent attendre. Sauter cette phase produit le symptôme classique : le nouveau système réussit tous les tests en isolation et tombe en panne dès qu’une intégration réelle le sollicite.
Phase 3. Big bang, trickle ou exécution en parallèle
Votre stratégie de migration de données se résume à une seule décision : quelle quantité de données est déplacée en une fois, et si les anciens et nouveaux systèmes fonctionnent ensemble pendant ce temps. Trois schémas couvrent presque tous les projets réels, et chacun échange du temps d’arrêt contre du risque et de la complexité. Choisissez délibérément, car changer d’approche à mi-parcours est coûteux et perturbateur.
Big bang
Une fenêtre planifiée
Jeux de données plus petits et bien compris qui tolèrent le temps d’arrêt
Tout le risque concentré dans un seul événement
Trickle (progressif)
Quasi nul, les systèmes se chevauchent
Jeux de données volumineux qui ne peuvent pas s’arrêter
Maintenir les deux systèmes synchronisés pendant le chevauchement
Exécution en parallèle
Quasi nul, les deux fonctionnent en direct
Données critiques ou réglementées
Le double des coûts et de l’infrastructure
Big Bang
Le big bang déplace tout dans une seule fenêtre planifiée, généralement un week-end, puis bascule tous les utilisateurs vers le nouveau système en une seule fois. C’est l’approche la plus simple à planifier et la moins coûteuse à exploiter ensuite, car un seul système est maintenu au lieu de deux. La contrepartie est un risque concentré, car si la validation échoue tard le dimanche, il faut soit corriger en direct, soit déclencher le retour arrière, et chaque utilisateur ressent la coupure. Le big bang convient aux jeux de données plus petits et bien compris, ainsi qu’aux organisations capables d’absorber une fenêtre d’indisponibilité définie.
Trickle
La migration trickle, parfois appelée progressive ou incrémentale, déplace les données par lots sur des jours ou des semaines pendant que les deux systèmes restent actifs. Le risque est réparti, car chaque lot est assez petit pour être validé et, si nécessaire, refait, et il n’y a pas de week-end unique à haut risque. Le prix à payer est la complexité, puisqu’il faut garder l’ancien et le nouveau système synchronisés pendant le chevauchement, ce qui implique une capture des modifications de données (change-data-capture) ou une couche de synchronisation, ainsi qu’une règle claire pour les enregistrements modifiés en cours de transfert. Le trickle convient aux grands jeux de données et aux systèmes qui ne peuvent pas se permettre un temps d’arrêt significatif.
Exécution en parallèle
L’exécution en parallèle maintient les deux systèmes pleinement opérationnels et traite les mêmes transactions côte à côte, ce qui permet de comparer leurs résultats avant de faire confiance au nouveau. C’est le moyen le plus sûr de prouver l’exactitude sur des données à enjeux élevés telles que la finance, la santé ou les données réglementées, car vous observez les deux systèmes s’accorder sur des charges de travail réelles avant de mettre l’ancien à la retraite. C’est aussi le plus coûteux, puisqu’il nécessite le double de l’infrastructure, une alimentation fiable vers les deux systèmes, et une règle explicite sur quel système fait autorité pendant le chevauchement.
Phase 4. Conception de la logique de transformation
Les données ne s’adaptent presque jamais sans modification au modèle du nouveau système. La phase quatre conçoit la logique de transformation, les règles explicites qui convertissent chaque champ source vers sa cible : conversions de types, normalisation des unités et des devises, déduplication, division ou fusion de champs, et valeurs par défaut raisonnables pour les données que l’ancien système n’a jamais capturées. Consignez ces règles par écrit et versionnez-les, car elles constituent la partie de la migration la plus susceptible de dissimuler une hypothèse erronée.
La partie difficile, ce sont les cas limites, et les données legacy sont surtout faites de cas limites. Que se passe-t-il pour un enregistrement comportant une valeur nulle dans un champ requis par le nouveau système, pour des dates stockées sous trois formats différents, ou pour ce customer_type comptant 73 valeurs alors que le nouveau modèle n’en autorise que 12 ? Chaque réponse est autant une décision métier qu’une décision technique, si bien que les règles doivent être revues par quelqu’un qui comprend la signification des données, pas seulement par les ingénieurs qui les déplacent. Construire cela sans spécification finalisée est normal, et Redwerk résout l’ambiguïté de façon collaborative au fur et à mesure qu’elle apparaît, plutôt que d’attendre un document d’exigences qui n’allait de toute façon jamais arriver complet.
Phase 5. Méthodologie de validation
Une migration n’est terminée que lorsque vous avez prouvé que les nouvelles données correspondent aux anciennes. La validation est la phase que les équipes suppriment en premier sous la pression des délais et regrettent en premier en production, alors concevez la méthodologie de validation avant de déplacer quoi que ce soit et définissez le succès comme une preuve plutôt que comme une absence de plaintes.
Validez à trois niveaux. Les comptages confirment que chaque table contient le nombre attendu d’enregistrements, les valeurs confirment que les totaux, les sommes de contrôle et les lignes échantillonnées se réconcilient entre la source et la cible, et le comportement confirme que les rapports, les soldes et les intégrations produisent les mêmes résultats sur les deux systèmes. Sur PageFreezer, une plateforme d’archivage que Redwerk a construite pour capturer et rejouer du contenu web et social à grande échelle, l’équipe a conçu des sommes de contrôle et une logique de basculement afin qu’aucune donnée collectée par les robots ne puisse être perdue ou altérée, le même réflexe qu’exige la validation en entreprise. Automatisez la réconciliation pour qu’elle s’exécute à nouveau après chaque lot et une fois de plus juste avant la bascule.
Phase 6. Bascule et retour arrière
La bascule (cutover) est le moment où les utilisateurs cessent de travailler dans l’ancien système et commencent à travailler dans le nouveau. Traitez-la comme une procédure répétée plutôt que comme un événement, avec un runbook écrit couvrant chaque étape, un responsable et une estimation de temps par étape, un gel des modifications sur la source pendant la synchronisation finale, et un point de contrôle go/no-go dont les critères de réussite découlent directement de la validation. Répétez le runbook sur une copie avant le vrai week-end, afin que l’équipe l’ait déjà fait une fois.
L’étape dans laquelle la plupart des équipes sous-investissent est le retour arrière (rollback). Avant de basculer, vous avez besoin d’une réponse testée à la question « que se passe-t-il si la validation échoue à deux heures du matin », un point défini où vous vous arrêtez, remettez l’ancien système en service et reprogrammez sans perdre les transactions effectuées pendant la tentative. Gardez l’ancien système récupérable jusqu’à ce que le nouveau ait fonctionné proprement en production pendant une période définie, et intégrez la bascule dans une feuille de route de transformation numérique plus large afin qu’elle intervienne quand l’entreprise peut l’absorber, plutôt que pendant un pic de charge ou une échéance de reporting.
Une plateforme de vote électronique du Parlement européen migrée par Redwerk depuis une pile JBoss vieillissante vers des versions modernes de Spring et Tomcat illustre ce résultat. Environ 30 000 lignes de code ont été transférées et le travail a été livré dans un délai d’un mois, car la bascule avait été planifiée, testée et réversible plutôt qu’improvisée.
La planification, facteur décisif
Dans chaque phase, le même schéma se répète : le travail qui détermine si un transfert réussit se déroule avant que la moindre donnée ne quitte la source. La découverte, la cartographie des dépendances, une approche délibérée, des règles de transformation documentées et un plan de validation et de retour arrière constituent le transfert lui-même, tout autant que la copie. Les équipes qui traitent la copie comme l’étape finale facile, parce que la réflexion difficile est déjà faite à ce stade, sont celles qui respectent leurs délais.
C’est aussi dans cette préparation qu’un partenaire expérimenté trouve sa place, moins en écrivant davantage de code qu’en ayant déjà vu quelles hypothèses s’effondrent et en insistant pour qu’elles soient testées tant qu’il est encore temps de les corriger. Si vous planifiez une migration d’entreprise et recherchez une équipe qui a modernisé des systèmes vieillissants dans des délais réels, contactez-nous pour mettre votre plan à l’épreuve avant que vos données ne deviennent un incident de production.
FAQ
Pourquoi les migrations de données échouent-elles ?
La plupart échouent parce que le système source est moins bien compris que l’équipe ne le suppose. Des champs non documentés, des solutions de contournement informelles et des dépendances cachées ne se révèlent que pendant le transfert, et le fait de sauter la validation laisse en plus passer une corruption silencieuse des données. L’échec remonte bien plus souvent à la préparation qu’à la copie technique elle-même.
Quelles sont les phases d'une migration de données ?
Un transfert fiable se déroule en six phases : découverte et inventaire, cartographie des dépendances, choix d’une approche, conception de la logique de transformation, validation, et bascule avec un plan de retour arrière. Les cinq premières se terminent toutes avant tout basculement en production, et l’ordre compte, car chaque phase élimine une catégorie de risque dont dépend la suivante.
Quelle est la différence entre la migration big bang et la migration trickle ?
Le big bang déplace toutes les données en une seule fenêtre planifiée et bascule tous les utilisateurs en une fois, ce qui concentre tout le risque dans un seul événement. Le trickle déplace les données par lots plus petits pendant que les deux systèmes restent actifs, répartissant le risque sur de nombreuses étapes vérifiables au prix du maintien de la synchronisation entre les deux systèmes. Le big bang convient aux jeux de données plus petits qui tolèrent le temps d’arrêt, tandis que le trickle convient aux grands systèmes qui ne peuvent pas s’arrêter.
Combien de temps dure une migration de données ?
Cela dépend bien davantage de la complexité que du volume brut. Un jeu de données propre et bien documenté peut être déplacé en un seul week-end, tandis qu’un système vieux de plusieurs décennies avec d’importants besoins de transformation et de validation peut prendre plusieurs mois, la majeure partie étant consacrée à la découverte et aux tests plutôt qu’au transfert lui-même. Un calendrier réaliste est dimensionné à partir de la phase de découverte, et non à partir d’une estimation faite avant que quiconque n’ait profilé les données.
Découvrez comment nos outils ERP personnalisés ont aidé Mass Movement à atteindre une croissance de revenus de 2,74 milliards de dollars