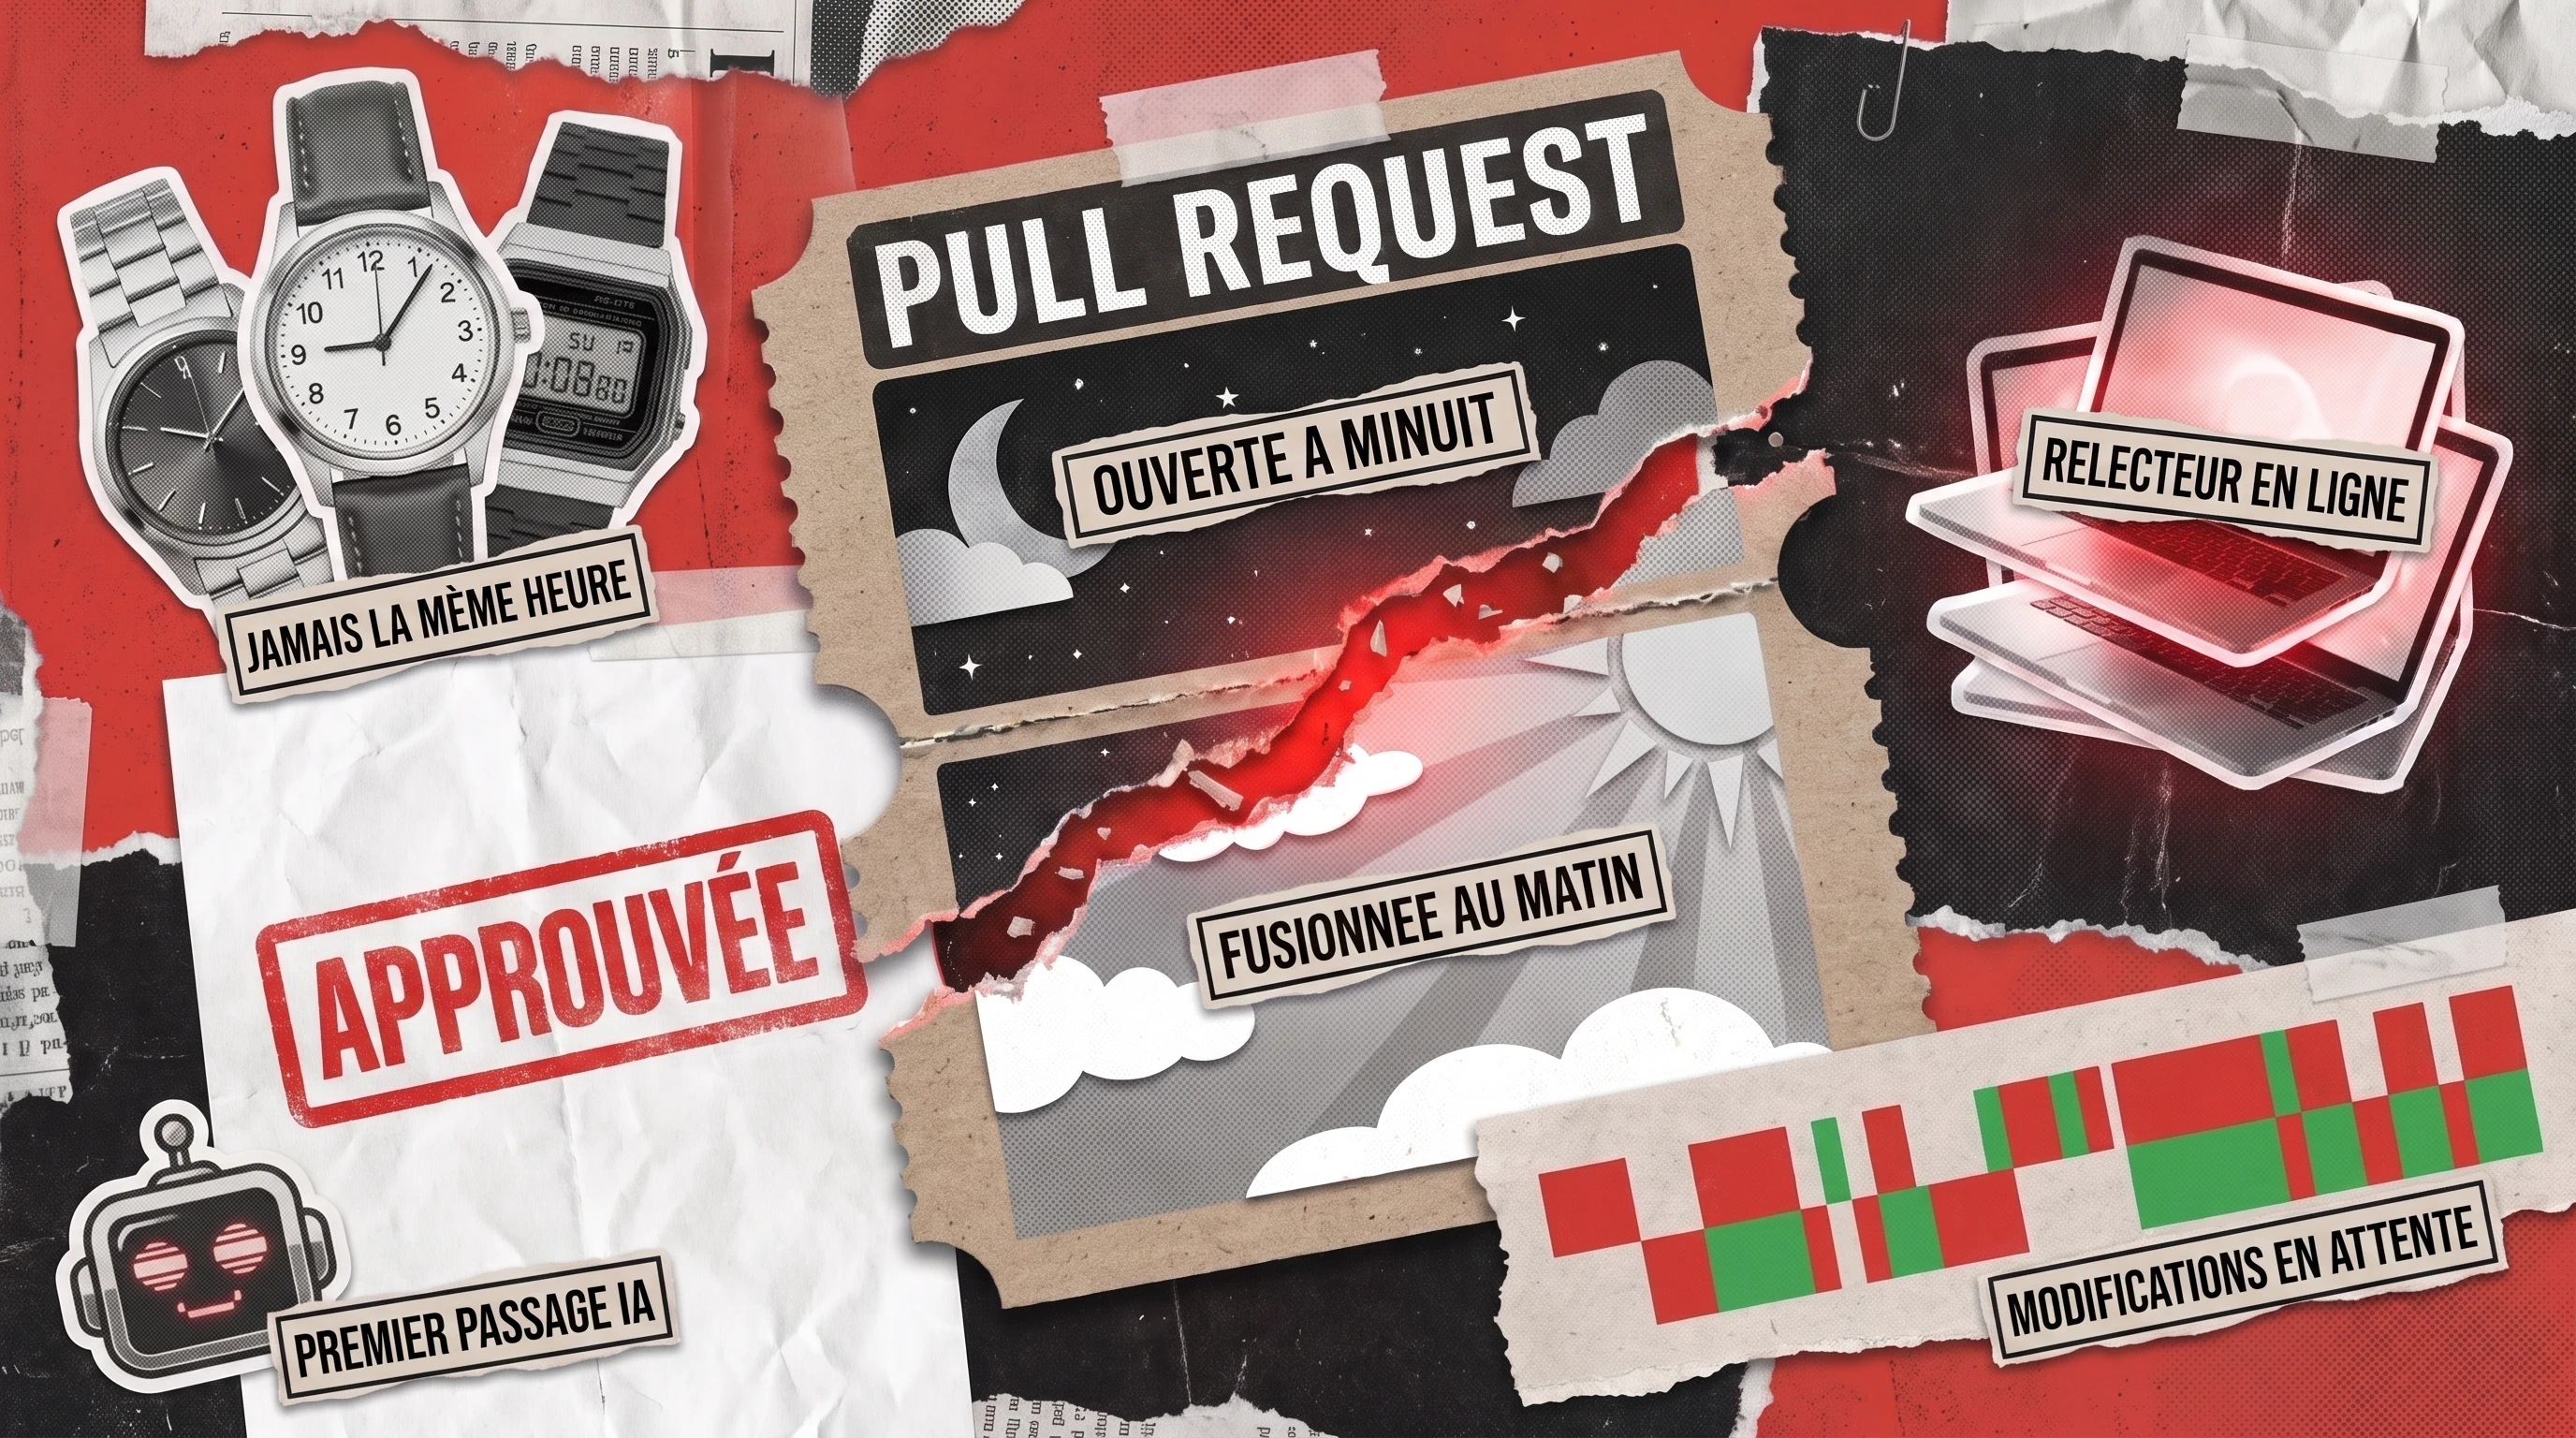
Votre équipe pousse du code depuis Lisbonne à 18h et il reste intact jusqu’à ce qu’Austin se connecte le lendemain matin. Pour une équipe d’ingénierie distribuée, la file d’attente de revue est l’endroit où la vélocité meurt en silence, et aucune vitesse de frappe ne compense une attente de huit heures pour un second regard.
Les meilleurs outils de revue de code pour les équipes distribuées réduisent cet écart nocturne en automatisant la première passe, en acheminant chaque pull request (PR) vers la personne éveillée, et en conservant tout le contexte à l’intérieur pour que personne n’attende une réunion pour approuver un changement.
Ce guide filtre six outils selon cinq critères qui comptent quand vos relecteurs ne partagent jamais une heure de travail, puis aborde le point où l’automatisation atteint ses limites et où des ingénieurs seniors qui connaissent déjà votre stack prennent le relais avec une profondeur de revue que l’automatisation ne peut pas atteindre.
Le filtre en cinq points : choisir les meilleurs outils de revue de code pour les équipes distribuées
Avant de comparer des produits, il faut s’accorder sur ce que " ;bon" ; signifie réellement pour une équipe asynchrone. Une configuration distribuée met discrètement en échec tout outil qui suppose que l’auteur et le relecteur partagent le même fuseau horaire, la même fenêtre de chat ou le même modèle mental de la base de code. Nous évaluons chaque candidat selon cinq critères, et le meilleur logiciel de revue de code réussit les cinq au lieu de l’emporter uniquement sur le nombre brut de fonctionnalités.
Les meilleurs outils de revue de code traitent ces cinq points comme des standards et non comme des options, de sorte qu’un relecteur qui se réveille à trois fuseaux horaires de distance peut agir sur une pull request sans avoir à solliciter l’auteur et attendre une journée entière la réponse. Chacun des six outils ci-dessous est évalué selon ces mêmes cinq critères, et non selon le nombre de fonctionnalités qu’il annonce.

Six outils de revue de code conçus pour les équipes distribuées
Aucun produit ne couvre à lui seul les cinq critères, c’est pourquoi la plupart des équipes distribuées en combinent deux ou trois. Chacun des six outils de revue de code ci-dessous résout une partie spécifique du problème de la revue continue, du triage par IA dès l’ouverture d’une PR aux fusions sécurisées pendant que l’auteur dort. Ils sont regroupés selon la tâche qu’ils accomplissent le mieux, sans classement du meilleur au moins bon, car le bon dosage dépend de votre stack et de l’endroit où se trouvent réellement vos ingénieurs.
CodeRabbit : une première passe par IA pour que les relecteurs se réveillent devant une PR déjà préparée
CodeRabbit exécute une revue automatisée dès l’ouverture d’une pull request, de sorte que le relecteur humain du fuseau horaire suivant part d’un résumé en langage clair et d’une liste des problèmes probables, plutôt que d’un mur froid de modifications de code brutes. Parmi les outils de revue de code par IA, il se distingue par ses commentaires ligne par ligne, un résumé des changements lisible, et la façon dont il apprend de la manière dont votre équipe traite les retours passés. Sa limite est celle que partage tout relecteur automatisé : il reconnaît des schémas sans saisir l’intention, il faut donc considérer son résultat comme un échauffement pour l’humain, pas comme un verdict final, un compromis que nous détaillons dans notre guide sur les revues de code assistées par IA. Choisissez CodeRabbit en premier lorsqu’une équipe a besoin d’un gain de qualité immédiat sans restructurer la façon dont les pull requests sont construites, car il s’intègre à un flux de travail GitHub ou GitLab existant en quelques minutes.
Graphite : PR empilées et routage des relecteurs entre régions
Graphite s’articule autour des pull requests empilées, de petites modifications dépendantes revues en séquence plutôt qu’une seule pull request gigantesque que personne ne veut ouvrir à 2h du matin. Pour les équipes distribuées, cela apporte deux éléments essentiels lorsque les relecteurs sont dispersés :
- Des PR plus petites qu’un relecteur peut traiter en une seule session, ce qui maintient la file d’attente nocturne courte.
- Une attribution automatique des relecteurs basée sur la propriété du code et la disponibilité, de sorte qu’une revue arrive à quelqu’un qui est réellement en ligne.
Le compromis est un changement de flux de travail. L’empilement demande de la discipline, et les équipes habituées à une branche par fonctionnalité ont généralement besoin de quelques semaines pour s’adapter avant que le bénéfice ne se fasse sentir. Privilégiez Graphite à une première passe uniquement par IA lorsque le véritable goulot d’étranglement est la taille des pull requests elle-même, car réduire chaque pull request diminue le temps de revue d’une façon qu’un commentaire automatisé sur un changement gigantesque ne pourra jamais égaler.
LinearB : SLA de revue codifiés et workflow-as-code
LinearB transforme le processus de revue en une politique que l’équipe configure une fois et qui s’applique ensuite automatiquement. Il attribue les relecteurs selon le codeowner et la disponibilité, signale toute pull request qui dépasse un SLA convenu, et fait remonter celles qui stagnent vers un relecteur de secours ou un canal Slack avant qu’elles ne bloquent une mise en production, de sorte que le processus se déroule de façon identique, que l’auteur soit à Londres ou à Sydney. Ce SLA codifié est précisément l’intérêt pour les équipes distribuées, puisque rien ne dépend d’un relecteur qui se souvient de la convention ou d’un manager qui traque le statut à la main. LinearB se démarque des autres outils présentés ici lorsque le véritable mode de défaillance est une pull request qui stagne sans que personne n’en soit responsable, et son tableau de bord de métriques de livraison donne à un manager une visibilité précise sur l’endroit où cette stagnation se produit dans chaque région.
Gerrit : asynchrone par conception, toujours la référence pour la revue basée sur les changements
Gerrit précède la vague actuelle et reste la référence pour la revue asynchrone basée sur les changements. Il examine des commits individuels, pas des branches entières, suit chaque révision d’un changement, et impose une notation avant une fusion, un modèle qui suppose que les relecteurs agissent entièrement selon leur propre emploi du temps. Parmi les outils de revue de code open source, c’est le plus éprouvé pour les grandes organisations d’ingénierie distribuées, Android et Chromium étant construits dessus depuis des années. Le prix à payer se situe au niveau de la mise en place et de l’interface, car Gerrit est puissant et résolument utilitaire, il faut donc prévoir une courbe d’apprentissage plus raide que n’importe quelle option hébergée présentée ici. Gerrit prend tout son sens une fois qu’une organisation est assez grande pour gérer sa propre équipe plateforme et souhaite un historique strict au niveau des commits, un profil mieux adapté à l’échelle qu’à une petite équipe cherchant à avancer vite dès le premier jour.
Aviator : des files de fusion qui gardent le pipeline actif pendant la nuit
Aviator résout un problème différent : fusionner en toute sécurité une fois l’approbation obtenue et sans que personne ne surveille plus. Sa file de fusion regroupe les PR approuvées, retteste chacune par rapport à la branche principale la plus récente, et ne fusionne que ce qui réussit les tests, de sorte qu’une revue validée à minuit devient un changement fusionné au matin, sans qu’aucun humain n’ait à surveiller le pipeline. Pour les équipes distribuées, cela comble l’écart entre " ;approuvé" ; et " ;livré" ; qui, autrement, reste bloqué jusqu’au prochain jour de travail de l’auteur. Cela suppose toutefois une configuration CI mature, car une file de fusion sans tests fiables ne fait qu’automatiser la livraison de code défectueux. Aviator mérite d’être associé à n’importe lequel des outils ci-dessus dès que le volume de fusions rend impraticable une surveillance humaine de la file, car il traite une étape ultérieure du pipeline, différente de la revue elle-même.
Sourcegraph Cody : du contexte inter-dépôts pour des relecteurs sans temps de réunion
Sourcegraph Cody s’attaque directement au problème du contexte. Un relecteur situé à trois fuseaux horaires de distance ne peut pas simplement se pencher et demander pourquoi une fonction existe, alors Cody répond à partir du code lui-même, en effectuant des recherches dans tous les dépôts, en expliquant les modules inconnus et en retraçant la façon dont un changement se propage à travers les dépendances. Cette connaissance inter-dépôts est ce qui permet à un relecteur d’approuver en toute confiance et de s’affranchir entièrement du passage de relais synchrone. Il fonctionne comme un assistant, pas comme un verrou, et complète donc un outil de revue au lieu de le remplacer. Tournez-vous vers Cody spécifiquement lorsqu’une équipe s’étend sur de nombreux dépôts et que les relecteurs restent bloqués sur des questions auxquelles seul l’auteur original pourrait répondre, un manque qu’aucun des cinq autres outils ne comble.
Où l'automatisation atteint ses limites : le problème de la capacité de revue
Chacun des outils ci-dessus accélère la mécanique de la revue. Aucun d’entre eux n’ajoute de relecteurs, et c’est précisément là que les équipes distribuées se retrouvent bloquées. La recherche DORA 2025 de Google le formule bien, en constatant que l’IA agit surtout comme un amplificateur qui " ;amplifie les forces et les faiblesses existantes d’une organisation" ;, plutôt que de corriger d’elle-même un processus défaillant.
Lorsque l’automatisation aide les ingénieurs à produire plus de code, la contrainte se déplace en aval, vers les personnes qui le relisent, et une équipe distribuée le ressent en premier car son vivier de relecteurs est déjà restreint et dispersé entre fuseaux horaires. L’enquête Stack Overflow Developer Survey 2025 montre pourquoi les équipes ne peuvent pas simplement automatiser cet écart, 46 % des développeurs se méfiant des résultats de l’IA et 58,7 % déclarant ne pas prévoir d’utiliser l’IA pour committer et relire du code. Un pipeline de revue de code en intégration continue impose automatiquement ce point de contrôle humain, et une checklist de revue de code partagée maintient des standards identiques, que le relecteur se trouve à Berlin ou à Boston. L’outillage achemine et trie le travail, mais il ne fabrique jamais un jugement senior là où il n’existe pas.
La couche humaine derrière les revues continues
Les équipes qui livrent véritablement 24 heures sur 24 traitent l’outillage comme un échafaudage autour d’une fonction de revue dotée en personnel, et non comme un remplacement de celle-ci. Une véritable couverture 24 heures sur 24 suppose des relecteurs dont les horaires de travail chevauchent chaque partie de votre cycle de commits, qui connaissent votre base de code assez bien pour repérer les problèmes d’intention qu’une IA manque, et qui répondent assez vite pour qu’une pull request ne dorme jamais une nuit entière. La plupart des équipes du marché intermédiaire ne peuvent pas doter cette profondeur depuis un seul bureau.
C’est là qu’une équipe externe trouve sa place. Nous associons des ingénieurs à votre stack exact, de sorte qu’un relecteur acquiert le contexte en quelques jours plutôt qu’en quelques semaines, et une couverture s’étendant sur nos fuseaux horaires et les vôtres signifie qu’une pull request ouverte en fin de votre journée rencontre un relecteur frais au début de la sienne. Associer cette couche humaine senior à l’automatisation décrite ci-dessus, par exemple une première passe par IA de CodeRabbit transmise à un ingénieur adapté à votre stack, c’est ainsi que les équipes distribuées gagnent à la fois en vitesse et en profondeur. Pour les équipes qui intègrent un agent IA directement dans la boucle de revue, notre guide sur l’utilisation de Claude Code pour la revue de code détaille les types de pull requests qu’il gère bien et les limites qu’il vaut la peine de fixer autour de lui.
Les équipes distribuées ne gagnent pas en achetant la plus longue liste de fonctionnalités. Elles gagnent en décidant ce que la revue asynchrone doit garantir, en choisissant deux ou trois outils qui tiennent ces garanties, et en les appuyant sur des relecteurs dont les horaires et l’expertise couvrent réellement la journée entière. Réussissez la couche humaine et l’outillage la démultiplie. Ratez-la et des fusions plus rapides ne font que livrer les défauts plus tôt. Si vous voulez une équipe de revue senior adaptée à votre stack et à vos fuseaux horaires, contactez-nous.
FAQ
Comment les équipes à distance gèrent-elles les revues de code entre fuseaux horaires ?
Les équipes à distance rendent la revue asynchrone par défaut. Cela signifie de petites pull requests qu’un relecteur peut traiter seul, un contexte complet rédigé dans la description de la PR pour qu’aucun appel en direct ne soit nécessaire, un routage automatique vers la personne en ligne, et une file de fusion qui livre en toute sécurité les changements approuvés pendant que l’auteur dort. Les équipes dont les horaires se chevauchent d’au moins une heure de travail par région traitent les revues urgentes en direct et laissent tout le reste au flux asynchrone.
Quel outil de revue de code fonctionne le mieux pour les revues asynchrones ?
Il n’existe pas de gagnant unique, car la revue asynchrone répond à plusieurs besoins distincts. Gerrit est le choix le plus solide pour une revue purement basée sur les changements à grande échelle, CodeRabbit est le meilleur pour une première passe automatisée permettant aux relecteurs de démarrer sur des bases déjà préparées, et Graphite l’emporte en gardant les pull requests assez petites pour être revues seul. La plupart des équipes distribuées combinent une première passe par IA, une couche de routage ou d’empilement, et une file de fusion, plutôt que de dépendre d’un seul produit.
Quelle est la plus grande erreur que commettent les équipes distribuées avec les outils de revue de code ?
Supposer qu’un outil ajoute de la capacité de revue. L’automatisation trie, achemine et résume, mais elle ne crée jamais de relecteurs seniors ni le jugement nécessaire pour repérer les bugs liés à l’intention. Les équipes qui achètent de l’outillage pour compenser une fonction de revue sous-dotée ou mal adaptée finissent par fusionner plus vite tout en livrant les mêmes défauts plus tard. Corrigez d’abord la couche humaine, puis ajoutez de l’outillage pour l’accélérer.
Découvrez comment nous avons audité le logiciel Project Science de Complete Network, améliorant la maintenabilité du code de 80 %