Créer une application avec un minimum d’effort en utilisant l’IA semble être un rêve devenu réalité jusqu’à ce que vous compreniez l’étendue exacte des risques de sécurité du code généré par IA. De nombreuses entreprises l’ont déjà appris à leurs dépens, comme Moltbook, qui a perdu 1,5 million de jetons d’authentification API, 35 000 adresses e-mail et des messages privés dans les trois jours suivant son lancement.
La vérité est que la situation de Moltbook n’est pas un cas isolé. C’est ce qui se passe lorsque vous déployez un MVP généré par IA sans audit. Le schéma que nous observons dans les MVP générés par IA est cohérent et n’est pas subtil. Dans cet article, nous classons les sept risques de sécurité liés au code généré par IA qui apparaissent le plus souvent lors des audits, expliquons pourquoi ils s’aggravent silencieusement, et vous donnons une liste de contrôle par étape que vous pouvez exécuter avant le lancement discret, avant votre premier projet pilote payant et avant une levée de fonds d’amorçage.
De plus, nous expliquons comment le nettoyage professionnel du code généré par IA couvre les surfaces à haut risque : code, configuration, authentification et API, afin de garantir que chaque partie du produit est sécurisée à chaque itération, jusqu’à la production.
Pourquoi les risques du code généré par IA ne sont pas de simples bugs de « développeur junior »
Il est tout à fait normal que les développeurs juniors fassent des erreurs. Cependant, lors d’un développement logiciel classique, où l’on ne se fie pas à un « code par ambiance », ces erreurs sont généralement détectées avant que des dommages ne soient causés.
D’ordinaire, une entreprise de développement logiciel met en place plusieurs filets de sécurité pour examiner le travail d’un développeur junior avant qu’il n’atteigne les utilisateurs réels. Il existe des outils automatisés qui analysent le code à la recherche d’erreurs courantes, ainsi qu’un développeur senior pour examiner chaque changement. Des outils de sécurité signalent tout mot de passe ou clé de connexion divulgués, tandis que quelqu’un dans l’équipe prend le temps de réfléchir attentivement à la manière dont un attaquant pourrait tenter de casser les choses. Ensemble, ces couches permettent de corriger la plupart des problèmes évidents avant la mise en production.
Les applications « codées par ambiance » manquent généralement de ces étapes d’examen supplémentaires, ce qui entraîne trois problèmes majeurs :
- Les mêmes erreurs reviennent sans cesse
À chaque fois que vous demandez à l’IA d’ajouter une nouvelle fonctionnalité, elle peut accidentellement annuler une correction de sécurité que vous avez apportée la veille. L’IA n’a pas de mémoire de ce qu’elle a corrigé hier, de sorte que les problèmes que vous pensiez résolus reviennent silencieusement. - Personne ne possède réellement le code
Si aucun humain n’a écrit une ligne de ce code, aucun humain ne pourra le corriger lorsque les choses tourneront mal. Lorsqu’un problème survient au milieu de la nuit et que les utilisateurs sont bloqués, « demander à l’IA d’essayer à nouveau » n’est pas un véritable plan. - Une bonne démo n’est pas synonyme de sécurité avec des utilisateurs réels
L’IA est récompensée pour produire du code qui fonctionne et qui semble correct. Elle n’est pas récompensée pour produire du code qui résiste lorsqu’une personne tente activement de s’introduire.
Toutes ces affirmations sont étayées par des données réelles, notamment celles de Veracode, qui a testé plus de 100 outils de codage IA et a constaté que le code Java généré par IA échouait aux tests de sécurité de base dans 72 % des cas. Dans 86 % des cas, l’IA écrivait du code qui permettrait aux attaquants d’exécuter des scripts malveillants via un site Web. Une étude distincte d’Apiiro, portant sur des entreprises du Fortune 500, a révélé que le code assisté par IA contenait 322 % de vulnérabilités supplémentaires pour les attaquants et 153 % de défauts structurels profonds en plus que le code écrit par des humains. Entre décembre 2024 et juin 2025, le code généré par IA a été lié à environ 10 000 nouveaux problèmes de sécurité chaque mois. C’est dix fois plus qu’il y a seulement six mois, et cette accumulation de problèmes de sécurité ne cesse de croître chaque mois.
Top 7 des risques de sécurité du code généré par IA, classés par fréquence d'audit
Les risques du code généré par IA que nous constatons le plus souvent lors du nettoyage de code sont récurrents. Cela signifie qu’ils sont identiques, quel que soit le type d’application que vous créez ou l’outil que vous utilisez. Nous avons classé la liste ci-dessous en fonction de ce que les auditeurs constatent réellement dans des cas concrets, et non de ce qui est le plus facile à scanner.
Secrets codés en dur dans le code côté client
C’est le risque de sécurité le plus courant lié au code généré par IA que nous ayons rencontré. Les clés API, les URL de base de données, les identifiants de service et les jetons d’authentification sont intégrés dans des fichiers JavaScript qui sont directement envoyés au navigateur. Ensuite, il suffit d’ouvrir les DevTools, de regarder la source, et ils sont là.
La violation de données de Moltbook, documentée par Wiz Research, est l’exemple type de ce problème. Une clé API Supabase a été stockée dans un package côté client avec la sécurité au niveau des lignes (RLS) de Supabase désactivée, accordant à toute personne disposant d’un navigateur un accès complet à la base de données de production. Aucune exploitation, aucune sophistication n’était nécessaire, juste de la curiosité, et vous obtenez un accès aux données.
Ce qu’un audit détecte : analyse des secrets dans tout le dépôt et les packages intégrés, ainsi qu’une revue de configuration de chaque service backend avec lequel l’application communique.
Authentification et autorisation défaillantes
Les outils d’IA génèrent des flux de connexion qui semblent corrects en démonstration, mais ils échouent souvent silencieusement face à de vrais attaquants.
Schémas courants que nous trouvons :
- Les routes d’administration ne sont protégées que par un indicateur côté client, tel que `isAdmin`. Par conséquent, un utilisateur le modifie dans le navigateur et y accède.
- Points d’accès qui vérifient si vous êtes connecté, mais pas si vous devriez voir les données de cet utilisateur (autorisation au niveau de l’objet défaillante, ou BOLA).
- Flux de réinitialisation de mot de passe qui envoient un jeton par e-mail sans vérifier l’identité du demandeur.
- Cookies de session envoyés sans `HttpOnly`, `Secure`, ou expiration appropriée.
Par exemple, considérons qu’en juillet 2025, Wiz Research a trouvé cette classe exacte de faille dans Base44, une plateforme populaire de code généré par IA. Un `app_id` publiquement visible était suffisant pour créer un compte vérifié dans l’application privée de quelqu’un d’autre.
Ce qu’un audit détecte : vérifications d’authentification côté serveur sur chaque route, tests BOLA et IDOR sur chaque point d’accès aux ressources, et renforcement des sessions.
Règles mal configurées des services backend (BaaS)
Supabase, Firebase et des plateformes similaires facilitent la création d’applications générées par IA, mais elles proposent également par défaut des configurations permissives qui ne sont sûres que si vous savez comment les sécuriser. Par exemple, la violation de données de l’application Tea en 2025 a exposé 72 000 images d’utilisateurs, dont 13 000 cartes d’identité gouvernementales et selfies, car un bucket Firebase était laissé ouvert sans authentification. De nombreuses applications plus petites que nous avons examinées sont livrées avec la règle de base de données définie sur « autoriser lecture, écriture : si vrai ».
Ce qu’un audit détecte : revue de chaque règle BaaS, politique RLS et ACL de bucket de stockage, ainsi que des tests qui tentent de lire et d’écrire des données en tant qu’utilisateur anonyme.
Vulnérabilités d'injection (SQL, NoSQL, commande)
Les LLM aiment l’interpolation de chaînes, mais l’interpolation de chaînes aime être injectée. Ainsi, lorsqu’un modèle écrit une requête de base de données, il adopte souvent une approche en langage naturel et insère directement la variable utilisateur dans le SQL. Cela fonctionne lors des tests avec des entrées bénignes, mais pose problème dès qu’un utilisateur réel tape une apostrophe ou supprime une table.
Les directives OWASP LLM05:2025 sur la gestion incorrecte des sorties signalent ce schéma exact : une couche de base de données générée par IA qui construit des requêtes à partir des invites de l’utilisateur peut être trompée pour détruire les données qu’elle était censée interroger.
Ce qu’un audit détecte : inspection manuelle de chaque couche d’accès aux données, application de requêtes paramétrées et tests de fuzzing des entrées utilisateur.
Validation des entrées et nettoyage des sorties manquants
Le code généré fait confiance aux entrées utilisateur, mais cette confiance ne devrait pas s’étendre aux utilisateurs réels. Par conséquent, sans validation sur chaque champ et sans nettoyage avant que toute donnée n’atteigne une base de données ou ne soit rendue en HTML, vous n’êtes qu’à une charge utile élaborée d’un XSS stocké, d’une injection HTML, ou pire.
L’étude de Veracode a révélé que les outils d’IA n’avaient pas réussi à se défendre contre le cross-site scripting (CWE-80) dans 86 % des échantillons pertinents. À ce stade, il s’agit d’un risque de sécurité par défaut lié au code généré par IA plutôt que d’une erreur mineure.
Ce qu’un audit détecte : validation de schéma à chaque frontière d’API, encodage de sortie à chaque chemin de rendu, en-têtes CSP et tests DAST de l’application en cours d’exécution.
Dépendances non sécurisées et hallucination
Voici un risque dont la plupart des fondateurs n’ont pas entendu parler : le slopsquatting. Cela provient des LLM, qui inventent parfois des noms de packages. Ils suggèrent d’importer `fastjson-pro` alors qu’aucune bibliothèque de ce type n’existe sur npm ou PyPI. Les attaquants surveillent ces hallucinations, enregistrent les faux packages et attendent que le prochain développeur copie-colle la suggestion.
Même lorsque les packages sont réels, ils peuvent être compromis. Par exemple, en août 2025, le système de build populaire Nx a été victime d’une attaque de la chaîne d’approvisionnement où des attaquants ont fusionné une demande de tirage malveillante, puis ont utilisé les outils en ligne de commande de Claude, Gemini et Amazon Q sur des machines infectées pour rechercher les identifiants de portefeuille de crypto-monnaies. Les utilisateurs ont vu leurs portefeuilles vidés avant que quiconque ne s’en aperçoive.
Ce qu’un audit détecte : génération du relevé des matériaux logiciels (SBOM), analyse des dépendances et vérification que chaque package importé existe réellement sur son registre officiel.
Infrastructure exposée et valeurs par défaut trop permissives
Le dernier risque courant du «vibe coding» est assez ennuyeux, mais il compromet toujours des centaines de systèmes. Des buckets S3 publics, des CORS ouverts, des panneaux d’administration sur Internet sans liste blanche IP, des points d’accès de débogage en production, l’absence de limitation de débit sur les routes d’authentification et des journaux qui enregistrent volontiers les mots de passe et les jetons font partie de ce risque. Cependant, au lieu d’être des défauts de codage, ce sont des défauts de déploiement.
Les outils d’IA génèrent de l’infrastructure-as-code de la même manière qu’ils génèrent du code applicatif : optimisés pour «ça fonctionne» et indifférents à «c’est sécurisé».
Ce qu’un audit détecte : revue de l’infrastructure, audit CORS, vérification des secrets dans les logs, vérification de la limitation de débit et contrôle d’accès au niveau réseau.
Pourquoi ces risques de «vibe coding» s'aggravent au lieu de rester mineurs
Le nettoyage est toujours plus difficile que prévu, car chaque itération de «vibe coding» optimise pour «ça marche encore». Par conséquent, il n’optimise pas pour «c’est toujours sûr», donc un bug corrigé peut réapparaître la prochaine fois que vous demandez une fonctionnalité connexe. Par exemple, une autorisation renforcée peut s’assouplir à nouveau lorsque vous demandez un «onboarding plus facile» et que le code dérive vers sa valeur par défaut conviviale pour les démos.
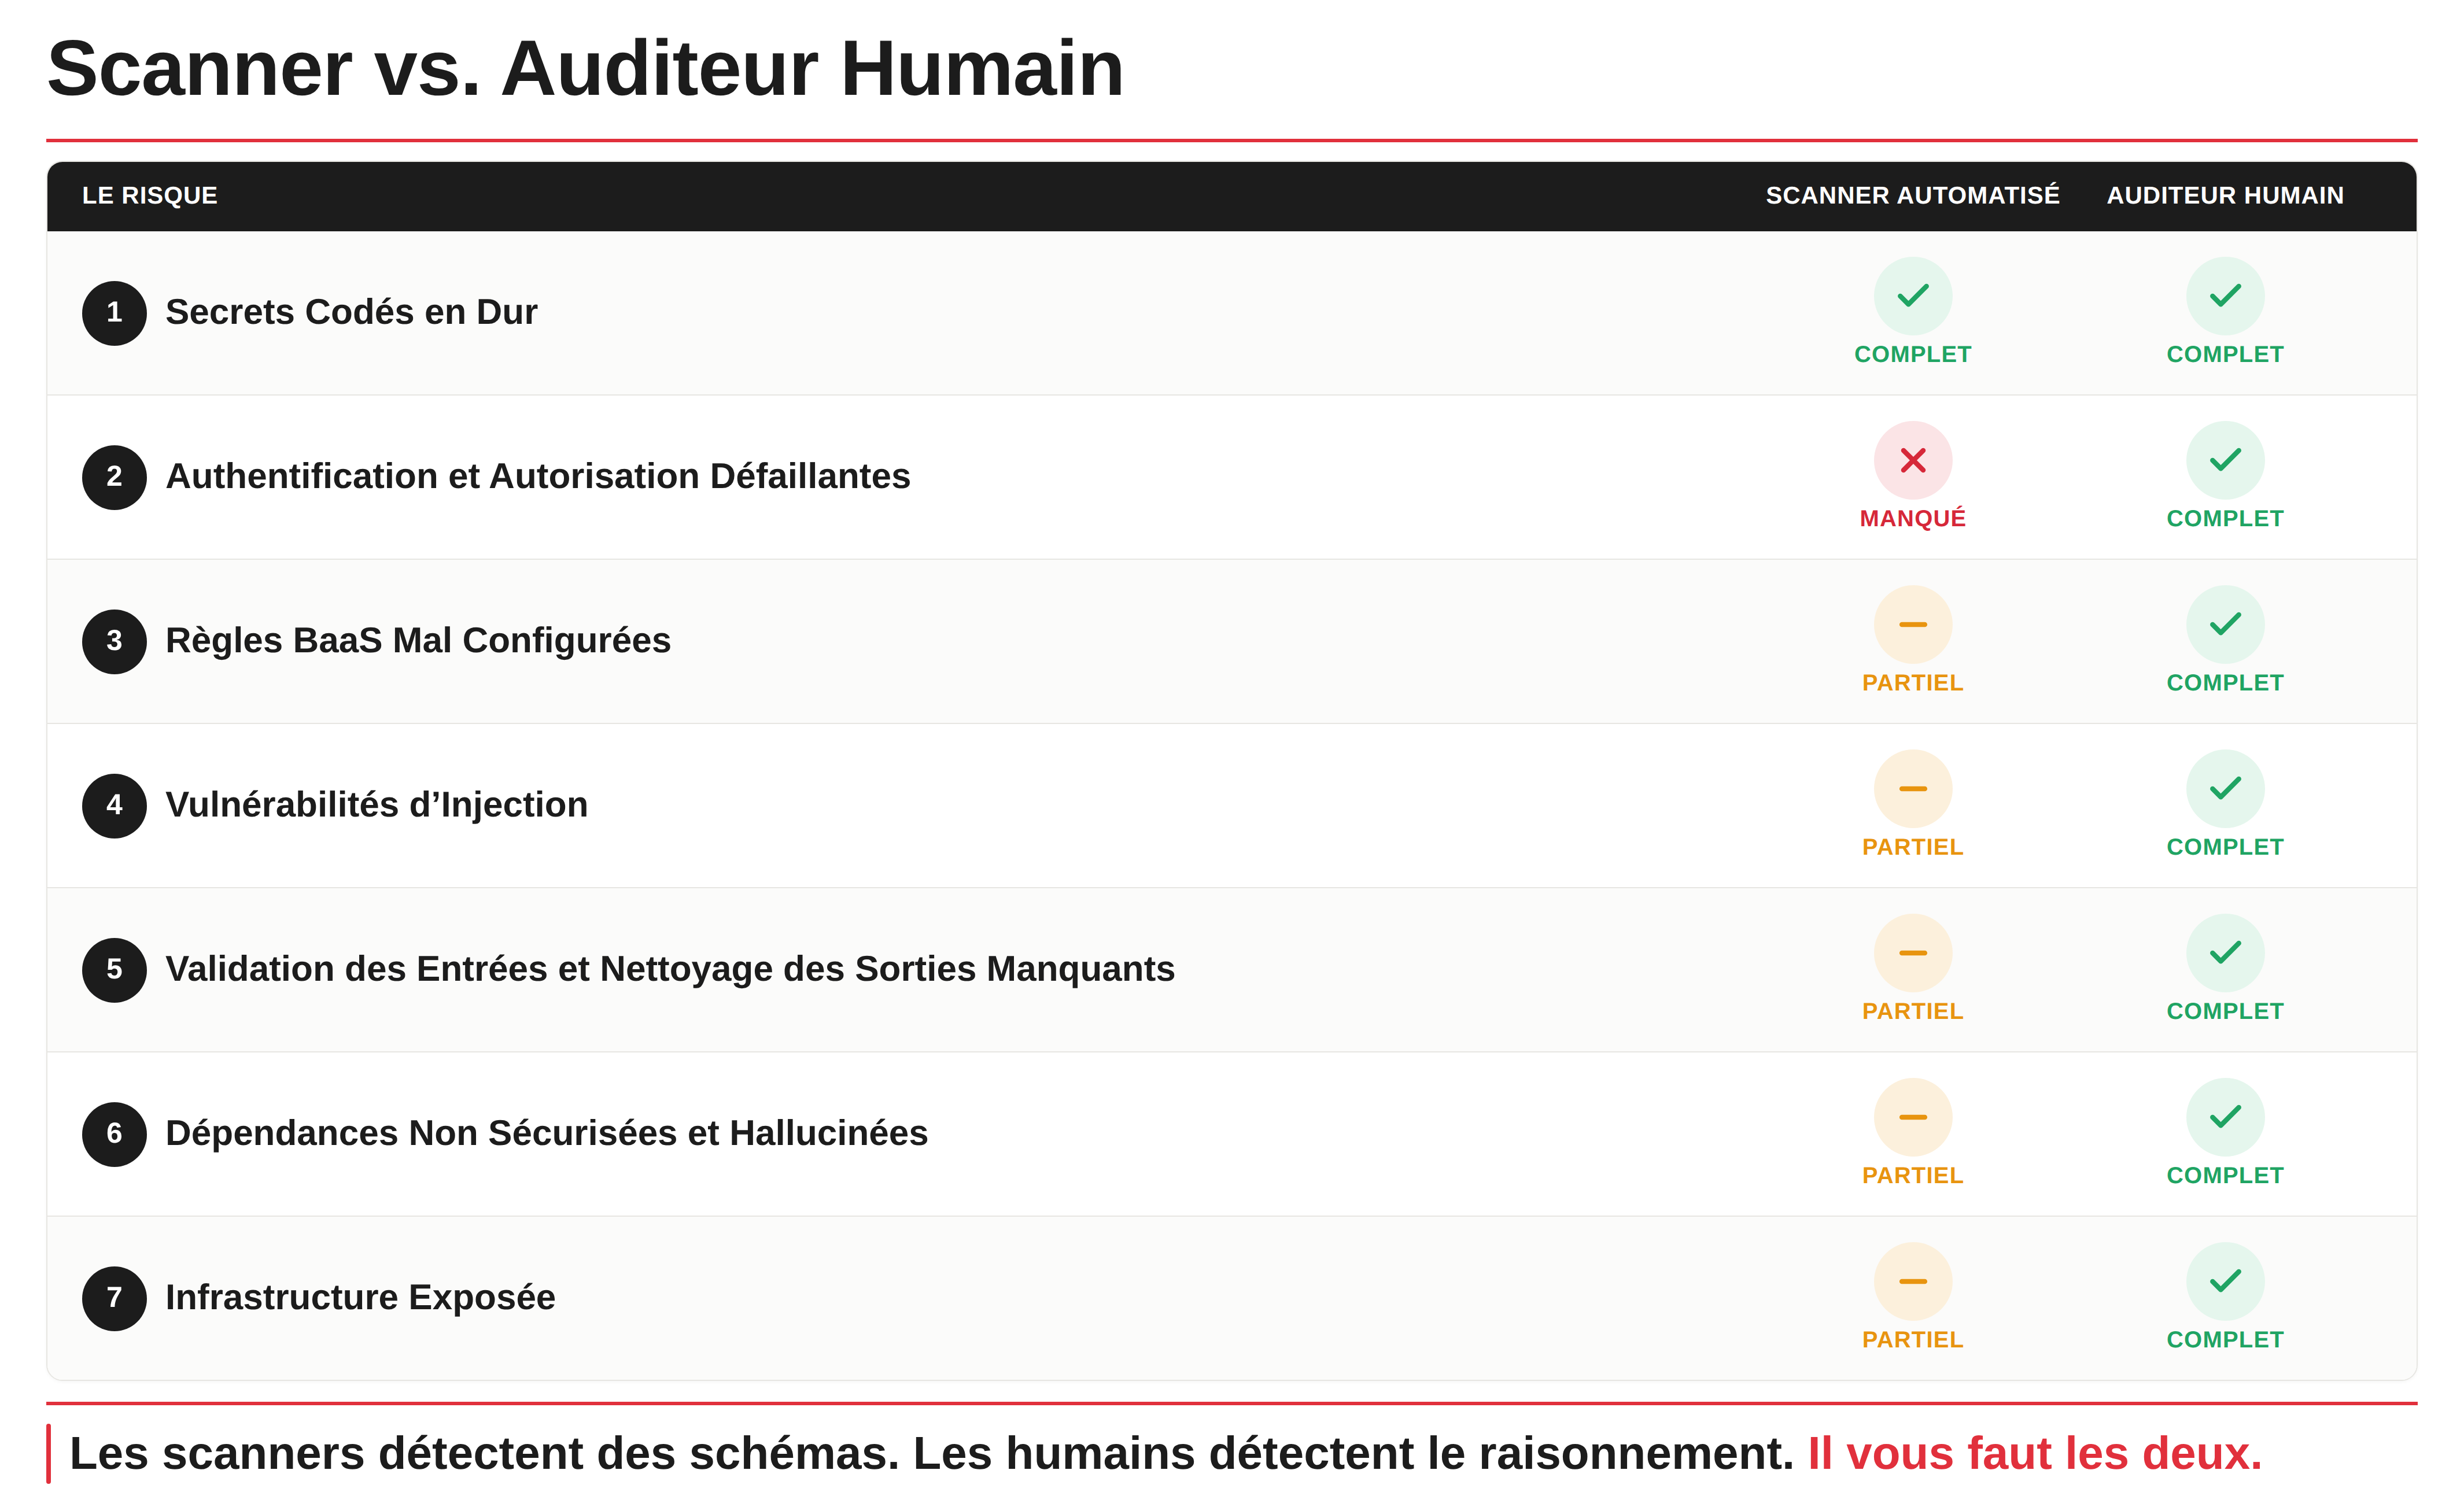
Les outils d’analyse statique aident, mais ils ratent plus qu’ils ne détectent. Les recherches d’Apiiro ont révélé que le code assisté par IA soulève précisément la classe de problèmes que les scanners manquent, tels que des flux d’authentification défectueux, des conceptions non sécurisées et des faiblesses architecturales systémiques. Ce sont des problèmes profonds que les réviseurs peinent à repérer, et que les scanners n’ont pas été conçus pour trouver. Par conséquent, le vrai travail qui compte reste humain.
L'audit minimal viable de «vibe coding», par étape
Il est essentiel de comprendre que vous n’avez pas besoin d’un audit complet d’entreprise dès le premier jour. Au lieu de cela, vous bénéficierez davantage en choisissant le type d’audit spécifique qui correspond à votre étape de développement. De cette façon, vous obtiendrez le meilleur rapport qualité-prix et éviterez de dépasser votre budget.
Avant le lancement soft (les vrais utilisateurs s’apprêtent à voir ceci) :
- Scan des secrets sur tout le dépôt et les actifs clients groupés
- Vérification de toutes les règles BaaS, RLS, règles Firebase et buckets de stockage (ne doivent pas être publics)
- Chaque point d’accès est authentifié côté serveur, et il n’y a pas de drapeaux côté client qui déterminent qui voit quoi
- Scan des dépendances pour supprimer ou remplacer tout élément non vérifié
- CORS configuré pour vos domaines réels
Avant un pilote payant (l’argent va bientôt changer de mains) :
- Logique d’authentification et de session testée correctement en pentest
- Vérifications BOLA et IDOR sur chaque point d’accès aux ressources
- Validation des entrées sur chaque champ de formulaire et paramètre d’API
- Journaux examinés pour détecter les fuites de PII et de secrets
- Limitation de débit active sur les routes d’authentification, de paiement et à forte charge d’écriture
- Sauvegarde et restauration testées au moins une fois
Avant une levée de fonds d’amorçage (la due diligence approche) :
- Revue de code tiers avec un rapport écrit que les investisseurs peuvent consulter
- Modèle de menace documenté et partagé avec le responsable de l’ingénierie
- Inventaire logiciel généré et maintenu à jour
- Rapport de test d’intrusion, datant de moins de 90 jours
- Manuel de réponse aux incidents et procédure de rotation des secrets, tous deux rédigés
- Gestion des données mappée au cadre pertinent pour votre marché (GDPR, HIPAA, préparation SOC 2)
Ce qu'un audit professionnel de «vibe coding» couvre réellement
La spirale sombre et dangereuse dans laquelle le «vibe coding» entraîne, c’est que les gens sont tentés de tout laisser à la machine, y compris la revue de code. Cependant, la réalité est que même lorsqu’un LLM effectue un audit et vous donne une liste exhaustive de problèmes, une grande partie sera erronée et les problèmes les plus dangereux n’y figureront pas.
Cela se produit car les scanners automatisés, y compris ceux basés sur l’IA, ne connaissent pas votre modèle de menace. Ils ne savent pas quelles tables contiennent des PII, et ils ne savent pas que le point d’accès `/admin/refund` est celui qui déplace l’argent. Ils ne connaissent pas non plus votre périmètre de conformité, ils rapportent ce qui correspond à un modèle et manquent ce qui compte vraiment.
Un audit structuré de «vibe coding» couvre ce que les scanners négligent :
- Revue du code source par des ingénieurs ayant déjà rencontré ces modes de défaillance
- Revue de l’architecture axée sur les frontières de confiance, les flux de données et le rayon d’explosion
- Revue de la configuration de chaque réglage BaaS, cloud et de déploiement
- Tests d’API avec un état d’esprit contradictoire, pas une simple liste de contrôle
- Audit des dépendances, y compris les paquets hallucinéés, abandonnés et typosquattés
- Modélisation des menaces contre votre activité réelle, vos utilisateurs réels, vos attaquants réels
C’est exactement ce que proposent les services de nettoyage de «vibe code» et d’audit logiciel de Redwerk. Nous n’avons pas d’ingénieurs juniors lisant des rapports de scan générés par IA génériques et «corrigeant» tout ce qui attire leur attention. Au contraire, notre équipe expérimentée possède des années d’expérience dans la transformation de bases de code désordonnées en produits qui résistent au trafic réel. Nous avons même aidé à auditer et à pérenniser une plateforme de détection de fraude fintech pour Project Science, augmentant la maintenabilité de l’API backend de 80 %, donc les applications de «vibe coding» nous sont familières.
En résumé : la manière sûre de gérer les risques du «vibe coding»
Le «vibe coding» ne va pas disparaître, et ne devrait pas, car cette technologie offre de grandes opportunités lorsqu’elle est bien utilisée. L’utilisation du développement assisté par IA, sous quelque forme que ce soit, permet souvent de mettre un produit devant les utilisateurs en quelques jours plutôt qu’en quelques mois.
Cependant, ce qui doit changer, c’est ce qui se passe entre «ça marche en démo» et sa sortie effective aux utilisateurs. C’est cet écart où se trouve 45 % du code vulnérable OWASP et où les risques de «vibe coding» cachés dans votre base de code cessent d’être théoriques et commencent à vous coûter des clients.
Vous n’avez pas besoin de ralentir les expéditions pour lancer une revue complète de «vibe code» afin d’identifier les faiblesses et de les corriger, augmentant ainsi la sécurité et la fiabilité globales du produit. Et pour ce faire, vous aurez besoin du bon regard sur le code et de réviseurs expérimentés capables de développer une stratégie de sécurité efficace.
Si vous avez utilisé le «vibe coding» pour votre MVP et que vous êtes proche du lancement, d’un pilote payant ou d’une levée de fonds, parlez-nous. Nous vous dirons franchement ce qui est cassé, ce qui est récupérable et ce qu’il faut corriger en premier.
FAQ
Le logiciel codé à la va-vite est-il sûr pour la production ?
La vérité est que les applications codées à la va-vite ne sont pas entièrement sûres sans un audit par un expert humain. Les tests de Veracode sur plus de 100 LLM ont révélé que 45 % du code généré par IA contient des vulnérabilités OWASP. Chaque application codée à la va-vite que nous avons examinée présentait au moins un problème exploitable.
Quels sont les plus grands risques de sécurité du «vibe coding» ?
Les plus grands risques de sécurité du «vibe coding» sont :
- Secrets codés en dur dans le code côté client
- Authentification et autorisation défaillantes
- Règles BaaS mal configurées
Ces trois éléments représentent la majorité des conclusions critiques dans les audits que nous effectuons.
Combien coûte un audit de «vibe coding» ?
Le coût d’un audit de code “vibe” dépend de la taille de votre base de code et de votre stade de développement. Un examen ciblé avant le lancement n’a pas la même portée qu’un audit avant une levée de fonds pré-amorçage avec un test d’intrusion complet. Envoyez-nous ce que vous avez construit et nous l’évaluerons correctement.
Puis-je auditer ma propre application "vibe" ?
Vous pouvez réaliser l’audit vous-même, en partie, en utilisant des outils de scan de secrets automatisés, des vérifications de dépendances et des audits RLS de base. Cependant, les failles de logique métier, les escalades de privilèges en chaîne et l’utilisation abusive des frontières de confiance nécessitent une expérience adversaire. C’est là que les audits externes justifient leur coût.
Quand un fondateur devrait-il faire réaliser un audit de code "vibe" ?
Les meilleurs moments pour réaliser un audit complet de code “vibe” sont avant que de vrais utilisateurs n’utilisent l’application, avant que de l’argent ne change de mains, ou avant que les investisseurs n’effectuent leur due diligence. La règle d’or reste la même : plus l’audit est réalisé tôt, moins les corrections sont coûteuses.
Un test d'intrusion remplace-t-il un audit de code ?
Non, le pentesting est essentiel, mais ce n’est pas la même chose qu’un audit de code détaillé. Ils répondent à des questions différentes :
- Un test d’intrusion montre ce qu’un attaquant peut exploiter depuis l’extérieur.
- Un audit de code montre ce qui ne va pas de l’intérieur, y compris les problèmes qui n’ont pas encore été exploités.
La meilleure stratégie pour les applications “vibe” est de commencer par l’audit de code, car les problèmes sont très souvent structurels. Ajoutez ensuite des tests d’intrusion une fois les problèmes évidents résolus.
Découvrez comment nous avons aidé Complete Network à auditer son API backend et à améliorer sa maintenabilité de 80%