
Gigmit
 Gigmit
Berlin, Allemagne
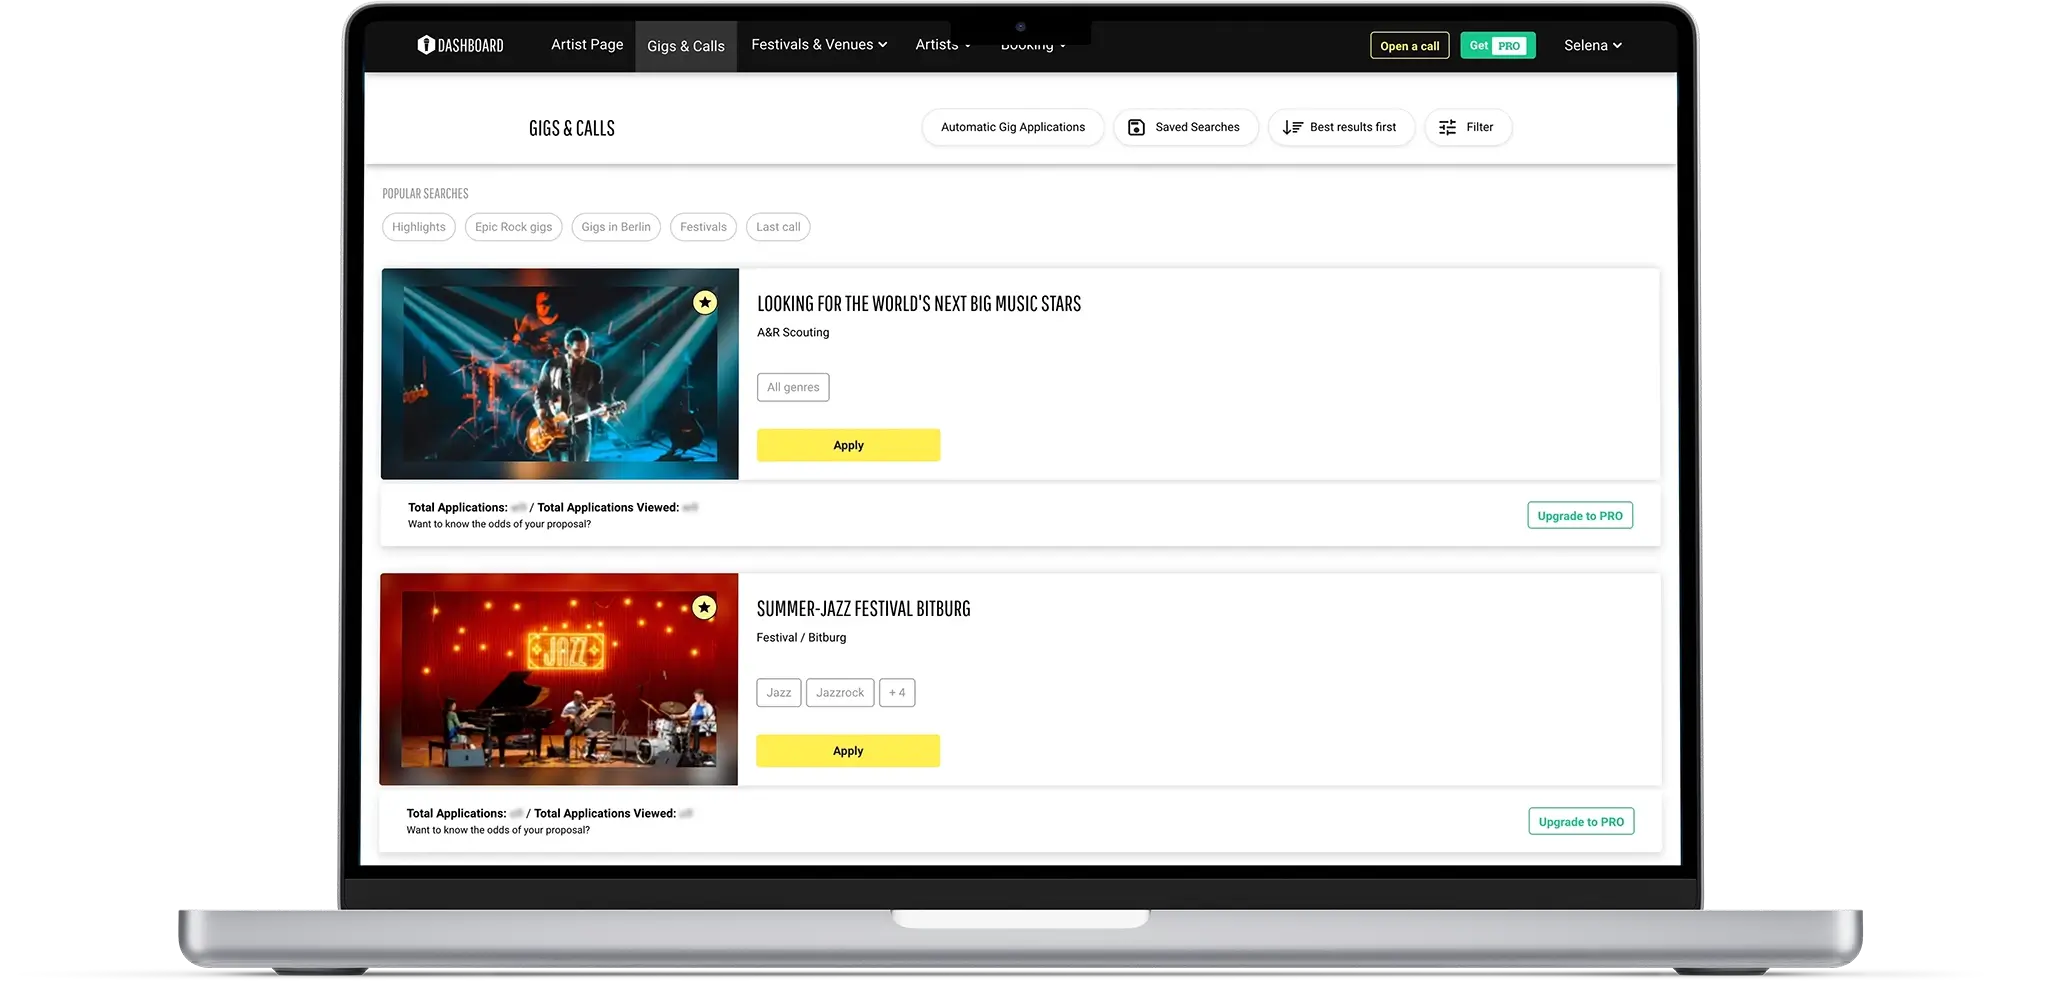
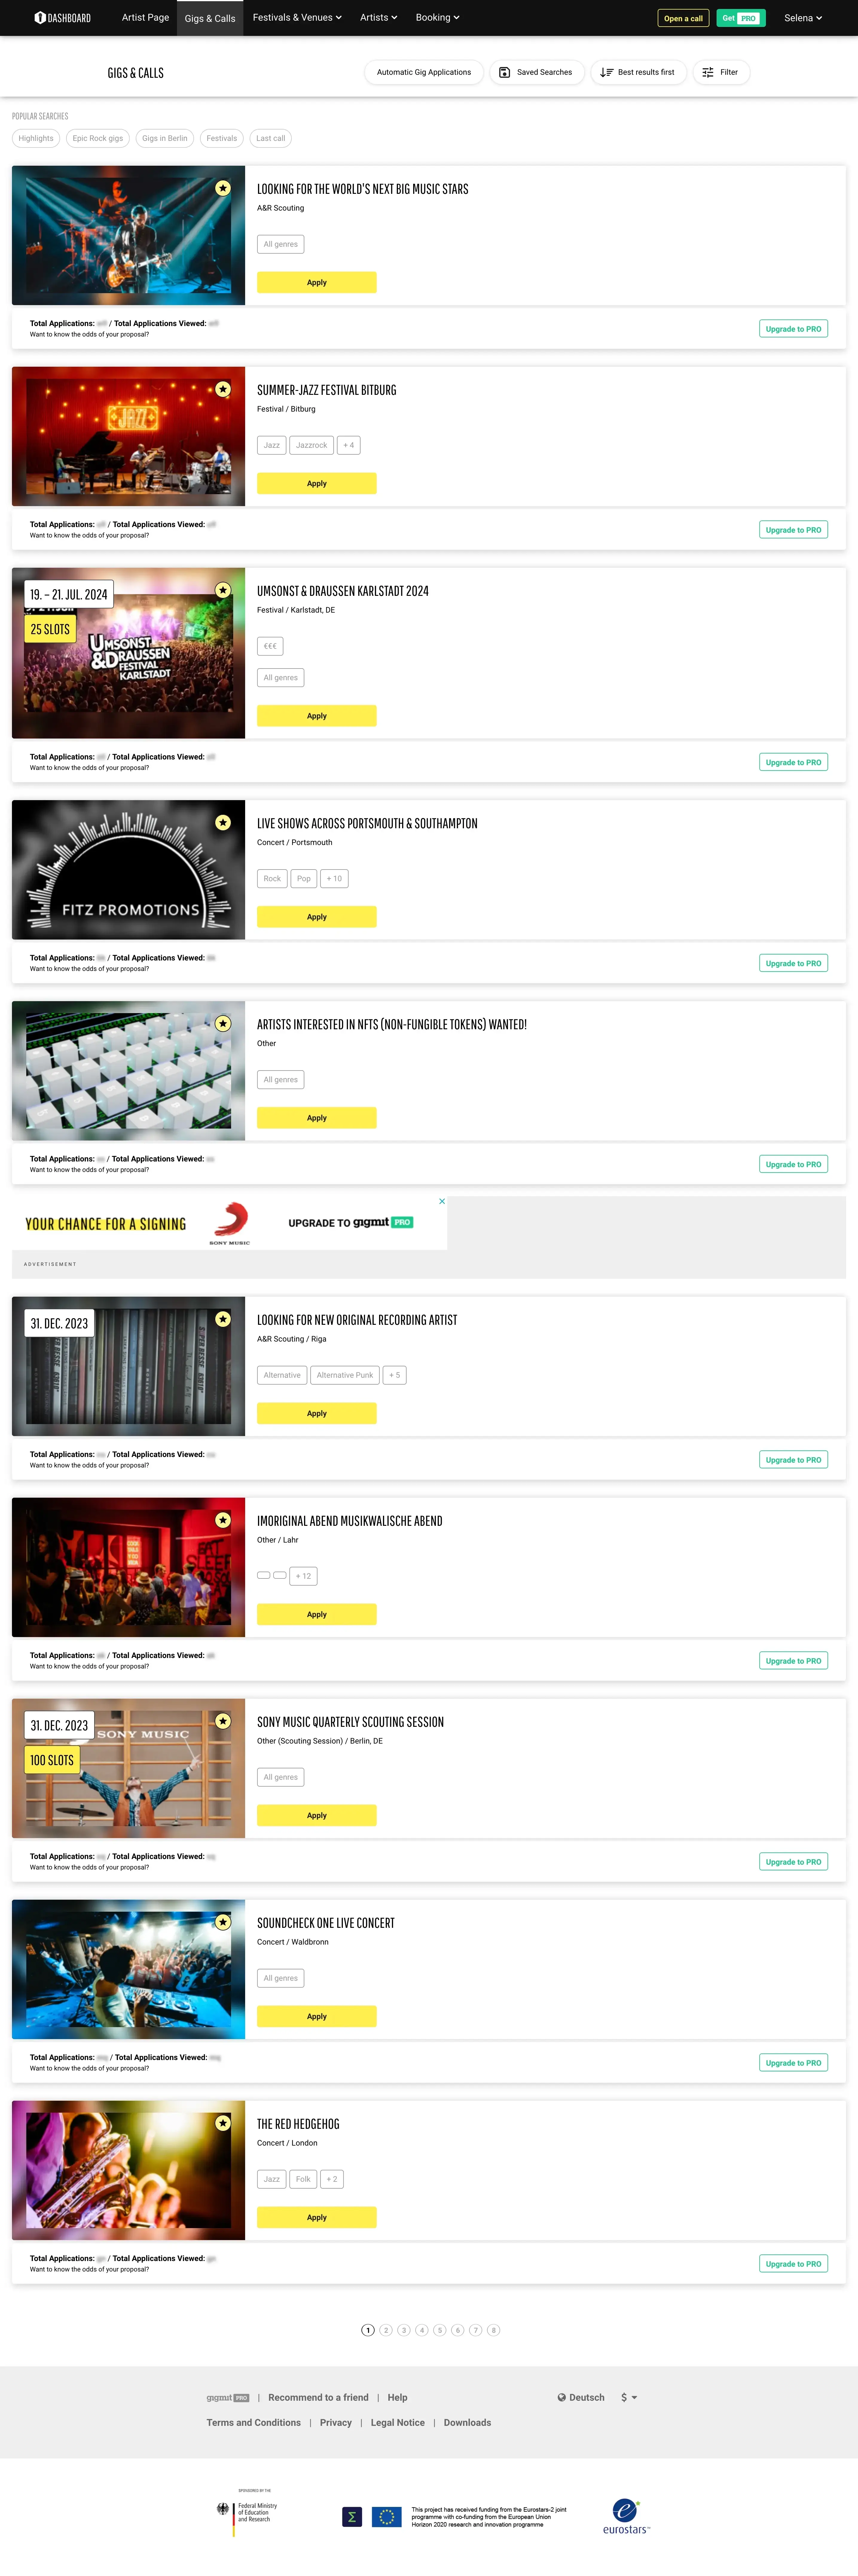
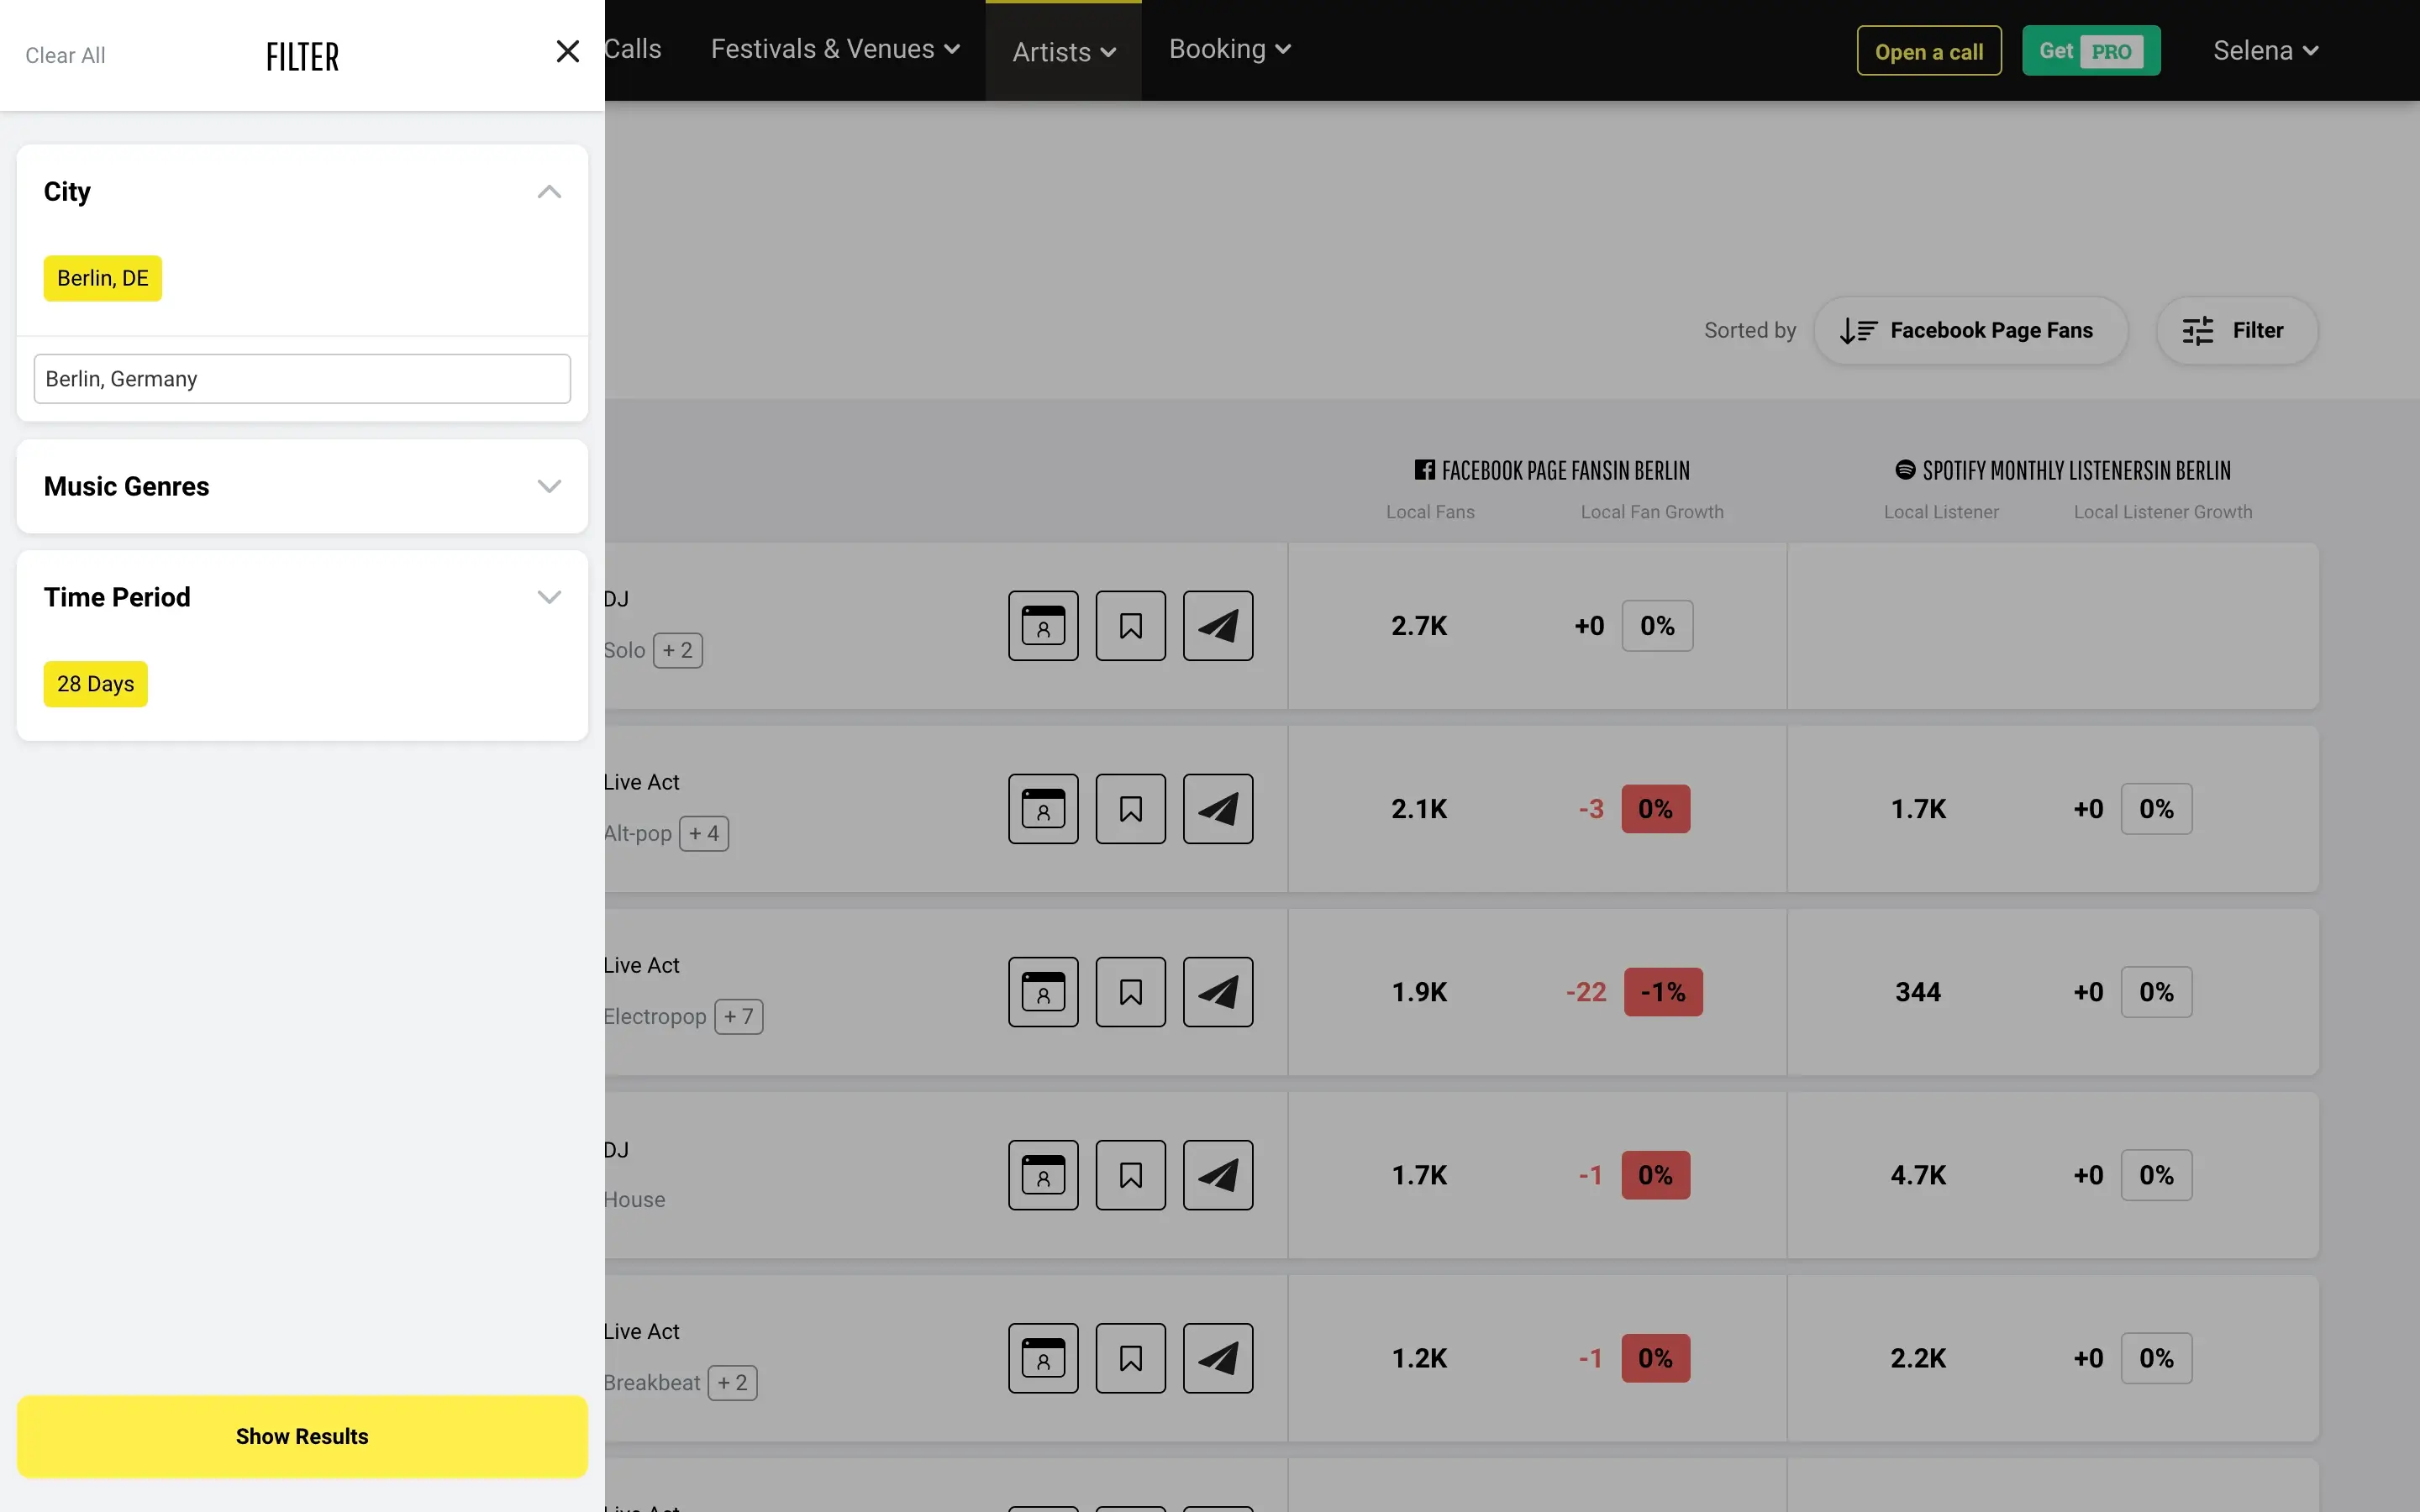
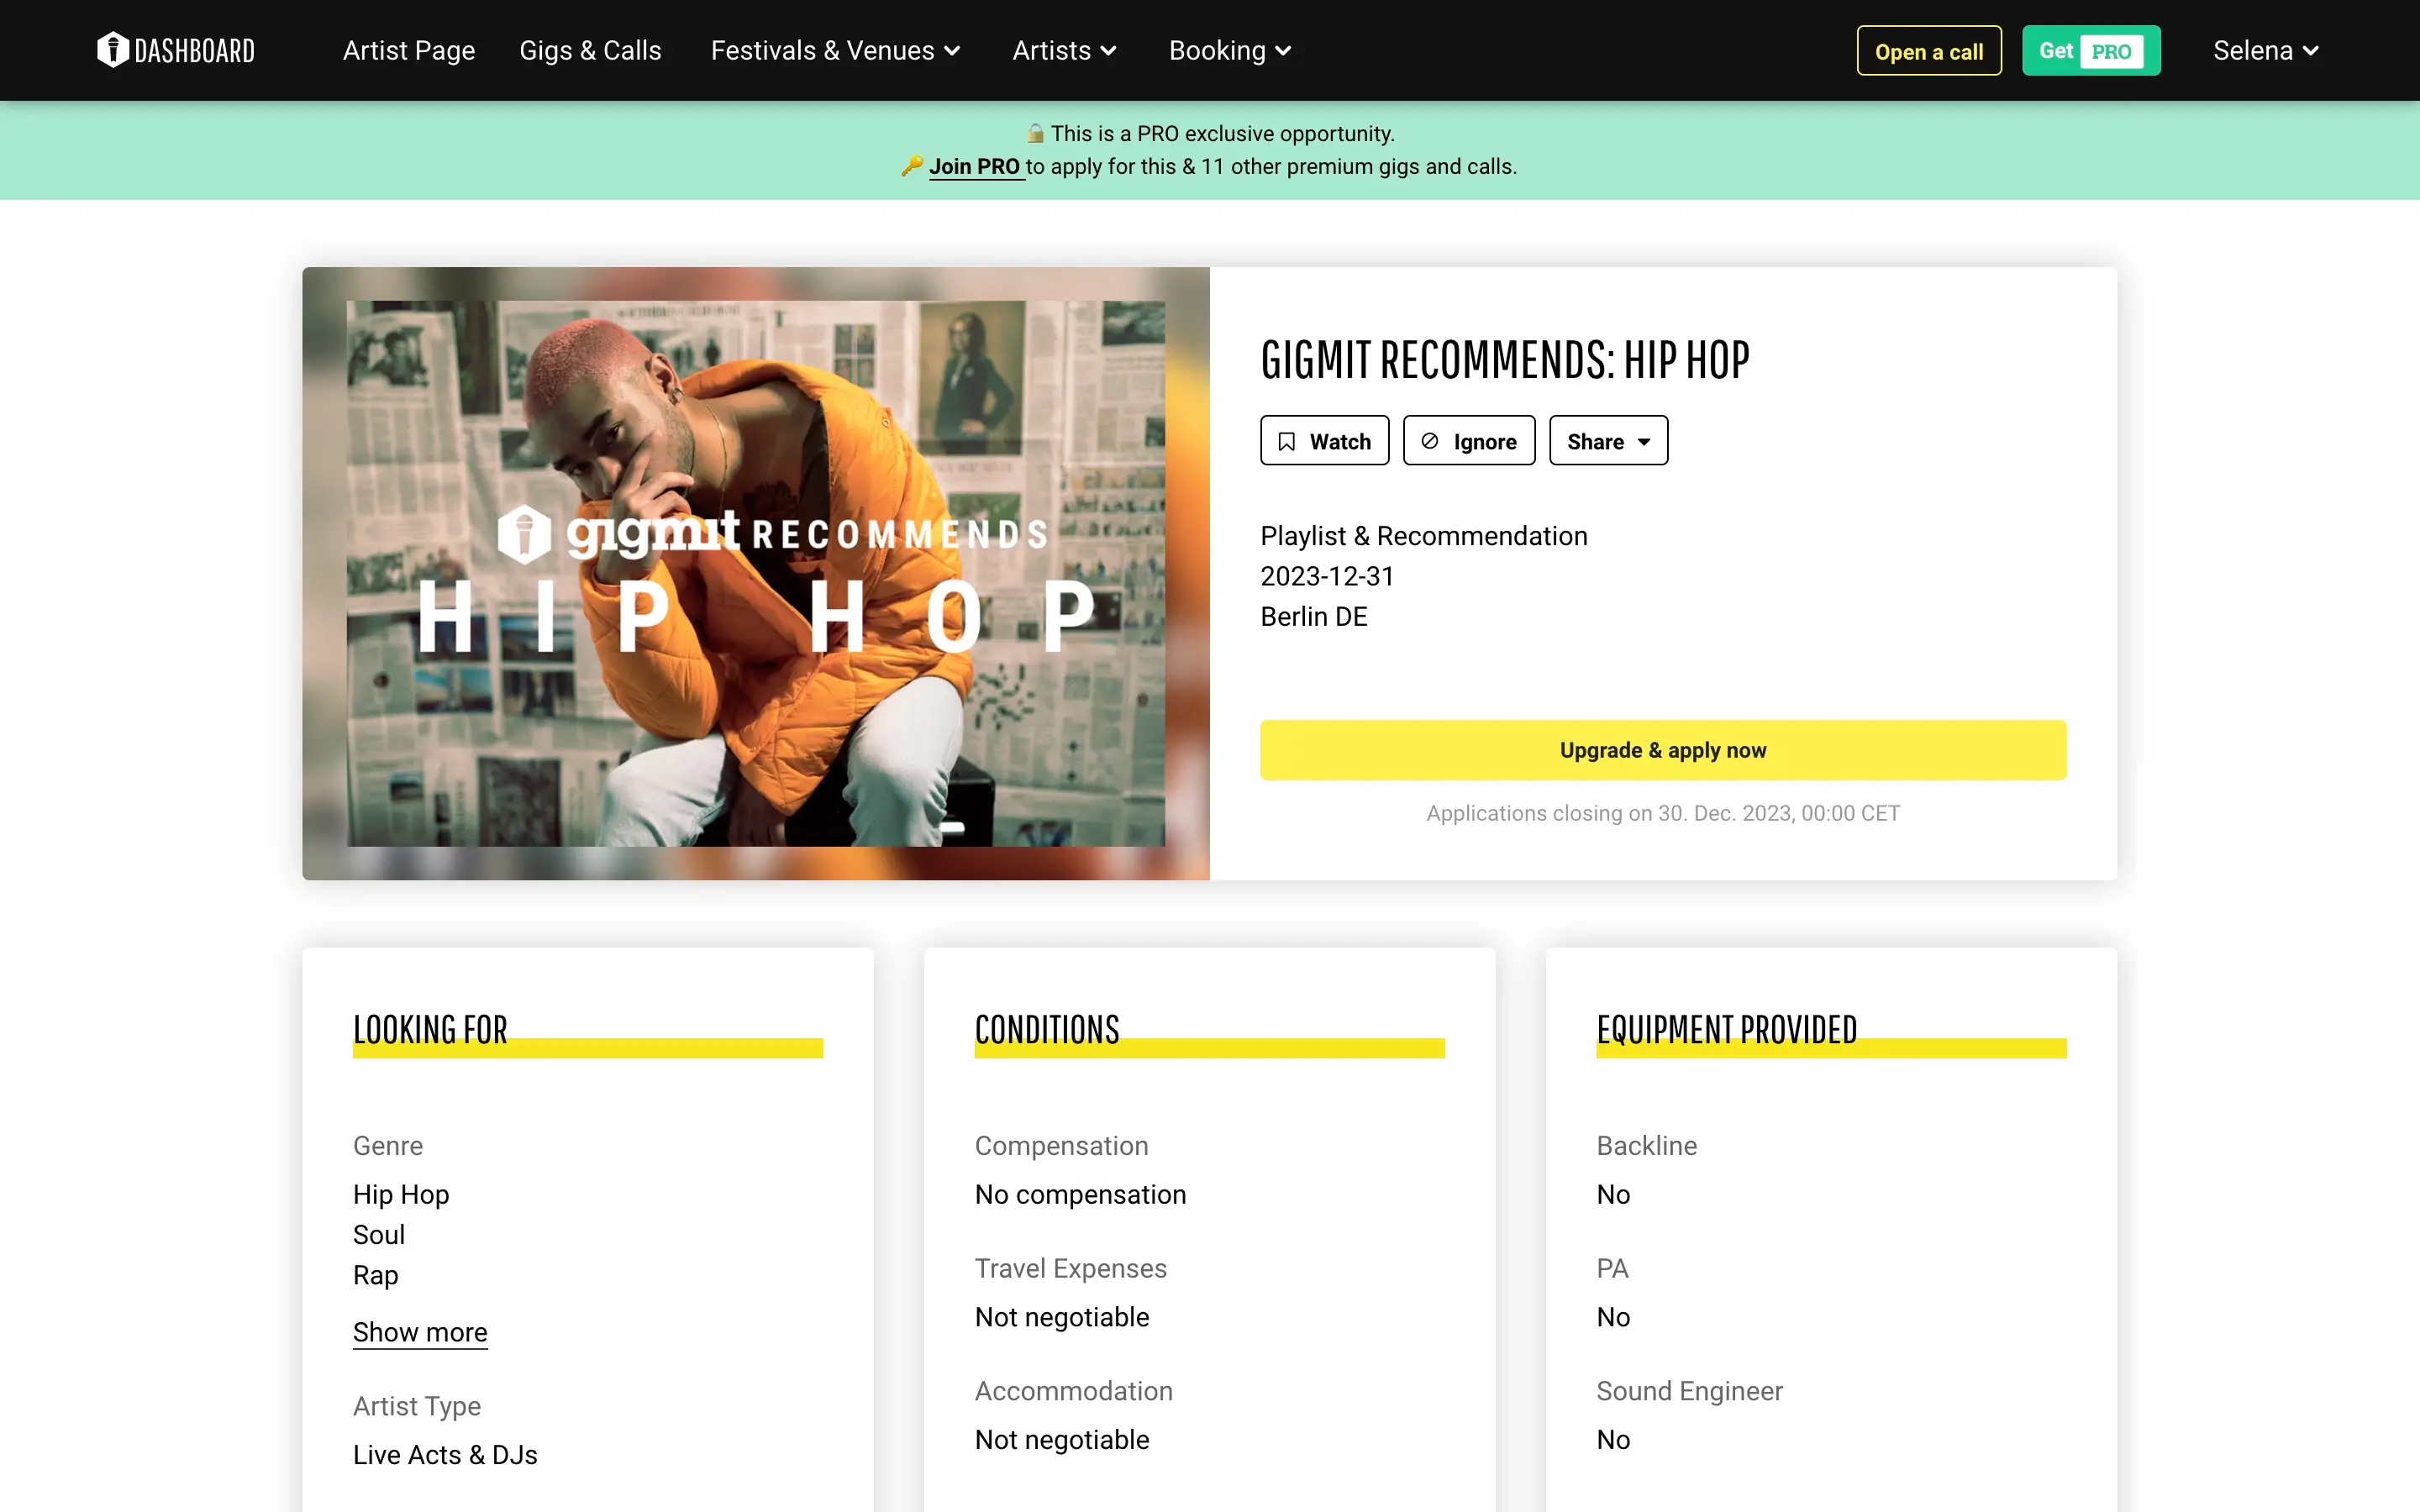
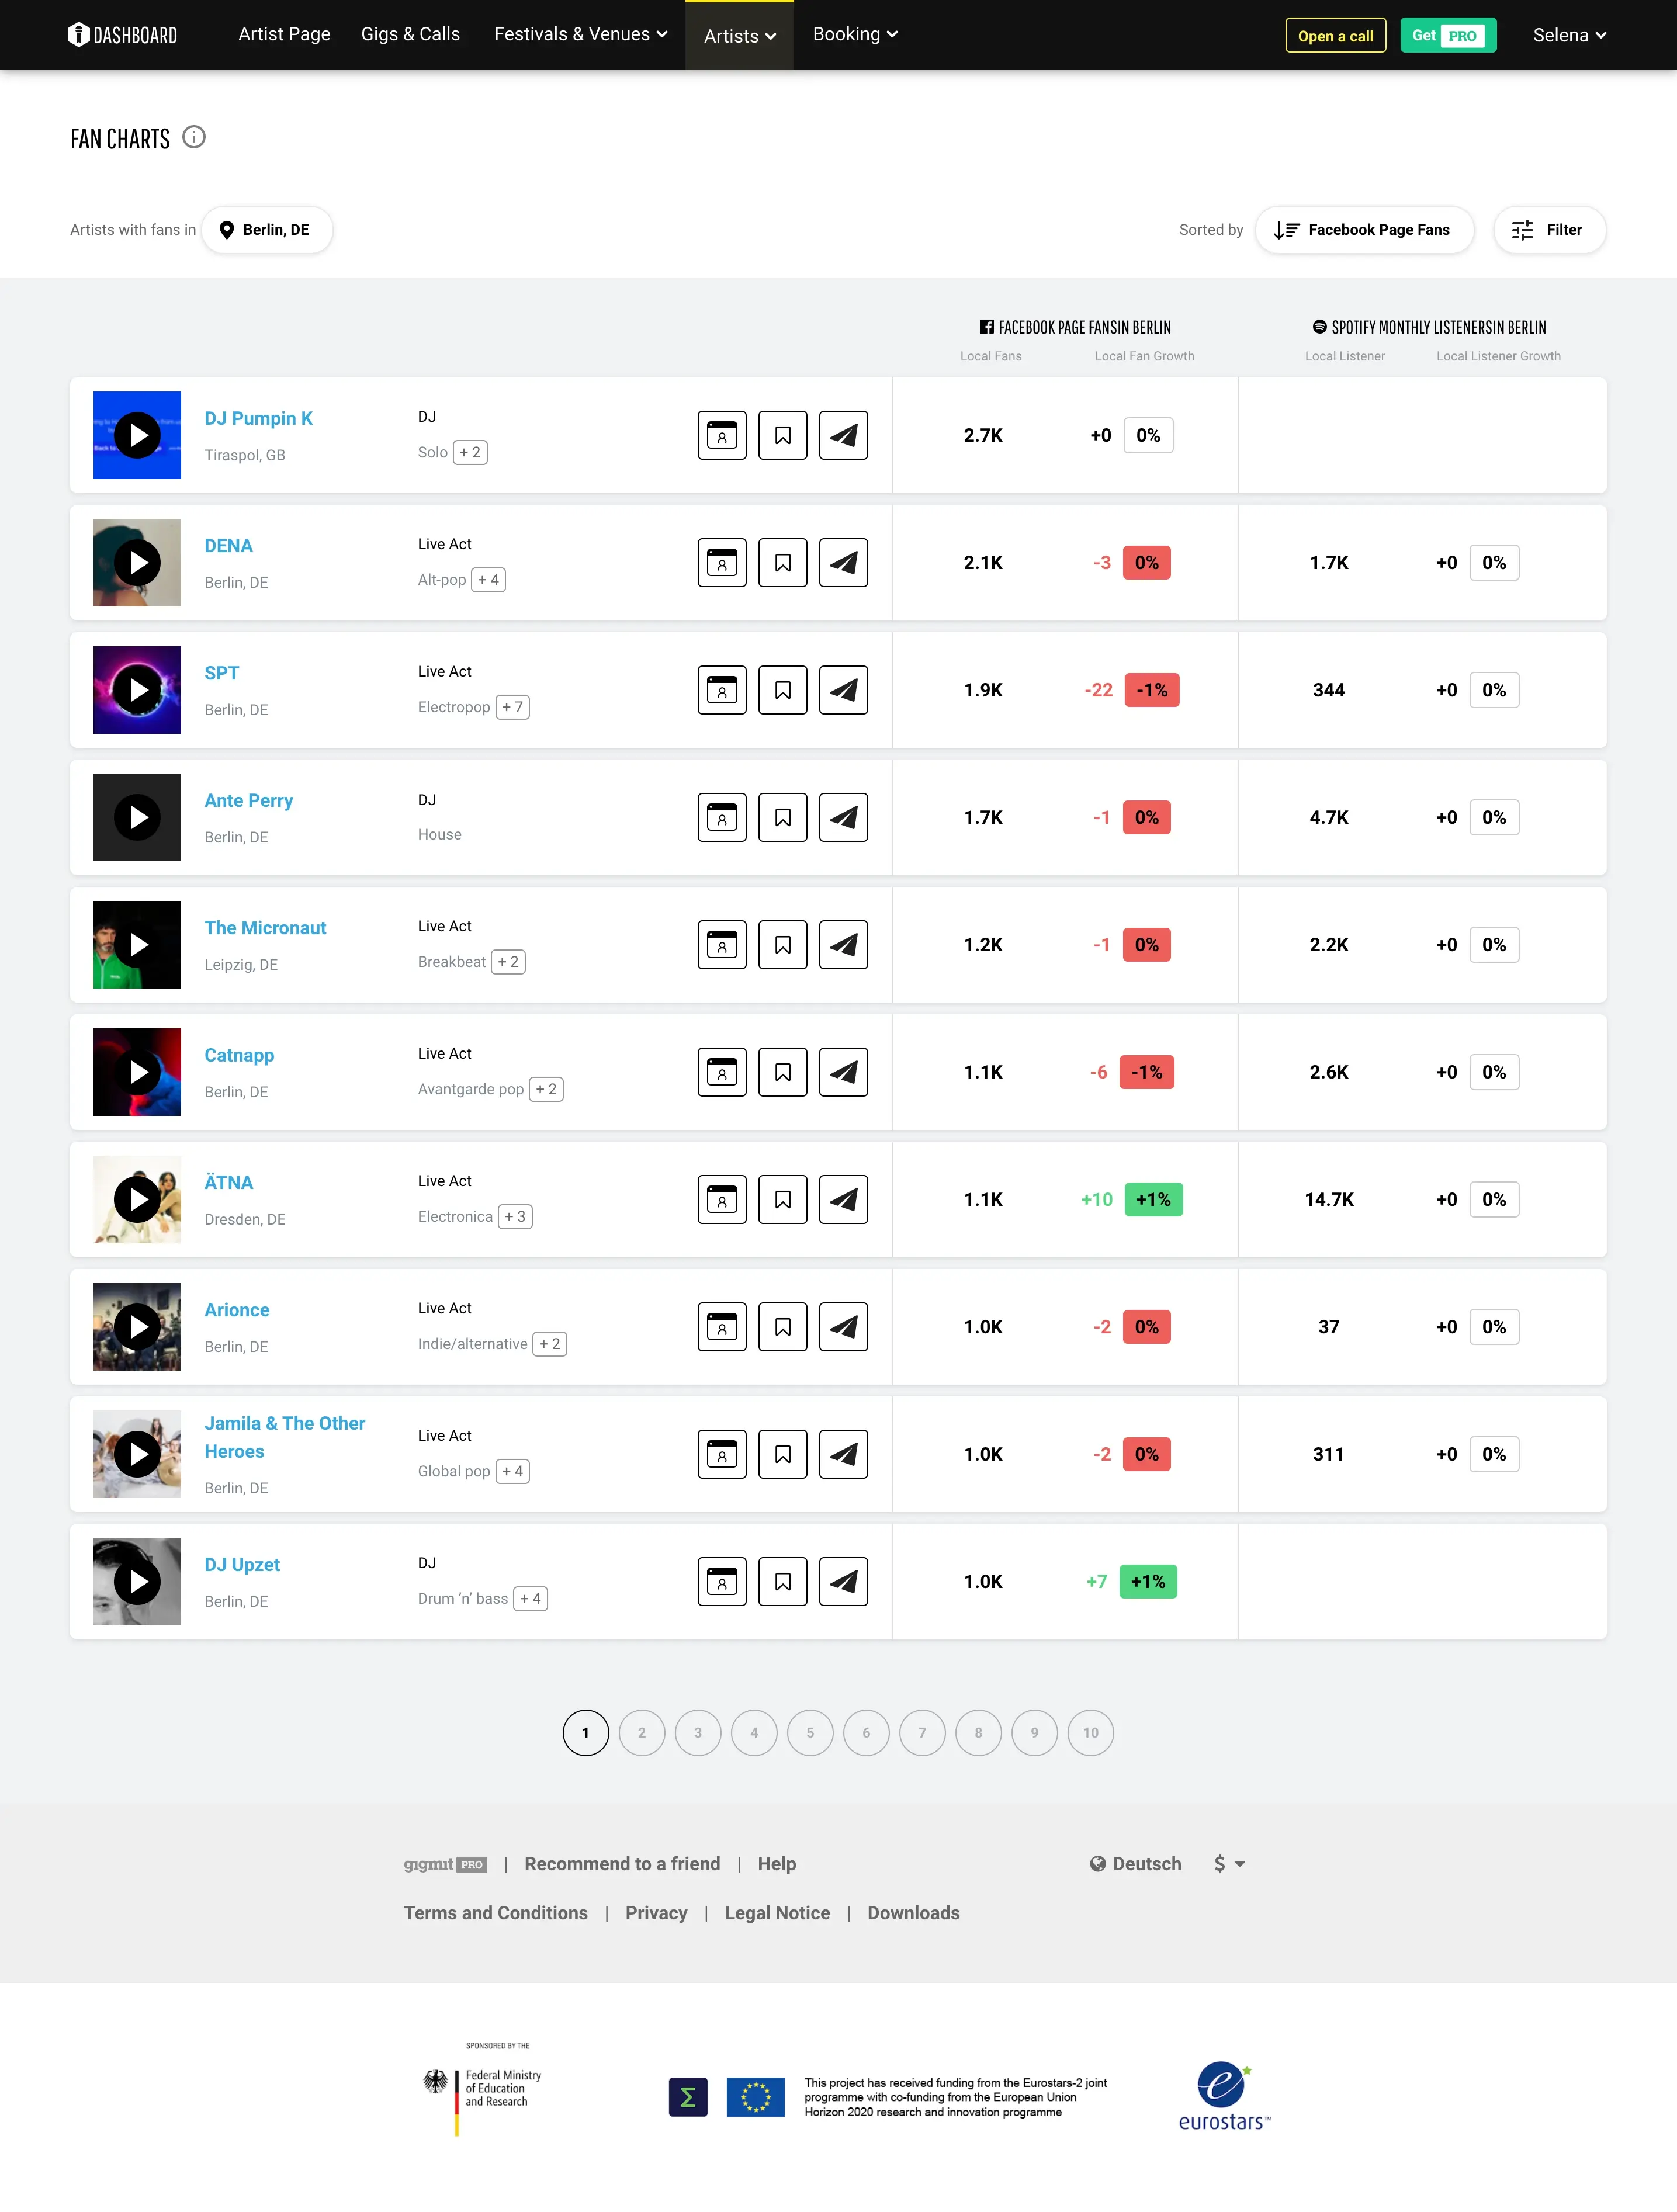
gigmit est un portail en ligne pour la réservation de concerts, aidant les artistes à réserver plus de concerts et les promoteurs à trouver des artistes appropriés. Il utilise des algorithmes basés sur les données pour faire correspondre parfaitement les artistes avec les concerts, festivals et autres événements, en fonction de leur genre, de leur lieu préféré et de leur public.
Tous les clientsExploitation de données
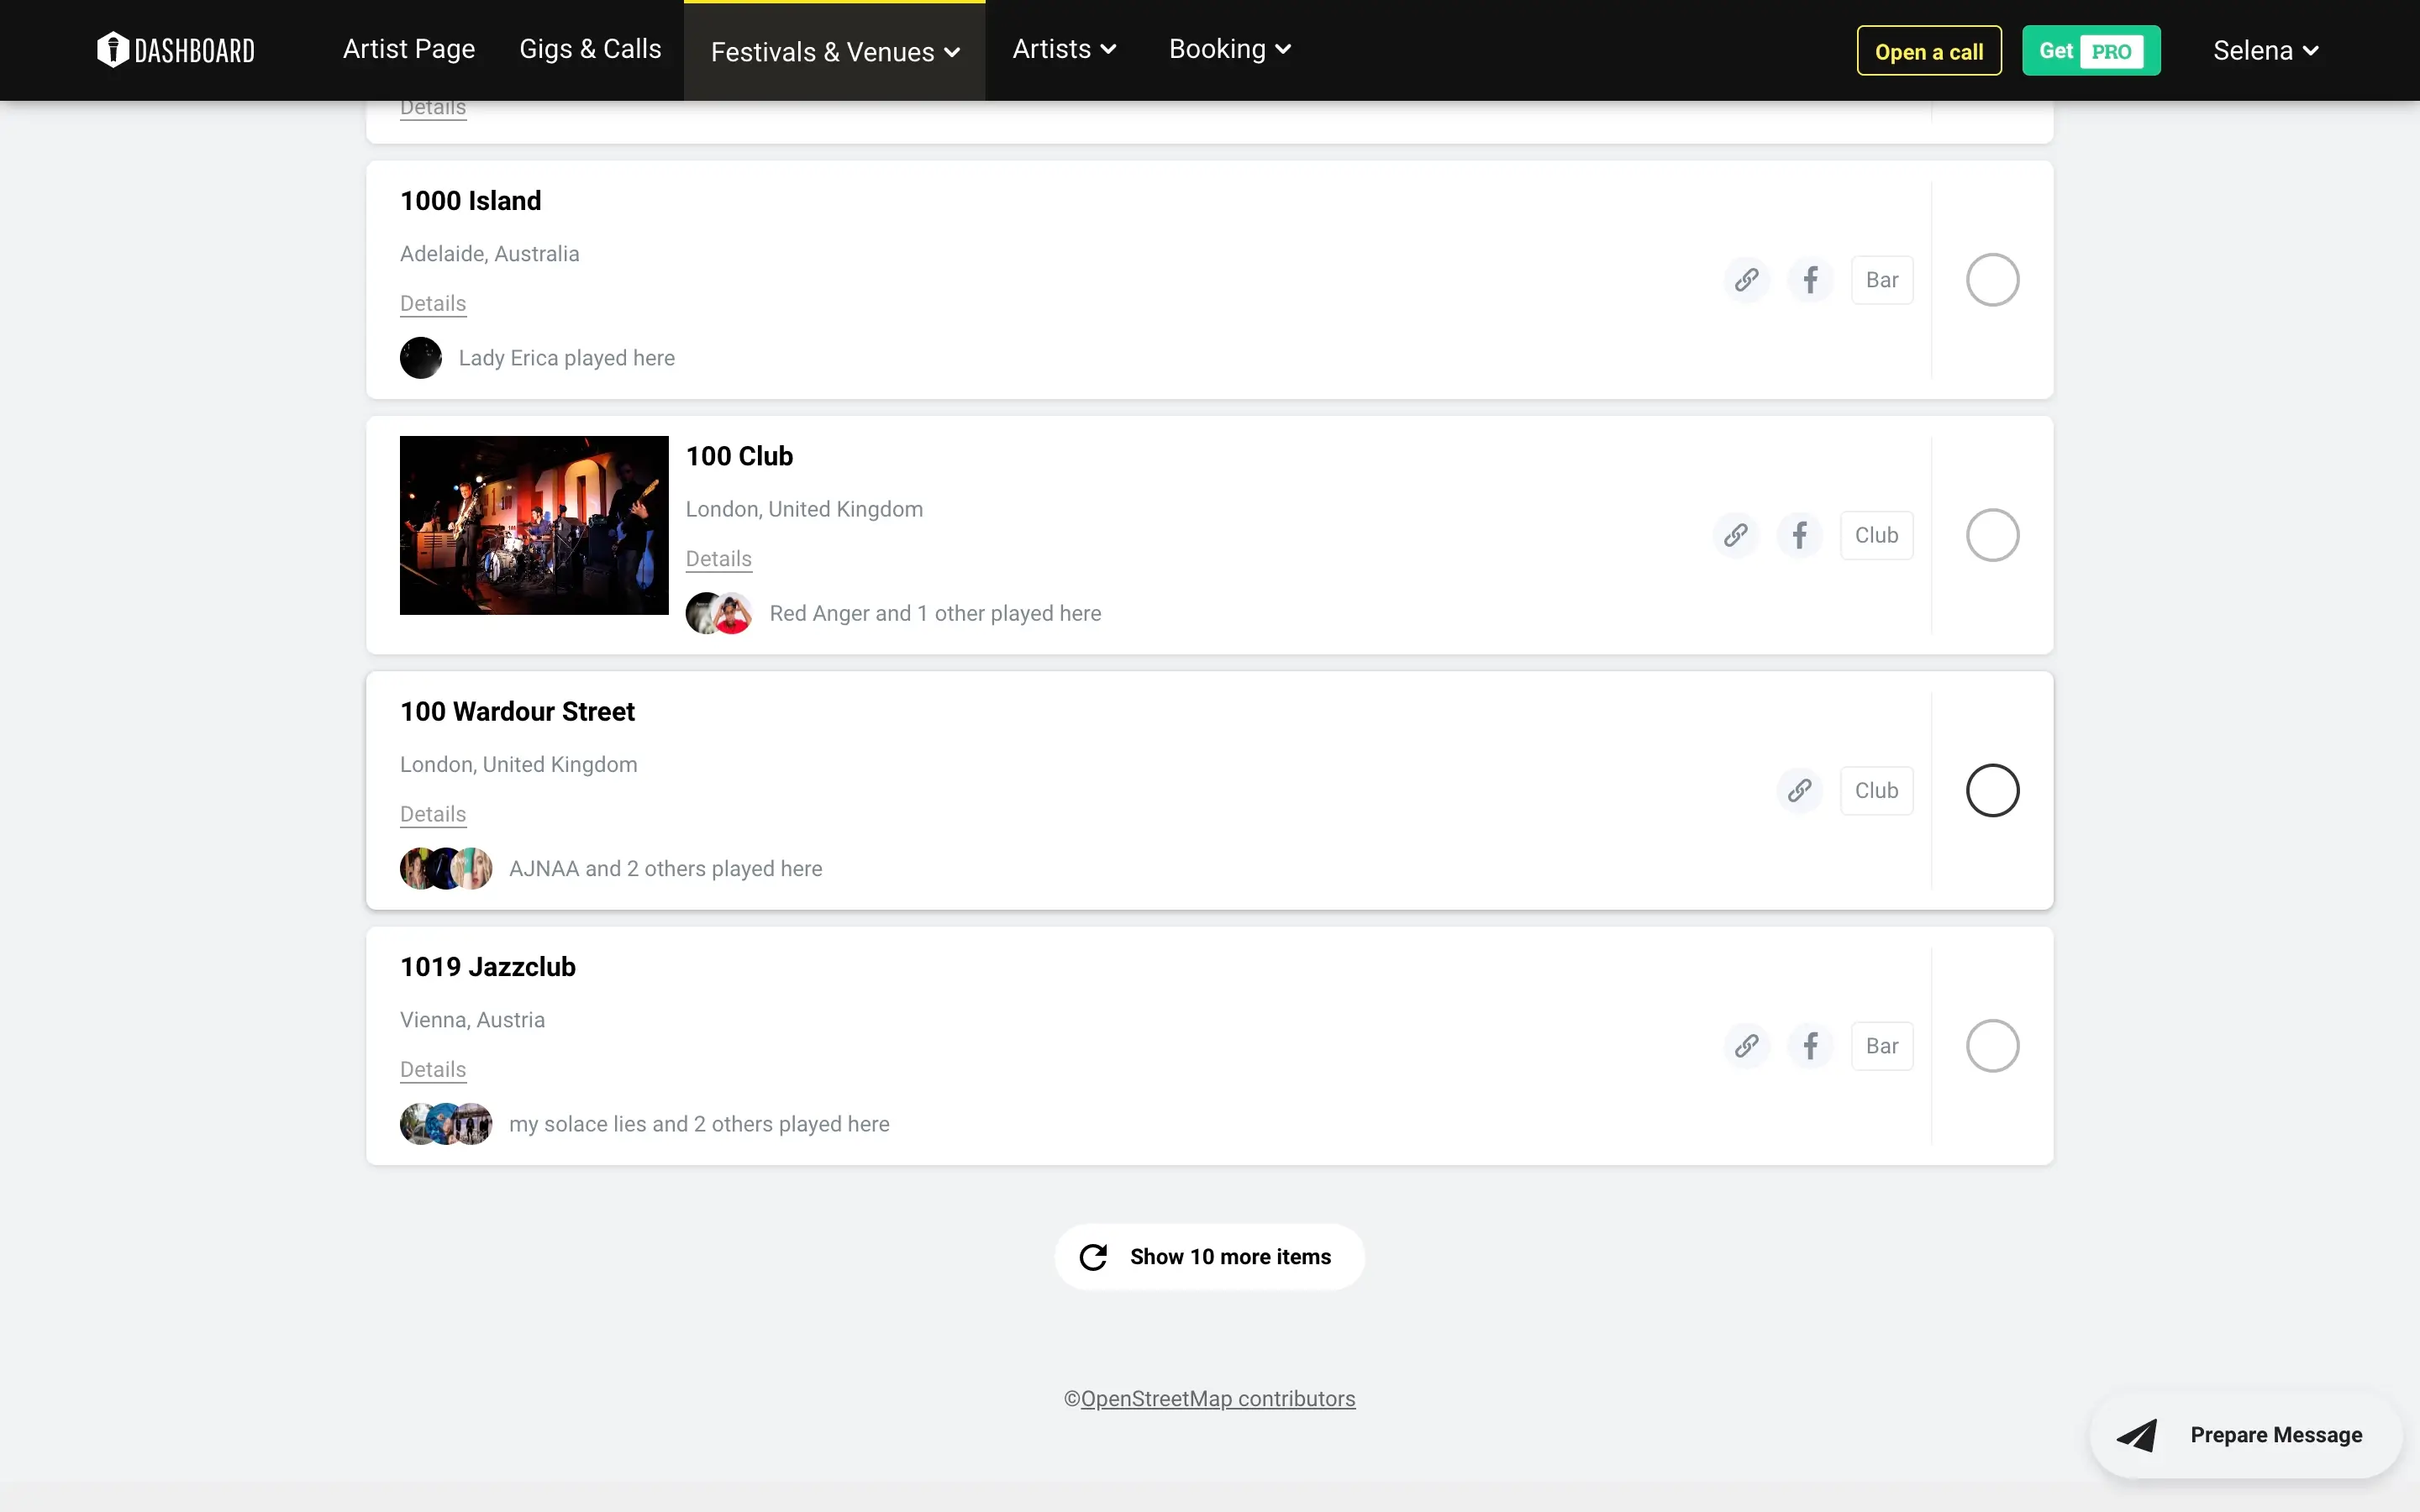
Nous avons aidé gigmit à élargir sa base de données avec de nouveaux festivals, lieux et les informations de contact et de localisation associées. Nous avons utilisé une combinaison de requêtes API et d'analyse HTML pour récupérer et organiser les données, en respectant strictement leurs exigences de structure de données.
En savoir plusMédias et divertissement
Nous avons aidé gigmit à poursuivre sa mission de rendre le secteur de la musique live accessible à tous. En les aidant à augmenter et enrichir leur base de données, nous avons offert à leurs utilisateurs un plus large choix d'opportunités, ce qui se traduit également par une confiance et une fidélité accrues des consommateurs.
En savoir plusDéfi
La nature de l’activité de notre client nécessite une récolte continue de données pour garantir aux utilisateurs finaux un choix toujours plus large d’options pertinentes et à jour. En termes simples, gigmit garantit que les artistes peuvent facilement trouver des festivals de musique, des foires, des spectacles ou des lieux d’événements spéciaux désirables et contacter les organisateurs.
Pour atteindre cet objectif, gigmit collecte des informations publiques provenant d’une pléthore de sites Web de musique et de divertissement dans une base de données unique. Avant notre partenariat, gigmit recueillait les données nécessaires à l’aide de Scrapy, un robot d’exploration Web open-source pour extraire des données avec des API et du web scraping généraliste.
Cependant, ils ont rencontré certaines limitations avec cet outil, ils se sont donc tournés vers Redwerk pour les aider à effectuer la collecte et l’analyse de données d’un certain nombre de ressources Web. Naturellement, on s’attendait à ce que nous le fassions d’une manière qui ne nuise pas au fonctionnement des ressources mentionnées et sans être bloqués. De plus, nous devions travailler sous contrainte de temps.
Solution
La première étape a consisté à évaluer la stratégie de web scraping existante et à sélectionner une nouvelle pile technologique qui présenterait moins de restrictions d’extraction et d’affichage de données.
Nous avons choisi Django REST pour construire des modèles de données et gérer les interactions avec la base de données. Ce framework nous a permis d’organiser et de gérer efficacement les données collectées.
Nous avons créé des files d’attente de tâches asynchrones avec Celery et RabbitMQ pour éviter de surcharger les serveurs avec des appels API. De cette façon, nous avons assuré que nos requêtes soient traitées de manière ordonnée et contrôlée.
Les informations de contact n’étaient que parfois facilement disponibles, nous avons donc exploité la puissance de Hunter.io, un localisateur d’e-mails basé sur l’IA.
Le plus grand défi a été de trouver l’équilibre entre la vitesse d’analyse et les limites des serveurs d’hébergement. Néanmoins, nous avons collecté éthiquement toutes les données nécessaires sans interruptions de service ni plaintes des administrateurs Web.
Résultat
Avec notre aide, gigmit a augmenté et enrichi sa base de données de festivals de musique, de lieux d’événements spéciaux, de pubs, de cinémas, de centres d’art, de théâtres, ainsi que les concerts et les coordonnées associées. Nous avons livré des données bien structurées dans des tables SQL et des fichiers XLSX, conformément aux exigences de structure de données. Le succès de gigmit en tant qu’entreprise repose sur des données à jour et pertinentes, et nous les avons aidés à les obtenir en temps voulu afin que leurs abonnés puissent voir toutes ces opportunités et postuler à des concerts appropriés.
Nous sommes fiers que gigmit s’étende aux États-Unis, et nous continuerons à les soutenir et à partager notre expertise technologique pour assurer leur croissance constante pour les années à venir.
Sous presse
Nous exploitons les données, et nous nous engageons à rendre ces données transparentes et accessibles. À un moment donné, nous serons en mesure de prédire à quel point un concert sera fréquenté à l'avenir.
Parmi les plateformes, gigmit fait le plus de vagues. Fondé en 2012, le site est une sorte de Tinder pour l'industrie musicale, réunissant des lieux et des artistes parfaitement assortis.
gigmit a été lancé sous le slogan « Réservation simple. Réservation simplement. » le 11 novembre 2012. Pour son dixième anniversaire, gigmit compte 225 000 utilisateurs dans plus de 120 pays.
Une solution numérique pourrait simplifier le monde de la musique live et aider les deux parties : donner aux promoteurs une vision plus filtrée et aider les artistes à voir où se trouvent les opportunités.
Besoin d'un outil fiable pour une récolte de données sûre ?
Parlez à des expertsTechnologies
 Django REST
 Celery
 Hunter.io
 PostgreSQL
Commentaire de l'équipe Redwerk
Oleksandr
Developer
J'ai utilisé un mélange de requêtes API et d'analyse de pages HTML pour collecter les données requises. J'ai appliqué des stratégies éprouvées pour éviter de surcharger les services à partir desquels les données étaient collectées. Ce projet a nécessité un peu de résolution de problèmes, mais une fois la pile technologique appropriée sélectionnée, tout est devenu très clair et simple.
Articles similaires dans le blog
Comment parcourir un site web protégé : analyse approfondie
Les web crawlers sont des programmes destinés au téléchargement et au traitement en masse de contenu Internet. Ils sont aussi souvent appelés « robots d’indexation », « spiders » ou simplement « bots ». Dans leur essence, un crawler effectue les mêmes actions qu’un navigateur web...
En savoir plus
Comment choisir la pile technologique adaptée à votre projet
Le développement logiciel est une affaire complexe. Chaque projet est avant tout un concept et les personnes qui lui donnent vie. Les délais, les ressources et, bien sûr, les technologies, sont généralement définis par la suite. Mais cela n’implique pas que le choix des technolog...
En savoir plusImpressionné ?
Engagez-nousAutres études de cas
Orderstep
A contribué à augmenter le revenu d'abonnement en développant un module de boutique en ligne premium
CDP Blitz
Base de données optimisée et fonctionnalités améliorées pour un annuaire médiatique hébergeant plus de 35 000 contacts
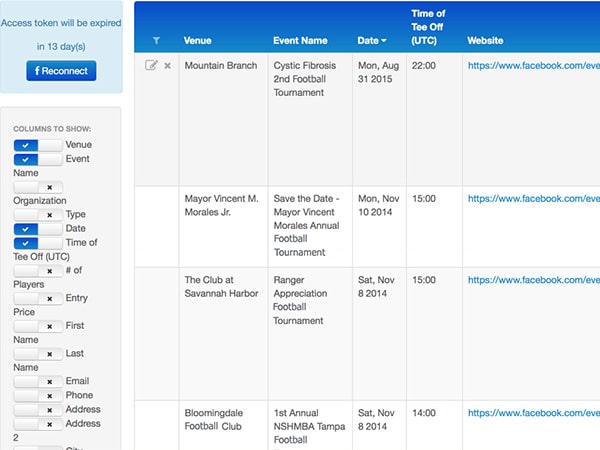
Sports Events Crawler
Automatisation des recherches manuelles fastidieuses d'événements sportifs grâce à un web crawler basé sur l'API de Facebook et une agrégation de données robuste.