Votre site semble lent, et vous devez prendre une décision. Vous pouvez continuer à deviner les corrections à apporter, ou découvrir ce qui vous coûte réellement des conversions avant de consacrer un sprint à la mauvaise piste.
Un audit de performance web est un diagnostic structuré de ce qui rend un site web lent. Il mesure l’expérience réelle des utilisateurs, la réponse du serveur, le poids des ressources et la charge des scripts tiers, puis classe chaque goulot d’étranglement selon son impact sur la vitesse et le chiffre d’affaires. Le résultat est une liste courte et ordonnée indiquant où investir des heures d’ingénierie, et où ne pas le faire.
Les enjeux sont mesurables. Un benchmark 2025 sur la performance des sites web de distribution portant sur les cinquante plus grands distributeurs au monde a révélé qu’un distributeur générant plus de 50 milliards de dollars par an met 9,4 secondes à charger sa page d’accueil, et perdrait potentiellement entre 3,4 et 24,1 milliards de dollars par an en conversions manquées à cause de cela. La vitesse, c’est de l’argent qui circule dans votre tunnel de conversion, et une page lente en laisse fuir un peu chaque jour, silencieusement.
Pourquoi la plupart des audits de performance web s'arrêtent au tableau de bord
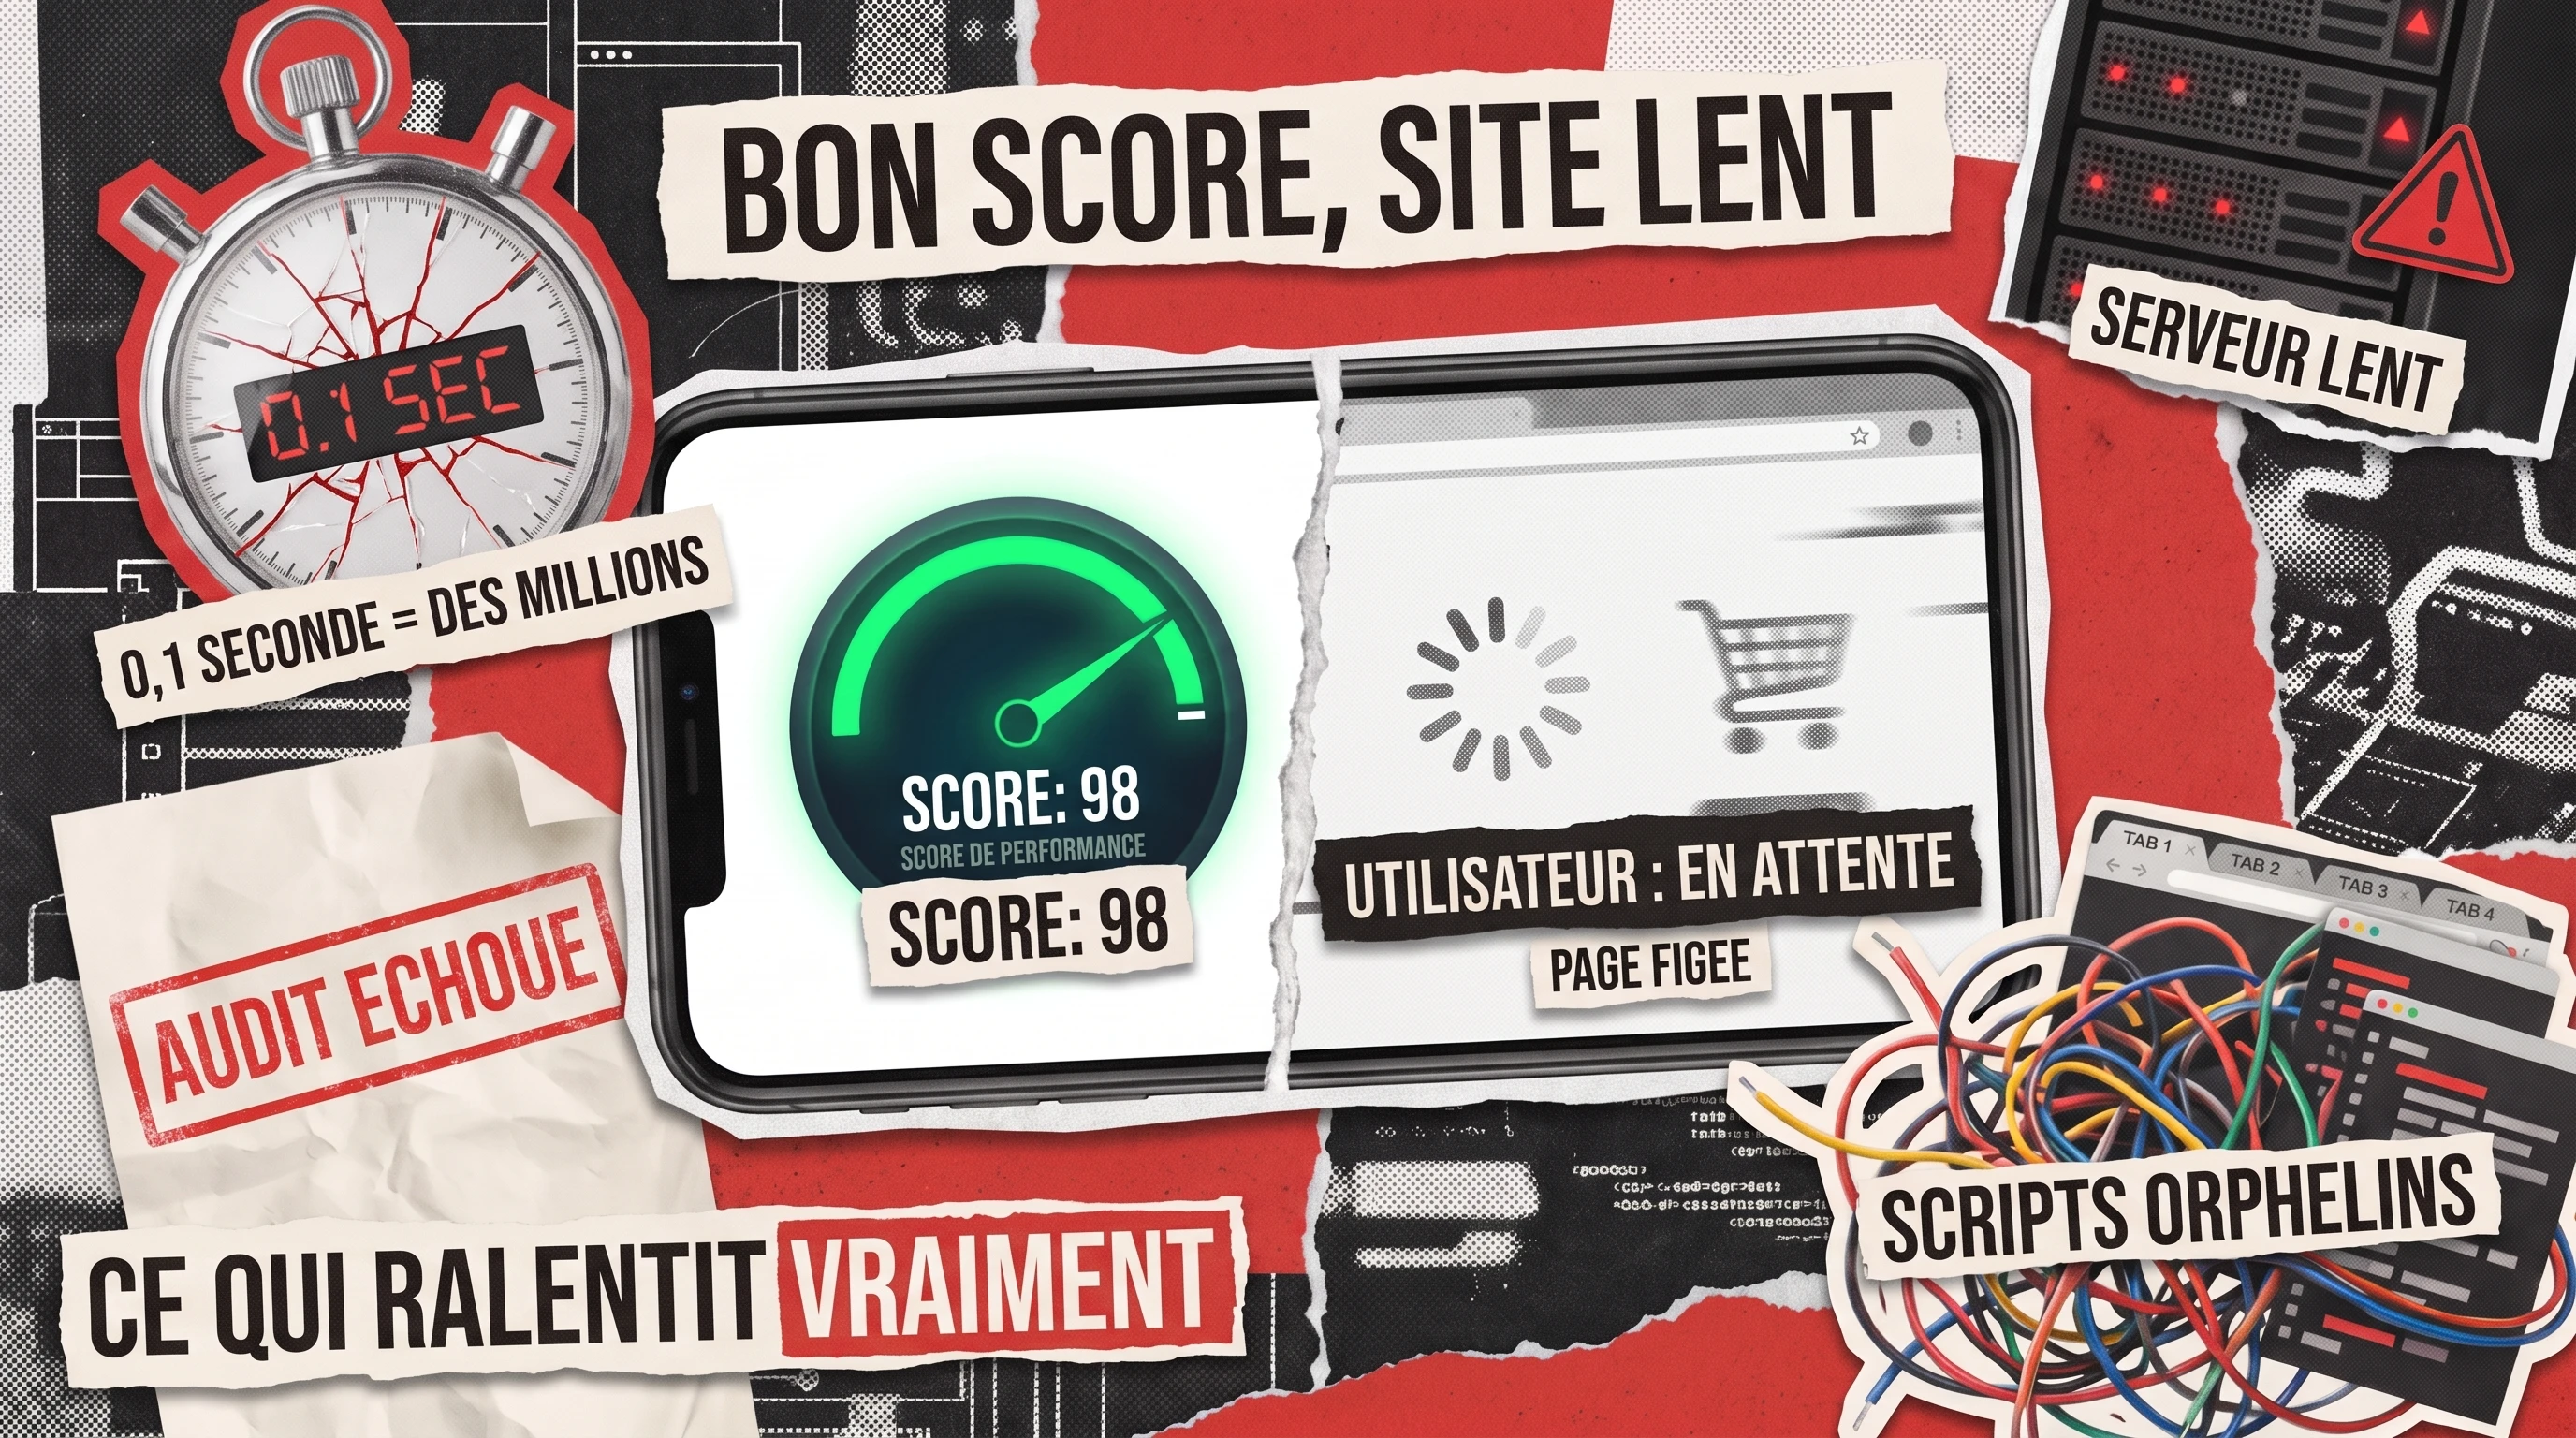
La plupart des équipes utilisent un outil gratuit, voient un chiffre au vert, et passent à autre chose. C’est précisément à ce chiffre vert que le vrai travail devrait commencer. Un score Lighthouse élevé mesure un seul chargement simulé sur une machine rapide dans un centre de données, ce qui correspond rarement au téléphone que votre client tient en main avec une connexion mobile lente.
L’écart entre les deux apparaît dans les données. Selon le HTTP Archive Web Almanac 2025, seulement 48 % des origines mobiles réussissent les trois Core Web Vitals, contre 56 % sur ordinateur de bureau, et la vitesse de chargement est la métrique que les sites échouent le plus souvent. Un score de laboratoire impeccable peut coexister avec des données de terrain qui racontent une tout autre histoire, ce qui explique comment un audit qui s’arrête au tableau de bord peut tout de même livrer un site lent.
Nous observons ce schéma constamment lorsque nous reprenons un projet à l’arrêt. L’équipe précédente a optimisé pour l’outil, ajusté la page d’accueil pour la présentation, et laissé intacts le tunnel de paiement, le tableau de bord des utilisateurs connectés et le mobile. Un audit qui mérite d’être mené examine les parcours qui génèrent du chiffre d’affaires, sur les appareils que vos utilisateurs possèdent réellement.
Ce que vérifie un audit de performance de site
Un audit approfondi fonctionne par couches, des symptômes ressentis par vos utilisateurs jusqu’aux systèmes qui les produisent. Chaque couche répond à une question différente, et en sauter une conduit les équipes à optimiser quelque chose qui n’a jamais été la véritable contrainte. Les trois domaines ci-dessous sont ceux où se cache presque tout goulot d’étranglement réel.
Les Core Web Vitals, les symptômes visibles par l'utilisateur
Les Core Web Vitals sont les trois métriques de terrain de Google qui indiquent le ressenti d’une page pour une personne réelle. Le Largest Contentful Paint (LCP) mesure le chargement, et Google considère qu’une valeur de 2,5 secondes ou moins est bonne. L’Interaction to Next Paint (INP) mesure la réactivité, avec un objectif de 200 millisecondes. Le Cumulative Layout Shift (CLS) mesure la stabilité visuelle, et un contenu qui se déplace pendant le chargement de la page obtient un mauvais score.
Ce sont des symptômes plutôt que des causes, et cette distinction change la façon de les interpréter. Un mauvais LCP indique que la page semble lente à charger, mais à lui seul il ne dira pas si le coupable est une image principale trop lourde, un serveur lent ou un script bloquant le rendu. Dans les données de terrain de 2025, le LCP est la métrique que les sites mobiles échouent le plus souvent, donc c’est généralement par la vitesse de chargement qu’un bon audit commence à creuser.

Réponse du serveur et poids des ressources
Avant qu’un navigateur puisse afficher quoi que ce soit, il doit recevoir une réponse de votre serveur. Le Time to First Byte (TTFB) capture cette attente, et un TTFB lent contamine toutes les métriques en aval, car rien d’autre ne peut commencer avant l’arrivée du premier octet. Les causes courantes incluent des requêtes de base de données non indexées, une origine sans couche de cache, et un serveur situé dans une région alors que vos utilisateurs se trouvent dans une autre.
Le poids des ressources constitue l’autre moitié de cette couche. Les images surdimensionnées, les polices non compressées et les mégaoctets de JavaScript doivent tous transiter par une connexion mobile avant que la page ne devienne utilisable. Lorsque l’attente remonte à l’hébergement, à la capacité ou à la configuration plutôt qu’au code, une revue front-end se transforme en audit d’infrastructure informatique, qui examine les serveurs, les pipelines et les dépenses cloud sous-jacents au site.
Ressources bloquant le rendu et scripts tiers
Même avec un serveur rapide et des ressources légères, une page peut se bloquer parce que le navigateur a reçu l’ordre d’attendre. Le CSS et le JavaScript bloquant le rendu obligent le navigateur à télécharger et à traiter des fichiers avant d’afficher quoi que ce soit, si bien qu’une seule feuille de style volumineuse ou un script synchrone dans l’en-tête du document peut figer une page par ailleurs rapide. Le remède consiste généralement à différer, diviser ou intégrer en ligne uniquement ce dont la première vue a réellement besoin.
Les scripts tiers sont le coupable le plus discret. Les balises analytiques, les widgets de chat, les outils de tests A/B et les pixels publicitaires ouvrent chacun des connexions et exécutent du code que vous ne contrôlez pas, et ils ont tendance à s’accumuler parce que personne n’est responsable de leur suppression. Une équipe de développement web sur mesure rigoureuse peut souvent regagner une seconde ou plus simplement en vérifiant quelles balises méritent encore leur place et en chargeant le reste de façon asynchrone.
Comment auditer la performance d'un site web
Savoir comment auditer un site web revient à appliquer une méthode reproductible plutôt qu’un outil préféré. L’objectif est de mesurer honnêtement, de retracer chaque métrique lente jusqu’à sa cause première, et de prouver que la correction a fonctionné avant de la considérer comme terminée. Les deux étapes ci-dessous transforment un tas de chiffres en un plan que vous pouvez remettre à une équipe d’ingénierie.
Mesurer avec des données de laboratoire et de terrain
Les données de laboratoire proviennent d’un test contrôlé, comme Lighthouse ou WebPageTest exécutant une page dans des conditions fixes. Elles sont reproductibles et très utiles pour le débogage, car vous pouvez modifier un seul élément et relancer le même test. Le hic, c’est qu’elles ne représentent qu’une seule machine sur une seule connexion, si bien qu’un score de laboratoire pris isolément peut vous induire en erreur.
Les données de terrain proviennent d’utilisateurs réels, collectées via le Chrome User Experience Report ou votre propre système de suivi des utilisateurs réels. Elles capturent toute la diversité des appareils, réseaux et emplacements de votre audience, y compris les plus lents. Un audit crédible croise les deux, en utilisant les données de terrain pour décider de ce qui compte et les données de laboratoire pour comprendre pourquoi.
Retracer, prioriser, vérifier
Une fois que vous avez des chiffres, le travail devient une enquête méthodique. Chaque métrique lente est retracée jusqu’à une cause concrète, classée selon son impact, puis confirmée après la modification. En pratique, cela ressemble à ceci :
- Retracer. Ouvrez la trace de performance du navigateur et suivez la métrique lente jusqu’à sa source, qu’il s’agisse d’une longue attente serveur, d’un script lourd ou d’une image qui se charge tardivement.
- Prioriser. Classez les corrections selon leur impact utilisateur rapporté à l’effort d’ingénierie, de sorte qu’un en-tête de cache d’une seule ligne qui économise 400 millisecondes l’emporte sur une refactorisation de deux semaines qui n’en économise que 50.
- Vérifier. Déployez la correction, puis remesurez sur le terrain durant les semaines suivantes, car une modification qui brille en laboratoire peut ne rien apporter aux utilisateurs réels.
C’est dans cette boucle qu’un audit honnête fait ses preuves. Il remplace l’opinion par des données probantes et empêche une équipe de brûler ses meilleures heures sur une modification qui semblait importante mais n’a fait bouger aucune métrique.
Les coupables habituels et leurs corrections
Après suffisamment d’audits, les mêmes coupables reviennent sans cesse. Le tableau ci-dessous associe les causes que nous rencontrons le plus souvent à la correction qui les résout généralement, ainsi qu’à la métrique que chacune tend à ruiner. C’est un moyen rapide de reconnaître votre propre site dans la liste avant qu’une seule ligne de code ne change.
Images non optimisées
LCP, poids total de la page
Servir des formats modernes comme WebP ou AVIF, redimensionner à la taille d’affichage, charger en différé tout ce qui se trouve sous la ligne de flottaison
JavaScript bloquant le rendu
LCP, INP
Différer ou diviser les scripts, n’intégrer en ligne que le code critique, supprimer les bundles inutilisés
Absence de cache ou de CDN
TTFB, vitesse lors des visites répétées
Ajouter un cache navigateur et un cache en périphérie, servir les ressources statiques via un CDN proche des utilisateurs
Trop de scripts tiers
INP, chargement total
Auditer chaque balise, supprimer celles qui sont inutilisées, charger le reste de façon asynchrone
Requêtes de base de données lentes
TTFB
Ajouter des index, mettre en cache les requêtes coûteuses, corriger les schémas de requêtes N+1
Décalage de mise en page dû à des ressources tardives
CLS
Réserver de l’espace pour les images et les publicités, précharger les polices, cesser d’insérer du contenu au-dessus d’un contenu existant
Un schéma se dégage de ces corrections. La majeure partie de la vitesse qu’un site ordinaire perd est récupérée en réduisant le poids et en attendant moins, avant même que quiconque ne réécrive l’application. L’audit existe pour vous indiquer laquelle de ces lignes vous coûte réellement quelque chose, afin que vous corrigiez par ordre d’impact plutôt que de suivre une liste de vérification générique.
Quand le goulot d'étranglement se situe sous le front-end
Parfois, le front-end est innocent. Vous compressez chaque image, différez chaque script, et le site reste lent, ce qui est le signal que la contrainte se situe plus profondément dans la pile technique. C’est la couche que les équipes préfèrent le plus éviter d’ouvrir, car les corrections coûtent plus cher qu’un en-tête de cache.
Sous le front-end, les suspects habituels sont une base de données surchargée, un monolithe incapable de s’adapter horizontalement, des appels synchrones à des services lents, et une architecture qui convenait au trafic du lancement mais qui plie sous une charge réelle. Ce sont des questions de conception plutôt que d’optimisation, et ce sont les mêmes que nous traitons lorsque nous concevons une architecture logicielle évolutive pour un produit en croissance. Un test de charge qui simule un pic de trafic les révèle généralement plus vite que n’importe quel score sur une seule page.
Lorsque les preuves pointent aussi profondément, la correction relève de l’architecture, et la prochaine étape appropriée est un audit de développement logiciel plus large qui examine ensemble le code source, le modèle de données et l’infrastructure, afin de résoudre la cause une seule fois plutôt que de traiter le symptôme chaque trimestre. La franchise permet ici d’économiser de l’argent, car réécrire une requête coûte peu cher, tandis que reconstruire une plateforme sous une charge d’urgence coûte cher.
Des symptômes aujourd'hui, des systèmes demain
Un problème de performance que vous corrigez aujourd’hui est une question de systèmes à laquelle vous répondez pour demain. Chaque constat est aussi un signal sur la façon dont votre produit est construit et sur les points où il subira des tensions à mesure que vous grandirez. Les équipes qui traitent la vitesse comme une pratique récurrente, plutôt que comme un nettoyage ponctuel avant le lancement, maintiennent leurs sites rapides à mesure que le trafic et les fonctionnalités s’accumulent.
La démarche pratique consiste à réaliser un audit avant de supposer que vous avez besoin d’une refonte, et à le refaire après chaque publication majeure. Mesurez ce que ressentent vos utilisateurs réels, retracez chaque métrique lente jusqu’à sa cause, et corrigez par ordre d’impact. Cette habitude transforme la performance d’un incendie que vous combattez en un atout que vous maîtrisez.
Si votre site semble lent et que vous souhaitez qu’une équipe expérimentée trouve la véritable cause avant que vous ne passiez tout un trimestre à deviner, contactez-nous et nous vous aiderons à interpréter les chiffres et à corriger ce qui compte vraiment.
FAQ
Que comprend un audit de performance web ?
Un audit de performance couvre quatre couches : les métriques de terrain des utilisateurs réels comme les Core Web Vitals, le temps de réponse du serveur, le poids et la livraison des ressources, et les scripts tiers. Un audit approfondi effectue également des tests de charge sur le backend et examine l’architecture, avant de vous remettre une liste priorisée de corrections classées selon leur impact sur la vitesse et le chiffre d’affaires.
Combien de temps dure un audit de performance de site web ?
Pour un site de taille moyenne typique, un examen ciblé prend de trois à cinq jours ouvrés : un jour ou deux pour rassembler les données de laboratoire et de terrain, quelques jours pour retracer les causes premières, et une session pour prioriser les corrections. Des tests de charge approfondis sur le backend ou l’architecture peuvent ajouter une à deux semaines.
À quelle fréquence faut-il réaliser un audit de performance ?
Réalisez un audit complet au moins une à deux fois par an, ainsi qu’une vérification plus légère après chaque publication majeure, refonte ou nouvelle intégration tierce. Un suivi continu des utilisateurs réels entre-temps détecte les régressions tôt, afin qu’une page lente ne vous surprenne jamais pendant votre semaine la plus chargée.
Pourquoi mon site est-il lent si mon score Lighthouse est élevé ?
Un score Lighthouse élevé reflète un seul chargement simulé sur une machine rapide, alors que vos visiteurs utilisent de vrais téléphones et de vrais réseaux, si bien que leurs données de terrain semblent souvent moins bonnes. Des serveurs lents, des scripts tiers lourds et des pages réservées aux utilisateurs connectés que Lighthouse ne teste jamais expliquent généralement ce désaccord.
Découvrez comment nous avons aidé Recruit Media à construire un SaaS de recrutement acquis par une société cotée au Nasdaq avec une capitalisation boursière de plus de 250 millions