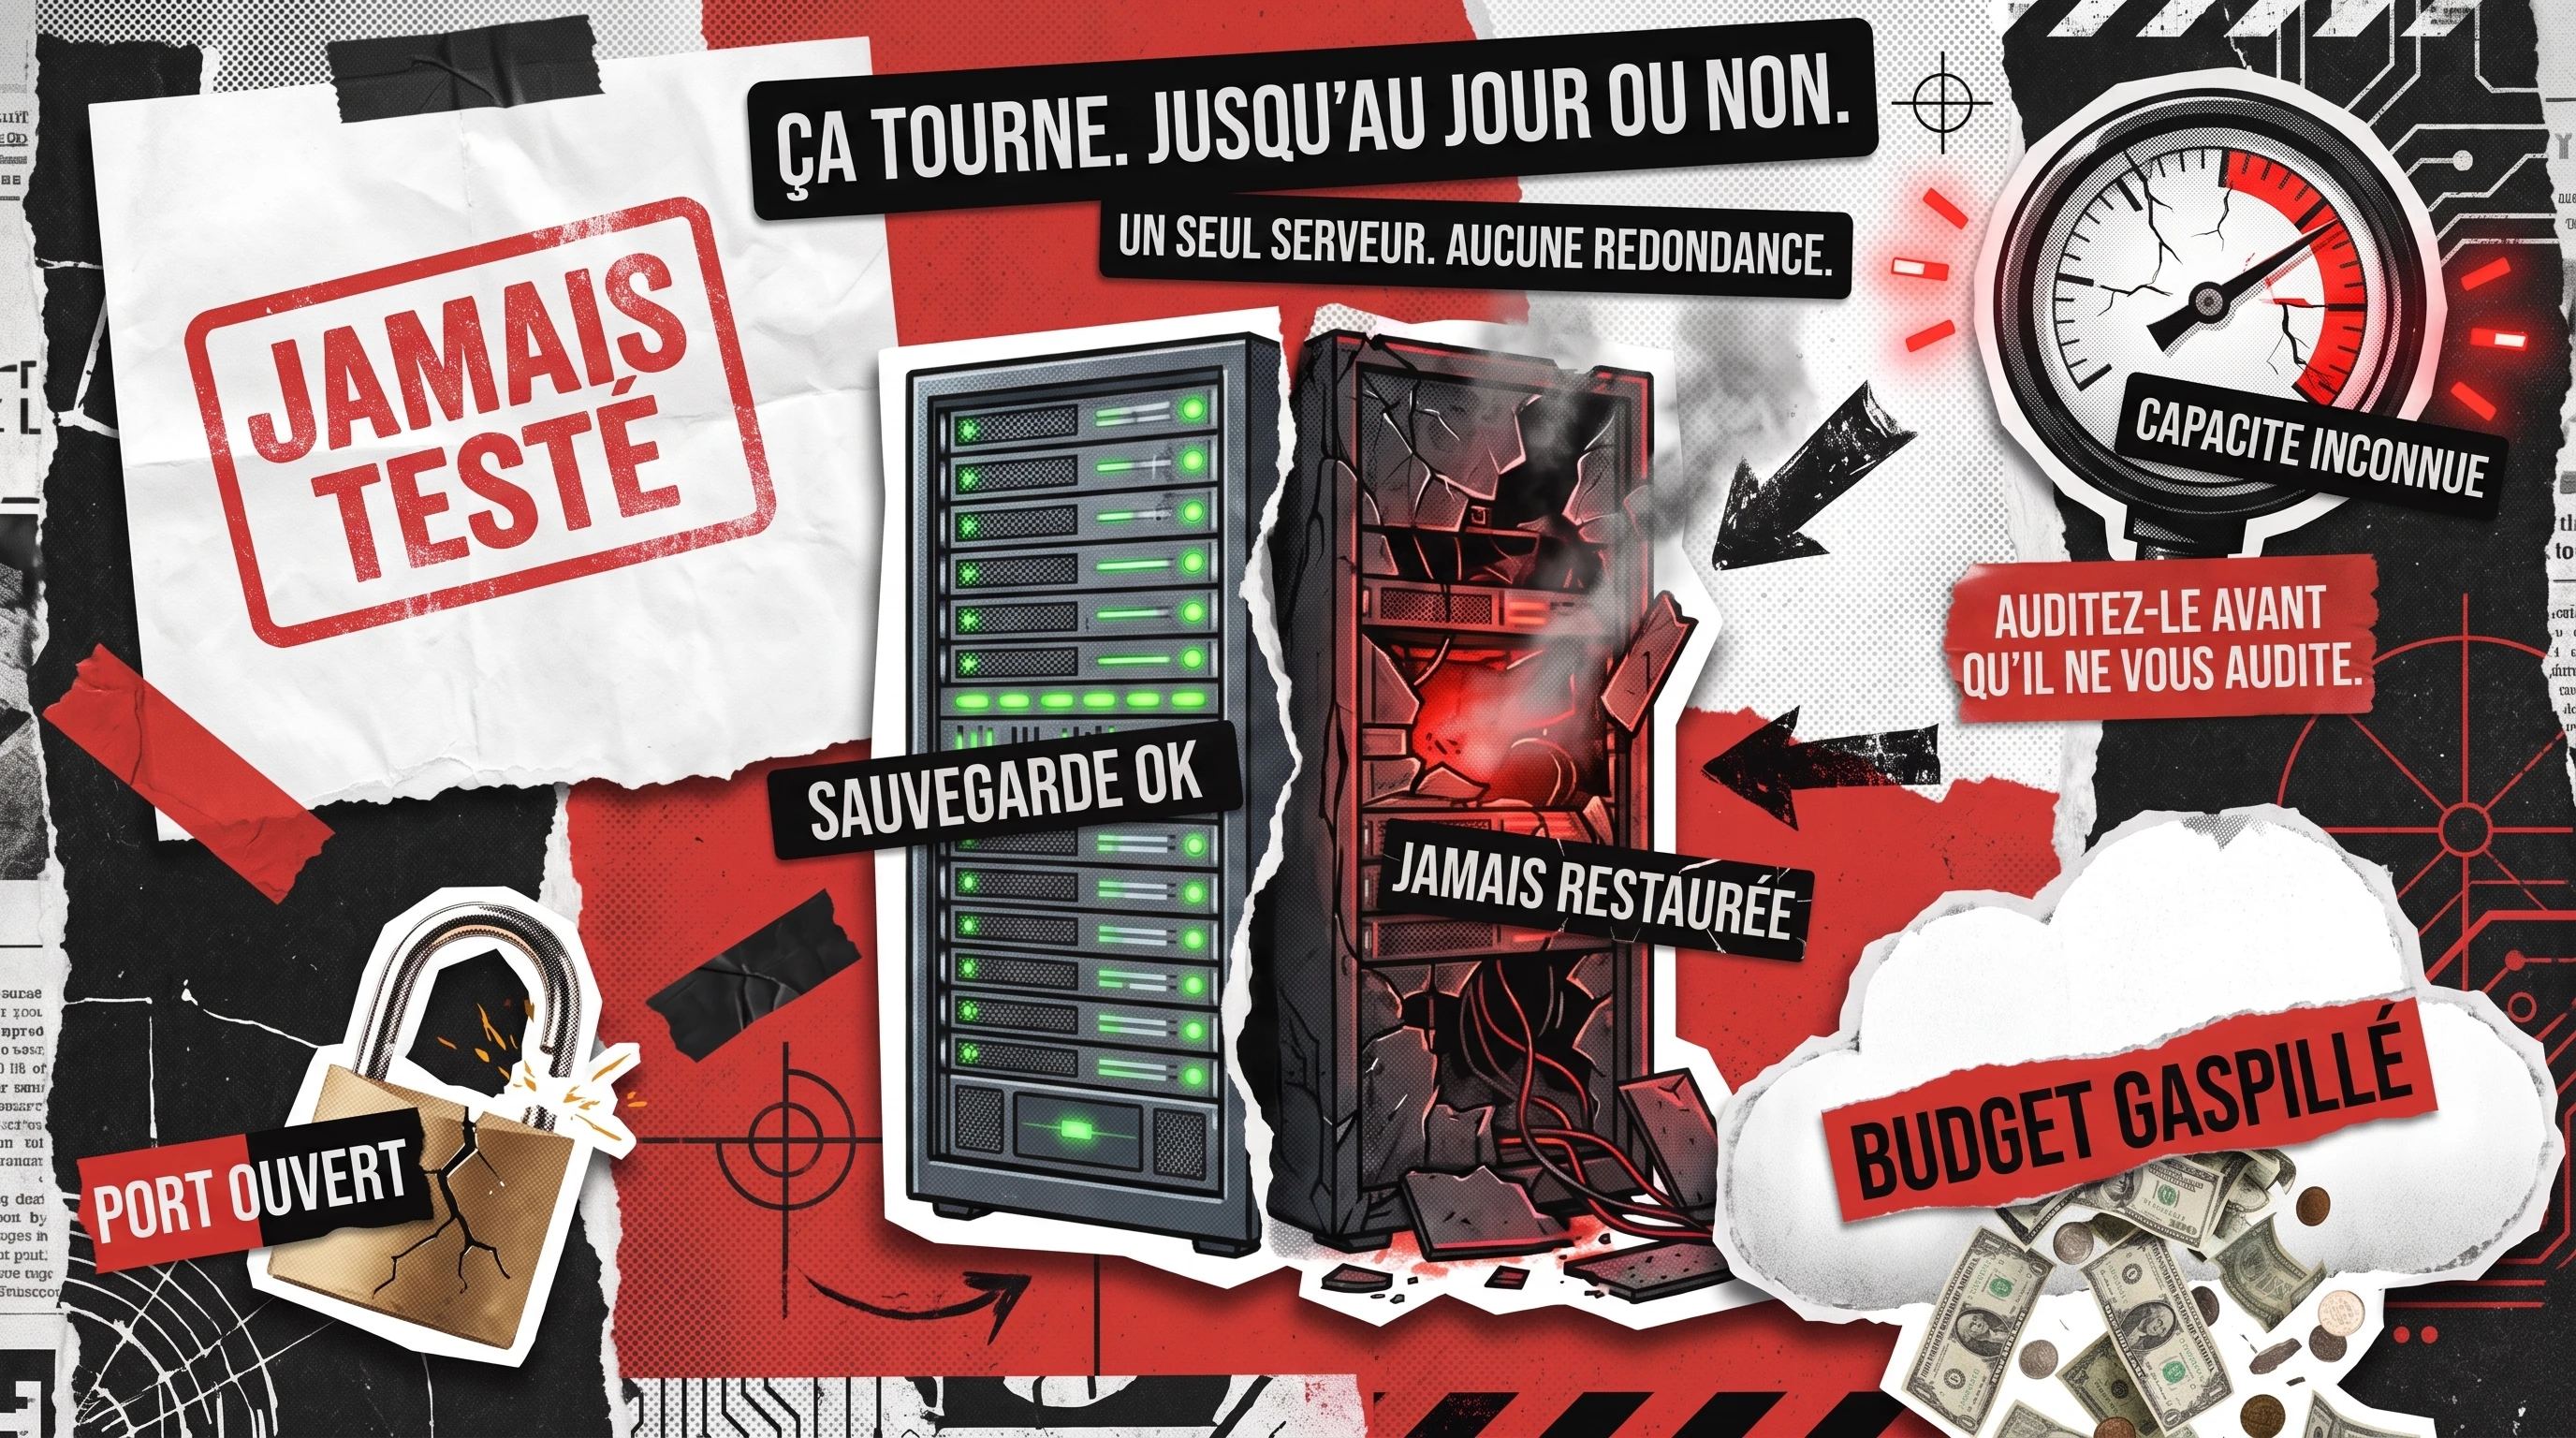
On sent généralement un problème d’infrastructure avant de pouvoir le nommer. Les déploiements ralentissent, la facture du cloud grimpe sans nouveaux utilisateurs pour l’expliquer, et un seul ingénieur devient la seule personne à savoir comment restaurer la base de données de production. La question sous-jacente est simple : cette installation est-elle sûre et prête à grandir, ou à une mauvaise nuit d’une panne grave ?
Un audit d’infrastructure est un examen structuré de chaque système sur lequel tourne votre logiciel : hébergement, bases de données, pipelines de déploiement, sauvegardes, réseau, sécurité et dépenses cloud, mesuré à l’aune de ce qu’il devrait offrir, afin que ce qui va tomber en panne, coûter trop cher ou refuser de passer à l’échelle apparaisse avant de devenir une indisponibilité, une violation ou une facture non budgétée.
Ce guide couvre ce que vérifie un examen approfondi, les défaillances qu’il prévient et le processus reproductible qui le sous-tend, tiré de la conduite de cet exercice à la fois comme audit logiciel autonome et comme première phase de missions de sauvetage plus vastes.
Ce que couvre réellement un audit d'infrastructure informatique
Le périmètre se situe une couche sous une revue de code. Une revue de code demande si l’application est bien écrite, tandis que celle-ci demande si le terrain sur lequel elle repose est solide : les serveurs, le réseau, les magasins de données et l’argent qui circule à travers tout cela. Une bonne revue s’appuie sur des preuves plutôt que sur des opinions, si bien que chaque constat renvoie à un fichier de configuration, à une métrique de tableau de bord ou à un contrôle manquant, et deux ingénieurs qui examinent le même système parviennent à la même conclusion.
Elle produit aussi une liste priorisée, car savoir que quatre-vingt-dix choses pourraient être améliorées compte moins que savoir quelles sont les cinq qui vous feront mal en premier.
Les défaillances qu'un audit d'infrastructure informatique prévient
La plupart des incidents graves sont des failles ordinaires restées visibles pendant des mois jusqu’à ce qu’elles mettent la production à terre au pire moment. Un examen les rattrape tant qu’elles ne sont encore que de la paperasse bon marché, pas une crise. Les modes de défaillance récurrents comprennent :
- Les points de défaillance uniques, où un seul serveur ou l’ordinateur portable d’une seule personne est la seule chose qui se dresse entre vous et une panne.
- Le pourrissement silencieux des sauvegardes, où les sauvegardes passent au vert chaque nuit mais n’ont jamais été restaurées, si bien que personne ne sait qu’elles sont inutilisables avant d’en avoir besoin.
- La dérive de configuration, que l’Annual Outage Analysis 2025 de l’Uptime Institute attribue à l’erreur humaine dans près de 40 % des organisations ayant connu une panne majeure ces trois dernières années, le plus souvent du personnel ne suivant pas la procédure.
- L’aveuglement sur la capacité, où le système n’a jamais été testé au niveau de trafic que présuppose le plan de croissance du trimestre prochain.
Les rattraper tôt, c’est toute la différence entre un ticket du mardi et une cellule de crise le week-end, et cela coûte bien moins cher un jour calme qu’en plein incident.

Que vérifier : le périmètre de l'audit d'infrastructure
Le moyen le plus rapide de garder un examen honnête est de partir d’un périmètre fixe, pour que rien ne soit sauté sous prétexte d’ennui. Le tableau ci-dessous est la carte de synthèse ; les sous-sections qui suivent expliquent à quoi ressemble le « bon » à chaque couche.
Hébergement et serveurs
Redondance, niveau de correctifs, marge de ressources
Une seule instance non répliquée qui porte la production
Bases de données
Indexation, réplication, limites de connexions, courbe de croissance
Sauvegardes nocturnes dont la restauration n’a jamais été testée
Déploiement et CI/CD
Automatisation, rollback, gestion des secrets
Déploiements manuels, non documentés, à une seule personne
Infrastructure as code
Couverture, dérive, gestion de versions
Serveurs configurés à la main, sans source de vérité
Sauvegardes et reprise après sinistre
RPO et RTO définis, restaurations testées
Aucun objectif de temps de reprise convenu
Empreinte de coûts
Ressources inactives, dimensionnement adéquat, étiquetage
Facture qui croît plus vite que les utilisateurs actifs
Hébergement et serveurs
Commencez par ce sur quoi tout le reste repose : si la défaillance d’une seule machine met tout le produit à terre, si le système d’exploitation et les environnements d’exécution sont corrigés vers une version prise en charge, et s’il y a assez de marge en CPU, en mémoire et en disque pour absorber un pic de trafic plutôt que de basculer pendant celui-ci. Un serveur à 90 % de mémoire un après-midi calme n’a plus de marge pour une matinée chargée, et un certificat SSL expiré reste l’une des pannes auto-infligées les plus courantes et les plus évitables.
Bases de données
La base de données est généralement l’endroit où une histoire de croissance devient discrètement une histoire de fiabilité. Examinez l’indexation des requêtes qui s’exécutent réellement en production, l’existence d’une réplication et d’un basculement, et la vitesse à laquelle les données croissent par rapport au disque qui les héberge. Une requête qui répond en vingt millisecondes à 10 000 lignes peut ralentir jusqu’à deux secondes à dix millions, et cette courbe reste invisible jusqu’à ce qu’un utilisateur la percute.
Les requêtes lentes et les index manquants sont les deux constats qui reviennent dans presque toutes les revues de bases de données, et les deux sont peu coûteux à corriger une fois que quelqu’un les nomme.
Pipelines de déploiement et CI/CD
Un processus de mise en production est sûr quand un nouvel ingénieur peut livrer dès sa première semaine et revenir en arrière en moins d’une minute, et risqué quand une seule personne connaît la séquence par cœur. L’examen vérifie si les builds et les déploiements sont automatisés, s’il existe une vraie voie de rollback et si les secrets sont injectés de façon sécurisée plutôt que collés dans des scripts. Aligner cette étape sur les bonnes pratiques du SDLC établies est souvent le changement au plus fort effet de levier qu’une équipe de taille intermédiaire puisse opérer.
Les déploiements manuels ajoutent du risque au temps perdu : la fatigue et les fautes de frappe pendant une séquence manuelle sont ce qui transforme une mise en production de routine un vendredi en panne imprévue.
Infrastructure as code
L’infrastructure as code signifie que les serveurs, les réseaux et les politiques sont définis dans des fichiers versionnés plutôt qu’assemblés à la main dans une console. L’audit vérifie quelle part de l’environnement est ainsi capturée et si les systèmes en fonctionnement ont dérivé de ce que ces fichiers décrivent. Une infrastructure bâtie à la main est comme une maison sans plans : praticable jusqu’à ce que quelqu’un parte et que plus personne ne puisse la reconstruire deux fois de la même façon. Le test pratique : si une région tombait dans le noir, pourriez-vous recréer l’environnement à partir du dépôt, ou seriez-vous en train de le reconstruire de mémoire sous pression ?
Sauvegardes et reprise après sinistre
Les sauvegardes ne sont réelles qu’une fois restaurées. Cette partie de l’examen confirme que deux chiffres sont convenus : l’objectif de point de reprise, la quantité de données que vous pouvez vous permettre de perdre, et l’objectif de temps de reprise, la durée pendant laquelle vous pouvez vous permettre d’être à l’arrêt, puis vérifie les deux par une véritable restauration de test. Une sauvegarde que vous n’avez jamais restaurée est un espoir, pas un plan.
Traitez-la comme une assurance : vous ne voulez pas découvrir que la police est trouée le jour de l’incendie.
Empreinte de coûts
L’argent est un signal de fiabilité autant qu’une préoccupation financière, car le gaspillage signifie généralement que des ressources sont provisionnées sans que personne ne surveille. L’examen traque les instances inactives, les machines surdimensionnées et les ressources non étiquetées qui rendent impossible de savoir quelle équipe dépense quoi. Harness a projeté dans son rapport FinOps in Focus 2025 qu’environ 44,5 milliards de dollars de dépenses d’infrastructure cloud seraient gaspillés en 2025 rien qu’en ressources sous-utilisées.
Le signe à surveiller : une facture qui croît plus vite que vos utilisateurs actifs, ce qui signifie presque toujours que vous payez pour une capacité que personne n’utilise.
Les vérifications réseau et sécurité au sein de l'audit
La fiabilité et la sécurité se recoupent tellement qu’un examen sérieux les traite en une seule passe, et certaines équipes commandent cette portion à part comme un audit de l’infrastructure réseau et de la sécurité lorsque la conformité ou le contrat d’un client l’exige. Les enjeux sont concrets : le Cost of a Data Breach Report 2025 d’IBM a chiffré le coût moyen mondial d’une violation à 4,4 millions de dollars, une rare baisse d’une année sur l’autre, portée par une identification et un confinement plus rapides.
Règles de pare-feu
Les règles de pare-feu s’accumulent comme le bric-à-brac dans un tiroir : ajoutées en hâte pendant un incident et rarement retirées une fois celui-ci passé. L’examen lit l’ensemble de règles réel et signale tout ce qui est trop permissif, en particulier les règles qui exposent des ports d’administration ou des bases de données à l’internet ouvert. Un pare-feu qui autorise tout est un videur qui fait entrer toute la rue, ce qui est pire que pas de videur du tout, car cela crée un faux sentiment de sécurité.
Segmentation, VLAN et moindre privilège
Les réseaux plats sont commodes et dangereux, car dès qu’un attaquant est dans l’un d’eux, il peut tout atteindre. Une bonne segmentation limite le rayon d’impact pour qu’une compromission dans une zone ne puisse pas se propager au reste. Cette partie de l’examen vérifie généralement :
- Si la production, la préproduction et les outils internes reposent sur des segments ou des VLAN distincts plutôt que sur un seul espace plat.
- Si les services ne peuvent atteindre que les systèmes précis dont ils ont besoin, en suivant le moindre privilège plutôt que la commodité.
- Si le trafic interne est chiffré, et pas seulement le trafic tourné vers l’internet public.
Contrôles d'accès et MFA
La dernière vérification porte sur qui peut entrer et à quel point il serait difficile de l’usurper. Vérifiez si l’authentification multifacteur est imposée sur chaque compte administrateur, si l’accès est accordé par rôle plutôt que distribué de façon permanente, et si les anciens employés et les comptes de service obsolètes ont réellement été déprovisionnés. Les comptes administrateur orphelins sont l’un des risques les plus discrets de tout environnement, car ils portent tous les privilèges et personne ne les surveille.
Infrastructure cloud
Les environnements cloud méritent leur propre passe, car leurs modes de défaillance diffèrent de ceux d’une baie de serveurs physiques. L’examen étudie les politiques de gestion des identités et des accès, l’autoscaling, la répartition entre tarifs réservés et à la demande, et l’usage des services gérés là où ils réduiraient la charge opérationnelle. Le cloud rend possibles la résilience et l’efficacité des coûts sans garantir ni l’une ni l’autre, et l’audit mesure laquelle votre installation offre réellement.
Un constat fréquent est un lift-and-shift qui a recopié les habitudes on-premise dans le cloud, si bien que l’entreprise paie des prix cloud pour une conception qui n’a jamais adopté les avantages du cloud comme l’élasticité ou les bases de données gérées. Démêler cela est exactement le travail qu’aborde une mission dédiée de conseil DevOps, car les correctifs couvrent ensemble le coût, la fiabilité et le pipeline de déploiement.
Comment mener un audit d'infrastructure informatique, étape par étape
Savoir comment auditer une infrastructure informatique se ramène à une séquence reproductible.
- Fixez le périmètre et le standard. Décidez quels systèmes sont dans le périmètre et ce que signifie le « bon » pour chacun, au regard d’objectifs convenus, non du goût personnel.
- Inspectez tout. Construisez une véritable carte des serveurs et des dépendances, car vous ne pouvez pas auditer ce que vous n’avez pas consigné.
- Rassemblez les preuves. Récupérez les fichiers de configuration, les journaux d’accès et les rapports de coûts pour que chaque conclusion repose sur un artefact.
- Testez les affirmations. Lancez une restauration, déclenchez un rollback et effectuez un test de charge sur un chemin critique, car les hypothèses sur la résilience ne valent rien tant qu’elles ne sont pas éprouvées.
- Classez les constats par risque et par effort. Distinguez ce qui fera mal le plus tôt de ce qui couve lentement, la discipline employée lors de l’audit du processus de développement logiciel.
- Livrez un rapport avec responsables et échéances. Un constat sans responsable ni échéance est une note, pas une correction.
Tester avant d’inventorier revient à tester les mauvaises choses, et rapporter avant de classer laisse l’équipe sans point de départ.
À quelle fréquence devriez-vous mener l'audit ?
Il n’existe pas de cadence unique correcte, car cela dépend de la vitesse à laquelle vous changez. Une règle applicable : les systèmes stables reçoivent un contrôle léger trimestriel et un examen complet annuel, tandis que tout changement majeur mérite sa propre passe ciblée.
Trimestriel
Contrôle léger du coût, des accès, du niveau de correctifs
Rattrape la dérive avant qu’elle ne s’accumule
Annuel
Examen complet de bout en bout
Réinitialise la référence sur toutes les couches
Avant un événement de montée en charge
Capacité, base de données, autoscaling
Confirme que le système survit à la croissance prévue
Après un incident majeur
Cause racine plus risques adjacents
Corrige la catégorie de problème, pas seulement le symptôme
Avant une levée de fonds ou une acquisition
Examen complet axé sur la sécurité
La due diligence technique attend des preuves
L’erreur la plus courante est de traiter l’audit comme un nettoyage plutôt que comme une habitude. Sautez un cycle et l’environnement dérive de nouveau vers son point de départ en moins d’un an.
Ce que contient le rapport d'audit
Le livrable est là où le travail devient utile, et un rapport faible est la raison pour laquelle beaucoup d’audits ne changent rien. Un bon rapport est assez précis pour qu’un ingénieur puisse agir sans réunion de suivi. Au minimum, il contient :
- Un résumé exécutif en langage clair, pour qu’un décideur non technique voie les principaux risques et les dépenses recommandées sur une seule page.
- Une liste priorisée de constats, chaque élément noté par risque et par effort de correction.
- Des preuves pour chaque constat, un extrait de configuration, une métrique ou une ventilation des coûts.
- Une feuille de route de remédiation avec responsables et échéances approximatives.
- Un plan de nouveau test, car un constat n’est clos qu’une fois que quelqu’un a vérifié la correction.
Cent avertissements de poids égal ne disent rien au lecteur sur le point de départ, et les équipes à qui l’on remet un tel rapport n’en traitent généralement aucun.
Faites de l'audit une habitude
Les systèmes sur lesquels tourne votre produit tombent rarement en panne avec fracas au début. Ils dérivent, accumulent de petits compromis et concentrent le savoir chez une ou deux personnes, jusqu’à ce qu’un mardi ordinaire se transforme en panne, en facture démesurée ou en violation dont le confinement prend des mois. Un examen discipliné transforme ces risques silencieux en une liste courte et hiérarchisée de choses que vous pouvez réellement corriger.
Les équipes qui traitent cela comme une habitude récurrente plutôt que comme une course ponctuelle passent à l’échelle sans drame, parce qu’elles trouvent le point faible avant leurs utilisateurs. Si vous voulez une équipe senior qui a mené ce même exercice sur de vrais systèmes de production pour le conduire ou épauler le vôtre, contactez-nous et nous en définirons le périmètre avec vous.
Découvrez comment nous avons audité la base de code d'Adoorabelle, identifié 80 problèmes cachés et réduit les coûts d'infrastructure de 3 600 $/an
FAQ
Quelle est la différence entre un audit d'infrastructure et un audit de sécurité ?
Un examen d’infrastructure regarde l’ensemble des fondations sur lesquelles tourne votre logiciel, y compris la fiabilité, les sauvegardes, le coût et le réseau, en traitant la sécurité comme une partie de ce tableau. Un audit de sécurité se concentre sur les menaces et les contrôles, souvent au regard d’un standard formel tel que SOC 2 ou ISO 27001. Les deux se recoupent fortement, car un système non sécurisé est rarement fiable, et un système peu fiable est rarement sécurisé.
Qui devrait réaliser un audit d'infrastructure informatique, une équipe interne ou un prestataire externe ?
Une équipe interne connaît l’historique et peut mener des contrôles peu coûteux et fréquents, ce qui convient aux examens trimestriels. Un prestataire externe apporte un regard neuf et la volonté de signaler des problèmes avec lesquels les gens de l’intérieur ont appris à vivre, c’est pourquoi l’examen annuel plus approfondi profite généralement d’une aide extérieure. La configuration la plus solide mêle les deux.
Combien de temps dure un audit d'infrastructure informatique ?
Un examen ciblé d’un petit environnement mono-cloud prend généralement une à deux semaines. Un examen complet d’un parc plus vaste avec de multiples services et des exigences de conformité s’étend sur trois à six semaines, selon la quantité de documentation déjà existante.
